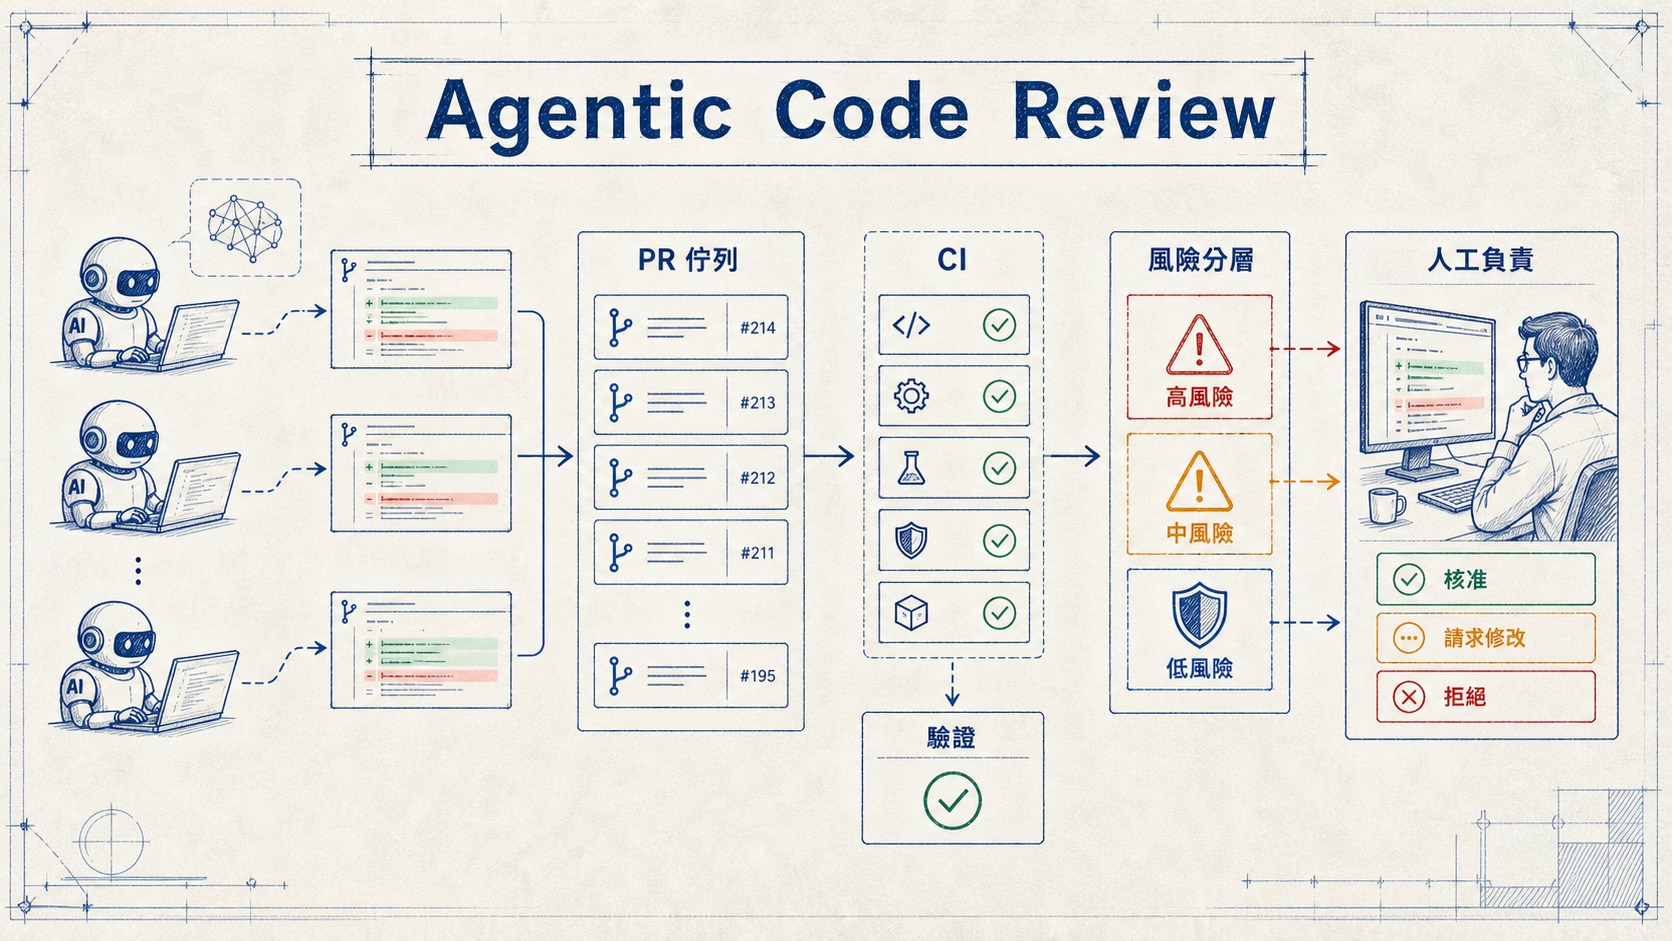
0. Review 沒有消失,只是從流程配角變成工程主戰場
Addy Osmani 在 2026 年 6 月 15 日發表的 Agentic Code Review 提出一個很直接的判斷:coding agent 讓寫程式變得非常便宜,但沒有讓理解、驗證與承擔責任變便宜。工程瓶頸因此不是「怎麼更快產生 code」,而是「怎麼更快、也更可靠地知道這些 code 值不值得相信」。
這篇文章有趣的地方,不是單純反 AI,也不是替 AI 生成程式碼背書。它比較像一張工程組織地圖:同樣是 AI 產生的 PR,solo builder、剛有使用者的新產品、十年企業系統、熱門 open-source maintainer,面對的風險完全不同。Review 的深度、工具、門檻和人的參與方式,都應該跟著風險調整。
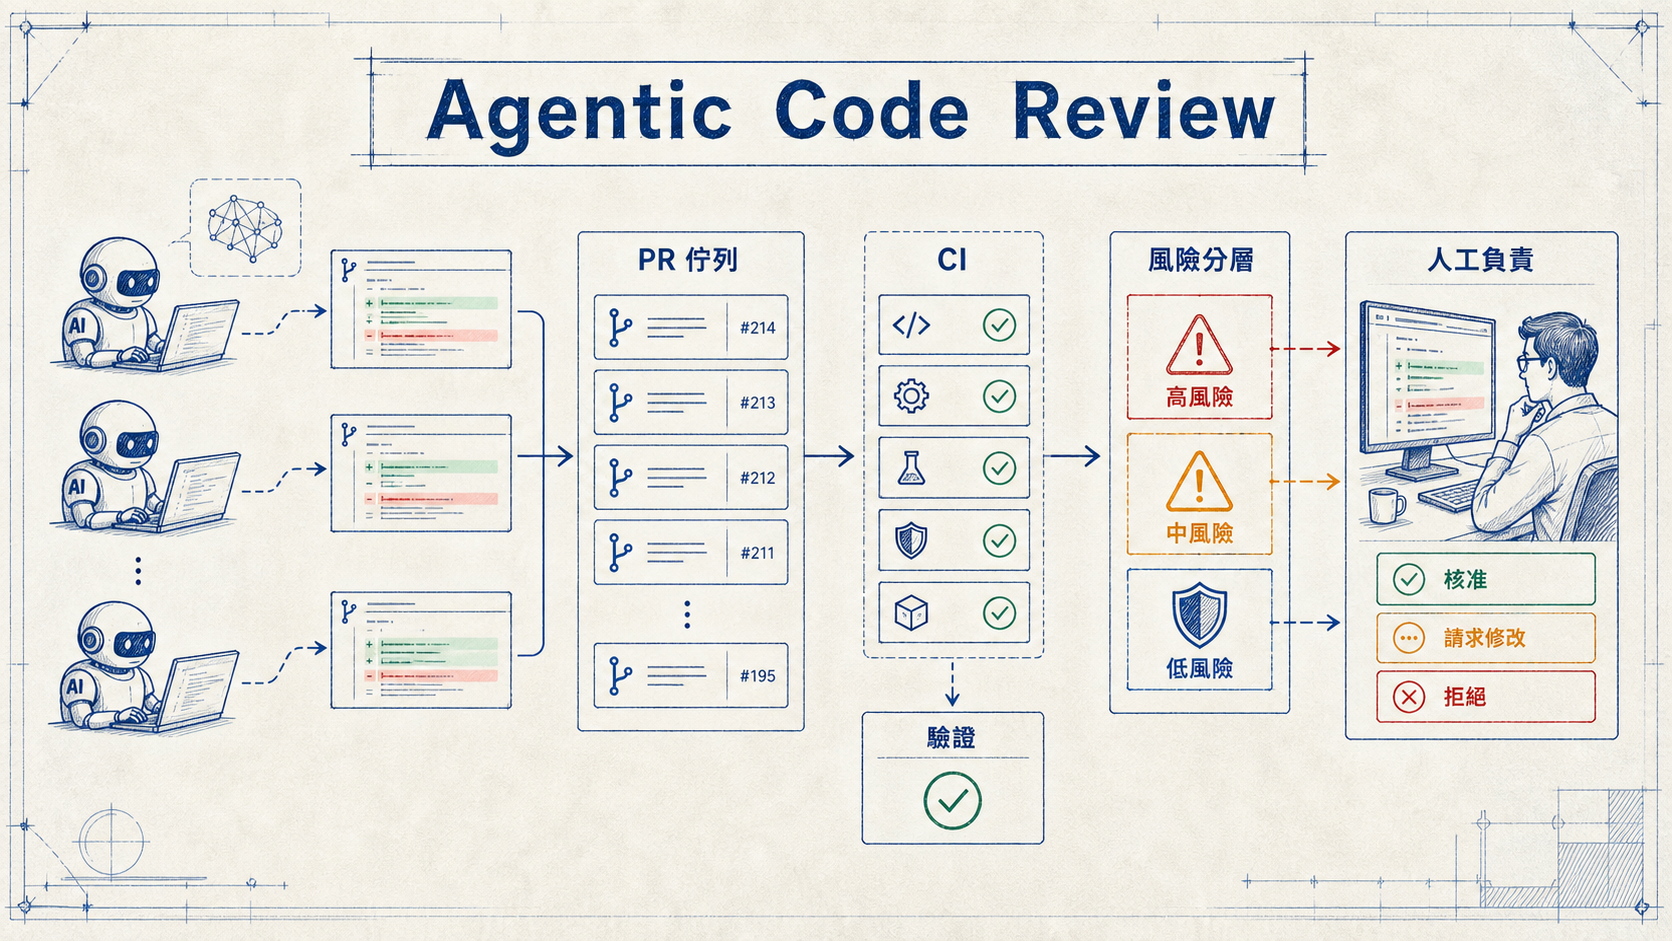
以前 code review 之所以能運作,是因為人寫 code 慢、資深工程師讀 code 相對快。Review 不只是抓 bug,也順便讓團隊吸收系統知識。但 agent 可以在很短時間內產出大量格式整齊、看似合理的 diff,人類閱讀速度卻沒有一起升級。當產出速度暴增,review 就從流程中的一站,變成整條產線的限制點。
Addy 的核心句可以濃縮成一句話:writing got cheap, understanding didn’t。寫作業的成本下降了,判斷作業是否真的對,仍然昂貴。
1. 數據共同指向同一件事:AI 增加輸出,也增加驗證負擔
原文整理多組 2025 到 2026 年的研究與產業報告,雖然來源各有立場,方向卻高度一致:AI 讓 raw output 大幅上升,但 reviewability、缺陷率與維護壓力也一起上升。
Faros AI 追蹤 22,000 位開發者、4,000 個團隊後,觀察到高 AI 採用團隊合併更多 PR、完成更多工作,但 code churn、incident-to-PR ratio、缺陷率與 review duration 都顯著上升。最刺眼的是 zero-review merge 也增加,代表不是大家決定不 review,而是 review capacity 被大量 agent output 擠爆,最後未讀 code 開始變成常態。
CodeRabbit 的 open-source PR 研究則指出,AI coauthored PR 的 issue 約為 human-only PR 的 1.7 倍,特別是邏輯正確性、安全與可讀性問題。這裡要保留一點判斷:CodeRabbit 是 AI review 工具商,Faros 也賣相關解法,所以 framing 不可能完全中性。但即使把商業立場打折,這些數字仍然說明一件事:agent output 不是免費午餐,它把成本搬到下游。
GitClear 的數字更適合拿來做管理層溝通:每日使用 AI 的開發者可能產出約 4 倍 raw code output,但和自己前一年相比,實際生產力增幅大約是 12%。中間的落差,就是 review、理解、修改、測試、維護與刪除不必要 code 的成本。
GitHub 則顯示,Copilot review 已經跑過數千萬次 review,平台上相當比例的 review 牽涉 agent。這不再是早期 adopter 的玩法,而是軟體生產方式的日常化變化。
這些資料放在一起,可以得到一個更準確的說法:AI 沒有把 review 問題解掉,而是把 review 問題放大到不能再靠資深工程師硬吞。
2. 不同風險位置,Review 的答案完全不同
這篇文章最值得保留的不是某個工具清單,而是 Addy 反覆提醒的風險光譜。很多 AI coding 的爭論之所以吵不完,是因為大家其實在討論不同場景。
如果你是一個 solo builder,產品還沒有使用者,review 的知識傳遞功能幾乎不存在,因為「團隊」就是你自己。這時候合理做法可以是:靠測試、自動化、型別、lint 與 AI reviewer 做大部分把關,只在人類真的需要理解的地方花時間。這不是偷懶,而是根據 blast radius 配置注意力。
但當產品開始有使用者,情況會快速改變。Bug 不再只是自己修一修,可能傷害真實使用者、資料、金流或品牌信任。更重要的是,團隊開始變多人,review 的第二職責,也就是「讓多個人理解系統」,開始重新出現。很多團隊危險的地方就在這裡:它們沿用 solo 階段的習慣幾個月,直到一次事故讓成本浮出水面。
到了大型組織或長期維護系統,agent 產出的大量 PR 會直接撞上所有舊問題:重複 helper 變成長期 bug surface,沒有人理解的改動變成 on-call 事故,測試被改到只是在證明錯誤行為也能綠燈。這時候「tests pass, ship it」不是速度哲學,而是 incident generator。
所以重點不是「企業要保守,個人可以放飛」。重點是 review depth 應該跟著三個變數調整:
- Blast radius:壞掉會發生什麼事。
- Code lifespan:這段 code 是下週可能重寫,還是要活五年。
- Shared understanding:需要幾個人能維護它。
同一個 diff,在不同位置需要不同 review。
3. Agent PR 最大的問題:沒有人類意圖跟著 diff 一起出現
傳統 code review 預設作者是人。人類作者至少在腦中有某種 intent:為什麼這樣寫、為什麼不那樣寫、這個 trade-off 想解決什麼。Reviewer 雖然未必同意,但能對著作者的 reasoning 追問。
Agent PR 的麻煩在於,模型產生 code 的過程通常有 reasoning,但那段 reasoning 很少被保留下來。最後 reviewer 只拿到 diff,卻沒有拿到「它原本想解什麼問題、假設了什麼、放棄了什麼」。Addy 引用 2026 年論文 AI Slop and the Software Commons 的觀察:maintainer 常常變成第一個真正看過這段 code 的人。
這不是單純的品味問題,而是 review 成本來源。Reviewer 不只要判斷 code 是否正確,還要重建 intent。重建 intent 比確認 intent 慢很多。
可行的改善方向也很明確:要求 agent 在 PR 裡留下 decision log。至少要包含:
- 這個 change 想解決什麼問題。
- 它假設了哪些系統事實。
- 它修改了哪些行為邊界。
- 它沒有做哪些事,為什麼。
- 它跑過哪些測試,輸出是什麼。
這不會讓 AI review 自動可靠,但會把「第一個人類重建上下文」的成本往前移。沒有 intent 的 diff,就是把理解債丟給 reviewer。
4. AI Reviewer 是 sensor,不是 verdict
Addy 對 AI review 工具的態度其實很務實:工具已經夠好,值得跑,而且常常抓到人會漏掉的問題。但它們不能取代人類對風險與責任的判斷。
原文提到 CodeRabbit、Greptile、Anthropic Code Review、Sentry Seer、Cursor BugBot 等工具。最有意思的不是誰第一名,而是不同 reviewer 之間的重疊度可能很低。有工程師把四個 reviewer 並行跑在真實 PR 上,結果多數 flagged locations 只被其中一個工具抓到。這說明「異質性」比「同一種模型多跑幾次」更重要。
實務上可以這樣分:
- 低風險 side project:一個 AI reviewer 加上真實測試,通常已經夠用。
- 中等風險產品:AI reviewer 做第一輪,CI/typecheck/test 不可放鬆,人類抽樣看意圖與高風險區。
- 高風險系統:至少兩種不同特性的 reviewer,加上 domain owner、人類 security/architecture pass,以及嚴格證據門檻。
關鍵是不要把 AI 的「看起來沒問題」當成 merge 許可。AI review 應該被視為 sensor:它提供訊號、排序風險、節省注意力,但不替你承擔責任。
5. Review 系統的新形狀:分層、證據、快篩、保留人類責任
原文最後落到很工程化的建議:不要再把所有 PR 用同一種 review 深度處理。你需要的是風險分層,而不是道德焦慮。
依風險分層,而不是依作者分層。 小型文案或 config change,可以靠 linter、測試與快速 glance。Auth、payment、permission、資料遷移、LLM prompt path、使用者輸入進模型的地方,都應該進入高風險流程。
把證據門檻前移。 不要 review 沒有上下文的巨大 diff。提交者或 agent 必須先提供改動目的、測試輸出、風險說明與實際跑過的證據。Reviewer 不該替 PR 作者補完整個故事。
限制 PR 大小。 Agent 很容易產生大而完整的改動,但大 PR 是 review 系統的敵人。要求 agent 拆小 commit、拆小 PR,讓人類真的能讀。
先讀 test changes。 Agent 常見失敗模式是改了行為,然後把測試也改成接受新行為。大量 test diff 比 production diff 更值得警覺。綠燈不代表正確,只代表目前的測試同意它。
CI 是不能談判的牆。 GitHub 也提醒 reviewer 注意被移除的測試、被跳過的 lint、被降低的 coverage、重複 helper、以及 user-controlled input 進入 prompt 造成的 prompt injection 風險。Agent 不一定惡意,但它會找到最快變綠的方法。
人類負責 merge。 這是整篇最現實的底線:模型不能被 on-call,不能對事故負責。點 merge 的人必須知道自己在接受什麼風險。
6. 全文導讀式翻譯:依原文脈絡完整重寫
以下不是逐字翻譯,而是依照原文順序,把每個段落的主張改寫成繁中導讀。這樣做的目的,是讓讀者能完整掌握 原文 的論證,而不重刊整篇文章。
開場:最難的部分移到信任
Addy 一開始先表明,他比以往更樂觀看待 agentic engineering。工具真的變強,而且每個月都在進步;他現在能完成一些一年前不會嘗試的工作。但也正因為工具變強,工程工作的重心移動了:難題不再只是寫出程式碼,而是判斷這些程式碼是否值得信任。
過去 code review 能成立,是因為相對速度剛好有利於人類:資深工程師讀 code 通常比初階工程師寫 code 快。Review 因此可以跟上產出,也順便讓團隊透過讀彼此的 diff 學會系統。這套機制並不是精心設計,而是因為寫 code 本來很慢。
現在這個前提失效。Agent 可以快速產生大量格式良好的 code,但人類閱讀與理解速度沒有改變。瓶頸因此下移到「有人能不能對改動有信心」。Addy 認為這不是壞事,因為這正是現在最有槓桿的工程能力。
他也先排除一個誤會:這不是反 AI 的文章。相反地,他自己會用 Claude Code 或 Codex 幫 open-source PR 做 first-pass triage,讓自己知道哪裡該花時間。問題不是要不要用 AI,而是該怎麼在不同風險環境中使用它。
2026 數據:輸出增加,審查成本也增加
原文接著整理多個研究。Faros AI 的資料顯示,高 AI adoption 團隊 merge 更多 PR、完成更多工作,但 churn、incident ratio、defect rate 和 review duration 也大幅上升。這代表 AI 的生產力提升是真實的,但不是免費的。
CodeRabbit 的報告指出,AI coauthored PR 帶來更多 issue,尤其是 correctness、安全與 readability。Addy 特別提醒,Faros 和 CodeRabbit 都是相關市場中的 vendor,所以讀者應該意識到 framing 的商業立場。但他也認為數字效果夠大,而且不同來源方向一致,不能直接忽略。
GitClear 的數字讓問題更鮮明:AI 使用者 raw output 可能是 4 倍,但實際生產力提升約 12%。如果產出的 code 多四倍,價值只增加一成多,剩下的差距就會變成理解、驗證與維護成本。
GitHub 的平台資料則說明,agent review 已經成為日常。這不是少數人的實驗,而是 code production 的新現實。四組資料合起來,結論是:我們把 machine-speed output 倒進 human-speed review system,瓶頸沒有消失,只是搬到 verification。
每個人其實在解不同問題
Addy 認為,大多數 AI coding 建議之所以互相矛盾,是因為發言者的 blast radius 不同。Solo developer 和 enterprise team 不是在解同一種問題。
他提出三個判斷變數:壞掉時影響多大、這段 code 會活多久、需要幾個人理解。這三個變數決定 review 的目的與深度。
如果你是一個沒有使用者的 solo builder,review 的知識分散功能不存在。你可以靠測試、自動化和針對關鍵部分的人工確認,接受其他地方較輕的 review。但前提是測試真的可靠;沒有 safety net 的 skip review,只是把成本延後。
當產品開始有使用者,review 的 bug-catching 功能變重要;當團隊變多人,review 的 knowledge-sharing 功能也啟動。很多團隊會太晚意識到自己已經跨過這條線。
大型組織則完全承受 Faros 數字的壓力。重複 helper 不是小問題,而是未來維護成本;沒有人理解的改動不是小瑕疵,而是 comprehension debt。Addy 的重點不是一邊保守、一邊自由,而是 review 規則必須跟使用情境一起變。
Review 的新任務:補回缺失的意圖
傳統 review 是在檢查作者的 reasoning。人類作者即使寫得不好,至少知道自己為什麼這樣寫。Reviewer 可以要求說明、挑戰假設、討論 trade-off。
Agent 也可能有推理過程,但這段過程通常不會附在 PR 裡。最後 reviewer 只看到 diff,卻看不到 agent 曾經考慮過什麼。這讓 reviewer 變成第一個真正重建 intent 的人。
Addy 引用 AI slop 相關研究指出,maintainer 會被迫處理大量看似合理、但缺少意圖與上下文的貢獻。這不是 review 原本設計來處理的工作。
好消息是,缺失的 intent 可以被工具補回來。Agent 應該在 PR 裡留下它想做什麼、排除了什麼、有哪些假設、跑了哪些測試。這不等於讓 AI 自己審自己就夠了,因為「這是不是該做的改動」仍然需要人類判斷。但至少能把 reviewer 從重建上下文的泥沼裡拉出來。
工具很好,但不要迷信單一最佳工具
原文接著討論 AI reviewer。Addy 的態度是:它們已經值得使用,而且應該跑在幾乎所有專案上。CodeRabbit、Greptile、Anthropic Code Review 等工具各有強項;有的 recall 高、有的 precision 好、有的善於抓 production severity。
更重要的是,幾個不同工具抓到的問題可能不重疊。這讓「異質 review」變得有價值。四個同類模型重複檢查,可能只是把同一種盲點放大;兩個不同特性的 reviewer,反而可能提供互補訊號。
實務建議是:不要花太多時間尋找唯一最佳 reviewer。高風險場景可以跑兩個刻意不同的工具;solo project 則一個好 reviewer 加真實測試就足夠。每個工具都要用自己的 codebase 實測,因為 benchmark 不會自動代表你的系統。
AI 是否應該做更多 review?
Addy 認為,這個問題在 2026 年已經不能用舊道德直覺回答。事實上,AI 已經在 review 很多 code;真正的問題是要有意識地設計這件事,還是讓它默默發生。
他不再相信「人類閱讀每一行」是可行答案。產出量已經讓這件事結束了。但他也不同意完全閉環,讓一個 agent 寫、一個 agent review、另一個 agent judge,最後沒有任何人類理解其中風險。這會形成相關盲點:模型彼此用相似方式同意,給出很有自信但可能錯誤的結論。
所以人類的位置不是消失,而是上移。人類不一定逐行 review,而是負責 accountability、判斷這是不是正確方向、守住高 blast radius gate、抽樣稽核系統,以及處理沒有人明確寫進需求的行為。
Addy 自己的工作方式就是讓 Claude Code 或 Codex 幫忙把 PR queue 做 first-pass sorting:哪些安全、哪些需要更多工作、哪些高風險。AI 的價值是協助分配注意力;merge decision 仍然是他的。
他也提到 Kun Chen 這類極端 solo builder 案例:大量 parallel agents、詳細 plan、幾乎不做傳統 code review,而是把人類精力放在前期規劃與 automated gate。Addy 沒有否定這種做法,但強調它成立於特定條件:solo、風險邊界不同、沒有大型團隊共同維護的十年系統。把同一套搬到高風險團隊,會直接複製前面那些壓力數字。
實務上該怎麼做
Addy 的操作建議可以整理成一個 review system:
第一,依風險分層。小改動不需要重型 review;payment、auth、security、資料遷移與 LLM input path 必須重型 review。Review depth 跟作者是人還是 AI 無關,跟錯誤成本有關。
第二,早期快篩高維護 PR。研究顯示 agent 對小而清楚的改動表現好,但遇到主觀回饋容易放棄。系統可以用 patch size、file type 等便宜訊號預測哪些 PR 會耗費大量 review effort,先做 circuit breaker。
第三,提高進入 review 的門檻。沒有目的說明、沒有測試輸出、沒有風險描述、巨大 diff 沒有拆分,就不應該丟給人類 reviewer。這不是官僚,而是避免 reviewer 成為第一個補完整上下文的人。
第四,保持 PR 小。Agent PR 容易變大,而大 PR 會被拒絕或 rubber stamp。可讀性現在是設計限制。
第五,優先看 test changes。Agent 可能修改測試來符合壞掉的新行為,所以大量 test rewrite 是警訊。綠燈要先問:它還在驗證原本重要的行為嗎?
第六,CI 要不可談判。不要讓 agent 為了變綠移除測試、跳過 lint、降低 coverage 或複製既有 helper。特別要注意 user-controlled input 被送進 LLM prompt 的 prompt injection 風險。
第七,人類擁有 merge。AI review 是資料,不是判決。當 AI 說 looks good,人類仍然要知道自己正在接受什麼責任。
結尾:理解沒有變便宜
原文最後回到最重要的經濟學:code review 沒有因為 agent 出現而變不重要,它變成中心活動。寫 code 越便宜,能否建立可信任的 review system 就越重要。
如果你是 solo builder,企業級恐怖故事可能是未來風險,不一定是今天問題;你可以靠測試和自動化,把注意力放在真正重要的地方。但如果你維護的是大型系統,那些數字就是你的現在式,你需要分層、證據、異質 AI reviewer 和人類責任。
Addy 的最後主張可以改寫成:未來幾年做得好的團隊,不會是產生最多 code 的團隊,而是最能證明 code 可被信任的團隊。Agent 沒有改變工程師交付可運作軟體的責任,只是讓「證明它可運作」變成工作的中心。
7. 魚塘編輯結論
這篇文章對台灣工程團隊特別有用,因為很多團隊現在正卡在「AI 讓每個人都更會產 code,但 review queue 越來越痛」的階段。管理層容易只看到 PR 數、commit 數、story point 或交付速度,卻沒有看到 senior reviewer 的注意力債。
我會把這篇的實務 takeaway 改成三句:
- 不要問 AI code 要不要 review;問這個 change 壞掉會傷誰。
- 不要讓 reviewer 幫 agent 補 intent;PR 必須自己帶證據。
- 不要把 AI reviewer 當裁判;把它當風險排序器。
Agentic coding 的真正成熟,不是讓人類離開工程流程,而是讓人類不要再把時間浪費在低風險、可自動化、可由機器先篩的事情上。人類要留下來的地方,是意圖、風險、責任與系統理解。這也是 AI 寫 code 越強之後,工程師反而越需要變強的地方。