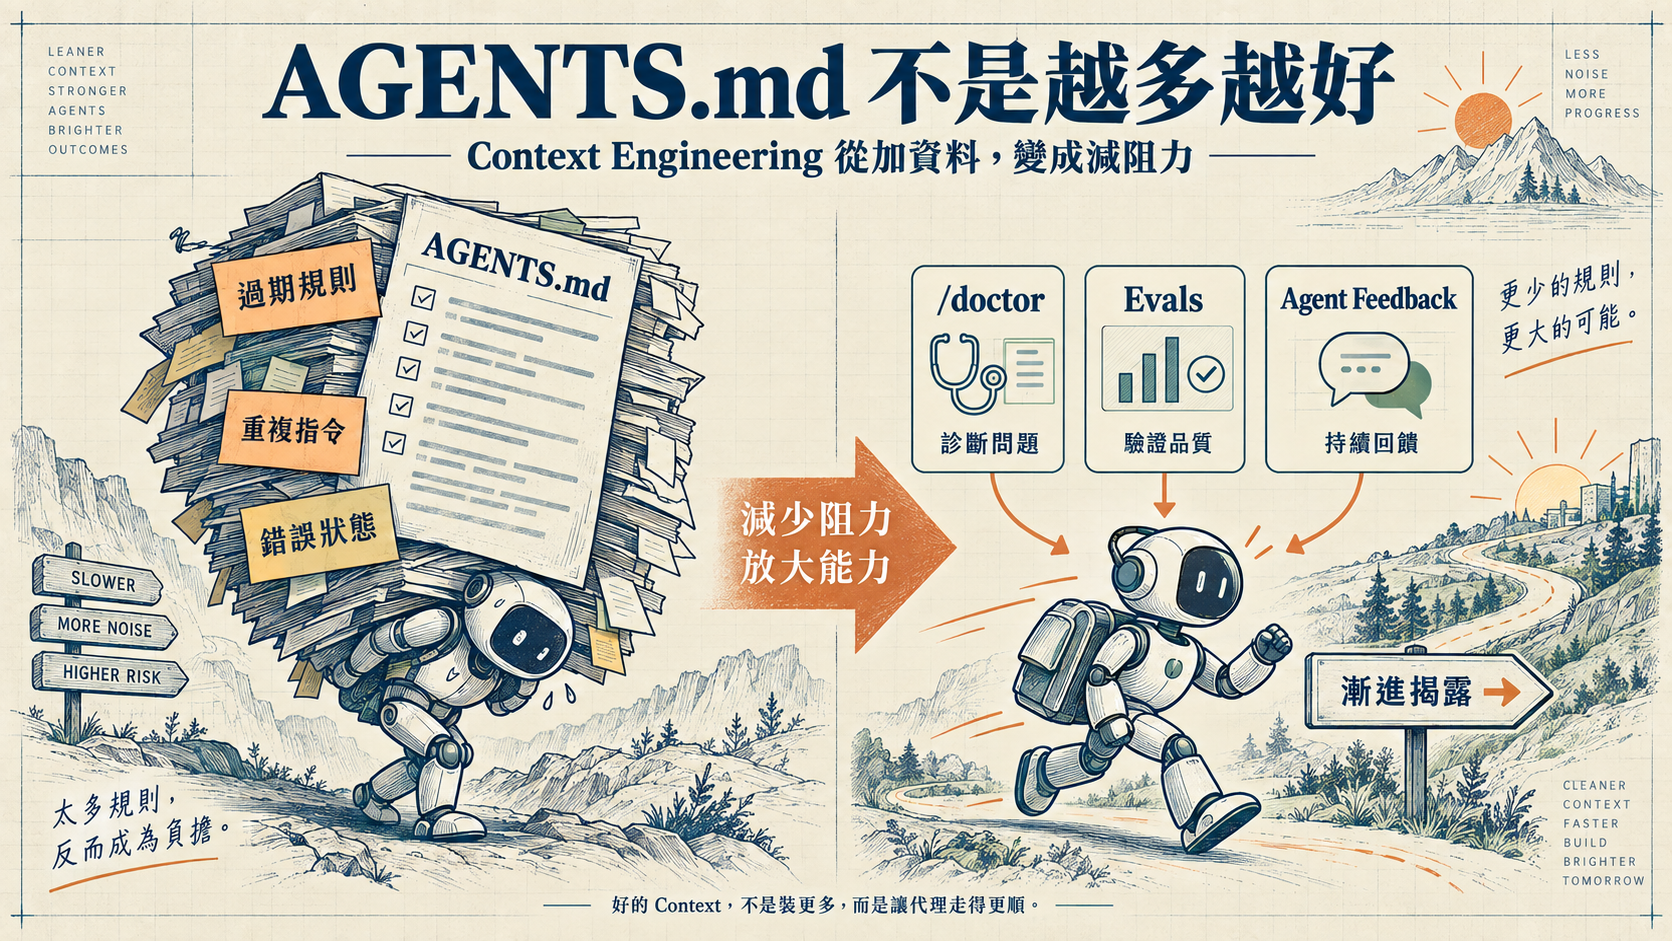
0. 過多 context 也會拖慢 agent|Context Engineering 從「補資料」變成「減阻力」
Jina Yoon 在 PostHog build mode 發表的 Read this before deleting your AGENTS.md,談的是一個很多團隊現在都會遇到的問題:早期我們把 AGENTS.md、CLAUDE.md、rules、skills、hooks 寫得越來越厚,是因為模型缺乏背景;但當模型越來越會自己推斷 repo 結構、工具慣例與任務意圖,過多常駐 context 反而可能讓 agent 表現變差。
原文開場用 PostHog 自己的 AI onboarding wizard 舉例。過去他們會在 scripts 裡預設指向 monorepo root,避免模型不知道該在哪個 project 工作;但現在模型已經比較能推斷 repo 結構,這種硬指令反而讓 headless runs 更容易落在錯專案。於是 PostHog 更新做法,讓執行流程更能利用模型自己的 recommendation。
這正是這篇文章最重要的轉向:Context Engineering 不再只是「把模型不知道的東西補進去」,而是要判斷哪些資訊已經變成噪音、過期狀態、重複約束或錯誤權威。Jina 也提到 Anthropic 刪掉 Claude Code system prompt 的 80%,說明 labs 正在回頭修正早期關於 rules 和 repetition 的建議。新的重點變成 judgment、interfaces、progressive disclosure。
這對工程團隊很實際。AGENTS.md 之所以危險,不是因為它不好,而是因為它被當成永遠正確的常駐記憶。一旦裡面寫了「永遠不要做 X」、「所有 merge 都走 Y」、「這個 repo 的入口在 Z」,agent 會很認真地照做。問題是現實會變:工具版本更新、CI 改流程、merge queue 暫停、repo 結構重整、模型能力提升。文件若沒有維護機制,就會從護欄變成障礙。
1. /doctor 只能做清潔,不能替你判斷真偽|能說出防止哪個失敗,才值得保留
第一個方法,是最手工、也最直接的:跑 /doctor,但一定要用真人眼睛再看一次。
原文說,多數 coding agents 都有內建 /doctor 這類健康檢查。Anthropic 的版本會做基本檢查:刪掉 redundant prompts、抓 broken settings、找 unused plugins,並優化 lazy loading。它也會列出每個 context file 的使用頻率、常駐 tokens,以及可以修剪多少。
PostHog 在網站 repo 上跑出一個例子:主要 AGENTS.md,也就是 CLAUDE.md symlink,估計 resident tokens 約 1,780,建議修剪約 350。整個 posthog.com repo 內,原文表示 /doctor 建議關掉 3 個 unused plugins 和 3 個 skills,估計每個 session 平均可省約 6K tokens。
這些數字有用,但 Jina 很快補上限制:/doctor 不能判斷 correctness。它只能根據 code 和設定推斷什麼看起來沒用、重複或可懶載入;它不知道 GitHub settings、團隊流程、暫停中的 merge queue、外部系統狀態。
原文舉了一個很好的反例。PostHog 曾在 AGENTS.md 加上一句:「All merges into master go through the Trunk merge queue. Never run gh pr merge.」後來團隊暫停 merge queue 來修 failing tests,卻忘了更新那行指令。結果 agents 在 21 小時內拿到錯誤規則:一位工程師的 PR 卡了 10 小時,另一位花了 45 分鐘調查原因才更新指令。
這種錯誤 /doctor 抓不到,因為 merge queue state 不在 code 裡。原文那句「Agents don’t know what they don’t know」很準確:agent 會遵守給它的世界觀,但它未必知道那個世界觀已經失效。
所以這裡的實務規則很簡單:跑 /doctor 可以作為清潔工具,但不能當裁判。每一行 AGENTS.md 都應該能回答一個問題:它防止哪個具體失敗?如果說不出來,就刪掉或移到 lazy-loading context。
2. 把 context 當程式碼測|每次 agent 犯錯,都應該變成 regression case
第二個方法,是把 context 當成 code 一樣測。
Jina 的類比很直接:你修 code bug 時會補 regression test;你修 agent context 時也應該補 eval。每一次你因為 agent 犯錯而改 AGENTS.md,都代表你發現了一個 failure mode。這個 failure mode 不應只變成一句新規則,也應變成下一次改 context 時會重跑的測試。
PostHog 的例子來自他們的 PostHog Wizard。他們會把真實 wizard runs 裡看到的 technical gotchas 記成 framework-specific commandments,例如 Next.js 15.3+ 要在 instrumentation-client.ts 初始化 PostHog、Phoenix/Plug apps 要在 router 前加入 PostHog.Integrations.Plug、Rust SDK crate 是 posthog-rs 等。
這些指令會和 context-mill 產生的其他規則,例如「reuse event names the project already uses」,以及約 40 個 clean sample apps 結合,變成 wizard-ci evals。流程是:
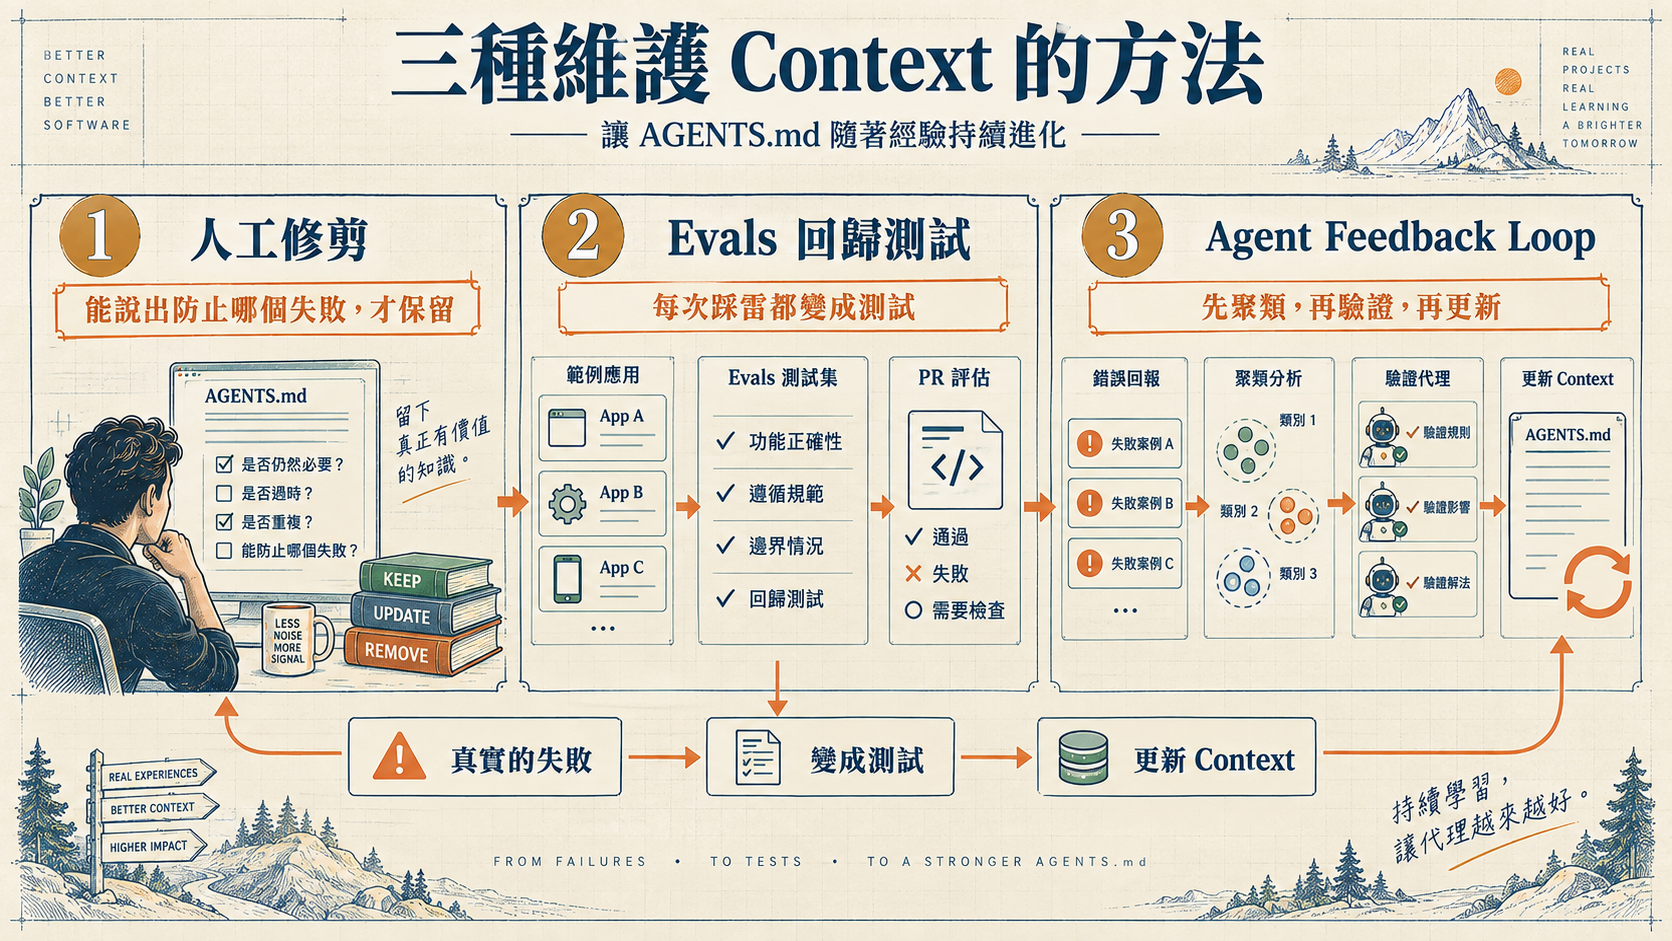
wizard-ci 在所有 sample apps 上跑 PostHog Wizard,為每個 sample app 建一個 PR。這些 PR 不會真的 merge,而是交給第二個 agent,也就是 pr-evaluator,根據 diffs 和 session logs 打分。pr-evaluator 再把 metrics 和 reports 留在 trigger PR 與 wizard-ci PR 上。
這個系統幫 PostHog 抓到一類問題:wizard 因為模型判斷「已經完成」而跳過安裝 PostHog。這不是單純靠 AGENTS.md 多寫一句就能放心的問題;你需要用固定 prompt、固定 sample apps、固定 evaluator,把 context 是否真的改善行為測出來。
對一般團隊來說,不需要一開始就做到 PostHog wizard-ci 那麼重。原文給的最小做法很務實:下一次 agent 犯錯時,把造成錯誤的 prompt 貼進 failures.md。下次你修改或刪減 AGENTS.md 前,重跑這些 prompts,看看高成本錯誤有沒有回來。
這句話對 Context Engineering 很重要:context 不是文檔收藏,而是行為契約。 如果一行規則真的重要,它應該能在某個 failure prompt 裡展現價值。反過來,如果它沒有可觀察的行為效果,就只是常駐 token 負擔。
3. 讓 agent 回報自己被什麼卡住|便宜的 AI observability
第三個方法,是直接問 agent:剛才有哪些 context 不夠、錯誤、不一致,導致你浪費回合或做錯?
原文說,很多開發者已經會讓 agent 更新 skills,但可以把這件事放進預設 prompt。PostHog Wizard 的 final instruction 就會要求 agent 回報:這次任務中,integration prompt 或 documentation 如果多提供什麼資訊,能避免 tool failures、erroneous edits 或 wasted turns?
這形成一種很便宜的 AI observability。每次 agent 跑完任務,不只輸出結果,也回報它在哪裡撞牆。PostHog 進一步把這些回報送回 context-mill,形成迴圈;但因為不能完全相信 agent 的自述,他們會先 cluster,再 verify underlying issues,最後才嘗試修 context。
這個順序很關鍵。Agent feedback 不是聖旨。它可能把自己的錯怪給文件,也可能提出局部有效、全域有害的建議。如果直接把所有回報寫進 AGENTS.md,context 會很快膨脹成一堆互相打架的備忘錄。PostHog 的做法是把 feedback 當 bug reports:先聚類,看是不是常見問題;再派 subagents 驗證是否真的能重現;最後才更新 context。
即使沒有規模化 pipeline,小團隊也能用這個方法。任務結束時問 agent 三件事:
這次用了哪些 context files?
哪些指令幫上忙?
哪些指令過期、不一致,或讓你多走了彎路?
久了之後,你會得到一份活的 context 維護 backlog。它比憑感覺翻 AGENTS.md 更接近真實使用情境,也能幫你找出「看起來很重要,但 agent 從來用不到」的規則。
4. 魚塘觀點|AGENTS.md 應該像測試套件,不像公司 Wiki
這篇文章值得放進魚塘,因為它把 Context Engineering 從「prompt 寫得更完整」拉回工程紀律。
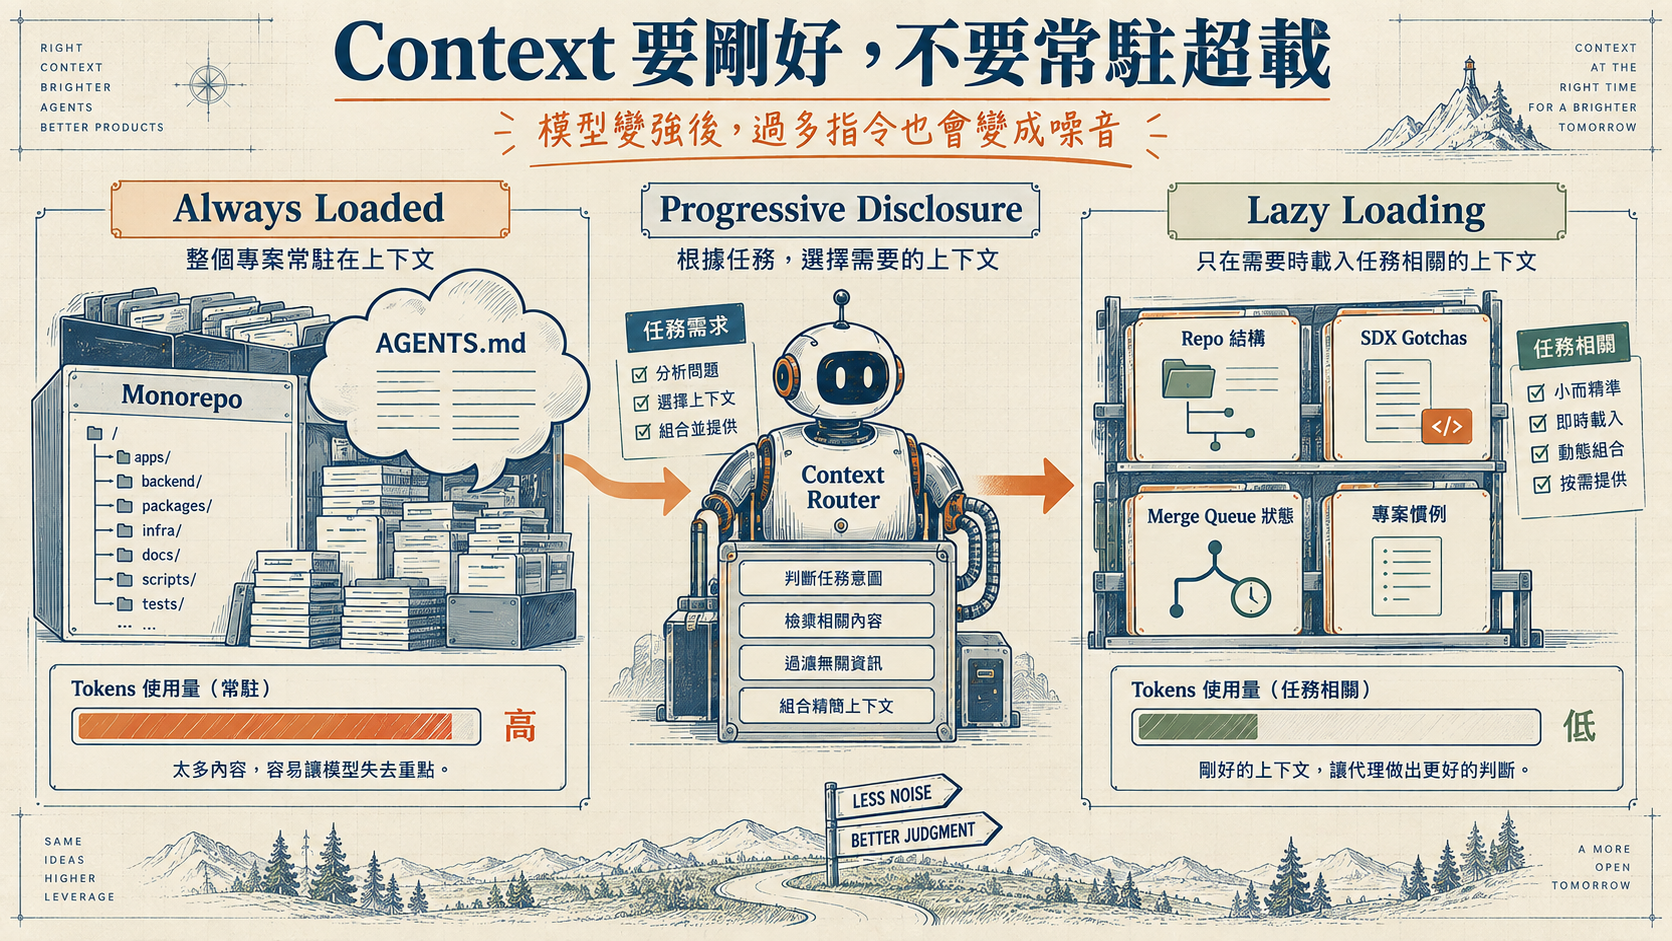
很多團隊第一次讓 agent 進 repo,會自然地把 AGENTS.md 當成公司 Wiki:所有規則、部署方式、歷史坑、個人偏好、命名習慣、安全提醒都塞進去。這在模型弱、repo 小、工具少的時候很合理。但當模型變強、repo 變大、agents 變多,常駐 context 會變成 shared mutable global state:每個 agent 都讀,每個任務都背,錯了就全域污染。
比較好的心智模型,是把 AGENTS.md 當測試套件和啟動索引的混合體。它不需要收錄全部知識,只需要:
第一,放真正全域且穩定的工作邊界,例如不要碰哪些系統、怎麼處理 secrets、哪些命令有破壞性。
第二,指向可懶載入的專門文件,而不是把每個框架細節都常駐。
第三,每一條高成本規則都有對應 failure case 或 eval,可以證明它仍然有用。
第四,定期用 /doctor、人工 review、agent feedback、eval results 做修剪。
Jina 引用 Boris Cherny 的建議:每六個月刪掉 CLAUDE.md,重新站在 bleeding edge 思考。這句話不一定要字面照做;更適合的解讀是:AGENTS.md 不該被當成沉積岩。模型能力、工具介面和團隊流程都會變,context 也應該有重構週期。
最後的取捨很清楚:不要把 agent 犯過的每個錯都變成一條永遠常駐的規則。先問它防止哪個失敗,再用 eval 驗證,再決定它應該常駐、懶載入,還是被刪掉。Context Engineering 的下一階段,不是寫更多上下文,而是讓上下文變得更少、更準、更可測。