010. 先讀|這不是「想一個 AI 點子」,而是做一個可被評審操作的作品
這場直播的表面任務,是介紹 Google Cloud AI Builder Cup 的時程、主題、提交方式與 Q&A。真正值得讀的地方,是它把一場 AI hackathon 的評分邏輯講得很清楚:主辦方要看的不是「我有一個 AI idea」,也不是「我把 prompt 丟給 Gemini 了」,而是一個能被操作、能被展示、能被部署、能說清楚 impact 的 working prototype。
來源是 Hack2skill YouTube 直播:AI Builder Cup | Introductory & Problem Statement Explainer Session。以下整理依據影片字幕與講者說明;賽程、獎項、評分權重與名額等資訊以直播中主持人與講者表述為準,參賽前仍應回到官方頁面確認最新規則。
如果把這支影片當成參賽 briefing,它的核心訊息其實只有一句:先選一個你真的理解的問題,再用 Google Cloud 與 AI 做出能跑的解法,最後用文件、demo、repo 和部署網址讓評審相信它不只是 demo day 的玩具。
這個順序很重要。很多 AI hackathon 作品會從工具出發:先想 Gemini、RAG、agent、vector search、Cloud Run、Firebase 要怎麼塞進去。Prashant 在 Q&A 裡反覆提醒的方向剛好相反:不要從 Google Cloud 有多少產品開始,要從 problem statement 開始。你要解什麼問題?這個問題在哪個主題下?你的原型如何證明 AI 有幫上忙?需要資料庫、runtime、RAG、agent framework 時,再把技術接上來。
所以這篇導讀不只整理規則,也把它改寫成一份參賽策略:一個團隊要如何從題目、原型、雲端部署、提交物到評分準備,逐步降低「做了很多功能但評審看不懂」的風險。
021. 賽制與時程|你不是只交 code,而是在進入一個篩選漏斗
主持人 Shwetta 先把 AI Builder Cup 定位成面向 APAC 開發者社群的大型 Google Cloud AI hackathon。她提到 APAC 有超過 1500 萬名開發者,這場活動是對這個社群的開放邀請。參賽者會從多個 enterprise problem statements 中選題,組隊,在幾週內做出能解決問題的原型。
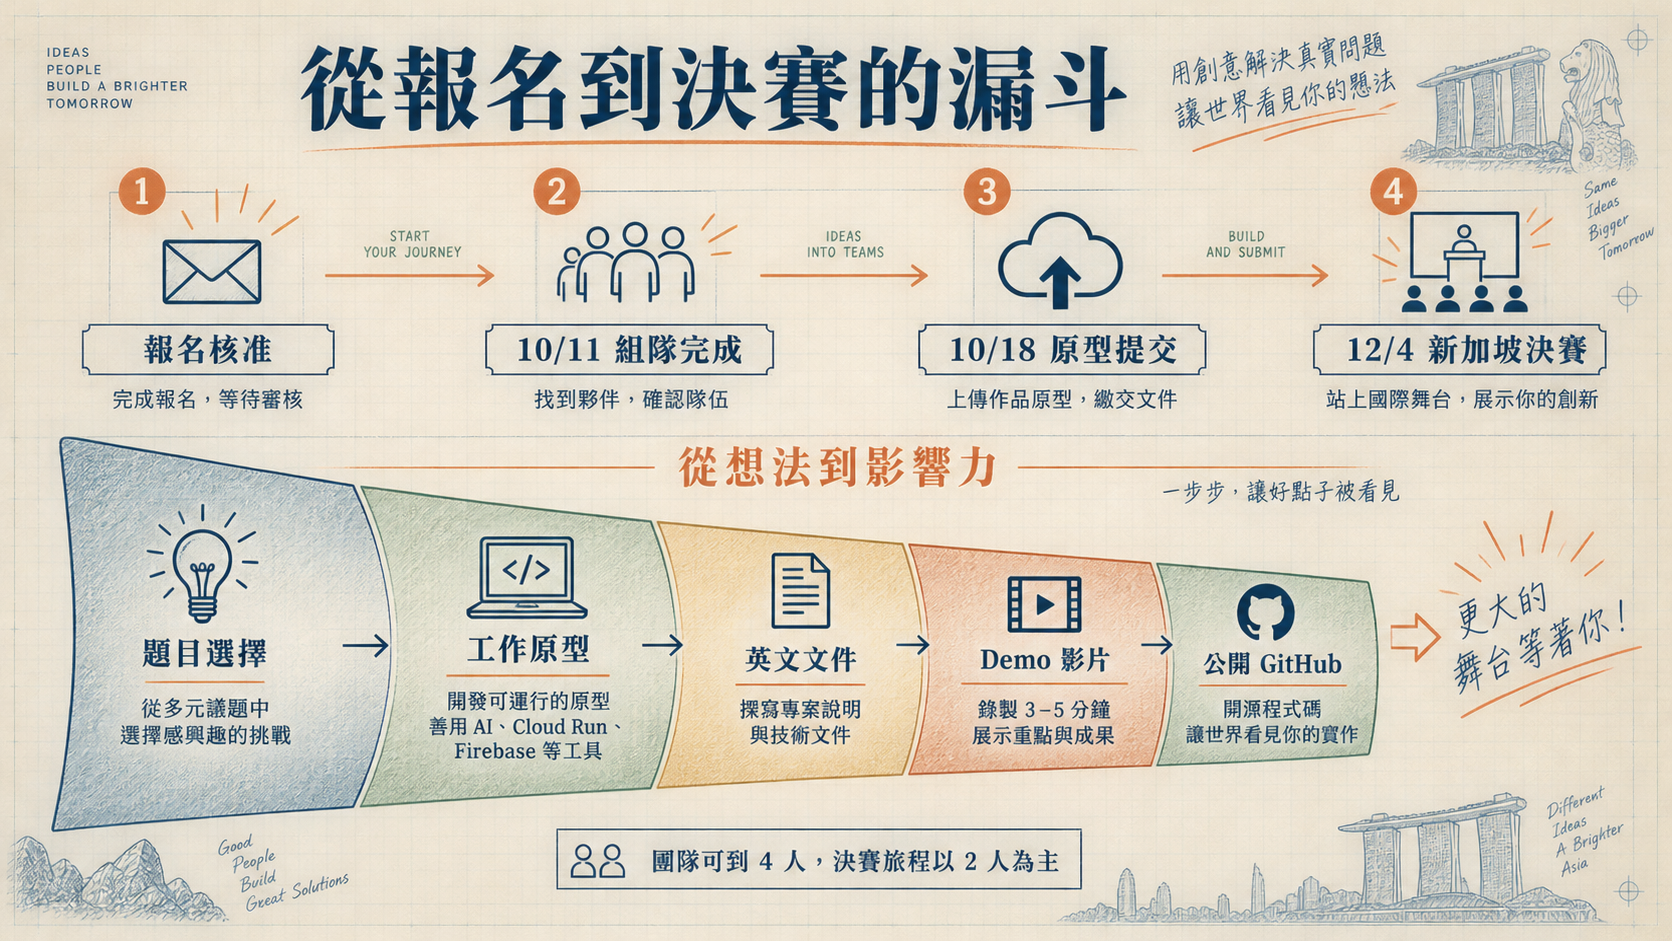
直播中提到的關鍵節點如下:
- registration 會分批審核;有些人註冊後會先顯示 waitlisted。
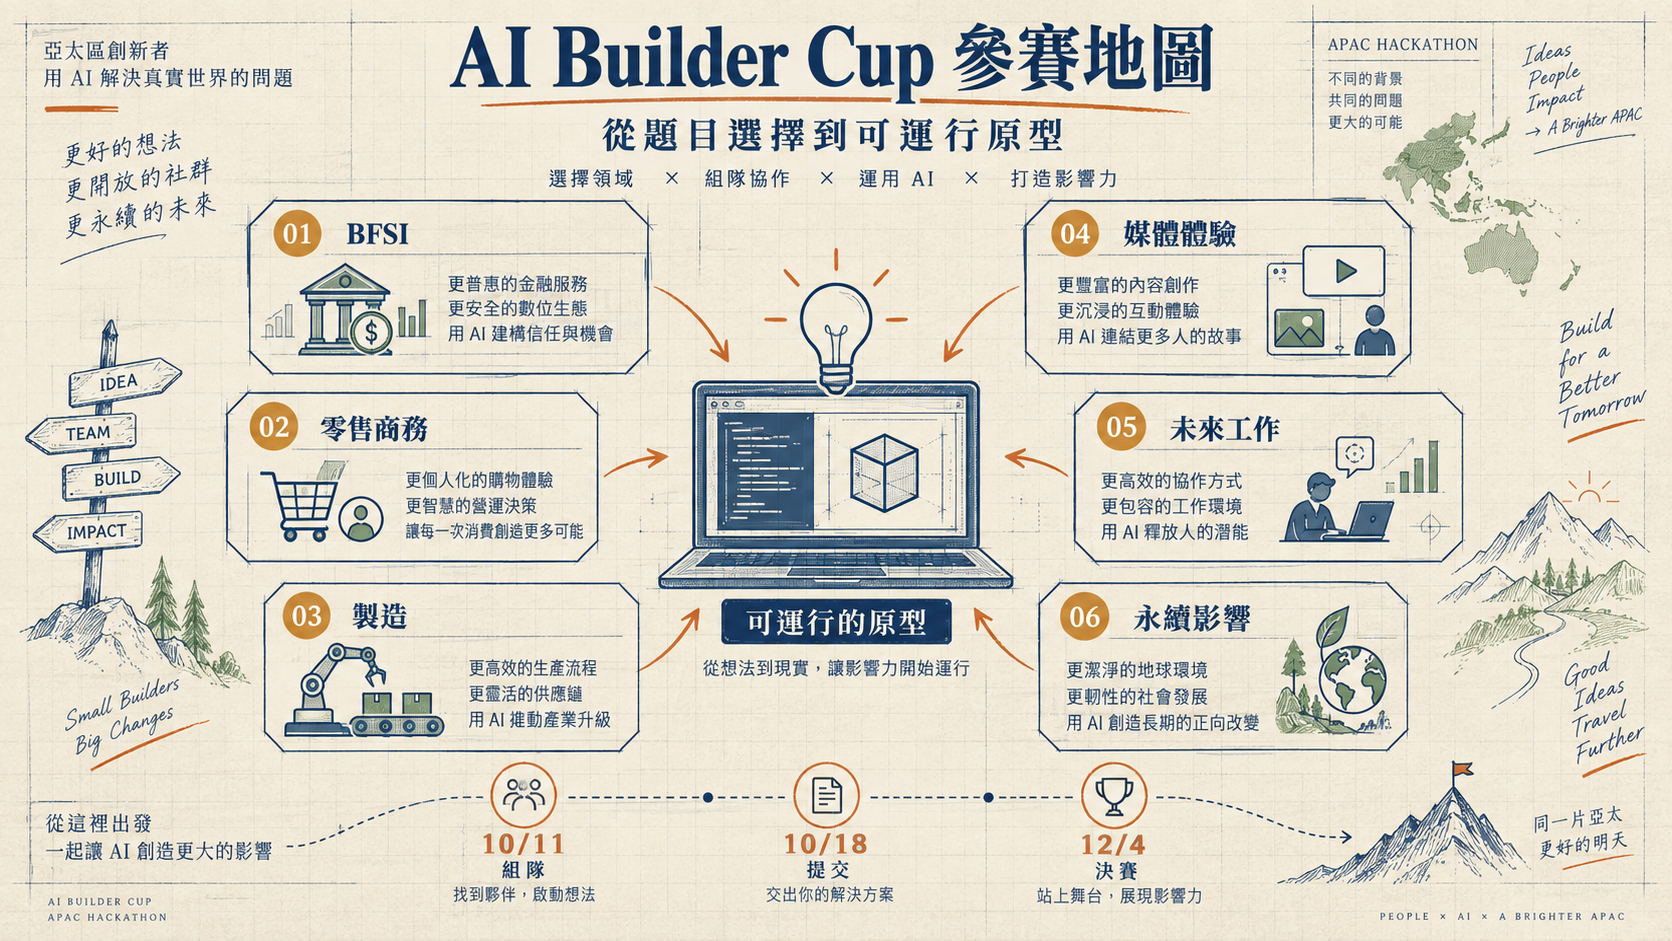
- team finalization 到 10 月 11 日。
- prototype submission 到 10 月 18 日。
- shortlisted teams 會在 11 月第一週公布。
- live grand finale 在 12 月 4 日舉行。
她也說明,入選 top 50 teams 的隊伍會前往新加坡參加 in-person demo day,旅行與住宿由主辦方贊助;但 visa process 由各隊自行處理。建置階段團隊最多可到 4 人,但若進入決賽,實際可前往 finale 的成員是 2 位。
這些規則背後有兩個實務提醒。
第一,waitlist 不等於不能準備。主持人在 Q&A 裡提醒,registration 會分批 approve;等待期間,團隊仍可先研究 problem statements、規劃 PR document、想清楚 solution。這很實際,因為 10 月 18 日的提交期限不會因為團隊晚收到 approval 就自然變長。
第二,團隊組成要符合交付方式。最多 4 人一起 build,但只有 2 人可前往決賽,代表團隊要及早決定誰負責產品敘事、誰負責 technical demo、誰負責文件與 submission hygiene。這不是純工程題;最後上台和被評審 review 的,是整個作品的完整度。
獎項方面,主持人提到總獎金池 up to $30,000,並分成多個獎項類別,例如 winners、runner-up、Google Cloud AI tools and services 最佳使用、most impactful solution、jury choice award、best UI/UX。這意味著作品不只有一種勝利路徑:技術深度、影響力、工具使用與體驗設計都可能被看見。但前提一樣是,你要能把這些價值具體呈現出來。
032. 六大題目|選題不是選熱門字,而是選你能帶入經驗的問題
Prashant 接手後,先講 eligibility 與參賽者背景。他表示這一屆主要面向 working professionals、entrepreneurs、startups,不開放 students。他也提醒,如果要組跨職能團隊,要先看清楚 eligibility criteria。
接著他介紹六大 themes:
- BFSI:Banking, Financial Services and Insurance。
- Retail and Commerce。
- Manufacturing。
- Media, Content, Digital Experiences。
- Future of Work and Enterprise Productivity。
- Sustainability and Social Impact。
這六個主題看起來很寬,寬到幾乎所有 AI idea 都能硬塞進去。但 Prashant 的重點不是「每個題目都可以做 AI」,而是「你要選擇能帶入自身經驗、能產生最大 impact 的 problem statement」。換句話說,選題不是找最流行的關鍵字,而是找你能說出細節的痛點。
BFSI 的核心是 trust、security、numbers 與 complex process。可以思考 fraud mitigation、risk mitigation、金融服務的 user-friendly access、複雜流程自動化、customer interaction、hyperpersonalization。這裡很適合有金融、保險、風控、客服、合規經驗的人切入,因為評審會期待你知道「風險」不是一句口號。
Retail and Commerce 則以 customer experience 為主。Prashant 舉了 checkout、return process、conversational experience、inventory management、demand planning、seasonality、festival demand 等例子。這個主題容易做出漂亮 demo,但也容易流於一般 chatbot。要站得住,最好能明確描述哪一段 customer journey 被改善,以及改善後對商家或顧客的價值。
Manufacturing 的範圍包含 defect detection、supply chain、raw material、production time、demand-supply match、predictive analytics。這裡的難點通常不是 AI 模型本身,而是 domain context:產線資料、品質檢測、供應鏈延遲、需求預測之間的關係。如果團隊能把這些流程講清楚,作品會比單純的影像辨識 demo 更有說服力。
Media, Content, Digital Experiences 被 Prashant 拆成 creator 與 consumer 兩端。可以做 personalized content delivery、engagement analytics、creator insight、immersive education、multilingual content。這個題目與生成式 AI 很接近,但也因此競爭會很高。要避免做成「又一個內容生成器」,最好能處理 distribution、feedback loop、accessibility 或 learning outcome。
Future of Work and Enterprise Productivity 則關注 collaboration、knowledge management、workflow、decision support。Prashant 特別提醒,AI 不一定要替人做決策;更合理的是給 decision makers 足夠資訊,讓他們做更好的判斷。這句話很重要,因為 enterprise productivity 的作品如果直接宣稱「AI 幫公司決策」,很容易碰到可信度與責任邊界問題。
Sustainability and Social Impact 則包含 accessibility、education、elder care、underrepresented groups、climate change、water efficiency、heat spots、cooling solutions、cross ventilation 等方向。Prashant 說,這類題目可以從真正觸動你的問題出發。這不是鼓勵空泛公益,而是提醒團隊:如果要做 social impact,就要能說明受益者、場景、限制與實際可用性。
043. 技術落地|最小架構先跑起來,再談 RAG、agent 和擴展
這支影片最有價值的段落之一,是 Q&A 裡對 prototype architecture 的回答。有人問:從 AI prototype 到 Google Cloud working deployment,推薦架構是什麼?
Prashant 沒有直接列一張豪華雲端架構圖。他說,任何 reasonable application 至少需要三件事:AI API access、runtime、database。你的 UI 跑在 runtime 上,跟 database 與 AI API 溝通。這就是最小起點。
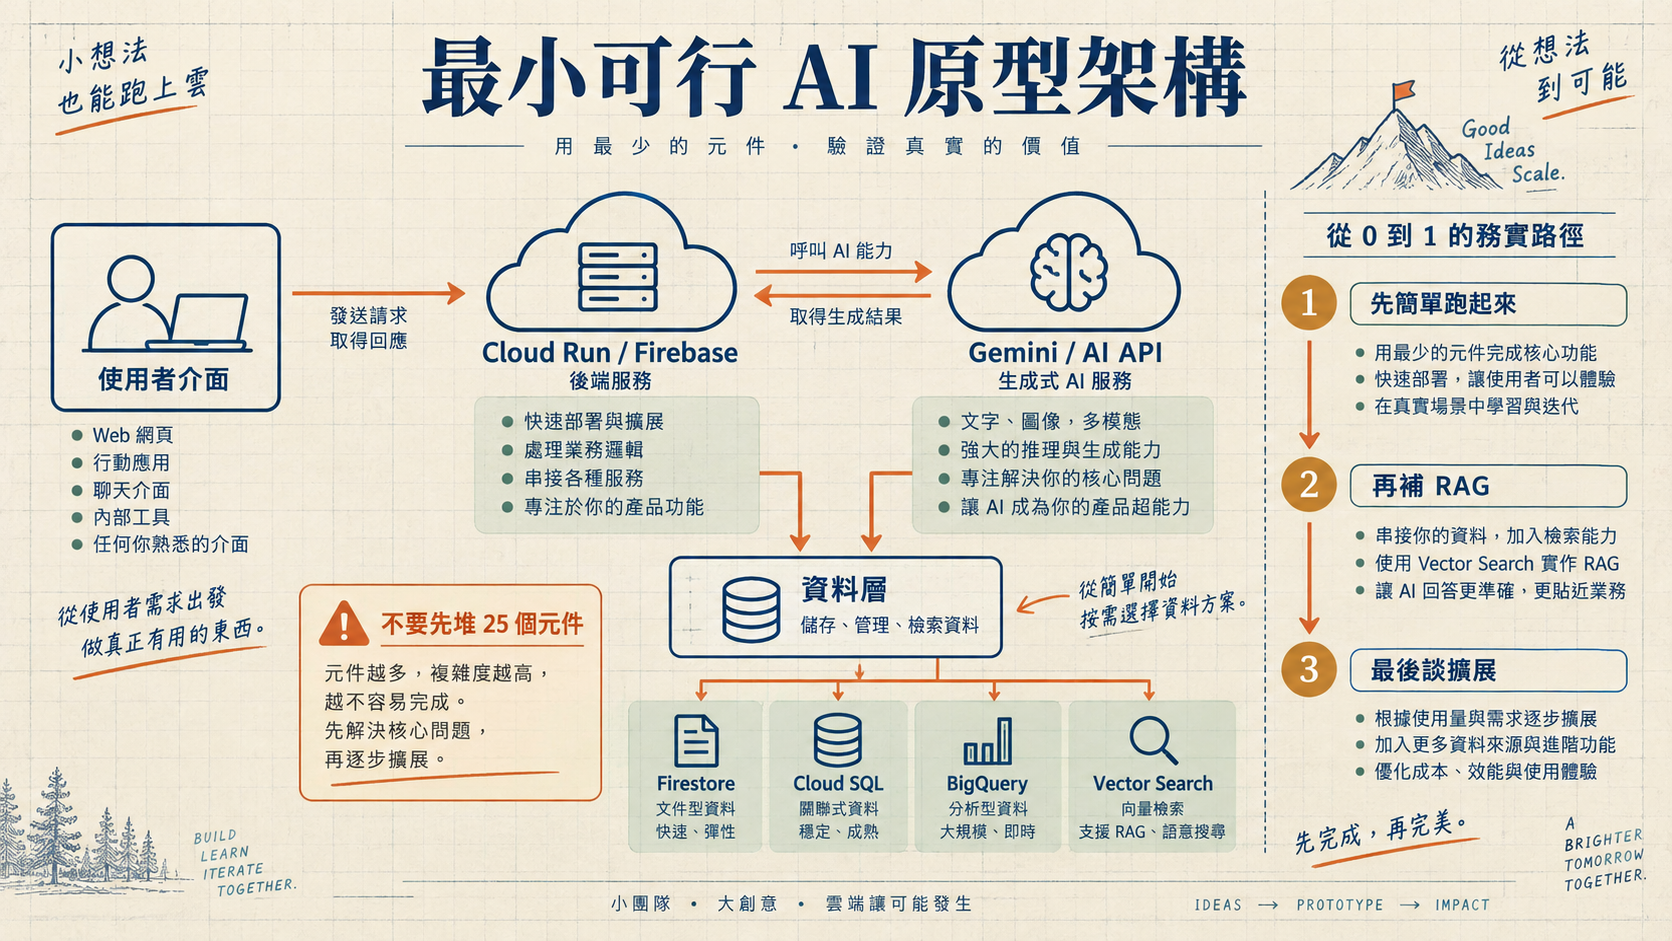
他建議的起步組合很樸素:Gemini 或 Google AI models,加上 Cloud Run 或 Firebase 作為 runtime,再依需求選 Firestore、Cloud SQL、BigQuery 或其他資料服務。若只是本地 proof of concept,甚至可以先用 SQLite;等 POC 成立,再遷移到 Firestore 或 Cloud SQL。
這背後的原則是 progressive architecture。不要一開始就設計 25 個 components,再把作品硬塞進複雜架構裡。先用最簡單的元件把問題解出來;等有使用者、有負載、有資料量、有可靠性需求,再逐步補 load balancer、caching、CDN、RAG、vector search 或更完整的 observability。
RAG 的回答也很務實。Prashant 說有兩條路。
第一是 DIY RAG。你可以選用 Google Cloud 上有 vector / embedding support 的資料庫,搭配 LangChain、LlamaIndex、ADK 等 framework,自行處理 retrieval、filtering、ranking。這適合 RAG 本身就是作品核心、團隊也有能力展示技術細節的情境。
第二是 out-of-the-box RAG。若 retrieval 只是輔助功能,不是作品核心,可以使用 Google Cloud agent platform 上現成的 vector search / RAG 能力,把文件或資料庫接進服務。這適合希望把時間集中在應用體驗與問題解法上的團隊。
最關鍵的一句,是他在最後總結時說的:如果你只有一份文件,可能根本不需要先做完整 RAG,把它放進 Gemini context 裡,先確保 proof of concept works。這句話對 hackathon 特別有用。很多隊伍會把「用了 RAG」當成加分項,但如果資料量太小、問題太簡單、展示時間有限,RAG 反而可能只是增加複雜度。
054. 提交物|文件、Demo、GitHub 與部署網址,是作品的一部分
Prashant 反覆強調:主辦方要看的不是 idea,而是 working prototype。他說得很直接:We want to see what you have built.
提交物至少包含幾個層次。
第一是 documentation。文件要說明 solution 是什麼、做什麼、產生什麼 impact、如何對齊所選 problem statement。如果你選 BFSI,就要說清楚你的 use case 為什麼屬於 BFSI,解的是哪個具體問題。不要只寫「我做了這個」,而要寫「我做這個,是因為這個主題下有這個問題」。
第二是 functional prototype。你在文件裡承諾的能力,prototype 裡要看得到。若文件說能處理某個流程,demo 裡就要展示流程;若文件說能支援某個使用者場景,prototype 就要讓評審操作或觀看到這個場景。
第三是 user guide。評審時間有限,不會替你猜產品怎麼用。你要告訴他們 feature 是什麼、流程怎麼走、如何使用 prototype。如果作品需要特定帳號、資料或操作順序,也要講清楚。
第四是 demo video。Prashant 建議可以用 YouTube、Vimeo、MP4 或 Google Drive,但連結必須 public accessible。這一點非常實際:如果評審點不開,你的作品等於沒展示。影片最好有 voice over,讓人理解你如何使用作品、它解了什麼問題。
第五是 public GitHub repository。主辦方希望看到你怎麼使用技術、如何建置、如何整合 Google Cloud 與 AI。這意味著 repo 不是隨便丟 code;README、setup、architecture note、deployment instructions 都會影響評審理解。
另外,主持人與 Prashant 都提醒,submission text、documentation、presentation 要用 English。這是 APAC-wide hackathon,評審會跨國看 submissions。對非英語團隊來說,這不是小事;最後一週才翻譯文件,通常會出現語意不清、連結錯誤、demo 敘事斷裂等問題。
065. 評分邏輯|40% 技術實作,但不能只是「我用了 AI」
直播中講得最明確的評分項,是 technical merit 佔 40%。Prashant 說,評審會看你如何整合技術、如何使用 AI。他特別補了一句:不是把 prompt 丟給 AI、拿到 response,然後說「我用了 AI」就結束。
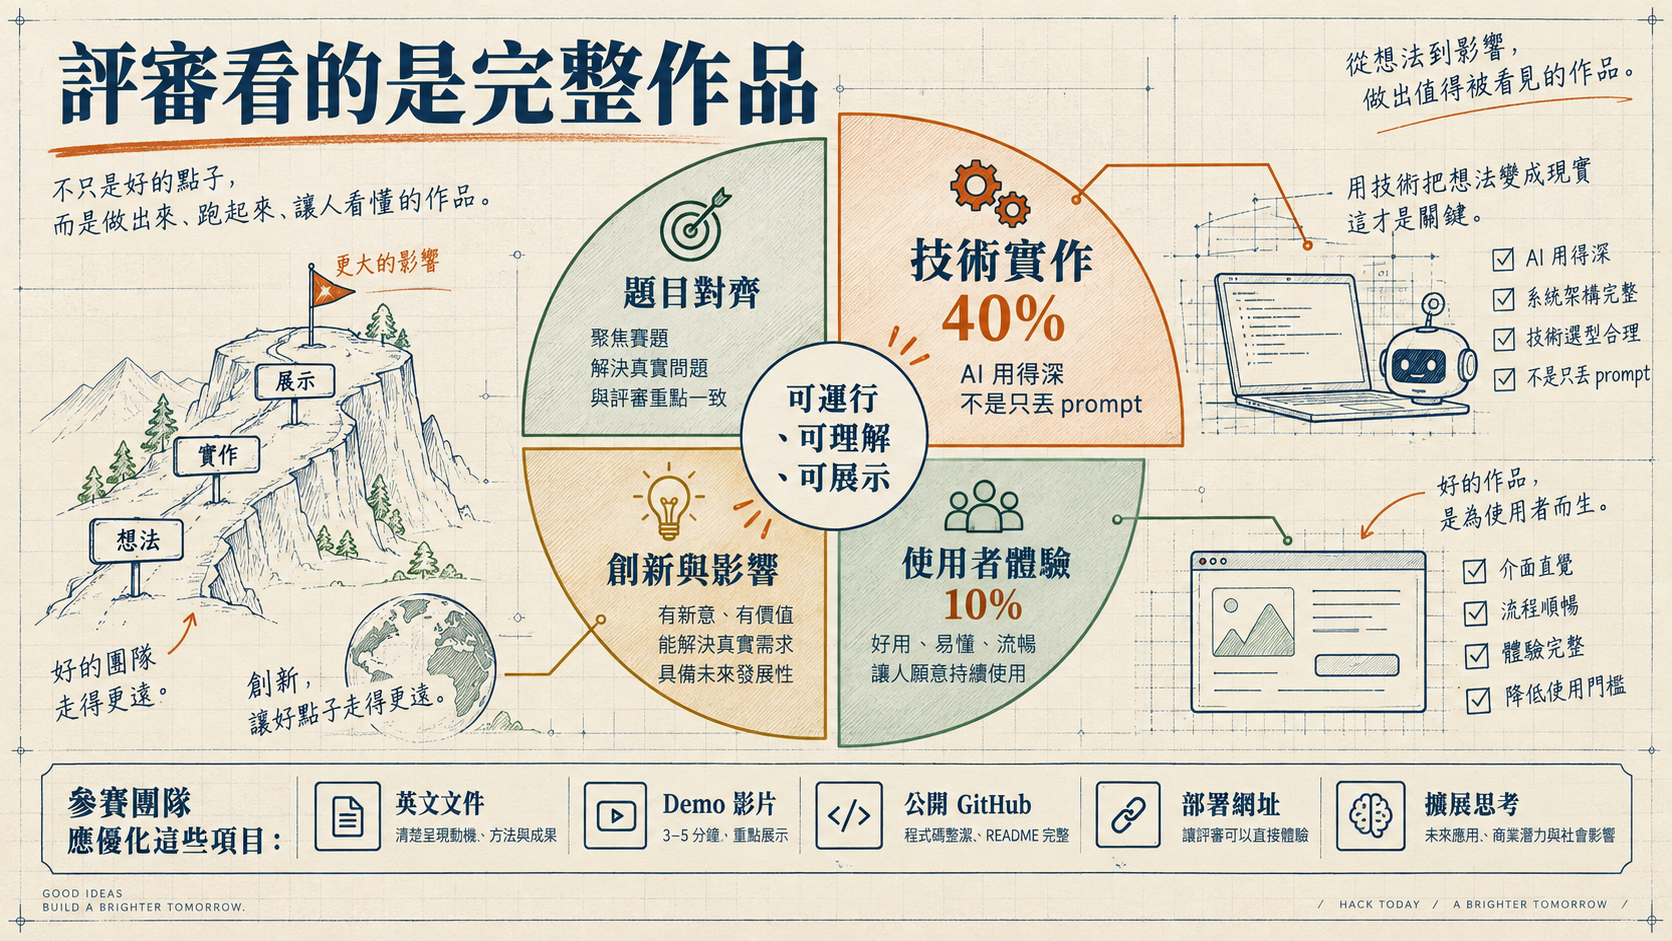
這句話幾乎可以當成所有 AI hackathon 的反作弊線。現在做一個 AI chatbot 太容易了,所以評審會問更深一層:你的 AI 在這個 domain 裡到底做了什麼?它有沒有理解資料?有沒有工具使用?有沒有 workflow?有沒有把使用者問題拆解?有沒有處理錯誤、延遲、權限、資料品質?有沒有用 Google Cloud 的能力完成部署與擴展?
第二個評分邏輯是 problem alignment。作品必須對齊六大 themes 與你選的 problem statement。如果你做了一個自己很喜歡、但無法對齊題目的作品,alignment 就會出問題。這也是為什麼文章前面一直強調從問題出發:不是因為工具不重要,而是工具要服務題目。
第三是 innovation and creativity。Prashant 鼓勵團隊做出讓人覺得「為什麼這只是 prototype,我希望它是正式產品」的體驗。這裡的創新不一定是發明新模型;也可以是把既有能力放進一個非常明確、非常有痛感的流程裡,讓 end users 真的得到新價值。
第四是 user experience and solution design,約 10%。他提醒 UX 不只是 flashy UI,而是使用者能不能走過 application、拿到價值、理解該怎麼使用。這對工程隊伍尤其重要:一個技術很強但評審跑不動、看不懂、點不出主要流程的作品,很容易輸給技術較簡單但敘事完整、體驗順的作品。
076. 參賽策略|從 problem statement 開始,然後做一條能被驗證的路
如果把這場說明會轉成行動清單,我會建議參賽隊伍用以下順序準備。
第一,選題時先寫「問題句」,不要先寫「技術句」。不好的起點是:「我們要做一個 Gemini + RAG + ADK agent。」比較好的起點是:「零售退貨流程中,客服與顧客都卡在狀態查詢、政策解釋與下一步建議,我們要把這段流程變成可對話、可追蹤、可升級的人機協作流程。」前者是工具清單,後者才是 problem statement。
第二,定義一個最短 demo path。評審看到作品時,應該在幾分鐘內理解:使用者是誰、痛點是什麼、輸入什麼、AI 做了什麼、輸出如何改變結果。不要把所有功能平均鋪開;hackathon demo 需要一條主線。
第三,先做最小可部署版本。Gemini 或 Gemini SDK、Cloud Run / Firebase、Firestore / SQLite / Cloud SQL,足夠就先跑起來。等核心流程成立,再決定是否需要 RAG、agent tools、BigQuery、Vector Search、caching 或更多雲端服務。
第四,儘早準備 submission artifacts。文件、demo video、public GitHub、部署網址,不是最後一天的雜事,而是作品的一部分。你需要讓評審相信:這個 prototype 有被認真思考過,知道怎麼操作,也知道未來怎麼走向 production。
第五,把 evaluation 想進去。Prashant 在 prompting 問題裡提到,如果做 data research、需要 accuracy,就應該考慮 eval。這點很值得延伸:不管是 RAG、agent、decision support 還是客服流程,只要輸出會影響使用者判斷,就應該有簡單的測試集、人工檢查或失敗案例說明。即使 hackathon 沒要求完整 eval framework,能展示你知道如何驗證 AI output,也會讓作品更成熟。
第六,別把 IP、語言、可存取性這些細節留到最後。直播中主持人說明,project IP remains with participant or team;文件應用英文;demo video 和 Drive link 要 public accessible。這些看似行政細節,實際上會直接影響評審能不能看見你的作品。
087. 編輯總結|真正的題目不是「用 AI」,而是「讓 AI 解一個可被驗證的問題」
這場說明會對 Builder 最有價值的地方,是它把 AI hackathon 的常見迷思拆開了。
不是用了 Gemini 就有技術深度。評審要看的是你如何把 AI 放進 domain workflow。
不是做了 agent 就比較高級。agent framework 要服務問題,不是問題反過來服務 agent。
不是畫出豪華架構圖就比較成熟。Prashant 明確建議,先用最小元件跑出可用 solution,再逐步補擴展性與可靠性。
不是提交 code 就完成。文件、demo video、public GitHub、部署網址、英文敘事、problem alignment,都是作品本體的一部分。
如果用一句話收斂:AI Builder Cup 要看的不是「我有一個 AI 點子」,而是「我選了一個具體問題,做出一個可運行、可理解、可展示、可部署的 AI solution」。這其實也是所有 AI product work 的縮影。模型只是其中一塊;真正決定作品能不能被相信的,是問題定義、使用者流程、技術取捨、驗證方式與展示能力。
對正在準備參賽的人來說,最好的第一步不是打開雲端產品頁,而是寫下三句話:
- 我們選哪個 theme,因為我們看見哪個真問題?
- 我們的 prototype 要讓評審在三分鐘內看到哪個 value moment?
- 如果這不是 hackathon demo,而是要進 production,下一步要補哪個可靠性或擴展性環節?
這三句話回答得越清楚,後面的 Gemini、ADK、RAG、Cloud Run、Firebase、Firestore、BigQuery 才會各自回到正確的位置。