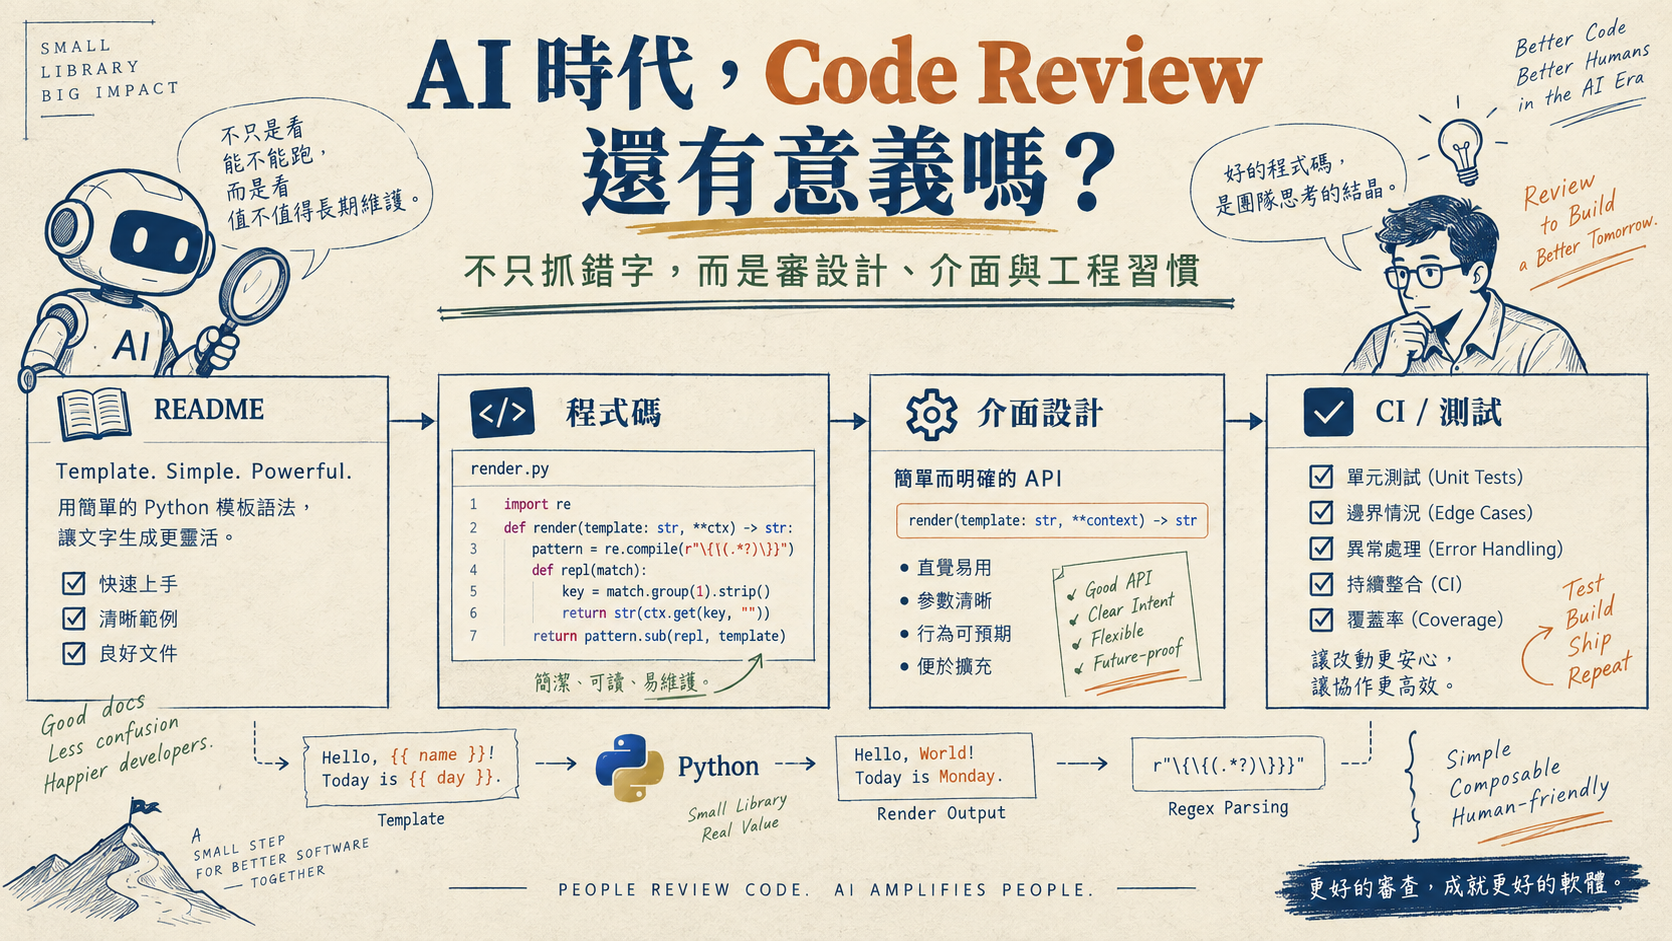
010. 導言|AI 讓低階問題變少,卻沒有讓 Code Review 失效
編輯轉述:當 AI 已經能補齊很多瑣碎細節,Code Review 的價值不會消失,而是被迫往更高一層移動。
這支影片的題目很直接:AI 時代,Code Review 還有意義嗎?
碼農高天沒有用抽象口號回答,而是拿一個很小的 Python 模板解析庫做示範。這個專案大約不到 170 行,核心功能也不複雜:使用者提供一段模板,再提供一段字串,函式庫會依照模板裡的大括號內容,把原始字串拆出欄位並轉成指定型別。影片來源是 YouTube 上的《【Code Review】AI时代的CR还有意义么?一起看一个模板解析库》。
如果只看表面,這種專案很適合被 AI 補完。命名、縮排、formatter、簡單的 type hint、README 範例,現在都不再是最稀缺的工程能力。影片也承認這一點:AI、linter、formatter 會讓「很蠢的小問題」變少,傳統 Code Review 裡常見的低階瑕疵,確實不再那麼常出現。
但這並不代表 Code Review 沒事可做。
相反地,這支影片有用的地方,正是它示範了「看起來乾淨」不等於「設計已經想清楚」。一個小型 library 可以沒有太多語法錯誤,卻仍然有介面心智模型的問題;可以用了泛型與 Python 新功能,卻仍然讓使用者重複輸入相同資訊;可以包出 decorator,卻未必真的增加抽象價值;可以有測試,卻沒有 coverage 與 CI gate。
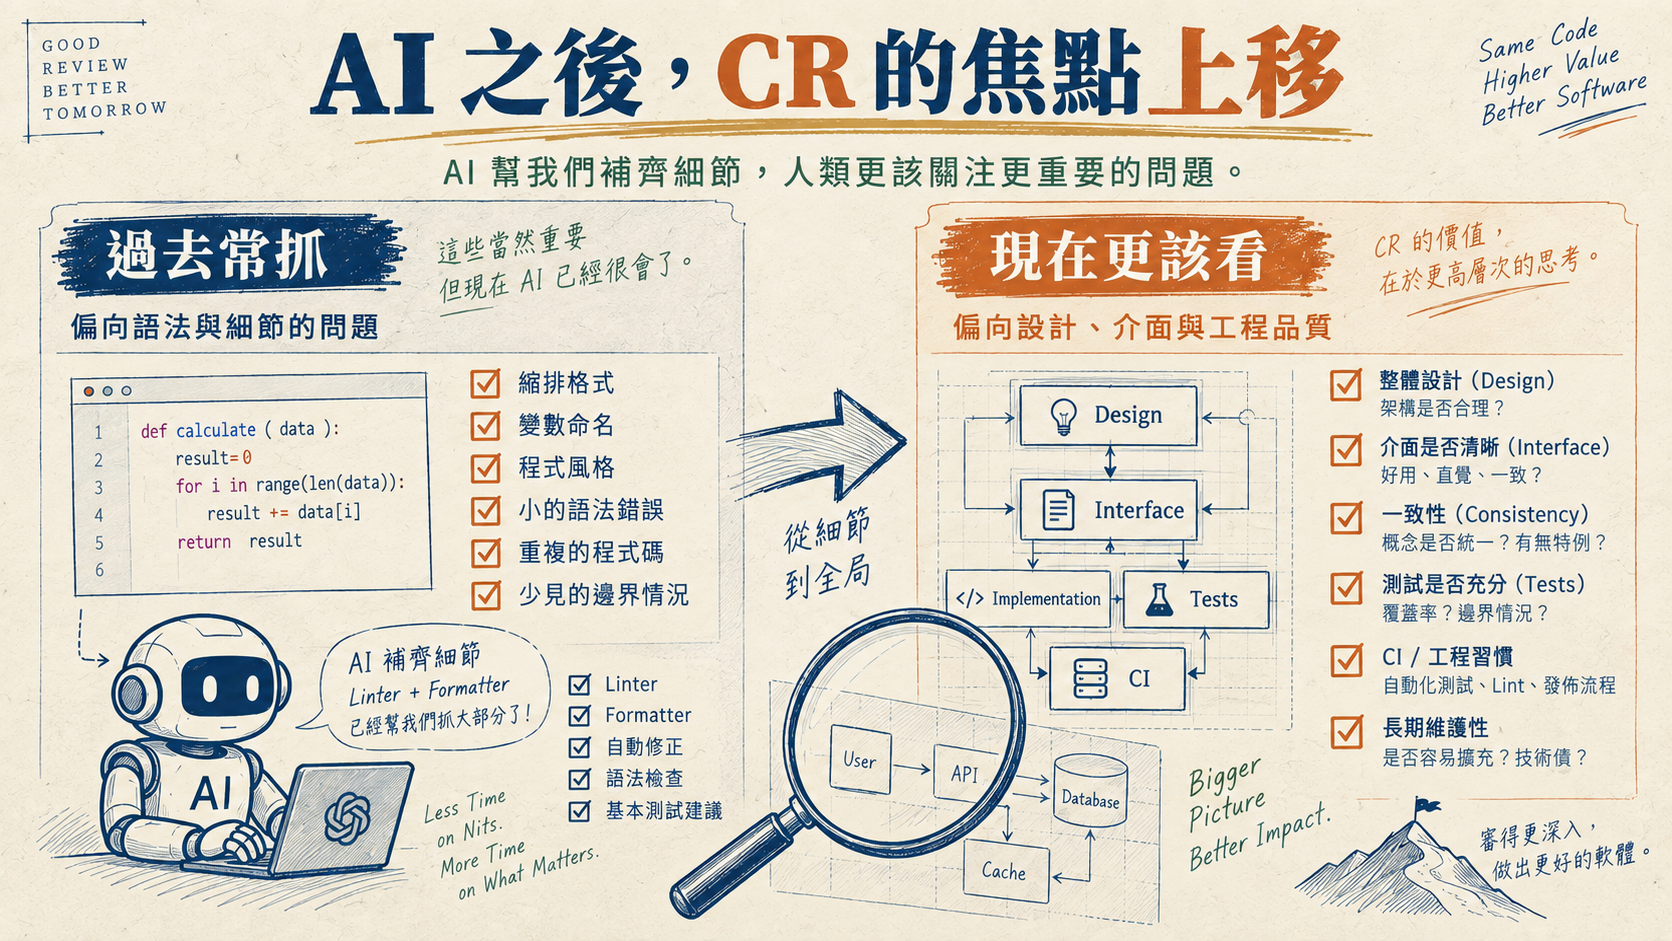
所以這篇導讀不會把焦點放在「這個小庫寫得好不好」這種單點判斷。更值得看的,是碼農高天透過它提出的審查方法:先看這個專案想提供什麼能力,再看 API 是否符合使用者直覺,接著看抽象是否真的降低複雜度,最後看它是否具備一個正式專案應有的品質門檻。
這其實也是 AI coding 普及後,工程師更需要保留下來的能力。AI 可以生成一段看起來合理的 code,卻不會自動替你問:「這個介面會不會讓使用者誤解?」「這個特例是不是破壞了整套語義?」「這個專案發布前,有沒有測試與 CI 擋住回歸?」
Code Review 還有意義,只是它不該停在挑錯字。
給讀者的 Takeaway
AI 讓 Code Review 的低階工作變少,但也讓高階審查變得更重要。真正值得保留的不是「抓到幾個小 bug」的成就感,而是對設計、介面與工程系統保持敏感。
021. 這個模板解析庫在做什麼|從字串裡提取結構化資料
編輯轉述:一個小 library 的 review,要先尊重它的核心任務;理解問題域,比急著改寫程式更重要。
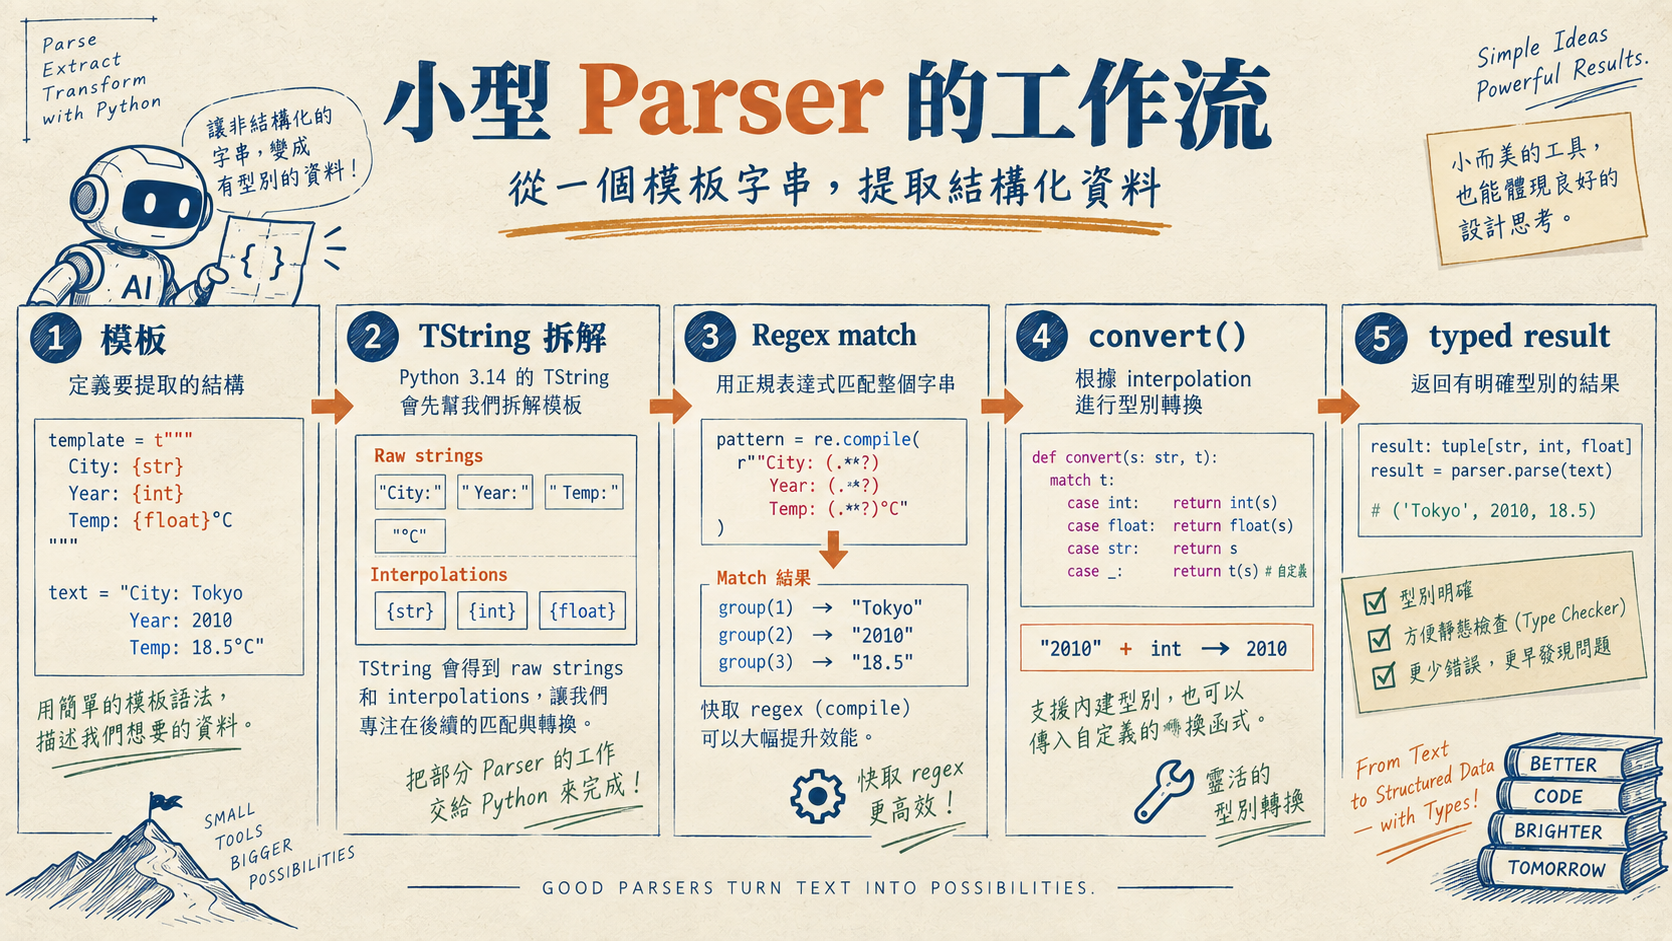
影片中的專案是一個模板解析庫。它的用法大致是:你先給一段模板,例如字串裡哪一段應該是城市、哪一段應該是年份;接著給一段真實輸入;library 依照模板,把輸入字串裡的片段取出來,並依照大括號中的設定轉成對應型別。
例如模板裡標示某個欄位是 str,解析結果就保留字串;標示某個欄位是 int,解析結果就把對應片段轉成整數。影片特別提到,這個 library 的有趣之處,是它嘗試把泛型也放進 API 設計裡,讓呼叫端可以提示返回值的型別,對 type checker 比較友善。
從實作上看,這個專案把大部分邏輯放在單一檔案裡。碼農高天的態度很務實:專案非常小,這樣做不是不能接受;但如果要把它當成可維護的 library,拆分檔案仍然比較清楚。這裡不是「單檔一定錯」,而是「單檔會把不同責任混在一起」,等專案稍微長大,閱讀成本就會上升。
核心類別是 parser。它用 type variable 表示輸入型別會影響輸出型別,這是很典型的 generics 用法。它也借用了 Python 3.14 引入的 TString,讓 Python 先幫忙拆出 raw string 與 interpolations。換句話說,這個 library 沒有完全從零寫 parser,而是把一部分解析責任交給語言本身的新能力。
這是一個值得肯定的設計方向。小工具能不能活下來,常常取決於它是否精準使用現有語言機制,而不是自己重造整套語法系統。TString 已經能告訴你哪些是原始字串、哪些是模板插值,library 再把這些資訊接上 regex match 與 conversion,就能用很少程式碼完成一個可展示的功能。
影片也肯定了幾個工程細節。比如 regex 被提前 compile,且用 cached property 保存;如果同一個 pattern 要反覆 match,這比每次都重新建立 regex 更合理。這些不是文章的主角,但它們提醒我們:好的 Code Review 不是只找問題,也要辨識哪些地方值得保留。
真正的討論,從「這段程式能跑」之後才開始。
這正是小型 library review 最有意思的地方。因為規模小,bug 可能不多;但正因為規模小,API 設計與心智模型會被放大。使用者第一次看 README 時,能不能理解大括號裡該放什麼?型別資訊為什麼要寫兩次?自定義 conversion 是不是符合 Python 使用者直覺?這些問題比少一個空格更接近 library 的生死線。
給讀者的 Takeaway
Review 小專案時,先看它有沒有把問題拆對。語法正確只是底線;真正決定使用者會不會採用的,是 API 是否讓人一眼理解,且能自然延伸。
032. AI 時代的 CR 焦點|從語法細節轉向專案判斷
編輯轉述:當機器能把 code 修得像 code,人類 review 的位置就不能只停在「像不像」。
影片中間有一段很關鍵:現在在 AI 的加持下,已經很難像以前那樣,在 Code Review 裡找出一堆細節上的小問題。不是因為人類突然更嚴謹,而是因為 AI、linter、formatter 把很多低階錯誤提前消掉了。
這個觀察很真實。縮排錯、命名格式不一致、少幾個 type hint、重複幾行 boilerplate,這些過去會佔掉 review 很多篇幅的問題,現在常常在提交前就被工具處理。甚至當 AI 生成初版程式碼時,它本來就會產出某種「看起來合理」的形狀。
但「看起來合理」是一個危險的狀態。它會降低 reviewer 的警覺,讓人以為沒有紅色波浪線就代表設計也沒問題。
碼農高天這支影片的價值,正是把 review 的焦點往上推。他不是在問「這個變數名合不合 PEP 8」,而是在問幾個更難自動化的問題:
第一,這個 library 的入口是否符合使用者心智模型?parse 被設計成小寫 class,是因為作者希望它在使用者感受上像一個 function。這個 hack 是為了泛型能力服務,所以可以被理解。但如果 parse 可以小寫,為什麼 decorator 形式的 Conversion 又回到大寫 class?一致性開始變成問題。
第二,抽象是否真的增加資訊?conversion 與 format conversion decorator 看起來讓功能更正式,但如果它只是把原始函式包住,沒有做檢查,也沒有給 type checker 額外資訊,那它可能只是多一層儀式,而不是必要抽象。
第三,特例是否破壞了整體語義?前面如果都是 class 或 function,使用者會建立一個直覺:大括號裡的東西,就是把字串轉成值的那個 callable。此時突然讓 json module 本身擁有特殊意義,就會打斷這個規則。
第四,專案是否有足夠工程護欄?有測試不等於有品質保證;沒有 coverage,就不知道測試覆蓋了多少;GitHub Actions 只有 publish,沒有 test、lint、format,就表示 release 之前缺少自動檢查。
這些問題不一定是 AI 永遠做不了的事。影片也沒有把 AI 描述成完全無能。重點在於:它們通常不是「請幫我寫一個專案」就會自動完整出現的能力。你需要知道要問什麼,才有機會讓 AI 補上答案。
這就是 AI 時代 Code Review 的重新定位:不是跟 AI 搶著抓逗號,而是幫團隊維持工程判斷的問題清單。
給讀者的 Takeaway
工具越會修細節,人越要負責問大問題。Code Review 不該變成格式審查,而應該變成產品介面、抽象成本與工程品質的共同討論。
043. 泛型、TString 與使用者直覺|好的 API 不要求你說兩次
編輯轉述:型別資訊對機器有用,但如果使用者必須在兩個地方重複表達同一件事,介面就開始漏水。
這個 library 的一個核心賣點,是它嘗試和 type checker 合作。呼叫者可以在泛型位置標示期望的輸出型別,例如某欄位應該是 str,某欄位應該是 int。這讓 IDE 與 type checker 更容易理解 parse 結果。
碼農高天認同這個方向,也理解某些 hack 的必要性。比如 parse 明明是 class,卻被設計成小寫,因為作者想讓它在使用者感受上像 function;而這樣做的原因,是現階段 Python 函式泛型能力仍有局限,所以作者用 class 包出需要的型別效果。
問題出在下一步:如果外層泛型已經告訴系統返回值型別,模板內部是不是還需要再寫一次同樣的型別?
影片裡的例子指出,string 與 int 會在兩個地方出現。前面的 generics 是給 type checker 的,可能不得不寫;但大括號裡如果仍然要求使用者再寫一次 int,那對常見情境來說,就形成了重複輸入。
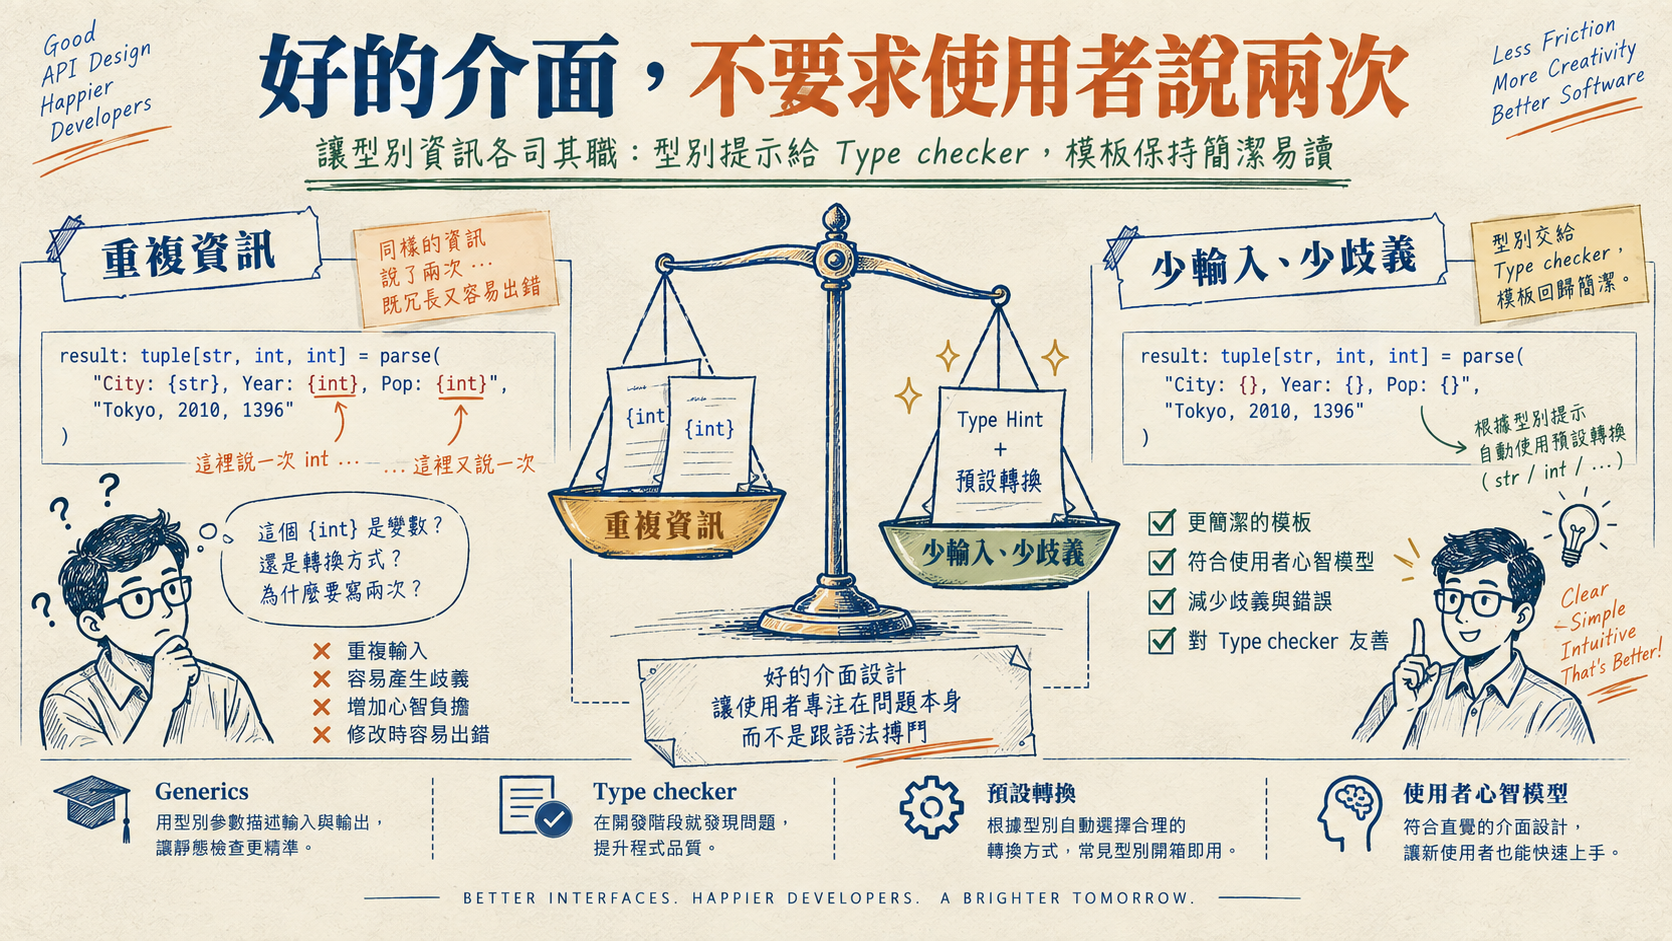
這裡的設計原則很值得記住:在沒有歧義的情況下,讓使用者輸入越少越好;尤其是同樣的資料,不要要求使用者輸入兩次。
這不只是懶人哲學,而是 API 設計的可靠性問題。重複資訊會帶來同步成本。如果泛型位置寫了 int,模板裡卻寫了 str,到底哪個才是事實?如果兩者本來就必須一致,系統是否應該自動推導?如果不能自動推導,錯誤訊息是否足夠清楚?
好的介面應該盡量讓不一致無法發生,而不是要求使用者記得不要犯錯。
影片後半段也提到另一個直覺問題:在 f-string 或 t-string 的語境裡,大括號裡通常代表「要被替換或關聯的值」。如果使用者看到 {percent},直覺上可能會以為它是某個被提取的欄位名,而不是「用 percent 這個函式轉換原始字串」。
這種問題很細,但很重要。library 的語法不是只給作者自己看的,而是要借用使用者已經熟悉的語言直覺。當一套 API 借用了 Python 的大括號語法,使用者會自然帶著 f-string 的心理模型進來。設計者可以改變這個模型,但要付出解釋成本。
碼農高天提出的替代方向,是利用 TString 已經提供的 format spec。冒號後面的格式規格,本來就更接近「如何轉換」的語義。如果把 conversion 放在 format spec 的位置,可能比直接把轉換函式塞進大括號更符合直覺。
這不表示影片提出的替代方案就是唯一答案。真正重要的是那個 review 問題:你的 API 借用了哪個語言慣例?使用者會怎麼理解它?你是在順著這個慣例設計,還是在反著它設計?
給讀者的 Takeaway
API 設計不是只讓 type checker 開心。好的介面要同時照顧機器與人:能推導就不要重複,能沿用既有語義就不要發明新語義。
054. Decorator 的價值|抽象如果不增加資訊,就只是包裝
編輯轉述:抽象本身不是美德。每多一層抽象,都應該換回檢查、約束、語義或可讀性。
影片中最像工程 review 的一段,是對 conversion 與 format conversion decorator 的質疑。
這套設計看起來很漂亮:使用者可以定義一個 percent 函式,讓 "30%" 這種字串轉成 0.3 之類的 float;再透過 decorator 標記這個函式是一種 conversion。從 README 角度看,這很有 library 感,也讓範例顯得完整。
但碼農高天往下追問:這個 decorator 到底帶來了什麼?
如果大括號裡放的是 percent,而 parse 時會在作用域中找到這個函式,再把字串餵進去轉成值,那麼 conversion 的本質就是一個 callable。此時 decorator 可能有兩個用途:第一,明確宣告這個函式是一種 conversion;第二,區分一般 conversion 與 format conversion 的參數數量。
問題是,在影片中的實作裡,decorator 似乎沒有做足夠檢查,也沒有替 type checker 提供更多資訊。它主要只是把原始函式保存起來,等到真正 convert 時再拿出來呼叫。
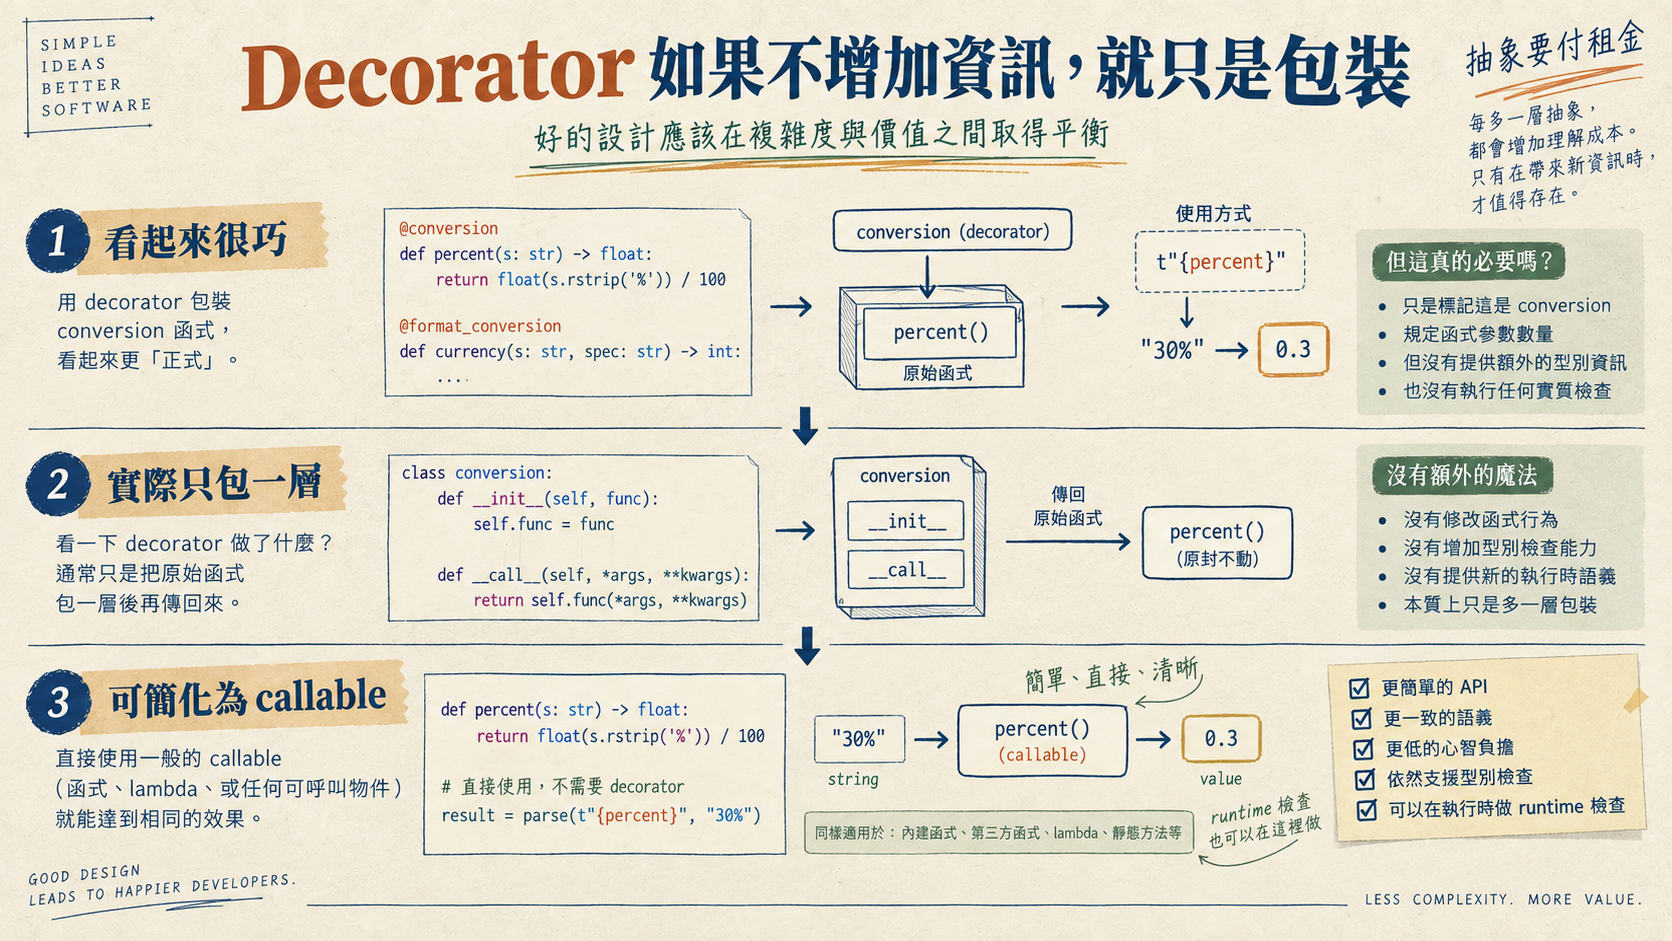
這就是抽象成本的問題。
一層抽象若能帶來明確收益,值得保留。例如它可以驗證函式簽名、生成更好的錯誤訊息、註冊 conversion registry、限制可用格式,或讓 IDE 推導出更準確的型別。這些都是真實價值。
但如果 decorator 沒有做這些事,只是為了「看起來像 framework」而存在,它就會增加學習負擔。使用者原本只需要理解「傳一個 callable」,現在要多理解一個裝飾器類別、一套註冊語義,以及 conversion 與 format conversion 的差別。
影片的建議很乾脆:也許根本不需要 conversion 與 format conversion。使用者直接傳函式就好;至於函式吃幾個參數、有沒有 format spec,可以在 runtime 透過 introspection 得知。
這個判斷不一定適用所有 library。大型框架常常需要 decorator,因為它們必須累積 metadata、做註冊、產生文件、連接 DI container 或框架生命週期。但在一個不到 170 行的小型 parser library 裡,抽象的存在更應該被嚴格審視。
這也是 AI 生成程式碼常見的風險之一。AI 很擅長生成看起來正式的結構:decorator、base class、registry、manager、adapter。這些東西讓程式碼看起來像成熟專案,卻可能在還沒有需求時就把複雜度引進來。
Code Review 要問的不是「這個 pattern 漂不漂亮」,而是「它有沒有付房租」。
給讀者的 Takeaway
不要把抽象當成專業感。每一層 wrapper 都應該換回可驗證的價值;如果沒有,它可能只是把簡單問題變成 framework 問題。
065. 一致性比巧思重要|JSON 特例為什麼讓人卡住
編輯轉述:介面的隱形文件,是它前面建立過的規則;一旦特例破壞規則,使用者就要重新學整套語言。
影片後段點名批評 json 的處理方式,這是整支 review 裡最能說明「一致性」的一段。
在前面的設計中,大括號裡放的東西大致可以被理解為 class 或 function。使用者建立的心理模型是:我把 match 到的字串餵給這個東西,它會回傳我想要的值。int 可以把字串轉成整數,float 可以把字串轉成浮點數,自定義 percent 也可以把百分比字串轉成數值。
這套規則不一定完美,但至少一致。
可是到了 JSON,設計突然變成:把 json module 放進大括號裡,library 會理解成要用 json.loads 把字串轉成 dict 或 list。
這裡的問題不是「JSON 不該被支援」。問題是 json module 本身不是 callable。使用者不能把字串直接餵給 module,得到 dict 或 list。這代表 library 在這裡自己發明了一個特殊語義:只要看到 json 這個 module,就把它解讀成一種 JSON parsing 指令。
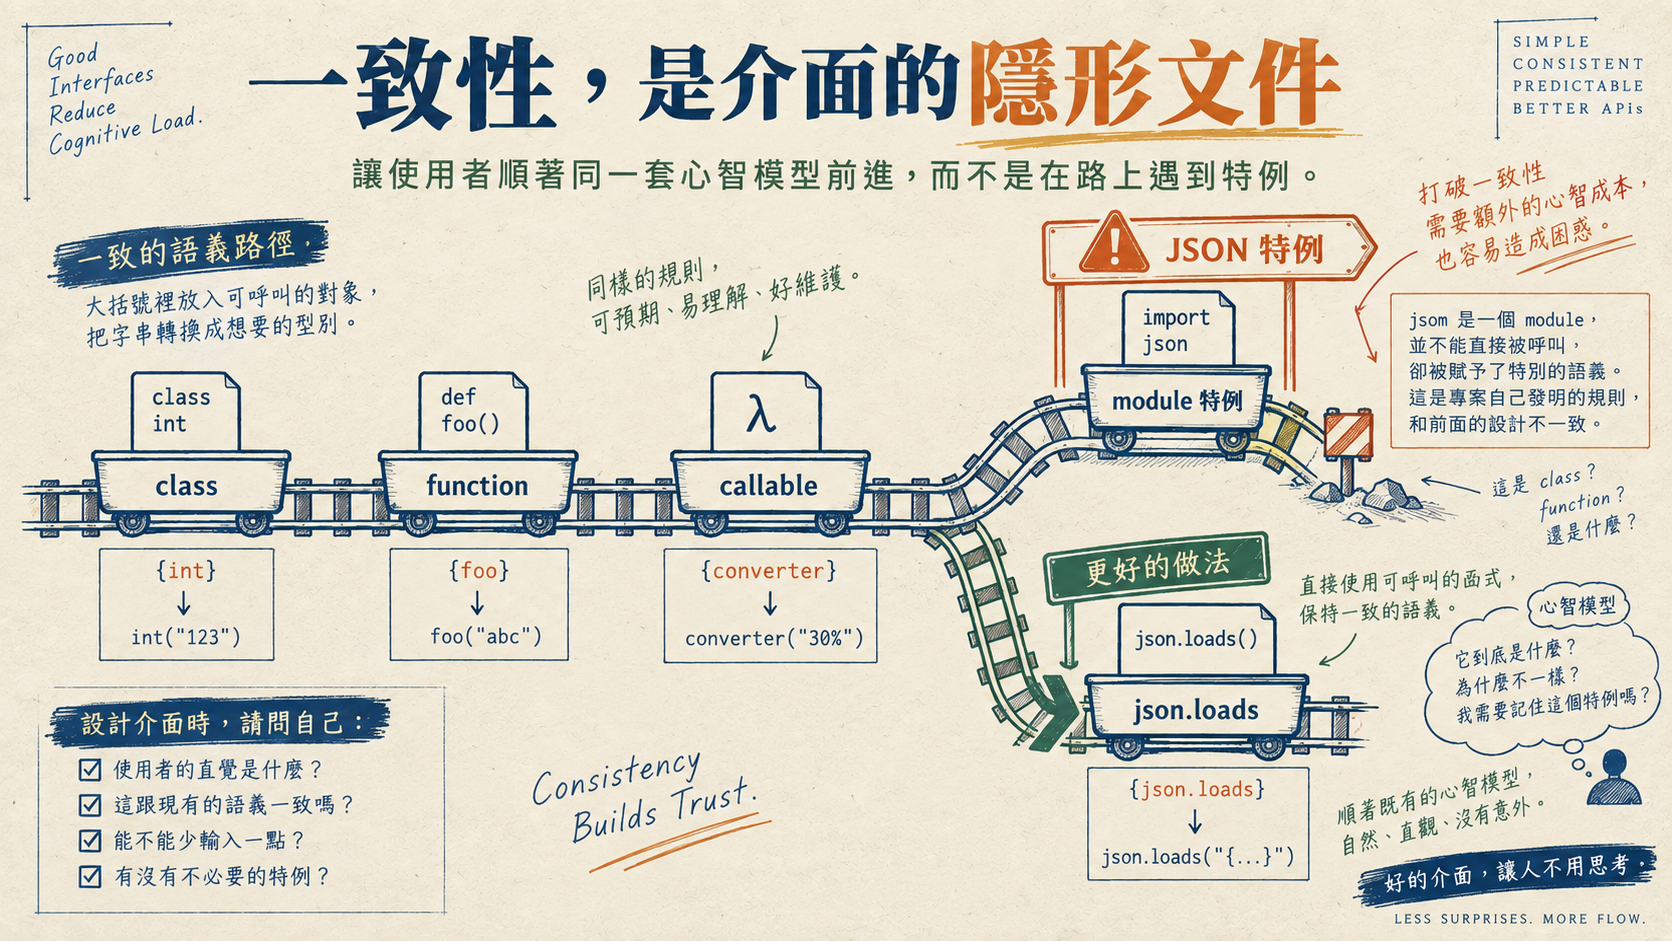
這種特例會讓使用者心智模型斷裂。前面他學到的是「大括號裡放可以轉換字串的東西」,後面突然變成「有些 module 也可以,但不是因為 module 可以呼叫,而是 library 對某些 module 開了特例」。一旦這扇門打開,使用者就會開始問:還有哪些 module 有特權?我能不能放 yaml?能不能放 tomllib?如果不行,為什麼 JSON 可以?
影片提出的替代方式很簡單:如果要 parse JSON,直接讓使用者寫 json.loads。它本來就是 callable,也符合前面的規則。這樣甚至不需要額外定義一個特殊語義。
這個點看似微小,實際上是 library 設計的核心。API 一致性不只是美感,它是文件的一部分。當設計一致時,使用者學會一個例子,就能推導下一個例子;當設計靠特例堆出來時,每個新功能都要重新讀文件。
影片還延伸到 runtime type check。如果 library 支援 list 與 dict,那解析出來的 JSON 是否真的符合使用者期望?如果使用者要求 dict,但 JSON 字串其實是 array,是否應該報錯?如果這個 library 已經很在意 type,那麼在 runtime 做一層 enforcement 可能更一致。
這裡不是主張所有 Python library 都要變成嚴格型別系統,而是指出一個設計承諾:你既然用泛型、type hint 與型別 conversion 作為賣點,就應該想清楚 runtime 行為要不要跟這個承諾對齊。
給讀者的 Takeaway
特例是 API 設計裡最昂貴的功能。能用既有規則表達,就不要開新語義;能放 callable,就不要讓 module 擁有神秘權力。
076. 正式專案還缺什麼|測試、Coverage 與 CI 才是品質門檻
編輯轉述:程式碼會跑,是 demo;變更能被自動檢查,才開始像專案。
影片最後把視角拉回工程系統。
作為小專案,這個 library 的根目錄內容大致完整,也有測試。但碼農高天指出,只有測試還不夠。如果沒有 coverage data,你不知道測試覆蓋了哪些路徑,也不知道哪些錯誤情境完全沒被碰到。
GitHub Workflow 也只有 publish,用來上傳 wheels,沒有 test、lint、format。這代表 release 流程可以把包發出去,卻沒有在發出去之前確認它仍然通過測試。對一個展示型小庫來說,這未必是致命傷;但如果作者真的希望它成為一個正式專案,CI gate 就該補上。
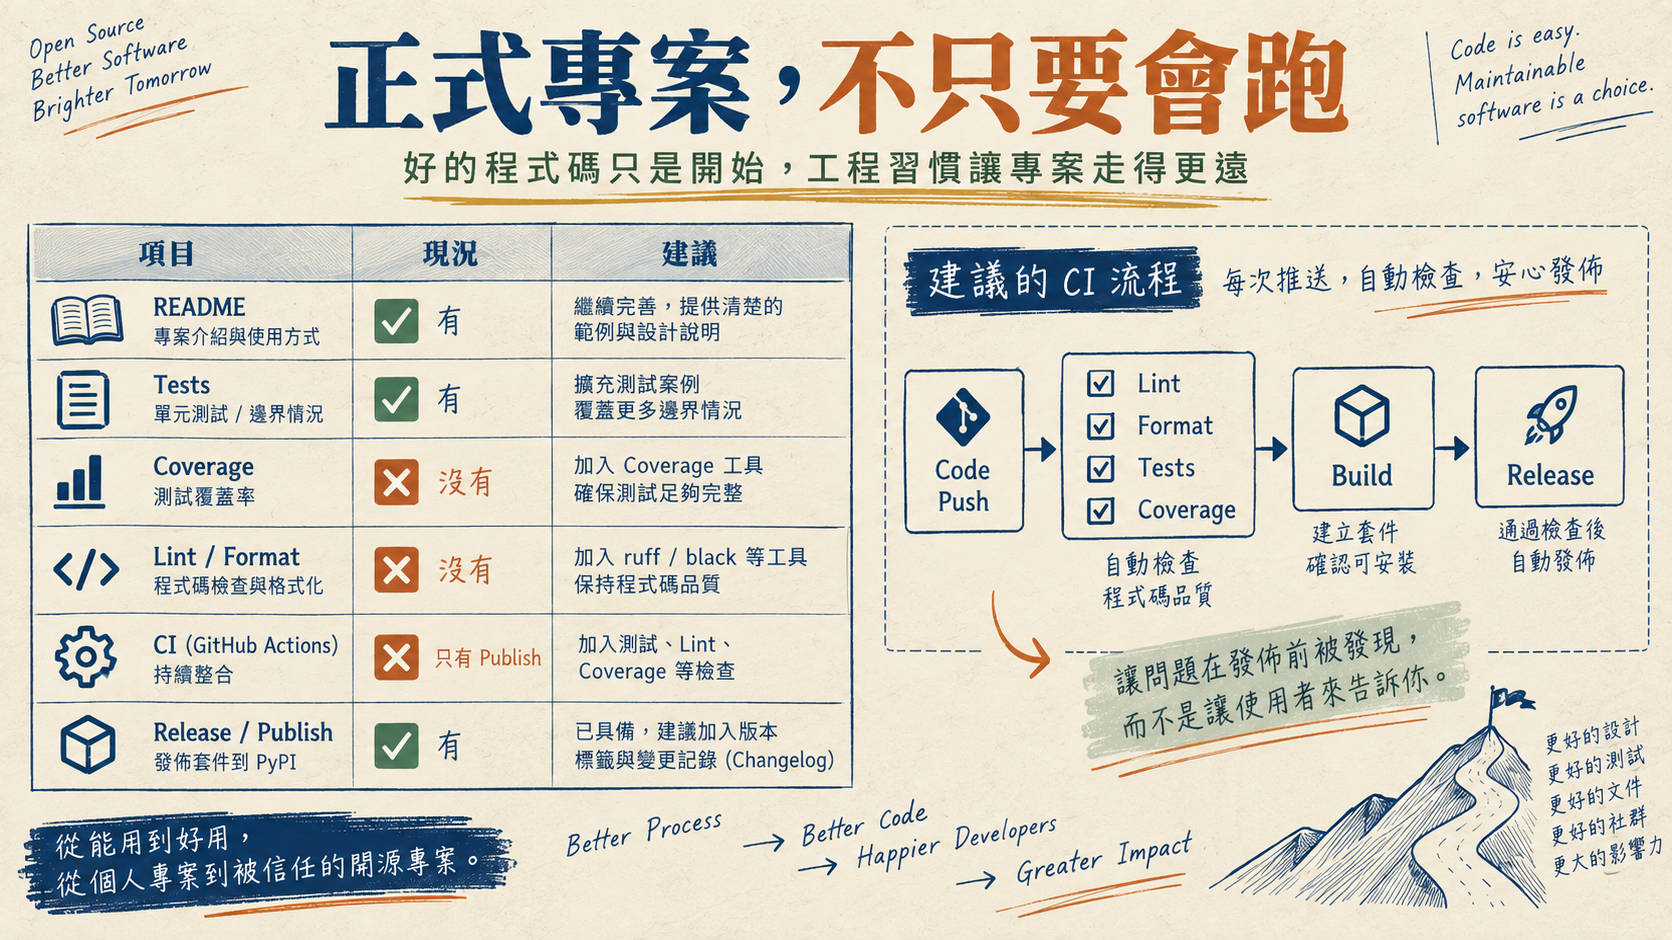
這個提醒尤其適合 AI coding 時代。
AI 很會幫你生成功能,卻不一定會主動替你建立品質系統。它可能寫出 README、範例、幾個單元測試,甚至幫你配置 publish workflow;但如果你沒有要求,它未必會把測試放進 CI,也未必會思考 coverage 門檻、edge cases、錯誤訊息、release 前檢查。
這不代表 AI 不能做。它可以做,而且做得很快。關鍵是工程師腦中要有這條線:任何可被外部使用的 library,都不只是一份 code file,而是一組使用者承諾。你承諾 API 穩定,承諾錯誤可理解,承諾版本發布前有基本檢查,承諾未來修改不會默默破壞既有行為。
Code Review 在這裡扮演的角色,是把「功能完成」往「專案可維護」推一步。
如果是一個內部 throwaway script,或許 README 好不好、coverage 有沒有都不重要。但這個影片 review 的對象是一個公開 library,且主題是解析與型別轉換。這類工具一旦被別人依賴,最容易出問題的地方不是 happy path,而是邊界輸入、錯誤格式、型別不符與版本升級。
因此,一份好的 review 應該問:
- 是否有測試涵蓋內建型別、自定義 conversion、format spec、JSON、錯誤輸入與 ambiguous template?
- 是否有 coverage 報告,能看見沒測到的分支?
- CI 是否在 PR 或 push 時自動跑 test、lint、format?
- publish workflow 是否依賴測試通過,而不是單獨存在?
- README 是否清楚說明大括號裡的語義,以及哪些情況會報錯?
這些問題不是「吹毛求疵」。它們是把 demo 變成專案的橋。
給讀者的 Takeaway
AI 可以幫你寫功能,但工程師要記得補上品質門檻。公開 library 的最低標準,不只是能 import,而是每次變更都能被自動檢查。
087. 結語|AI 時代的 reviewer,要培養的是提問能力
編輯轉述:AI 可能有很好的建議,但前提是你知道要把它帶到哪個問題上。
回到開頭的問題:AI 時代,Code Review 還有意義嗎?
這支影片的答案其實很克制。它沒有把 AI 描述成威脅,也沒有把人類 reviewer 神化。它只是示範:當 code 表面越來越像樣,review 的價值就更取決於你是否能提出更好的問題。
在這個小型模板解析庫裡,值得談的不是縮排,而是 parse 為什麼要用小寫 class;不是 regex 會不會跑,而是模板語義是否符合使用者直覺;不是 decorator 有沒有成功包住函式,而是它是否真的增加資訊;不是 JSON 能不能 parse,而是它是否破壞了前面建立的語義一致性;不是有沒有測試,而是測試有沒有進入 CI,成為發布前的品質 gate。
這些問題都不神秘,但它們需要 reviewer 腦中有一張地圖。地圖上有 API 設計、語言慣例、型別系統、runtime behavior、測試策略、release workflow。AI 可以幫你探索每一塊,但你要知道要去哪裡。
這也是工程師在 AI coding 時代仍然值得培養的能力:不是把每行 code 都手刻,而是能判斷一段 code 是否形成好的產品介面與工程系統。
Code Review 不該被理解成「人類最後的挑錯權」。更好的定位是:團隊共同校準軟體判斷的時刻。
當 AI 讓生成速度變快,這個校準反而更重要。因為越容易生成,越容易累積看似合理但缺乏一致性的抽象;越容易補功能,越容易忘記測試與 CI;越容易產出漂亮 README,越容易忽略使用者第一次理解 API 時會卡在哪裡。
所以,Code Review 的意義沒有消失。它只是從「這行 code 寫錯了」移向「這個設計會不會讓未來的人付出代價」。
給讀者的 Takeaway
AI 時代的 reviewer,不是比較會抓語法的人,而是比較會追問設計代價的人。你要培養的不是對 AI 的不信任,而是讓 AI 也必須面對好問題的能力。