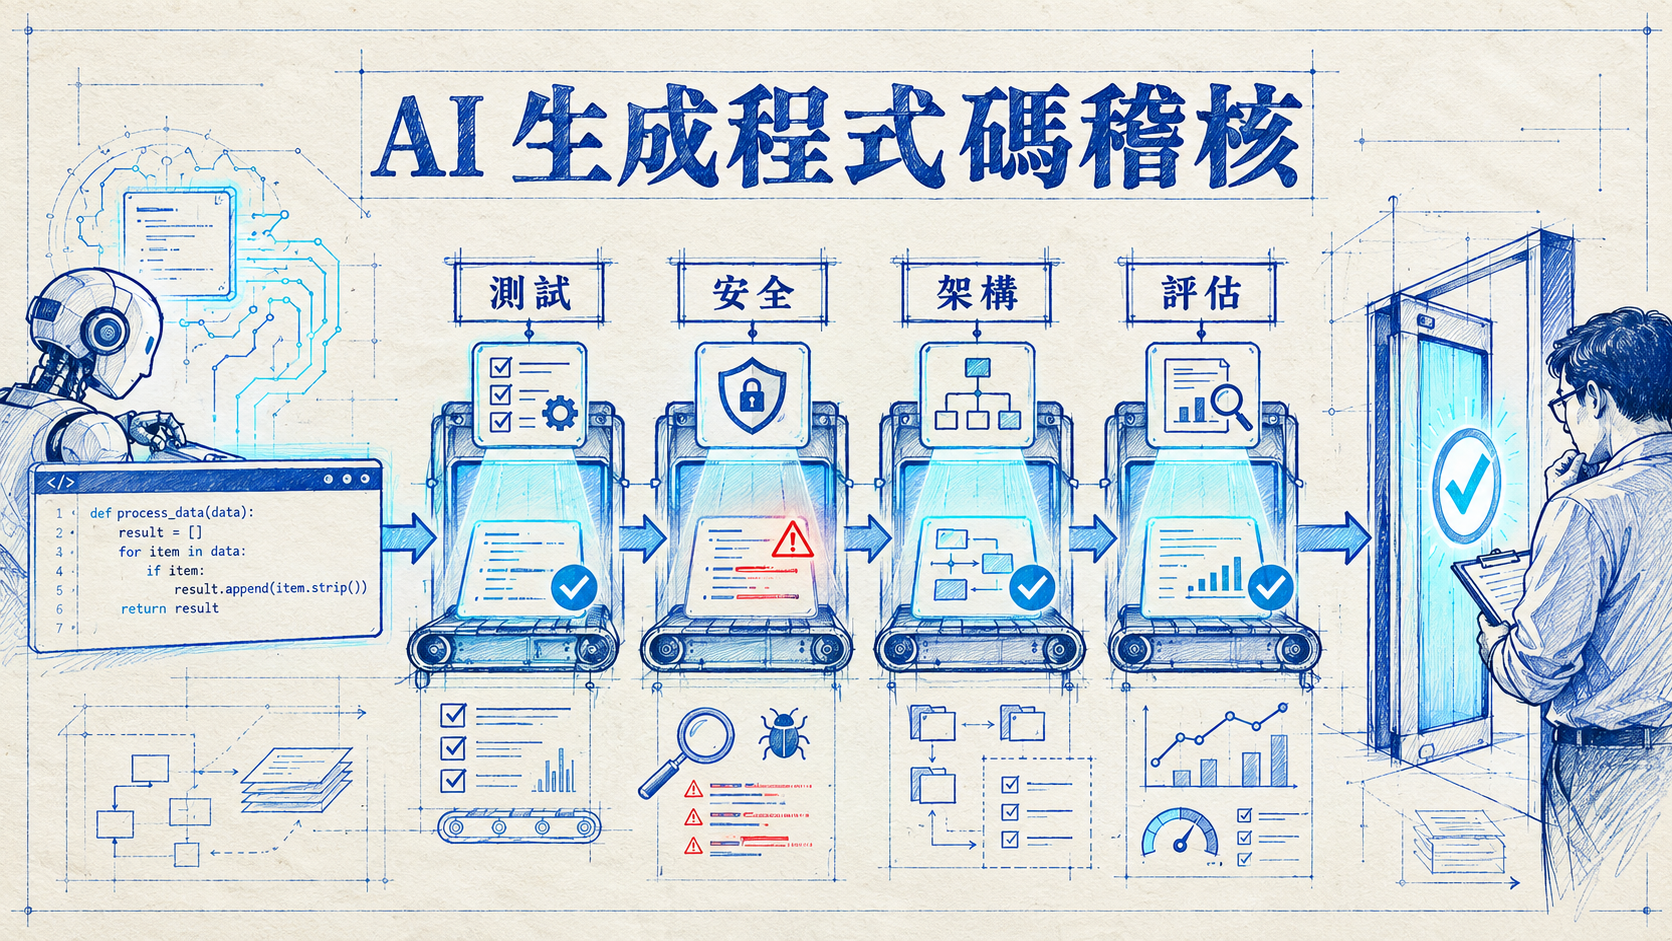
0. 先看結論|Vibe coding 與軟體工程的差別,是誰負責證明它可以信任
AI coding 最危險的地方,通常不是程式碼一眼就錯,而是它看起來非常合理:有型別、有例外處理、有 retry、有測試,CI 甚至全綠。人很容易在這個時刻停止追問,把「像工程」誤認成「已經被驗證的工程」。
Cheuk Ting Ho 的 Audit and evaluate AI generated code 工作坊 repo 和 完整投影片 正好拆解了這個盲點。這不是一份叫大家「多做 code review」的宣導,而是一個可操作的練習:用一個名為 accountsync 的 Python client library,刻意把多種非顯而易見的錯誤埋進看似成熟的專案,再要求參與者逐層把它們逼出來。
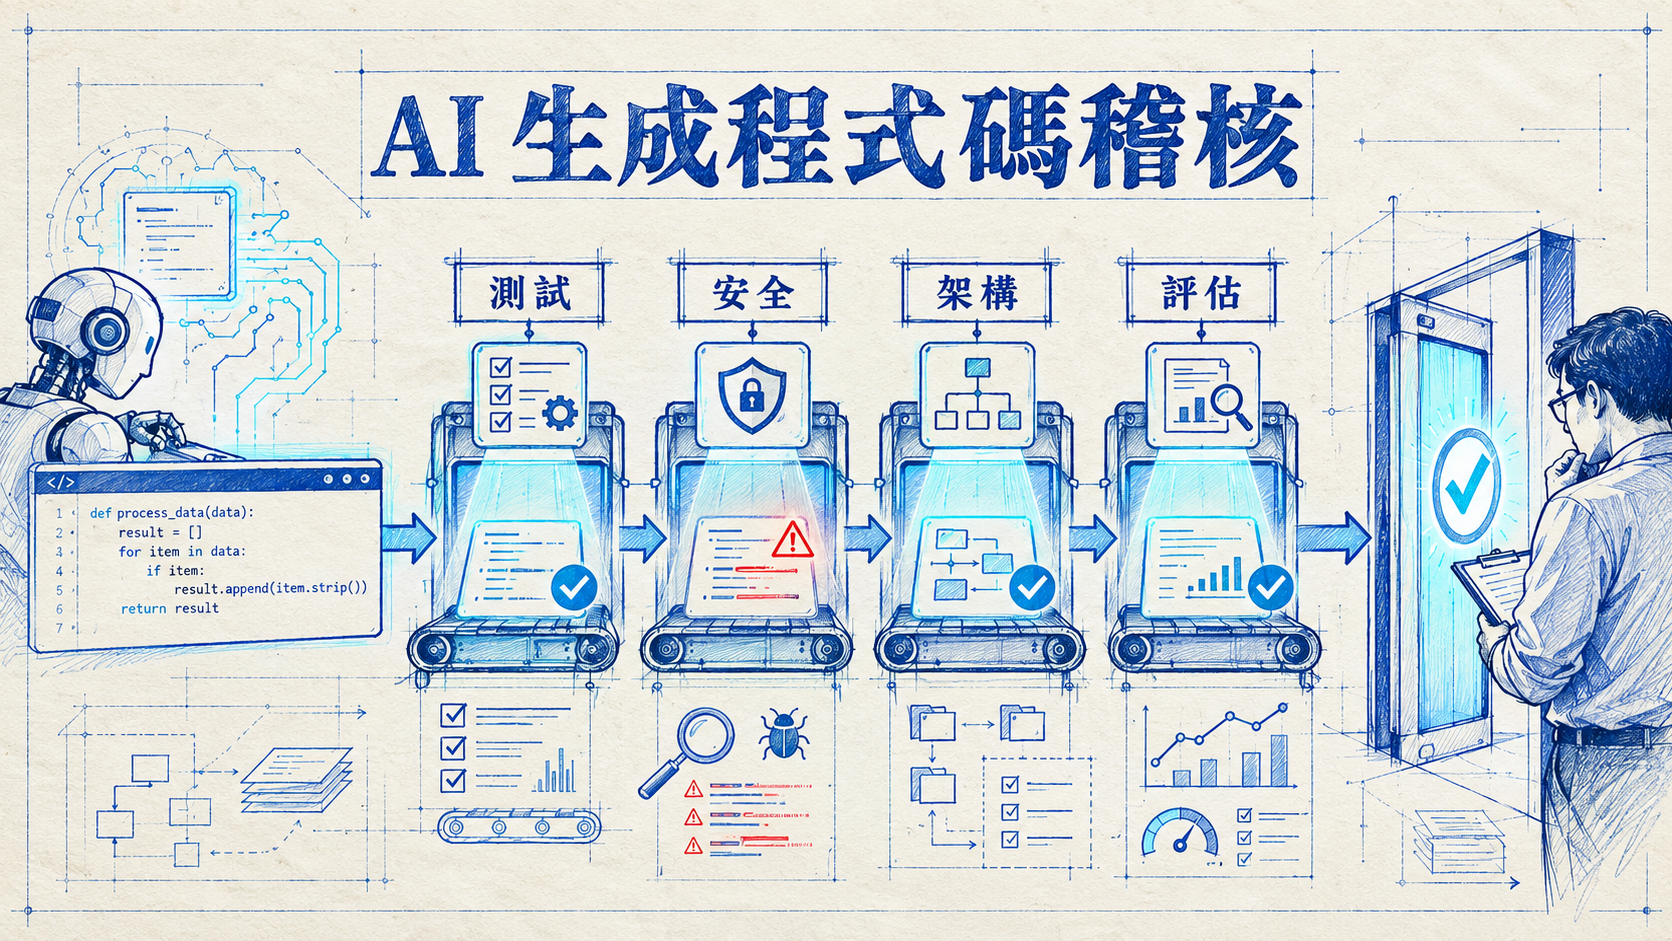
這份材料最值得帶走的結論是:Human in the loop 不是「最後看一下」,而是人類要先定義失效語義,再用不同工具建立互相重疊的證據。 單元測試證明幾個例子能跑;性質測試探索更大的輸入空間;靜態分析檢查已知危險模式;供應鏈工具檢查你沒寫的程式碼;架構規則防止系統慢慢長歪;評估框架則量測 AI 工作流本身是否退步。
1. 合理外觀的陷阱|retry 寫得像樣,失敗語義卻消失了
repo 裡最有代表性的兩段程式在 accountsync/retry.py 和 accountsync/users.py。它們都有迴圈、try/except、指數退避和成功時的 return,乍看就是標準 retry。
但當每次嘗試都失敗時,兩個函式都會跑出迴圈,隱式回傳 None。更細一點看,它們還會在最後一次失敗後繼續 sleep,即使已經沒有下一次嘗試。預設三次 retry、0.5 秒 backoff,意味著完全失敗時白白等待 0.5 + 1.0 + 2.0 秒。
這不是單純「少寫一個 raise」。它把失敗的種類抹平了。呼叫端收到 None,無法分辨是伺服器忙碌、連線中斷、逾時、HTTP 錯誤,還是 TLS 驗證失敗。投影片特別指出,requests.exceptions.SSLError 會被 RequestException 一起捕捉;安全訊號因此被當成普通暫時性故障重試,最後再被吞掉。
如果上層程式剛好用 if user is None: allow_access() 這種 fail-open 邏輯,網路上的攻擊者甚至可能故意製造 TLS 失敗,讓系統走進原本不該存在的授權路徑。這說明 error handling 本身就是 security boundary:你怎麼分類、傳遞與保存錯誤,會改變系統的安全語義。
工作坊的既有測試反而「認可」這個行為。像 test_survives_total_failure 和 test_upstream_outage_does_not_raise,只驗證例外沒有逃出來;test_backs_off_exponentially 更直接期待三次嘗試產生三次 sleep。測試全綠,但綠的是一份錯誤規格。
2. 覆蓋率不等於正確|例子走過每一行,不代表性質成立
工作坊明說,原始 test suite 對五個模組已經有接近 100% 的 line 與 branch coverage。繼續補幾個手寫 example,邊際效益很低;下一步應該改問「這個函式在整個輸入空間中,永遠應該維持什麼性質?」
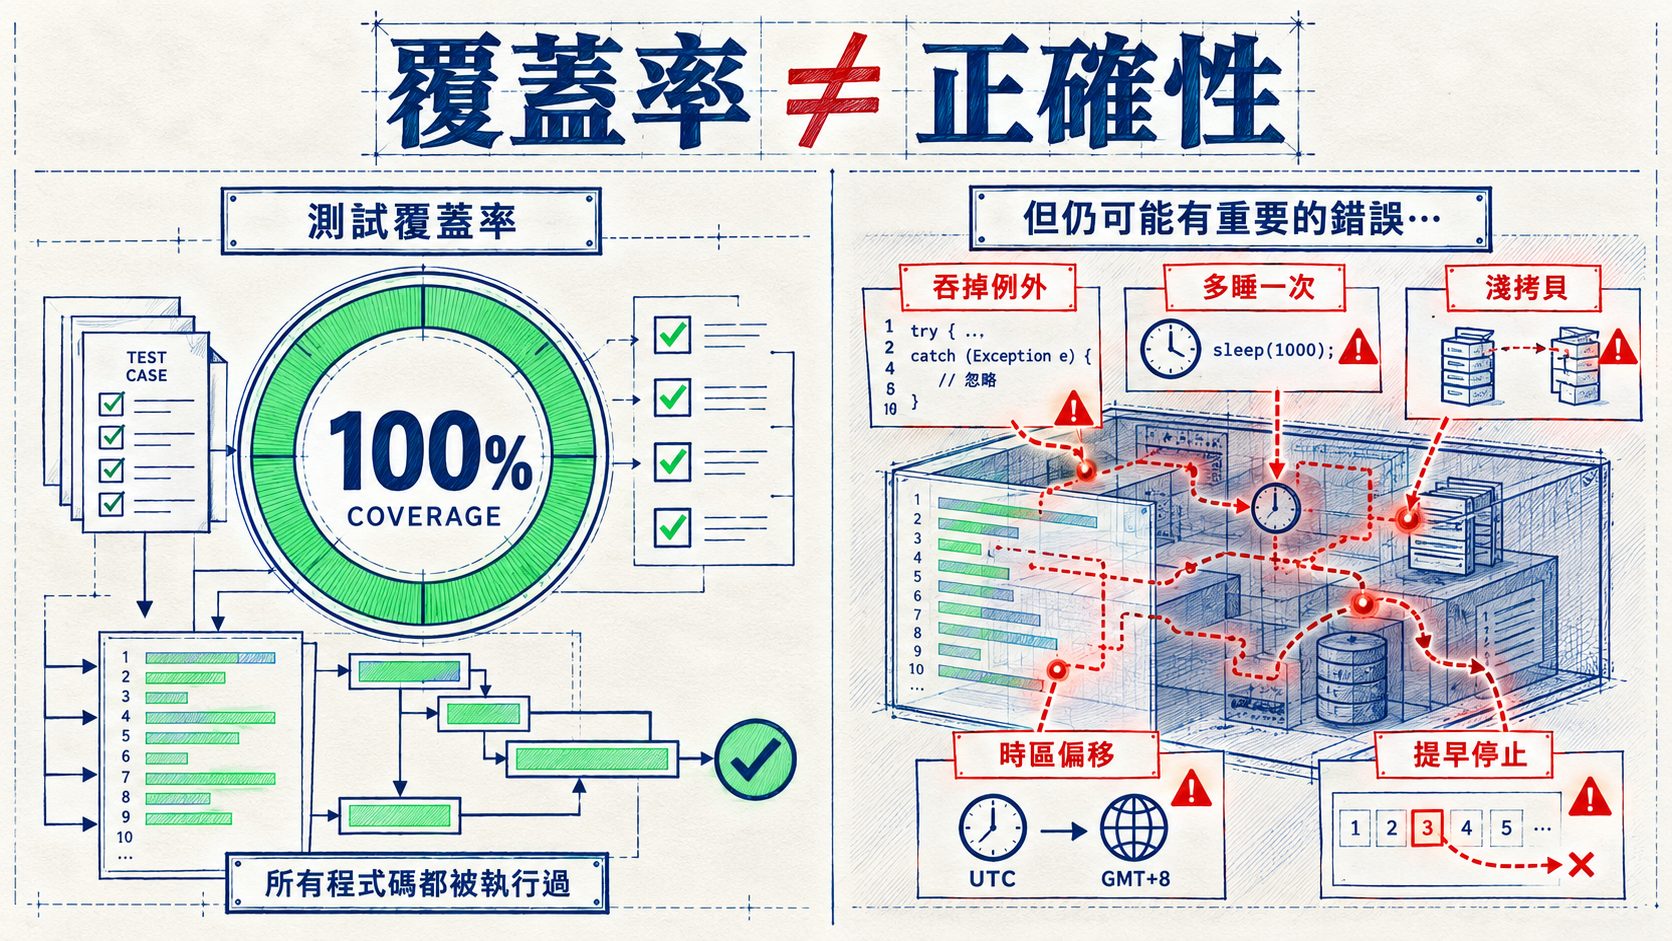
repo 把待完成的 Hypothesis 測試放在 tests/test_properties.py.txt。這個檔案不是答案,而是一組反例導航,至少涵蓋六類問題:
- Retry totality:成功就回傳 payload,完全失敗就讓原始錯誤逃出;不應悄悄回傳
None。 - Backoff 邊界:N 次 attempts 之間最多只有 N−1 次等待,最後一次失敗後不再睡。
- 設定合併深度:
merge_config只做 shallow copy,局部覆蓋database會吃掉其他預設欄位;回傳物件也可能和DEFAULTS共用巢狀 dict。 - 跨請求污染:呼叫端修改自己拿到的 config,可能反過來改到 module-level defaults,讓第 N 個 request 改變第 N+1 個 request。
- 時區不變性:程式用沒有 timezone info 的
datetime.now()去比較字面上代表 UTC 的Ztimestamp;同一個瞬間在不同機器時區可能得到不同答案。 - 分頁終止條件:
fetch_all看到短頁就停止,但若 upstream 在分頁後才套用權限或 soft-delete filter,短頁不一定代表資料結束;相反地,永遠回 full page 的病態端點又可能讓 client 無限跑。
這些測試的價值不在於 Hypothesis 會隨機丟很多資料,而是它迫使團隊先說清楚 invariant。Coverage 回答「哪些路徑跑過」;property-based testing 回答「跨越很多例子後,哪些承諾仍然成立」。兩者不是替代關係,但後者會揭露 example-based tests 與產品語義之間的斷層。
投影片還要求把 GitHub Actions 擴充成 timezone matrix。原始 CI 已跑 Python 3.11–3.14,加上 macOS 與 Windows,看起來很完整;但 Ubuntu runner 預設是 UTC,恰好會遮住 naive datetime 的問題。新增東京、洛杉磯、Kathmandu 或 Eucla 之類帶半小時/45 分鐘偏移的時區,才真的在測時間語義,而不只是測作業系統名稱。
3. 多層防線|別期待某一個工具包辦真相
工作坊第二段把防線從動態測試向外擴。這些工具的重點不是「越多 badge 越專業」,而是每一層回答不同問題。
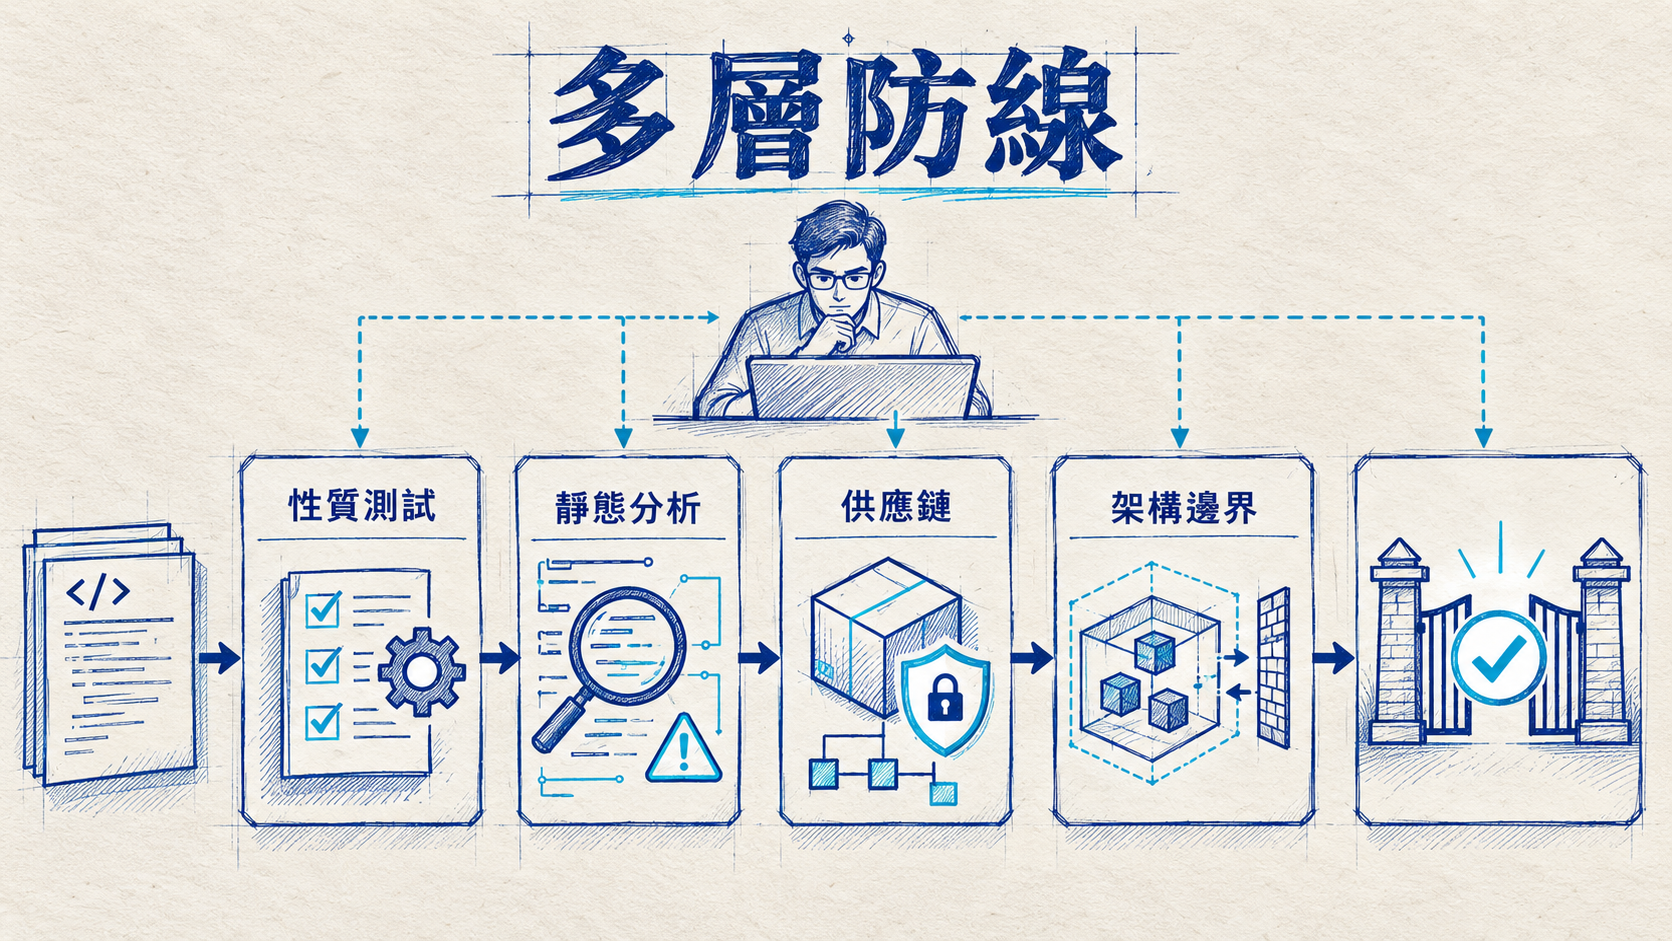
Ruff 適合抓語法、風格與一批已知 anti-pattern。投影片建議特別檢查 datetime timezone 規則(DTZ)與 return 規則(RET),再看完整 rule set 的統計,選出真正要納入專案的規則。重要的是選擇與固定版本,而不是每次用 uvx 臨時抓最新版;把工具放進 dependency group、鎖進 uv.lock,本機和 CI 才會得到同一結果。
Semgrep 可以用 project-specific 規則找危險結構,例如過寬的 exception handler、敏感錯誤被吞掉,或團隊明確禁止的寫法。投影片提醒 Semgrep 預設可能跳過 tests,所以要明確處理 .semgrepignore;否則你以為測試程式也被掃過,其實沒有。
Dependency audit 與 SBOM 處理的是自己沒寫的程式碼。Dependabot 比較像更新衛生,不等於 build-time vulnerability gate。工作坊建議用鎖定版本做漏洞稽核,遇到已知 CVE 就讓 build 失敗;再由實際 runtime environment 產生 Software Bill of Materials,驗證格式並保存成機器可讀的「軟體成分表」。
型別與架構規則 則防止系統慢慢偏離設計。repo 當下幾乎沒有 package-level type annotation,但 ty check 仍可能顯示「All checks passed」:沒有足夠型別資訊時,checker 的綠燈不代表很多。投影片建議逐步加入 TypedDict、Protocol、timezone-aware datetime 的區分、py.typed,再用 Ruff banned APIs 與 import-linter 固定模組邊界。
這裡的共同原則是:工具只有在規則可重現、版本被鎖定、結果能阻擋合併時,才是防線。 偶爾在本機跑一次掃描,和把它做成 CI gate,是兩種完全不同的可靠度。
4. 對抗式審查|不要只修 bug,要攻擊修法
第三個練習要求參與者主動「弄壞」accountsync。最簡單的輸入包括 --page-size 0、--retries 0、負數 retry,以及無效 token。這些不是複雜 exploit,卻常被 happy-path 測試漏掉。
投影片接著列出一套更系統化的 attack classes:
- Hostile upstream:亂序、重複、缺欄位、錯 content type、永不結束的分頁。
- Clock:DST、非整數時區、clock skew、過期邊界。
- Retry amplification:服務大量故障時,重試是否把小問題放大成流量尖峰。
- Concurrent writes:翻頁期間資料新增或刪除,是否重複或漏抓。
- Filesystem and process:目的路徑不可寫、磁碟滿、部分寫入、訊號中斷。
- Config surface:零、負數、極大數值、錯誤型別與跨來源覆蓋。
要讓這件事變成習慣,可以把 parser 做 fuzzing、在 CI 注入 failure、保留一個 pathological fake、把 threat model 寫下來,並在 code review 建立兩個儀式:先 red-team 修法,再問修法是否產生新的失效模式。這比「AI code 一律人工看過」更具體,因為它定義了人到底要看什麼。
5. 評估 AI 工作流|程式碼要回歸測試,產生程式碼的流程也一樣
工作坊最後把焦點從單一 repo 拉高到 AI workflow。核心主張是:先定義可量化的 accuracy、consistency 與 output quality 指標;跨多次 run 建立 baseline;比較 prompt 變體與 failure patterns;每次更新都能看出是否退步。
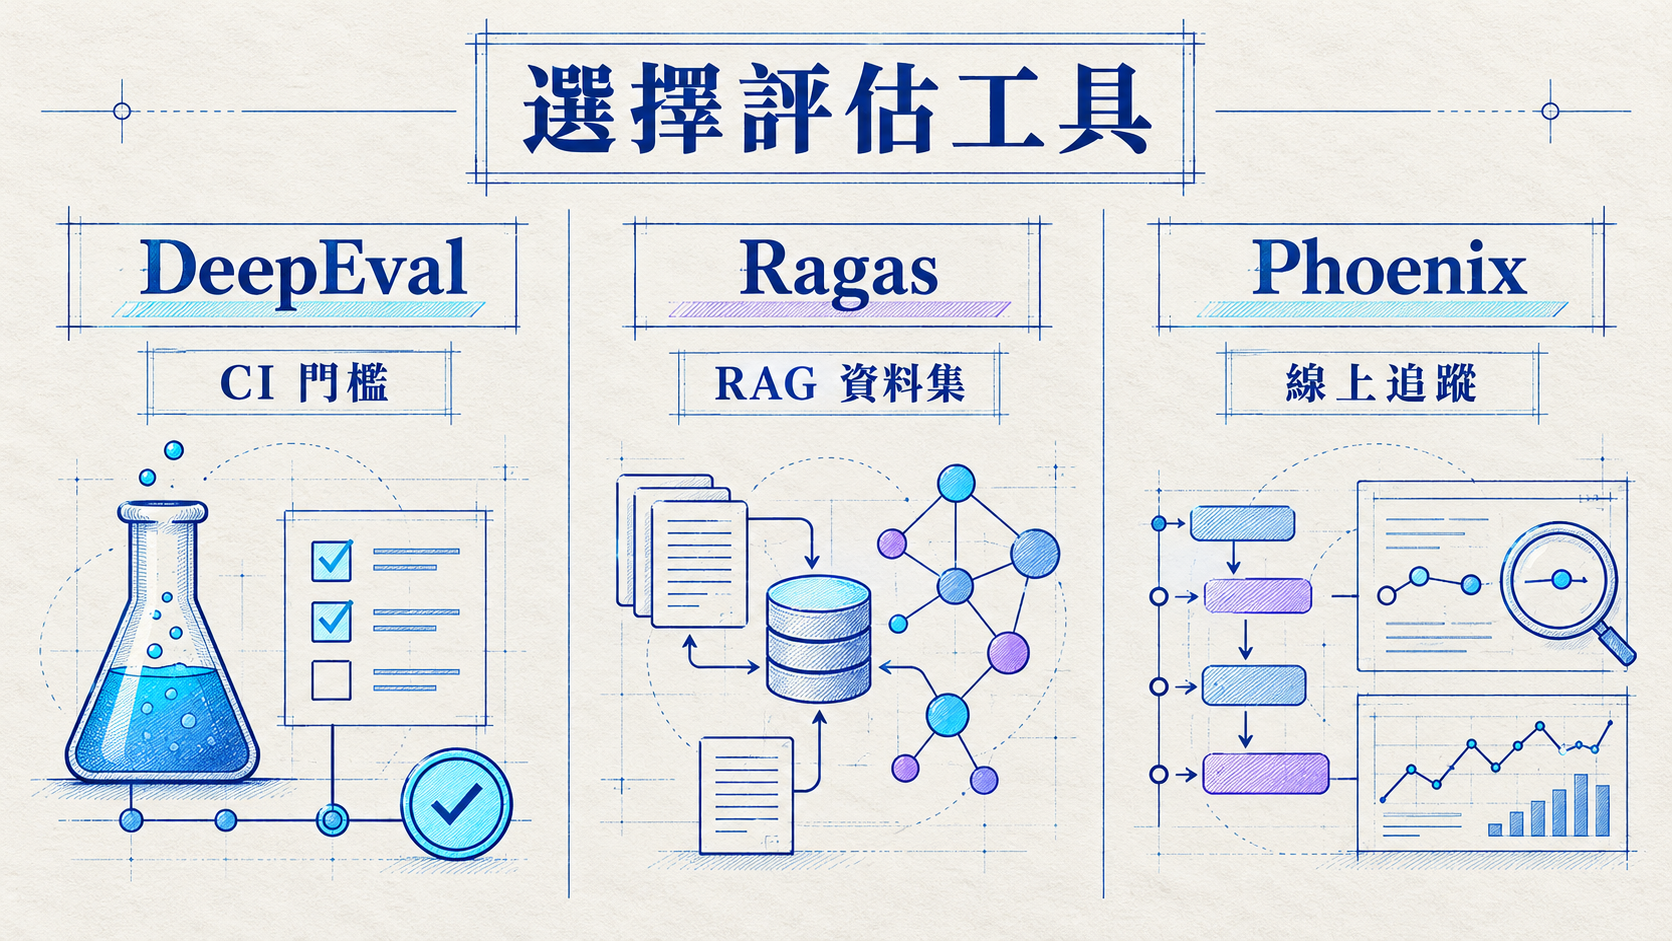
投影片把三套工具的定位拆得很清楚:
- DeepEval:適合把 metric threshold 放進 CI/CD,像單元測試一樣偵測回答品質或 hallucination regression,未達門檻就阻擋部署。
- Ragas:適合以 dataset 為中心評估 RAG,關注 faithfulness、answer relevance、context 與 claims 的支持關係,也適合比較 chunking 或 retrieval 策略。
- Arize Phoenix:適合 production tracing 與 live traffic,從 agent 的 spans、tool calls 和對話迴圈找問題,再用 evals 分類 grounded/hallucinated 或 correct/incorrect。
這三者不能只用「哪個分數最好」來選。真正的選擇題是評估要發生在哪裡:commit 前的 regression gate、離線資料集實驗,還是 production trace。團隊也不一定只選一個;離線用 Ragas 調 retrieval,CI 用 DeepEval 防回歸,上線後用 Phoenix 看真實流量,是合理的分層方式。
同時要保留編輯距離:LLM-as-a-judge 不是客觀真理,它也需要 calibration、抽樣人工複核與版本追蹤。只把另一個模型的分數接進 dashboard,並沒有自動解決「誰評估評估器」的問題。
6. 可落地清單|把「人類監督」改寫成可驗證流程
如果要把這份工作坊濃縮成團隊 playbook,可以用下面的順序:
- 先寫 failure contract:每個 I/O 函式成功回什麼、哪些錯誤重試、最後失敗要拋什麼,禁止以
None混淆成功與失敗。 - 把例子提升成性質:totality、idempotency、timezone invariance、無共享可變狀態、分頁 termination 等,都應有 property tests。
- 讓 CI 模擬環境差異:時區、Python 版本、OS,以及必要時的 locale、檔案系統與網路 fault。
- 分層加入掃描器:lint、Semgrep、dependency audit、SBOM、type checker、import boundaries,各自有固定版本與清楚失敗條件。
- 保留病態測試替身:不要只有永遠回 200 的 mock;加入 partial response、TLS failure、錯誤 schema、慢回應與永不結束的 upstream。
- 對修法再做一次攻擊:修掉 swallowed exception 後,確認例外型別沒有被改錯;加 retry 後,確認沒有 amplification 或多睡一次。
- 評估 agent workflow 本身:保存 prompt、模型版本、test set、評分規則與多次 run 結果,讓改善有 baseline,而不是靠印象。
AI 可以把寫程式的速度拉高,也會把未經驗證的假設更快送進 production。真正的工程能力因此不是比誰能生成更多,而是誰能更快建立反證、保存證據,並在不確定時 fail closed。
這就是 vibe coding 與軟體工程最實際的分界:前者問「它跑起來了嗎?」;後者持續追問「我們憑什麼相信它在失敗時仍然做對的事?」