010. 先讀|這不是「叫 AI 幫忙優化」的普通故事
Anthropic 在 claude.dev 發表的官方工程文章 How we made claude.ai 3x faster in two weeks,表面上是一篇效能優化回顧:今年 8 月,他們用兩週把 claude.ai 與 Claude desktop app 的核心使用體驗做快約 3 倍。
但這篇文章真正值得魚塘收進來的地方,不是「Claude 很會寫 code」,也不是「工程師開了一個 performance sprint」。更有意思的是:Anthropic 把 AI agent 放進效能工程的每一個環節,讓 Claude 不只寫優化 PR,而是參與找瓶頸、建 benchmark、觀察部署、關 feature flag、讀 field data、最後把新的 guardrail 鎖進 CI。
換句話說,這是一篇關於「如何把效能問題變成可被 AI 爬坡的數字」的文章。
原文給出的數字很漂亮:fresh load 到可輸入頁面的 p75 從 3.1 秒降到 0.55 秒;Claude Code 新 session 啟動從 0.8 秒降到 0.3 秒;Claude Cowork cloud session 載入從 2.6 秒降到 0.73 秒。團隊估算,這每天替使用者省下數萬小時等待時間。
但如果只看結果,很容易錯過方法。這次衝刺不是單一大 rewrite,不是某個 hero engineer 想到神奇 patch,也不是「用 AI 把工程師取代掉」。原文反覆出現的模式比較像這樣:
- 先把使用者旅程切成可量測的 hot path。
- 再讓 Claude 找出或建立可重複的 benchmark。
- 有實驗室結果後,切小 PR、掛 flag、跑測試、人類 review。
- 部署後讀真實使用者資料。
- 有效就把 benchmark ceiling 往下 ratchet,無效就關 flag 重來。
這篇導讀會把原文拆成一個更一般化的工程框架:如果 AI agent 要真的幫團隊變快,最關鍵的不是讓它「多寫一些 code」,而是替它打造一條可以量測、可以驗證、可以回滾、可以持續收緊的迭代迴路。
魚塘要特別補上一層判讀:這篇文章其實把「AI agent 在工程組織裡的正確位置」講得很清楚。Claude 不是坐在旁邊等 ticket,也不是直接接管 production,而是被放在一個有觀測、有目標、有審查、有部署、有回饋的閉環裡。這個閉環一旦搭好,agent 的高並行和高耐心才會變成優勢;如果閉環沒搭好,高並行只會變成大量低信任變更。
021. 指標先行|Claude 先被要求找出 95% 使用活動在哪裡
Anthropic 不是一開始就叫 Claude 到處亂改。原文描述,他們先開了一個 Slack channel,給 Claude 一組長期任務:監控部署是否造成效能退步、評估 telemetry 是否準確、維護 observability dashboard、主動提出低垂果實、和人類隊友溝通。
這裡的關鍵不是 Slack,而是任務定義。Claude 被放進的是一個有資料、有討論、有 deploy、有 owner 的工作場,而不是一個孤立 prompt。它可以透過 Datadog MCP server 分析 usage data,找出四個最高影響力的使用者旅程:啟動 app、開始對話、載入既有對話、送出訊息。
這四條旅程橫跨 web、desktop,以及不同產品型態,最後被拆成 13 個可比較的 measurement。每個 measurement 都被校準成:從一個使用者互動開始,到結果真正 render 出來結束,並且區分 client-side 與 server-side 的工作。
這一步看起來樸素,但它其實是整個 sprint 的基礎。很多「AI 幫我優化」失敗,不是因為模型寫不出快一點的程式,而是因為它不知道應該優化哪一段,也不知道什麼叫贏。沒有明確 measurement,AI 只能靠靜態直覺猜瓶頸;有了 measurement,它才有東西可以爬坡。
原文裡 Anthropic 一開始列了約 20 個手選專案,每個專案都對準一條旅程,Claude 估算每個專案可能帶來多少毫秒收益。結果他們在第三天就達成了 13 個目標中的 12 個。
這時最有意思的轉折出現了:目標太快達成後,團隊沒有收工,而是要求 Claude 重新掃描還沒探索的機會,甚至直接說可以提出「wacky ideas」。這代表他們不是把 AI 當成票務系統裡的 coding clerk,而是把它當成一個會持續找 slope 的 optimization loop。
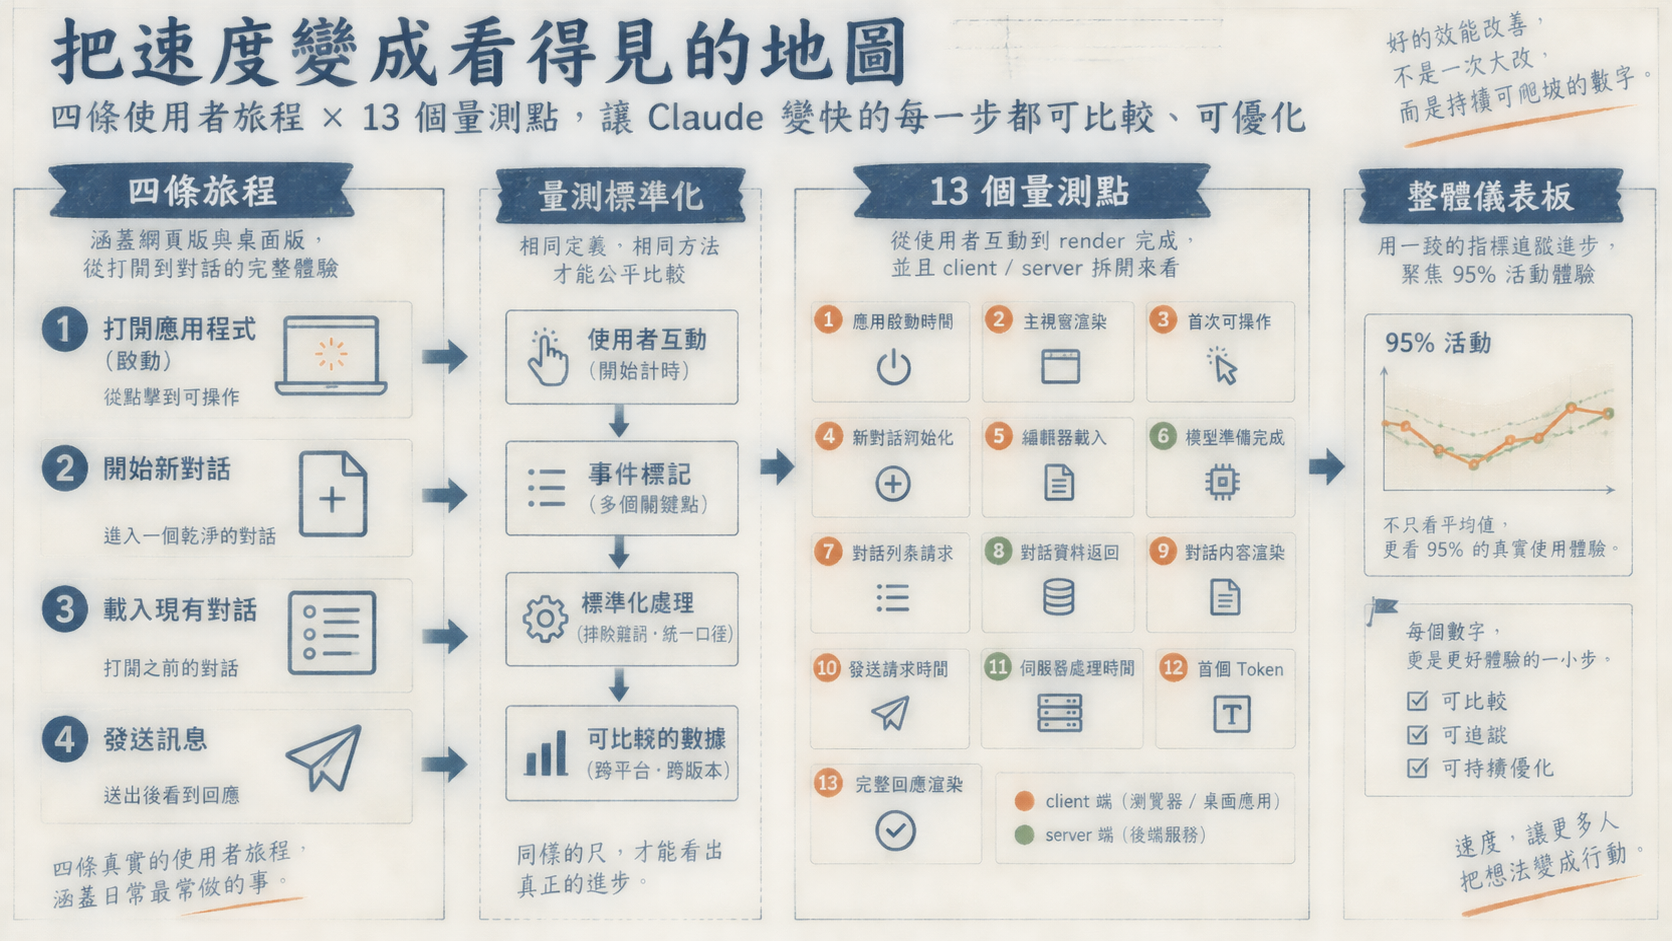
這裡可以抽出一個更深的模式:Agent 在複雜系統裡最需要的不是「完整權限」,而是「可比較的目標」。四條旅程、13 個 measurement、p75、client/server 拆分,這些聽起來像傳統 observability work,但它們其實是在替 agent 建立座標系。座標系越清楚,Claude 的工作越像工程;座標系越模糊,Claude 的工作越像猜謎。
這也是一般團隊最容易跳過的一步。很多人會直接要求 agent「幫我讓網站快一點」,然後得到一堆零散建議:壓縮 bundle、lazy load、memoize、移除不必要 render。這些建議未必錯,但沒有旅程和 measurement,它們沒有優先順序,也很難判斷是否真的改善使用者最常做的事。Anthropic 這次先問「95% 使用活動在哪裡」,比先問「哪個函式慢」更重要。
032. 可以計數,就可以爬坡|效能工程被改寫成 benchmark 工廠
原文最重要的一句話是:一旦 Claude 可以量測某件事,它就能讓那件事變快。
但真實世界裡,使用者感受到的是 wall-clock time,而 wall-clock time 很吵。瀏覽器、網路、cache、背景任務、機器狀態,都會讓毫秒級測試變得不穩。這也是很多效能 CI 難做的原因:你不能讓每個 PR 都被一個高波動的 20ms 差異卡住。
Anthropic 的做法是找替代計數。純 JS hot path 可以用 Valgrind 搭配 node --predictable 算 instruction count;瀏覽器路徑不能直接這樣做,就改看 React commits、V8 precise coverage 裡的 function call counts、layout 與 style recalculation counts、DOM mutations 等。
這些 metric 本身不是目的。團隊對每個新 benchmark 都保持懷疑:它必須同時滿足兩件事,一是 Claude 能在 lab 裡推動這個數字,二是這個數字可以成為 CI 裡只會往下收緊的 guardrail。若 benchmark 很 flaky,或不能證明和使用者 latency 有關,就丟掉。
原文舉了兩個 hot path:組裝 conversation message tree 的 routine,以及掃描 Claude Code output status line 的 scanner。Claude 用 Valgrind profile 後發現,前者有四分之一 instruction 花在 megamorphic dictionary lookups,而且同一個 message ID 被 resolve 三次。約一小時後,兩條 hot path 的 instruction count 分別下降 48% 與 31%,wall-clock time 則下降 78% 與 44%。
這裡不是單純「AI 找到一個 bug」。真正的工程價值在後半段:團隊把這兩個 count check in 成新的 ratchet。從那之後,任何 PR 只要把這兩條 path 的 instruction count 拉高,就會 fail CI;每日 job 也會在數字下降時自動調低 ceiling。
效能在這裡不再是「偶爾衝刺一下」的活動,而是變成會被 CI 記住的制度。這也是整篇文章最值得其他團隊學的地方:AI agent 很適合爬坡,但你要先替它鋪出可以爬的坡,並在它爬上去後把高度鎖住。
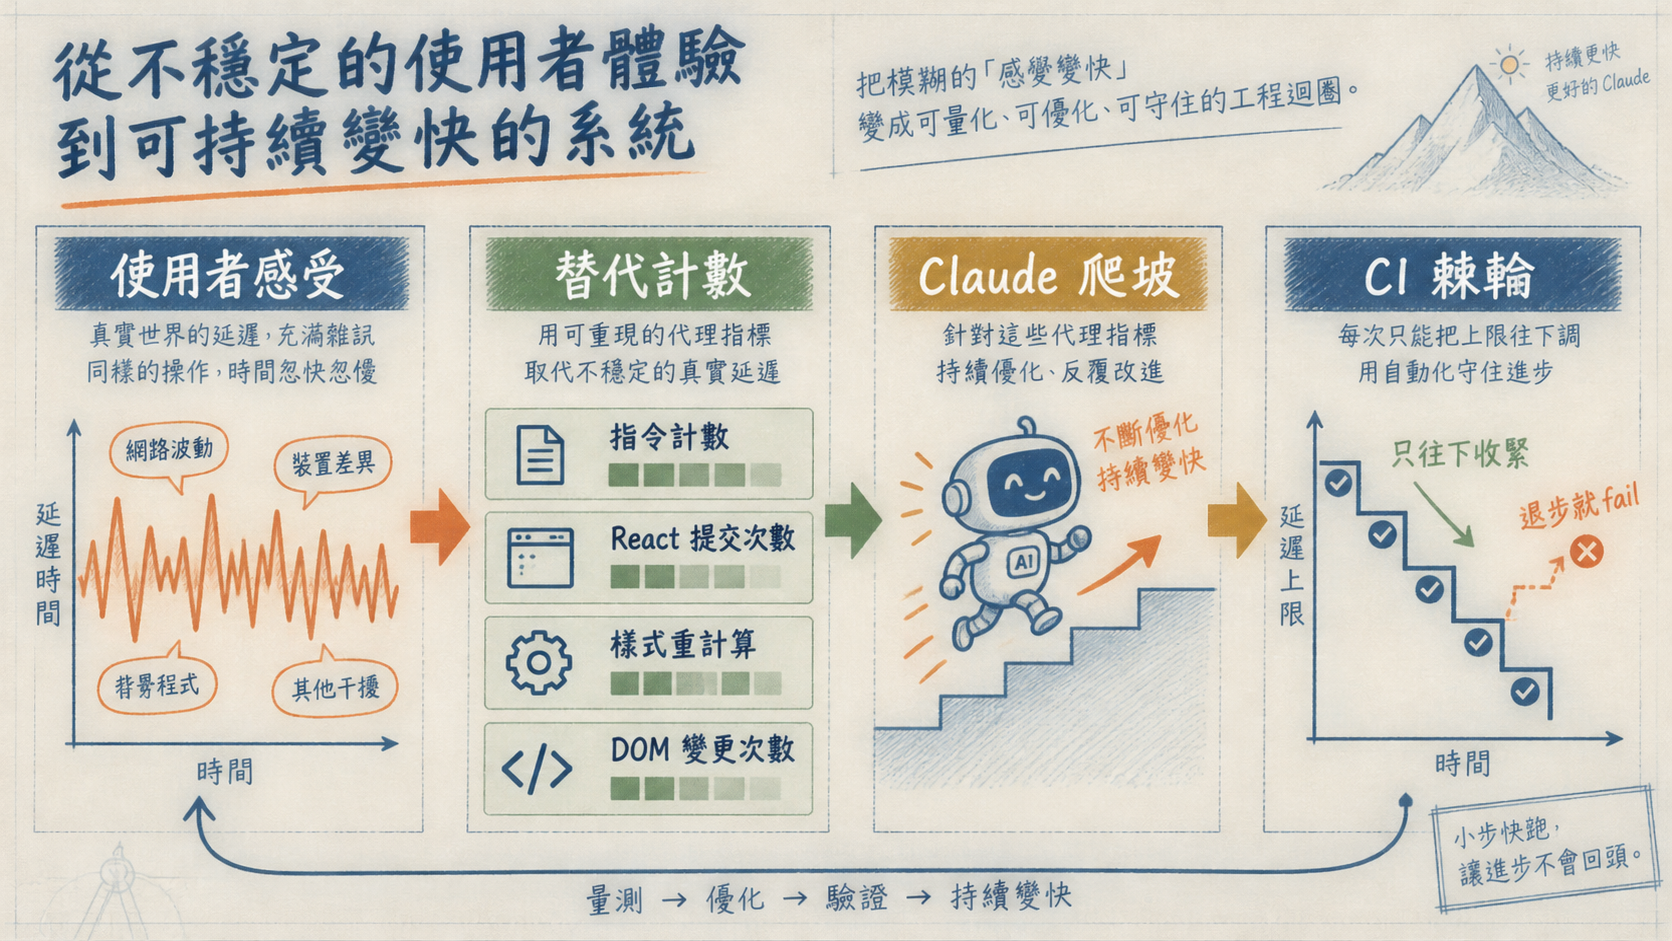
這裡的深層啟發,是「proxy metric」的地位被提高了。過去我們常把 proxy metric 當成折衷:instruction count 畢竟不是使用者感受到的速度,React commit count 也不是最終體驗。但在 AI-assisted engineering 裡,好的 proxy metric 會變成 agent 的工作介面。它不必等同於真實世界,它只要能穩定、可重複、且被證明和真實改善有關,就能讓 agent 快速試錯。
這也解釋為什麼原文堅持要丟掉不相關或 flaky 的 benchmark。如果 metric 錯,agent 會非常有效率地把錯的東西優化到極致。這不是 AI 特有問題,傳統工程也會 Goodhart's law,但 agent 把迭代速度放大後,錯 metric 的危害也會被放大。Anthropic 的做法不是相信每個數字,而是先要求數字證明自己值得被爬坡。
對一般團隊來說,這裡有一個實作順序:先用 RUM 或 tracing 找出真實痛點,再設計 deterministic proxy,再用小實驗證明 proxy movement 會帶來 wall-clock 或 user-perceived win,最後才把它放進 CI。不要一開始就把一堆 microbenchmark 變成紅綠燈,否則 CI 會變吵,agent 也會被訓練去滿足錯誤儀表。
043. Thread loop|一條慢路徑會長出 benchmark、PR、部署與下一條慢路徑
原文描述的日常工作流很有畫面:多位工程師和 Claude 在同一個 Slack channel 裡,thread by thread 地推進。每條 thread 通常從某個慢點開始,可能是一張截圖、一段 screen recording,或 field data 裡看起來不對的現象。
接著 Claude 會 trace flow,找出或建立 benchmark 來證明問題。若 lab 結果有希望,就送 PR。使用者可見的改動會掛 feature flag。合併部署後,Claude 讀 field data。如果數據改善,就 ratchet benchmark;如果沒改善,就關 flag,回頭再改。
這套 loop 重要的地方在於它不是「先規劃完所有優化,再一次實作」。它比較像一個會自己分裂的調查系統:每個 benchmark 都會找到下一個瓶頸,每個部署都會產生新的資料,每個資料又開出下一條 thread。
原文舉了一個 sidebar layout shift 的例子。有人分享 screen recording,發現 sidebar rows 在頁面載入後會跳動,Chat 和 Cowork row resolve 的時間不同,讓頁面感覺卡。既有 monitor 沒抓到,因為每次 shift 的 CLS 只有約 0.008,遠低於 0.1 的 good threshold。
Issac 提出直接引用 Layout Instability API。Claude 於是建立新的 telemetry event,把每個 layout-shift entry 的 source 對應到 named region 和 phase,例如 sidebar、transcript、first paint 前後。它也寫了 integration test:打開有 sidebar 資料的頁面,刻意讓 sidebar data 在 first paint 之後才到,任何 named region 的 shift 都會 fail。
這個 test 在 main 上 20 次全紅,在 PR 上 20 次全綠。部署後,Claude 再讀 field data,發現 31% 的 web page loads 在頁面可用後、使用者還沒互動前,有東西移動。接著它按名稱一批批處理:晚到的 header row、使用者名稱載入後側移的 caret、scrollbar 出現造成移動的 list。
這個例子很精準地說明 AI agent 的價值:它不是只修一個明顯 bug,而是把「感覺有點 janky」翻譯成可重現測試、field telemetry、命名區域、批次修復,最後變成能阻止回歸的 guardrail。
如果把這個 loop 拆得再細一點,它其實包含三種不同型態的知識。第一種是產品感:有人看出 sidebar popping 讓人覺得不穩。第二種是平台知識:Layout Instability API 能把 shift entry 的 source 拿出來。第三種是工程制度:把 named region、phase、integration test 和 field event 串在一起。Claude 的價值在於把第二、第三種知識快速落地;人類的價值則在於指出第一種「這不對勁」。
這也提醒我們,不要把 agent workflow 設計成只接收已經整理好的 bug report。最有價值的任務常常一開始很模糊:畫面怪、輸入慢、滑動卡、某個列表感覺會跳。好的 agent loop 要能從這種模糊訊號開始,逐步把它變成可量測、可重現、可部署觀察的工程物件。
054. 水平擴張|150 條 thread 的重點不是並行,而是每條都有收斂機制
當一條 thread 的 loop 跑得通,擴張就變成「多開幾條」。Anthropic 在 sprint 中同時跑超過 150 條 thread;有些 thread 會送出 50 個甚至 100 個 optimization PR。越到後面,甚至越常是 Claude 自己從調查或 nightly job 裡發現機會,主動開新 thread。
這種畫面很容易被誤讀成「大量 AI coding」。但如果只有大量 PR,沒有收斂機制,這會非常危險。原文真正呈現的是一種高並行但強 guardrail 的工作法:每條 thread 都要有 measurement、benchmark、flag、review、deploy observation,否則就只是製造變更量。
原文列了一串 Claude 找到的瓶頸:composer typing path 裡有 6,900 個 hooks 和 900 個 store subscriptions,每次按鍵都會 re-render;一個 :root:has() selector 讓每次 DOM change 多 24ms style recalculation;某個 leftover location.reload() 每天造成 50 萬次隱藏 reload;idle tab 把相同 cache snapshot 每兩分鐘 clone 進 IndexedDB,還都在 main thread 上做。
最有趣的一個 sidequest 是 syntax highlighting。Claude 發現 finished code block 的 highlight 有時會 freeze 約一秒,追到最後居然是 em dash 和 curly quote 這類非 Latin-1 字元。只要 markdown 裡出現非 Latin-1 字元,V8 會把整個 string 存成 UTF-16,讓 syntax-highlighting regex 走比較慢的 two-byte path。Claude 用約 20 行修改,把每個 code block 在 highlight 前 copy 成 one-byte string。
這類案例說明一件事:人類通常很難預先知道哪裡會有高 leverage。AI agent 的優勢是可以在很多 thread 裡持續翻石頭,但前提是它每次翻到東西,都要能回到 measurement 和 guardrail,而不是直接把直覺改動丟進主線。
這一段也可以看成「agent scaling law」的實務版。不是模型參數變大,而是可同時維持的調查線變多。150 條 thread 不是因為每條都同等重要,而是因為效能工作有大量局部 slope:有些在 React render,有些在 browser layout,有些在 IndexedDB,有些在 string encoding,有些在 feature flag lifecycle。人類團隊很難長時間盯住這麼多微坡,但 agent 可以。
不過這種橫向擴張只有在每條 thread 都夠窄時才成立。太寬的 thread 會讓 agent 在無限空間裡發散,太窄但沒有 measurement 的 thread 會變成瑣碎修補。Anthropic 這次的做法比較接近「窄 scope + 強 measurement + 持續追下一個瓶頸」。這是值得複製的,不是單純複製「開很多 thread」。
065. Guardrails|速度不是放手,而是先把煞車裝好
原文很清楚地說,這次 sprint 不是 autonomous。Claude 很有產出,但每個 PR 都有 automated review 與至少一個 human approval;unit tests 總是在 optimization 前;任何可能造成使用者可見問題的改動,都用短期 feature flag 包起來。
兩週內他們引入近 200 個 flags,其中超過一半在 sprint 結束前已經清掉。Claude 也負責分類每個 flag 是 kill switch 還是 ramp,並在安全後退休。這個細節很重要:feature flag 如果只加不清,最後會變成另一種 technical debt;讓 agent 參與 flag lifecycle,等於把風險管理也納入工作流。
靜態 composer 是一個典型例子。為了讓使用者在 React 初始化期間就能打字,Anthropic 在 HTML 裡先烤進一份 composer 的靜態版本,然後讓 React paint 在它上面。這種技巧的效能收益很大,但非常脆弱:如果 React render 和靜態 markup 差一個 pixel,魔法就破了。
所以 Claude 建了很多 guardrail:靜態 markup 由真正 React component 在 jsdom 裡 render 產生,測試保證兩者不 drift;integration test 在 14 種 viewport size 比較靜態頁和 React render,要求 1px 內對齊;keystroke test 直接穿過 handoff 打字,任何遺失或重排都 fail;field data 則回報十分之一 pixel 的 shift,Claude 會為任何非零移動開 thread。
最精彩的是 Chrome speculative loading 的案例。內部 rollout 四小時後,有隊友錄到新分頁開 claude.ai 時 composer 會下掉約 15 到 20px。Claude 追到原因不是 static composer handoff,而是組織管理的 Chrome new-tab page 底部有 56px footer。使用者在網址列輸入期間,Chrome 會在背景 prerender claude.ai,當時 viewport 比正式進入後矮;按下 Enter 後 footer 消失,頁面變高,第一幀就會顯得被重新擺位。
這是傳統測試很難想到的環境差異,也說明「lab benchmark + field observation + human screenshot」三者缺一不可。AI 可以追得很深,但要讓它安全追深,前提是 rollout、flag、測試和人類 taste 都在場。
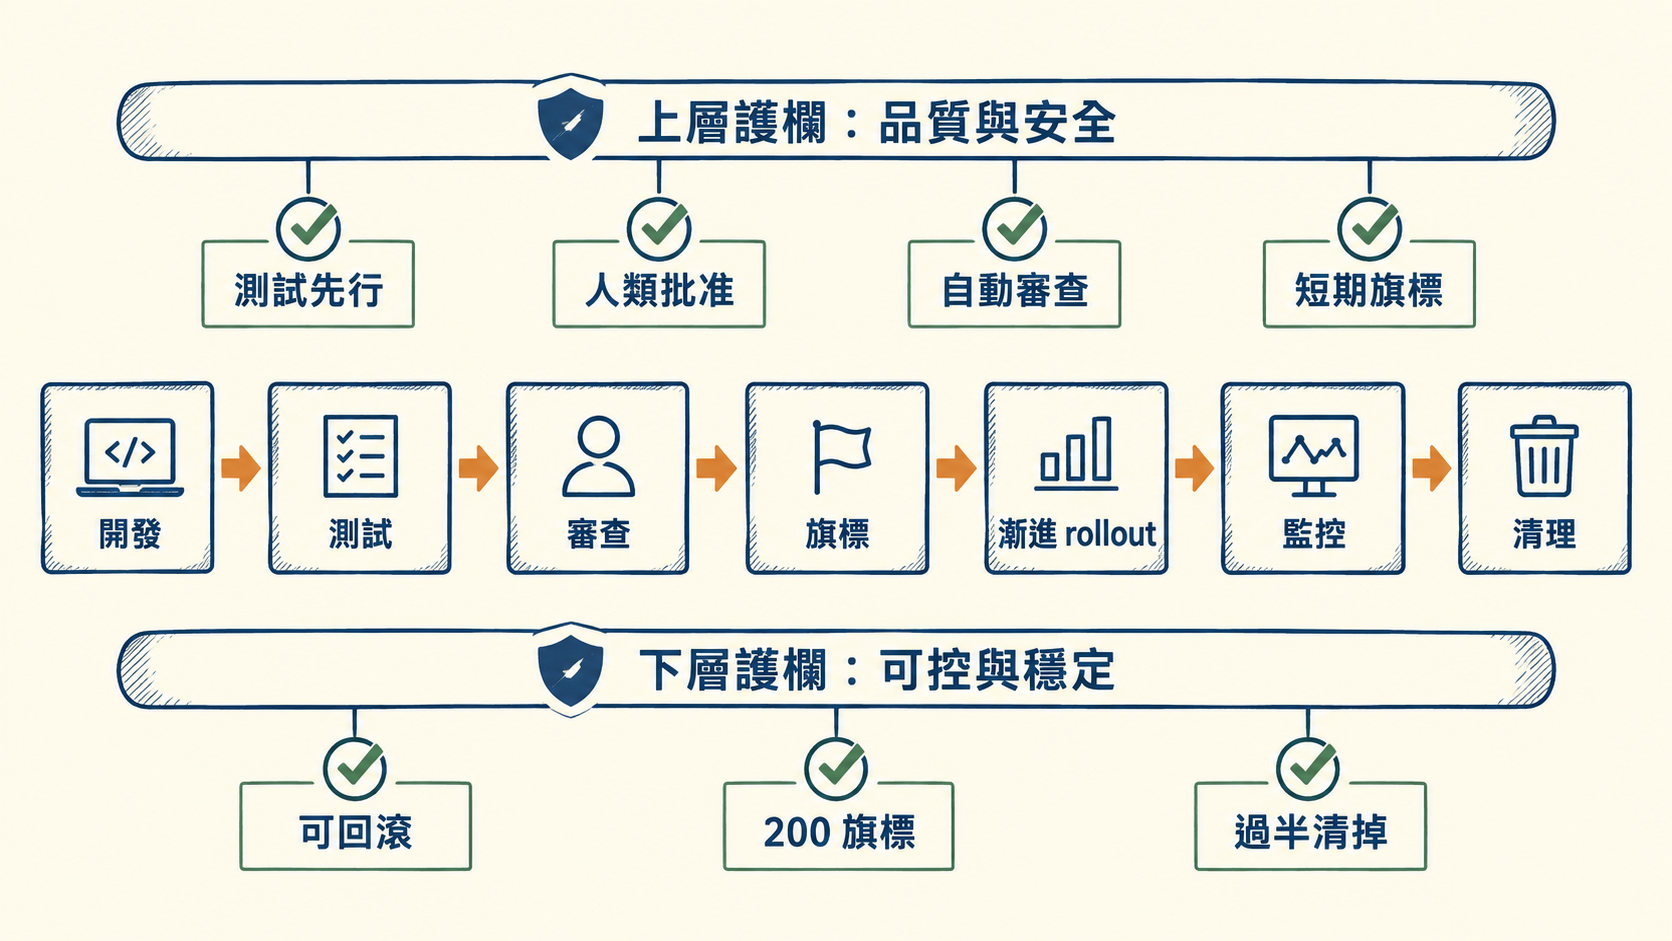
這裡最容易被忽略的是「清理」本身也是工作。兩週近 200 個 flags 聽起來很強,但如果衝刺結束後留下 200 個模糊旗標,下一輪效能工作會更慢,產品行為也會更難推理。原文提到超過一半已在 sprint 結束前清掉,代表 Claude 不是只負責生產變更,也被拉進變更的生命週期末端。
這點對 AI agent 特別重要。Agent 很擅長新增局部機制:一個 flag、一個 guard、一個 test、一個 helper、一個 telemetry event。若沒有清理策略,agent 會把系統變成越來越厚的沉積層。真正成熟的 agent workflow 應該要求每個臨時機制都有 owner、目的、退出條件和刪除路徑。否則「安全」會慢慢變成另一種複雜度負債。
所以這篇文章不是在說「你可以放心讓 AI 每天 merge 兩百個 changes」。更精準地說,是「如果你的變更有短期旗標、分階段 rollout、field monitors、rollback path、flag cleanup,以及人類 approval,你才有資格把 throughput 開大」。速度來自護欄,不是來自無視風險。
076. 人類的工作|不是逐行指揮,而是設方向、野心和品味
Anthropic 在原文裡對人類角色的描述很誠實:這個 loop 很 productive,但不 autonomous。人類的工作主要有三個:ambition、taste、direction。
Ambition 是因為 Claude 預設仍然偏謹慎。它會 ticket findings、保守估 feasibility、替範圍加 padding。團隊在 guardrail 足夠時,會主動要求它更大膽。原文裡甚至有人直接對 Claude 說「we have the power to do anything. please be braver」。這不是喊口號,而是在風險邊界清楚時,推 agent 不要把每個問題都延到未來。
Taste 是因為效能優化常常不是單純越快越好。表格要逐格填入,還是等整列完成?loading skeleton 要立刻出現,還是半秒後才出現?streaming text 的 word-by-word fade 值不值得花掉 frame budget 的五分之一?這些是產品感與工程取捨,不是 benchmark 自己能決定的。
Direction 則是把每條 thread 維持在狹窄範圍內。Anthropic 把 thread 想成 150 把找釘子的錘子,多數人類決策不是「這行 code 要怎麼寫」,而是:哪些 surface 優先、哪些 thread 互相踩到、什麼時候應該關掉一條已經進入遞減報酬的 thread。
原文有個很好玩的例子:某個 900 行 PR 只省下每次 send 2ms,人類最後用一句話否決,認為那不值得維護一個 build plugin 的複雜度。這就是 taste 和 direction 的交會點。AI 可以算出 2ms,但人要決定 2ms 是否配得上 900 行複雜度。
這也是這篇文章對 AI engineering 最重要的提醒之一:越是大量使用 agent,人類越不能退到完全不管。人類要從微觀 coding 移到更高層的約束設計、優先級、風險控制與產品品味。不是 less engineering,而是 different engineering。
這裡其實有一個組織設計問題。當 agent 可以同時提出大量 PR,人類 review 不可能繼續用「每個人慢慢讀完每一行」當唯一防線。review 會分層:自動化先擋 schema、型別、測試、benchmark regression;Claude 或其他 agent 先做 automated review;人類再把注意力放在風險、產品表現、複雜度和不可逆決策。
這不是降低標準,而是重新配置注意力。人類如果還把大部分時間花在確認機械式變更,真正需要人判斷的地方就會被擠掉。Anthropic 原文裡那句「2ms 不值得 900 行複雜度」正好說明,人類 review 的核心會越來越像經濟判斷:這個收益、風險和維護成本是否划算。
087. 8.33ms 預算|當 frame 也能被計數,streaming 就能被爬坡
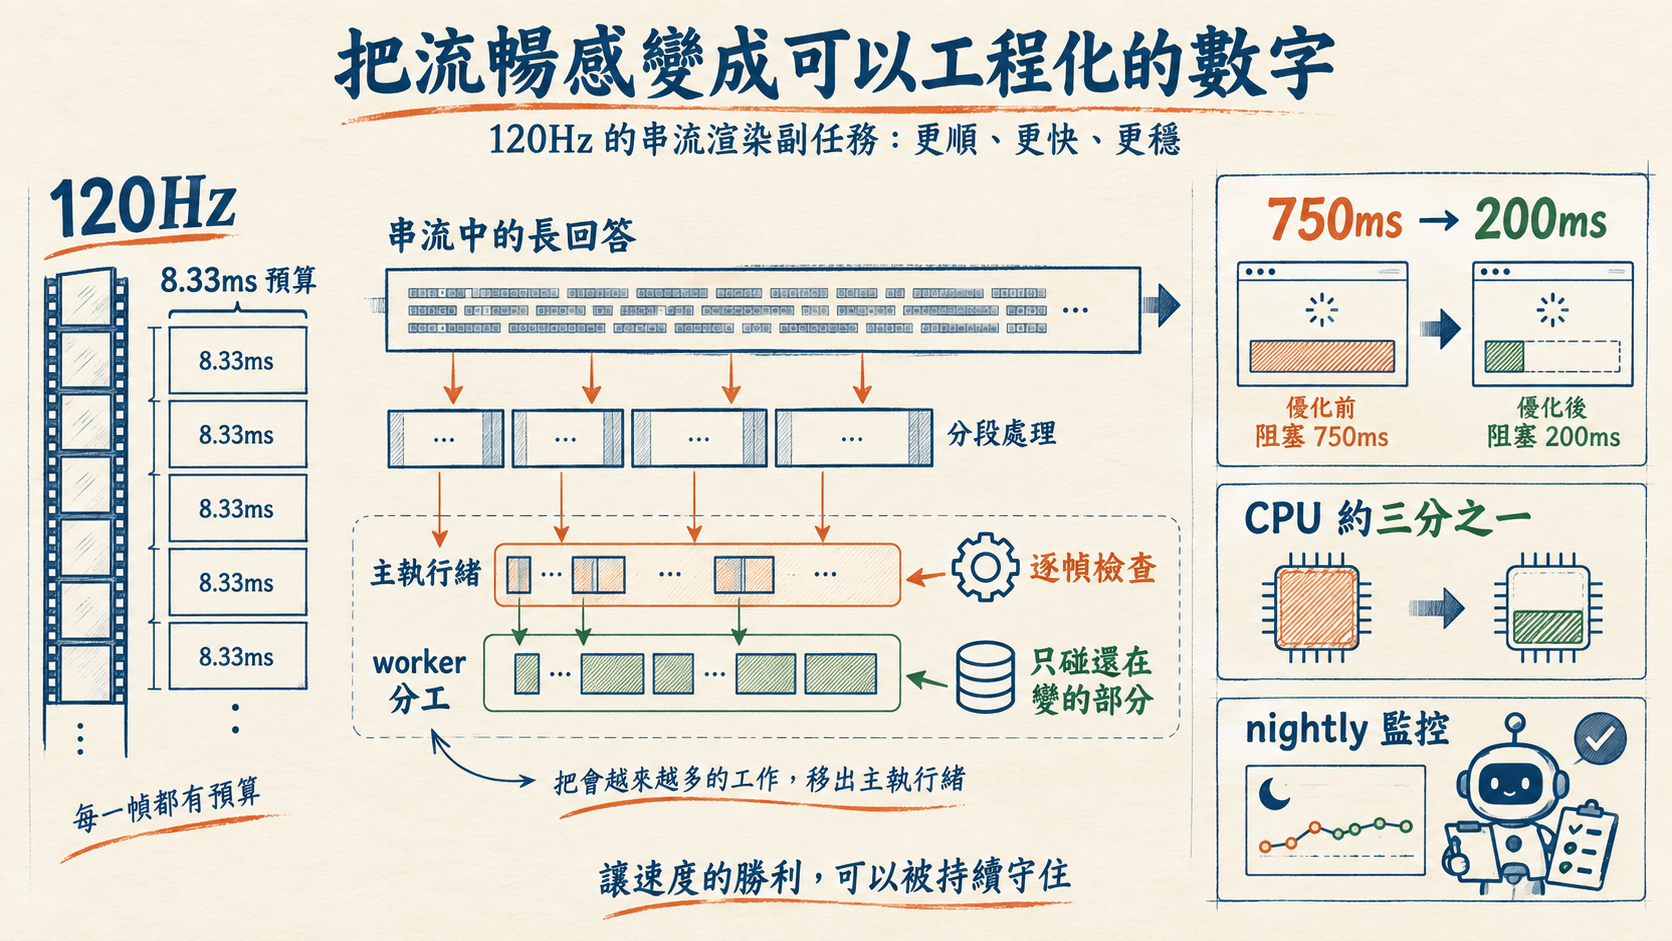
原文後段的 120Hz sidequest,是整個方法論的縮影。Claude 為了展示 live syntax highlighting 的 regex optimization,在 lab 裡錄了一段長回答 streaming 的畫面,角落加上由 animation-frame timestamps 算出的 frame-rate readout。
工程師追問是否卡在 60fps,能不能把 scroll 和 stream smoothness 推到 120Hz。Claude 回答 headless Chromium 預設 60Hz,但可以透過 DevTools begin-frame control 做 deterministic 120Hz frame stepping。確認後,240 個 begin-frame 對應 240 frames,每幀 8.33ms budget 就變成精確讀數,而不是 noisy measurement。
一旦 120Hz rig 成立,Claude 就開始逐幀找慢點。它移除每個 chunk 都做 O(message length) work 的問題,對已完成 block 做 memoization,把 growing code fence 的 tokenization 移到 worker,並讓 table cell by cell reveal。
在那一條 thread 裡,團隊落了近 60 個 PR。長回答原本會讓 main thread 總共 blocked 約 750ms,後來降到約 200ms;CPU 使用量約剩三分之一;在 120Hz MacBook 上可以從頭到尾維持 120fps。這個 120Hz rig 後來也變成 nightly job,由 Claude 持續監控 regressions。
這個故事特別值得放在結尾前,因為它把「AI 可以優化」講得很具體。不是 Claude 自己突然懂得 smooth streaming,而是人類和 Claude 一起把 smoothness 變成可測的 frame budget,再讓 Claude 在這個 budget 裡爬坡。8.33ms 不是口號,是 agent 可以反覆嘗試、回報、鎖進 CI 的目標。
這個 sidequest 也讓我們看到另一個方向:未來很多產品品質會被重新定義成「可工程化的感受」。流暢、穩、即時、不卡、沒有跳動,這些以前常常靠設計師和工程師用肉眼判斷。現在它們可以逐漸變成 frame budget、layout shift event、region-level telemetry、deterministic replay、nightly regression job。
這不代表品味會消失。恰好相反,品味會決定哪些感受值得被工程化。不是每個動畫都值得 120Hz rig,不是每個 2ms 都值得 900 行 code。AI agent 能把某個目標壓得很低,但人類要先決定那個目標是否真的代表產品品質。
098. 編輯結論|AI agent 的槓桿,在於把工程循環補齊
如果把這篇原文讀成「Anthropic 用 Claude 寫了很多效能 PR」,其實會低估它。更準確的讀法是:Anthropic 展示了一種 AI-native performance engineering loop。
這個 loop 的核心不是「agent 寫 code 比人快」,而是 agent 能在明確目標、充足 telemetry、可重複 benchmark、feature flag、CI ratchet、人類 review 和 field data 之間高速循環。它擅長把可量測的問題往下壓,擅長在許多 thread 裡持續尋找下一個 bottleneck,也擅長在勝利後把新 baseline 變成 guardrail。
但這套工作法也有前提。第一,系統要有可讀的 observability,不然 agent 只能猜。第二,團隊要願意把效能指標產品化,讓 benchmark 和 CI 能長期存在。第三,人類要有能力判斷哪些複雜度值得,哪些 2ms 不值得。第四,rollout 和 rollback 必須便宜,否則高頻改動會變成高頻事故。
Anthropic 的案例之所以強,是因為他們沒有把 AI 當成一個會魔法的 junior engineer,而是把它放進一條嚴密的工程迴路裡。Claude 可以很快,但快的不是單一回答,而是整個「發現問題、建立量測、提出修改、驗證部署、鎖住成果」的循環。
這對一般團隊的啟發很實際:
- 先找出最高流量或最高痛感的使用者旅程。
- 把 journey 拆成可比較的 measurement。
- 對每個 hot path 建立 deterministic proxy benchmark。
- 要求 AI 不只修 code,也要補 telemetry、tests、flags 和 rollback path。
- 每個有效優化都要用 CI ratchet 保護,不要只靠 sprint 記憶。
- 人類保留優先級、產品品味和複雜度取捨。
真正的結論不是「AI 會讓網站自動變快」。比較接近的是:如果你能把工程問題整理成一連串可量測、可驗證、可收斂的迴路,AI agent 會讓那個迴路以前所未有的速度運轉。
這也是為什麼這篇文章值得被記下來。它不是一篇單純的效能戰報,而是一份早期樣本:當 AI 進入成熟工程系統後,最強的能力不是替人類跳過流程,而是把原本太慢、太碎、太需要耐心的流程跑到極致。
109. 魚塘補充|這套方法不能直接照抄,但可以拆成三個成熟度
如果一般團隊讀完這篇文章,第一反應是「我們也要開 150 條 thread」,那大概會踩雷。Anthropic 的前提很特殊:他們有高品質 telemetry、有內部 Claude Tag、有 Datadog MCP、有很快的部署節奏、有能承受大量 PR 的 review 和 rollout 文化,也有足夠多工程師在 channel 裡做 steering。
更務實的拆法,是把這套方法分成三個成熟度。
第一層是「可見」。團隊至少要知道使用者在哪裡慢,能不能把主要 journey 拆成幾個穩定 measurement,能不能看到 p75、p95,而不是只看平均值或 Lighthouse 分數。這一層還不需要 agent 很自動,只需要讓 agent 能讀到真實現場。
第二層是「可爬坡」。團隊要開始替 hot path 建 deterministic proxy benchmark,並驗證 proxy 和實際體感有關。這時 agent 可以開始在明確數字上工作:降低 instruction count、減少 render、消掉 layout shift、縮短 blocked time。這一層的重點是把模糊品質翻譯成穩定目標。
第三層是「可守住」。有效的優化不能只存在 sprint report,要變成 CI ratchet、nightly job、field alert、feature flag cleanup。這一層才真的把 agent 的工作轉成系統記憶。沒有這層,agent 下次還會修同樣的 regression;有了這層,agent 和人類每次都站在更高 baseline 上。
所以,這篇文章最適合被當成 roadmap,而不是 cookbook。你不需要第一天就有 150 條 threads,但你可以先問三個問題:我們最重要的四條使用者旅程是什麼?每條旅程有沒有一個 agent 能操作的 proxy metric?任何一次效能勝利,是否會被 CI 或監控長期守住?
1110. 反面教材|AI 效能衝刺最怕三種假象
最後補一段原文沒有明說、但很值得延伸的反面教材。
第一種假象是「PR 數量等於進步」。Anthropic 兩週合併 3000+ changes 很驚人,但那個數字之所以有意義,是因為它綁著真實 user journey、benchmark、部署觀察和沒有 customer-facing incident。若只複製 PR throughput,不複製 guardrail,得到的是變更風暴,不是效能文化。
第二種假象是「代理指標等於真實體驗」。Instruction count、React commits、DOM mutations 都只是工具。它們需要被證明能帶來 wall-clock 或 perceived improvement。否則 agent 可能會把某個漂亮數字壓低,卻讓真實使用者完全無感,甚至讓 code 更複雜。
第三種假象是「AI 越自主越好」。原文的 Claude 很主動,但不是無人監督。每個 PR 有 human approval,使用者可見改動有 flag,產品取捨有人類 taste,方向和收斂有人決定。這不是 AI 接管工程,而是工程系統吸收 AI 的高 throughput,同時用制度把它導向有價值的地方。
從這個角度看,Anthropic 這篇文章真正示範的不是 agent autonomy,而是 agent accountability。Claude 可以跑很多線,可以熬夜,可以提出奇怪想法,可以追到 Chrome speculative loading 的邊角,但每一次行動最後都要回到數字、測試、部署、使用者體驗和人類判斷。
這大概也是未來 AI 工程組織最健康的形狀:不是「AI 替我們把事情做完」,而是「我們把好工程流程變成 AI 可以高速運轉的軌道」。軌道設得好,agent 會讓團隊看見更多慢點、守住更多勝利;軌道設得差,agent 只會更快地放大混亂。