0. 不是更聰明的聊天頁|第二大腦的真正差別
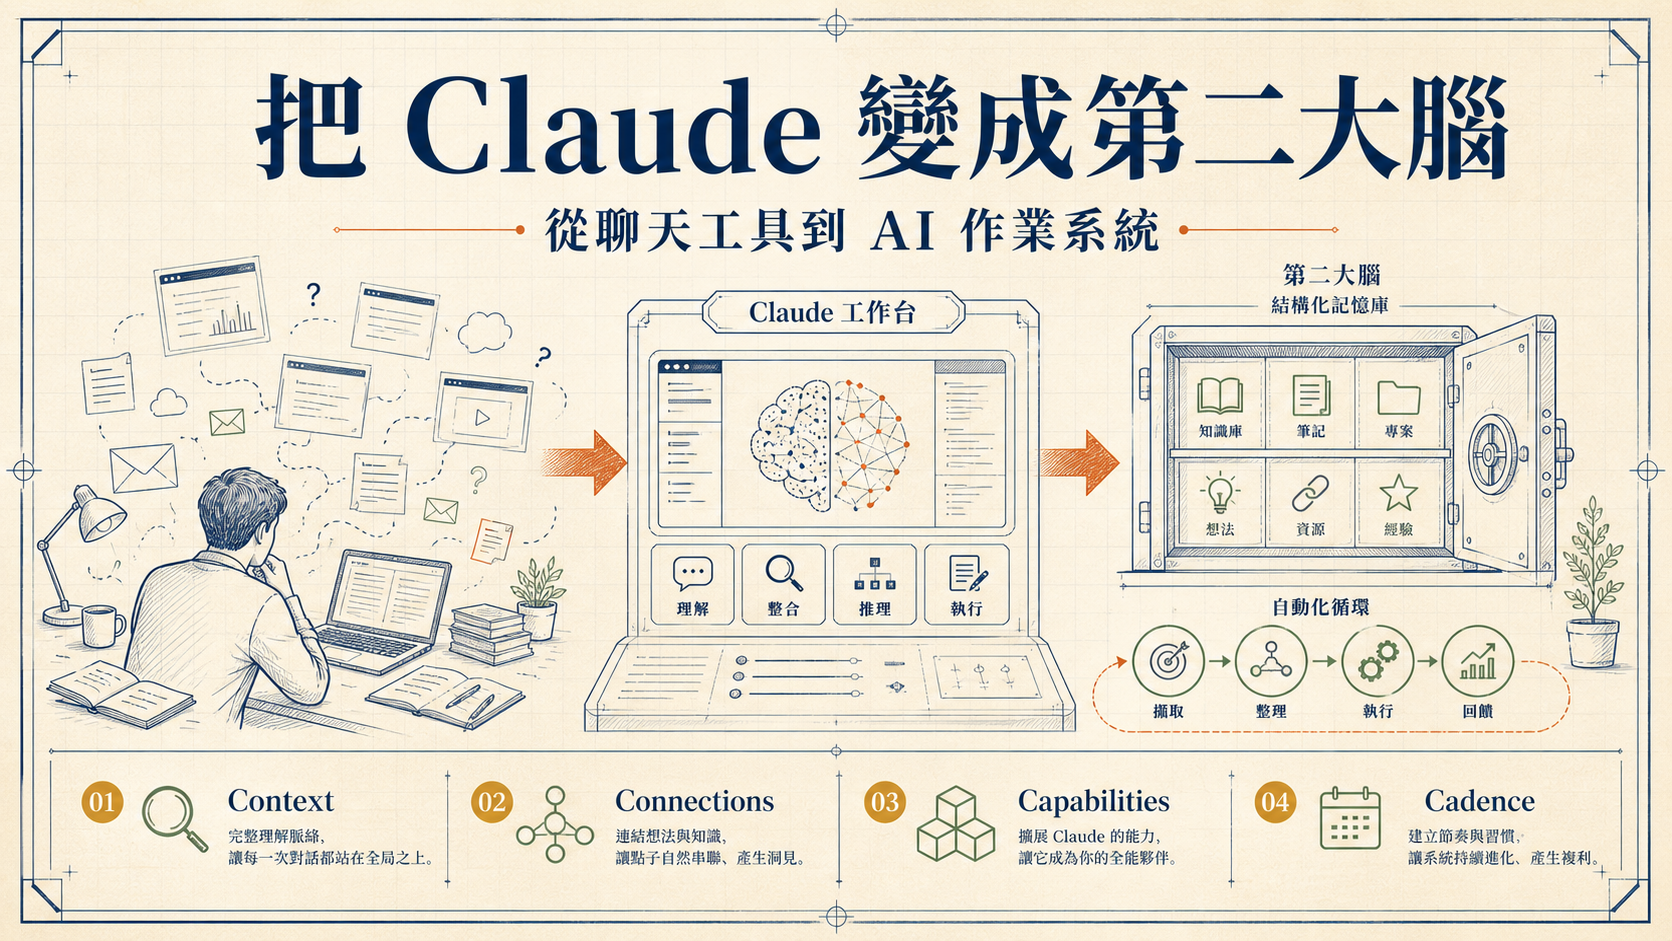
這支影片的表面題目是「把 Claude 變成 ultimate second brain」。但真正值得拿來拆解的,不是某個單一模型多強,也不是哪一個 prompt 比較神,而是一個更實用的問題:當 AI 已經可以接近全天候陪你工作,你到底要把它放在什麼位置?
原影片:I Turned Claude Into the Ultimate Second Brain
Nate Herk 的答案很明確:不要把 AI 當成另一個需要打開的聊天頁,而是把它變成工作系統的入口。也就是說,你不是每次遇到問題才臨時開一個模型、重新解釋自己是誰、公司在做什麼、資料在哪裡;你是把 context、connections、capabilities 和 cadence 都逐步收進同一個 AI operating system,讓它成為日常工作的預設介面。
這個差異很大。聊天頁的核心是「我問、它答」。第二大腦的核心是「它知道我在哪個系統裡工作」。AIOS 的核心則更進一步:它不只知道,還能接上工具、執行任務、定期運轉,並把錯誤回寫到記憶與流程。
影片中講者使用「Claude Fable」「Claude Mythos 5」等名稱描述當時他正在試用的模型,也提到錄製時的可用期間與價格。這些資訊在本文中都視為講者當下陳述,不把它們寫成本站對產品現況的確認。本文真正關注的是方法論:如何把 AI 從一次性回答工具,改造成一套可維護的工作環境。
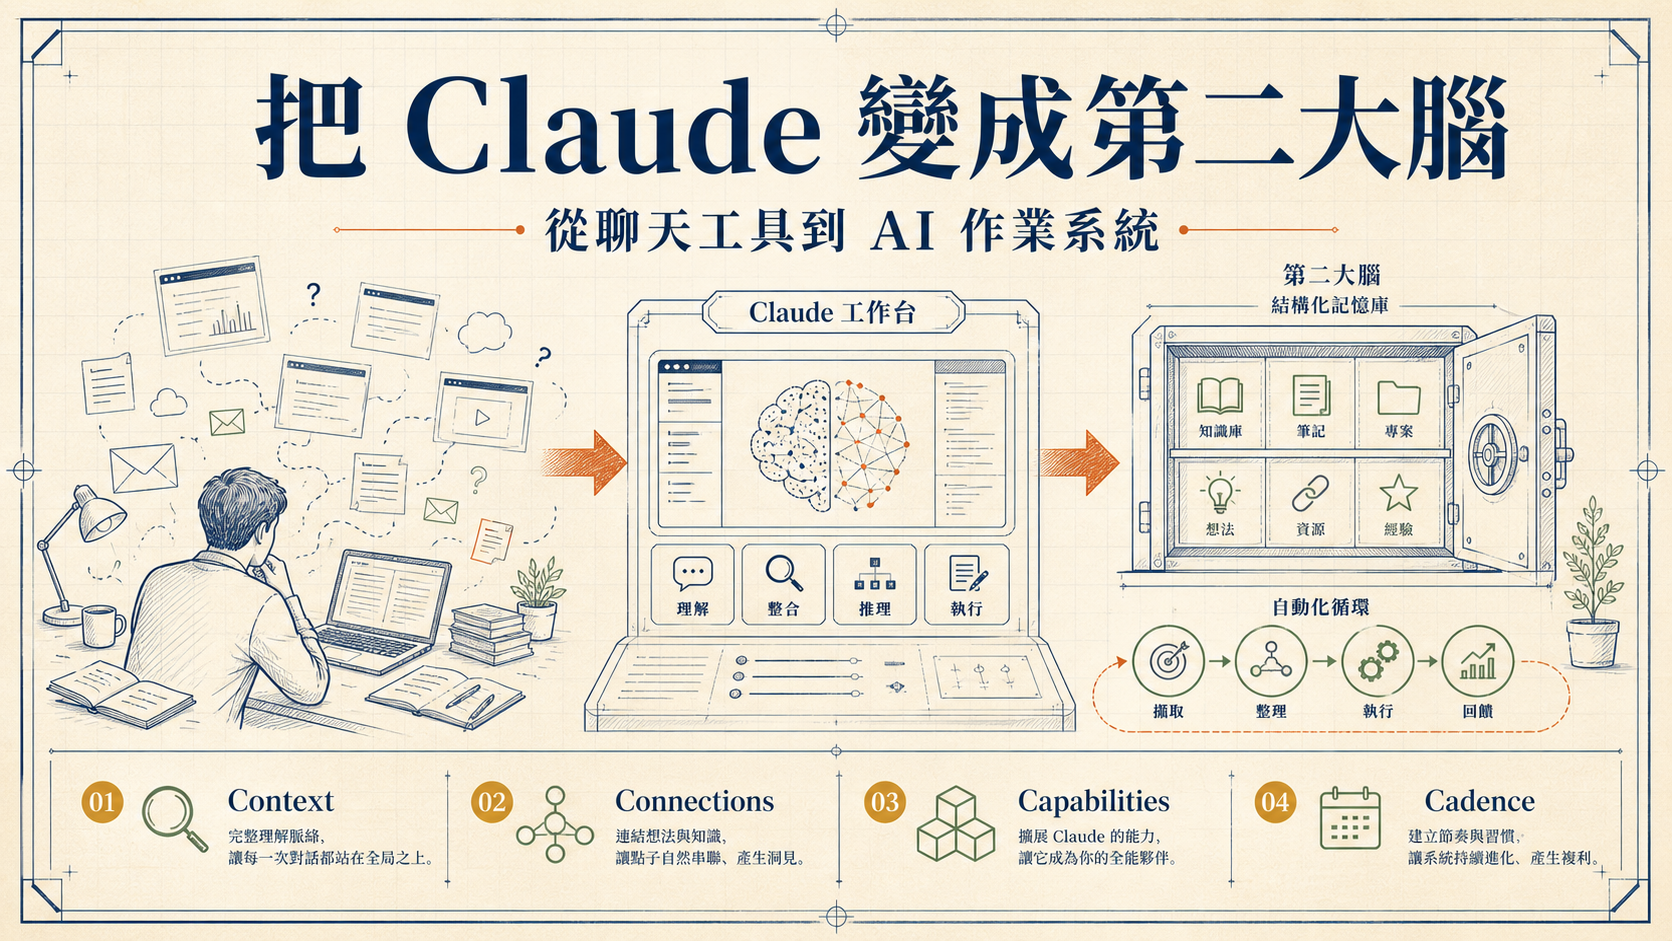
這也是魚塘自己最關心的部分。因為「AI 很聰明」不是系統;「AI 能幫我寫」也不是系統。系統是:知識放哪裡、權限怎麼接、技能怎麼驗證、排程怎麼監控、錯了怎麼回寫。少了這些,AI 越強,反而越容易把混亂放大。
1. 4C 架構|先讓它知道,再讓它做事
影片最有整理價值的部分,是講者提出的 4C:Context、Connections、Capabilities、Cadence。
前兩個 C 比較像 second brain。Context 是它是否理解你、你的業務、專案、客戶、規則、偏好與文件位置。Connections 是它能不能連到真實資料與工具,例如 Gmail、Slack、ClickUp、Stripe、QuickBooks、Google Workspace、Notion、Google Drive 或其他 API。
後兩個 C 才開始像 AI operating system。Capabilities 是它能不能用 skills、workflows、CLI、API、MCP 或本地檔案真正完成任務。Cadence 則是它能不能在手動請求之外,依事件或排程持續運轉,例如每週報告、客戶預約後的 follow-up、每日資料檢查、定期內容整理。
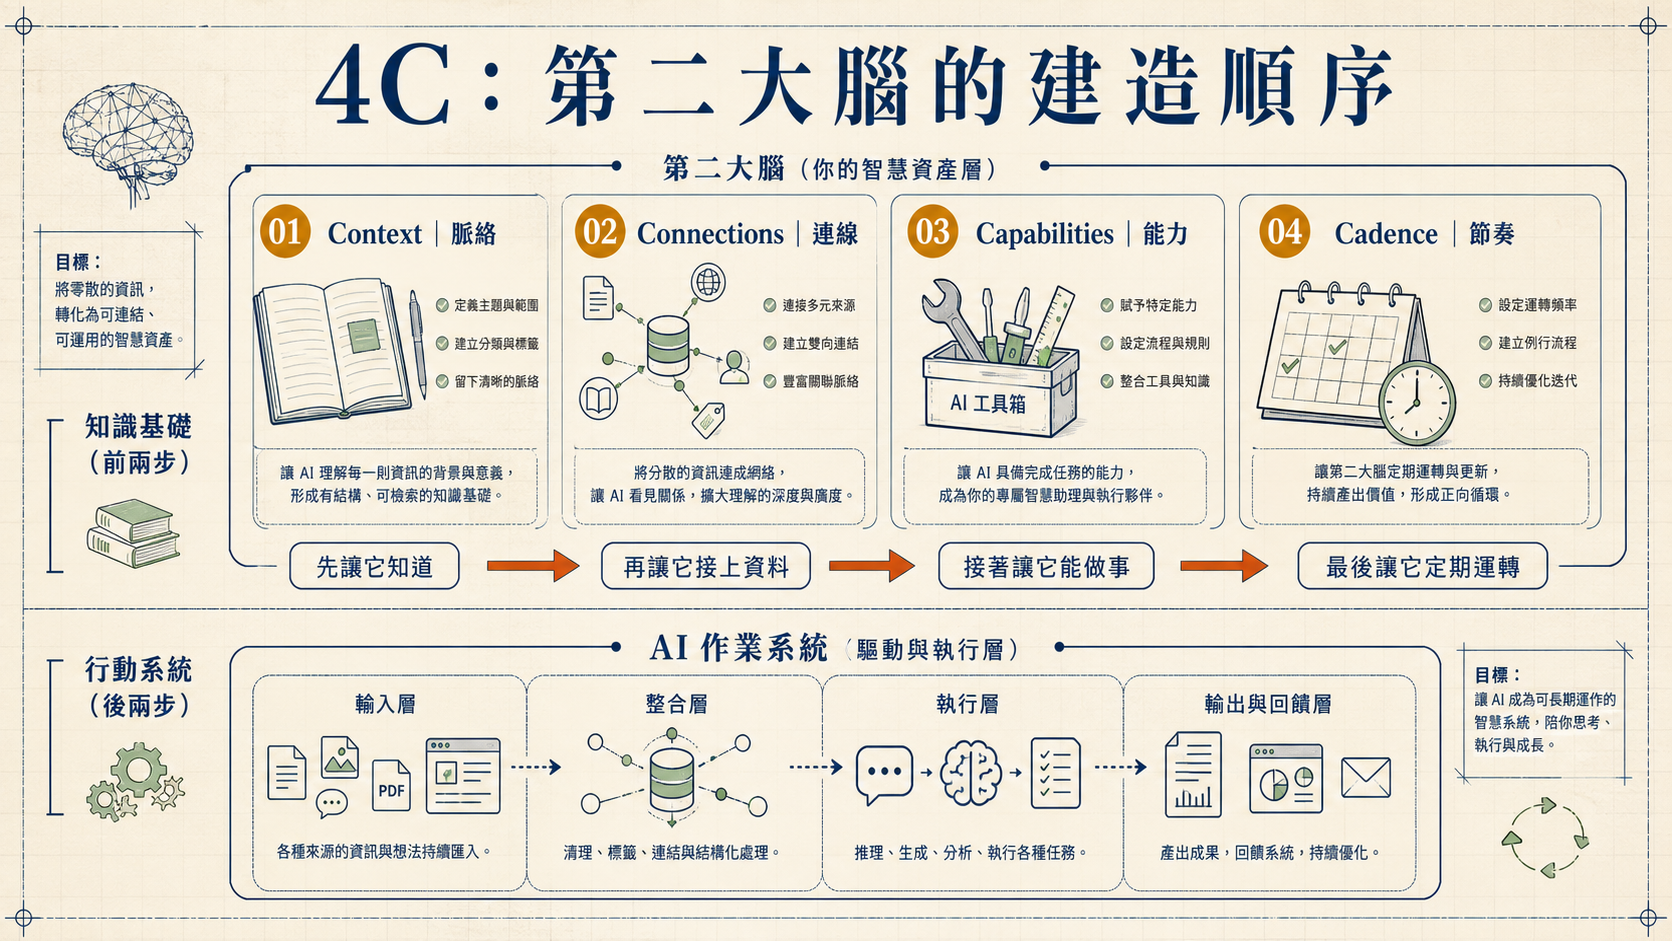
這個順序重要,因為很多人會反過來做。一開始就想自動化,一開始就想 agent 幫你寄信、整理客戶、更新專案、做財務報表。但如果它不知道公司規則、資料來源、誰可以被通知、哪個數字是最新的,這些自動化只會變成有禮貌的風險製造機。
比較穩的路徑是:先讓 AI 找得到東西,再讓它接上東西,然後才讓它做事,最後才讓它自動做事。這四步看起來慢,但其實是降低返工率。因為一旦底層 context 和 connections 亂掉,後面的 skills 和 automation 都會建在鬆動的地板上。
講者把這件事說成 adoption issue,也就是習慣問題。真正的第一步不是寫一份完美架構圖,而是把預設入口改掉:當你本來要開 Chrome、打開某個 SaaS、寄 email、查報表時,先試著從 Claude Code 或你選擇的 agent harness 開始。只有這樣,它才會累積足夠多的工作脈絡,變成你的系統,而不是偶爾借用的工具。
2. Context 路由樹|不要把所有東西塞進一個 prompt
影片裡最務實的一個比喻,是把 claude.md 或類似入口檔當成 router。它不是一本百科全書,而是一張路由表。
很多人聽到 context engineering,直覺會想把所有背景都塞進 prompt:我是誰、公司做什麼、客戶有哪些、規則是什麼、語氣偏好、專案文件、會議紀錄、工作流程。短期看,這樣好像有效;長期看,它會變成一團難以維護的巨型文字牆。
講者的做法比較像檔案系統設計:入口檔只保留關鍵方向,告訴 agent 規則在哪裡、references 在哪裡、skills 在哪裡、projects 在哪裡、wiki 在哪裡、memory 在哪裡。真正的知識分散在正確位置,需要時再被拉進來。
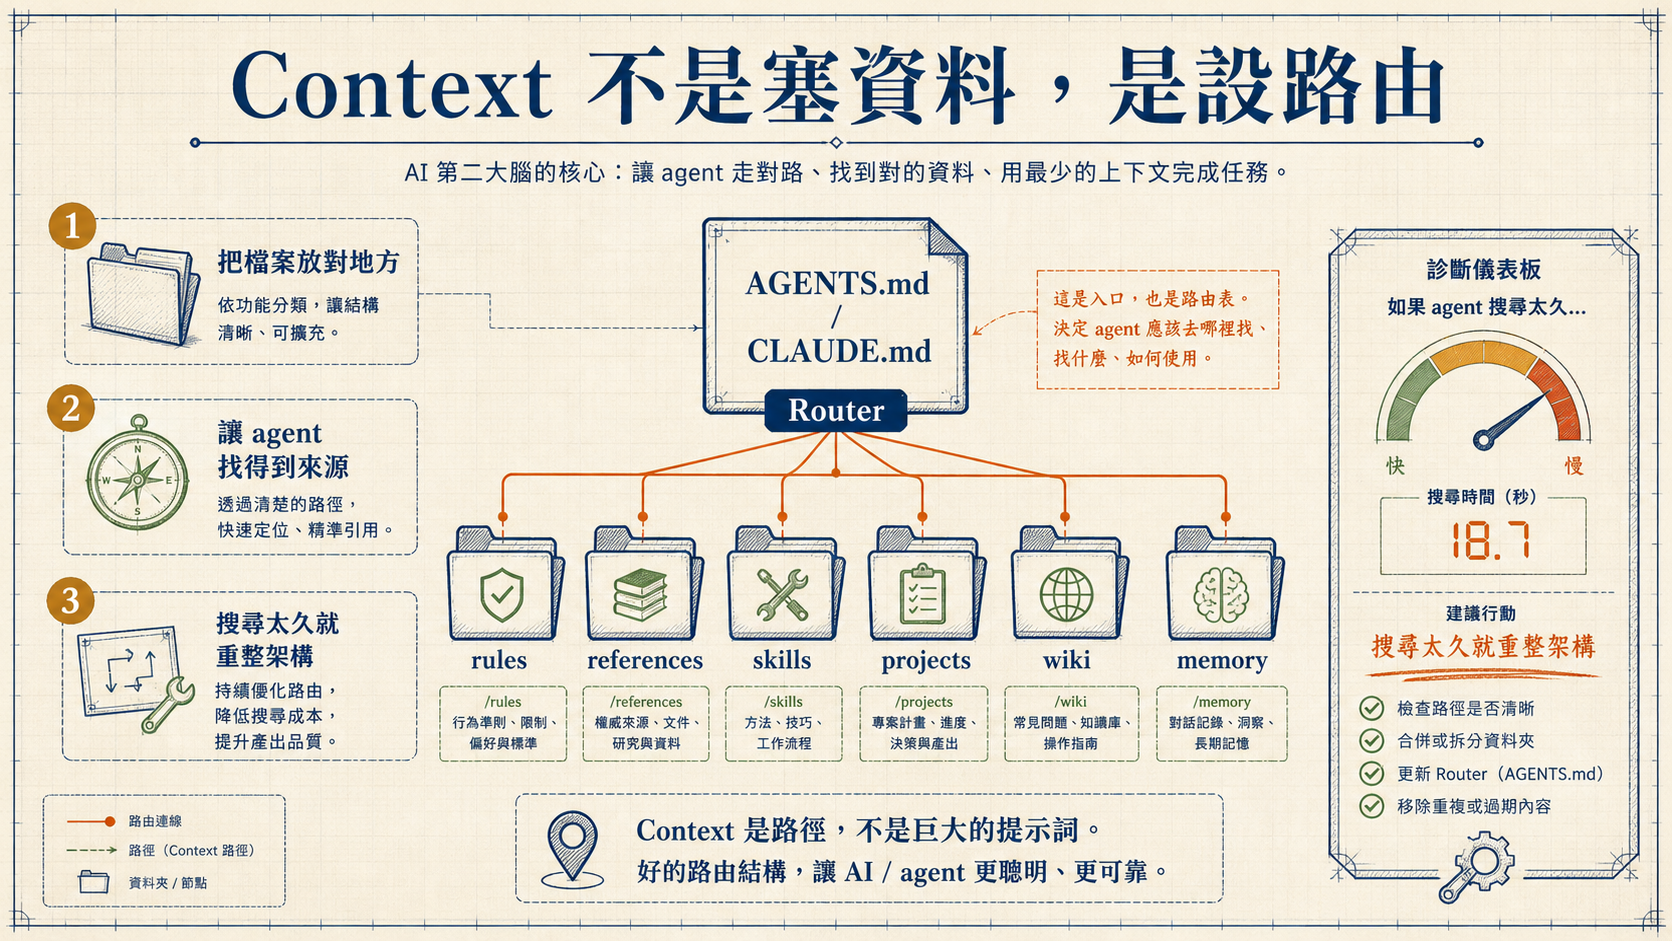
這裡有一個很好的診斷標準:如果 agent 找資料很快,而且找得到對的來源,context 還不算太多;如果它搜尋五分鐘還找不到一個你自己立刻知道在哪裡的檔案,架構就該重整。
這個判準比「context window 到底能塞多少 token」更有用。因為真正的問題不只是容量,而是可尋址性。AIOS 不是把整個人生壓縮成一段提示詞,而是建立一個它能導航的知識地圖。
影片也示範了 static data 的限制。講者讓系統根據他的頻道與業務資料產出介紹影片,但其中訂閱數過期了:系統知道他曾經有 620,000 subscribers,卻沒有即時知道當下接近 800,000。這不是 second brain 失敗,而是提醒我們要分清楚靜態記憶與即時資料。
靜態資料適合放身份、背景、長期規則、品牌語氣、流程與偏好。即時資料則應該透過 connections live pull,或至少有更新節奏。否則 AI 看似「很懂你」,其實可能只是很懂上一個版本的你。
3. Connections 的優先序|先接每週真的會碰的工具
第二個 C 是 Connections。講者沒有建議一開始就把所有工具都接上,而是從「每週真的會打開什麼」開始盤點。
這個方法很健康。因為 AIOS 的連線層不是展示用的整合清單,而是工作流的血管。你要先問:哪些工具承載收入?哪些地方有客戶資料?行事曆在哪裡?通訊在哪裡?任務在哪裡?會議紀錄在哪裡?團隊知識在哪裡?
講者舉的例子很典型:營收可能在 Stripe 和 QuickBooks;客戶可能在課程平台、社群或 YouTube;行事曆在 Google Workspace;通訊在 Gmail、Slack、ClickUp;知識可能散落在 Notion、Google Drive 或專案管理工具裡。
盤點完這些位置,才決定連線方式。API、CLI、MCP server、檔案同步都可以。講者偏好 API 和 CLI,因為他覺得控制更高、成本更可控;但他也承認 MCP 可以用。重點不是工具宗教,而是系統能不能可靠拿到資料、能不能追蹤來源、能不能避免過度授權。
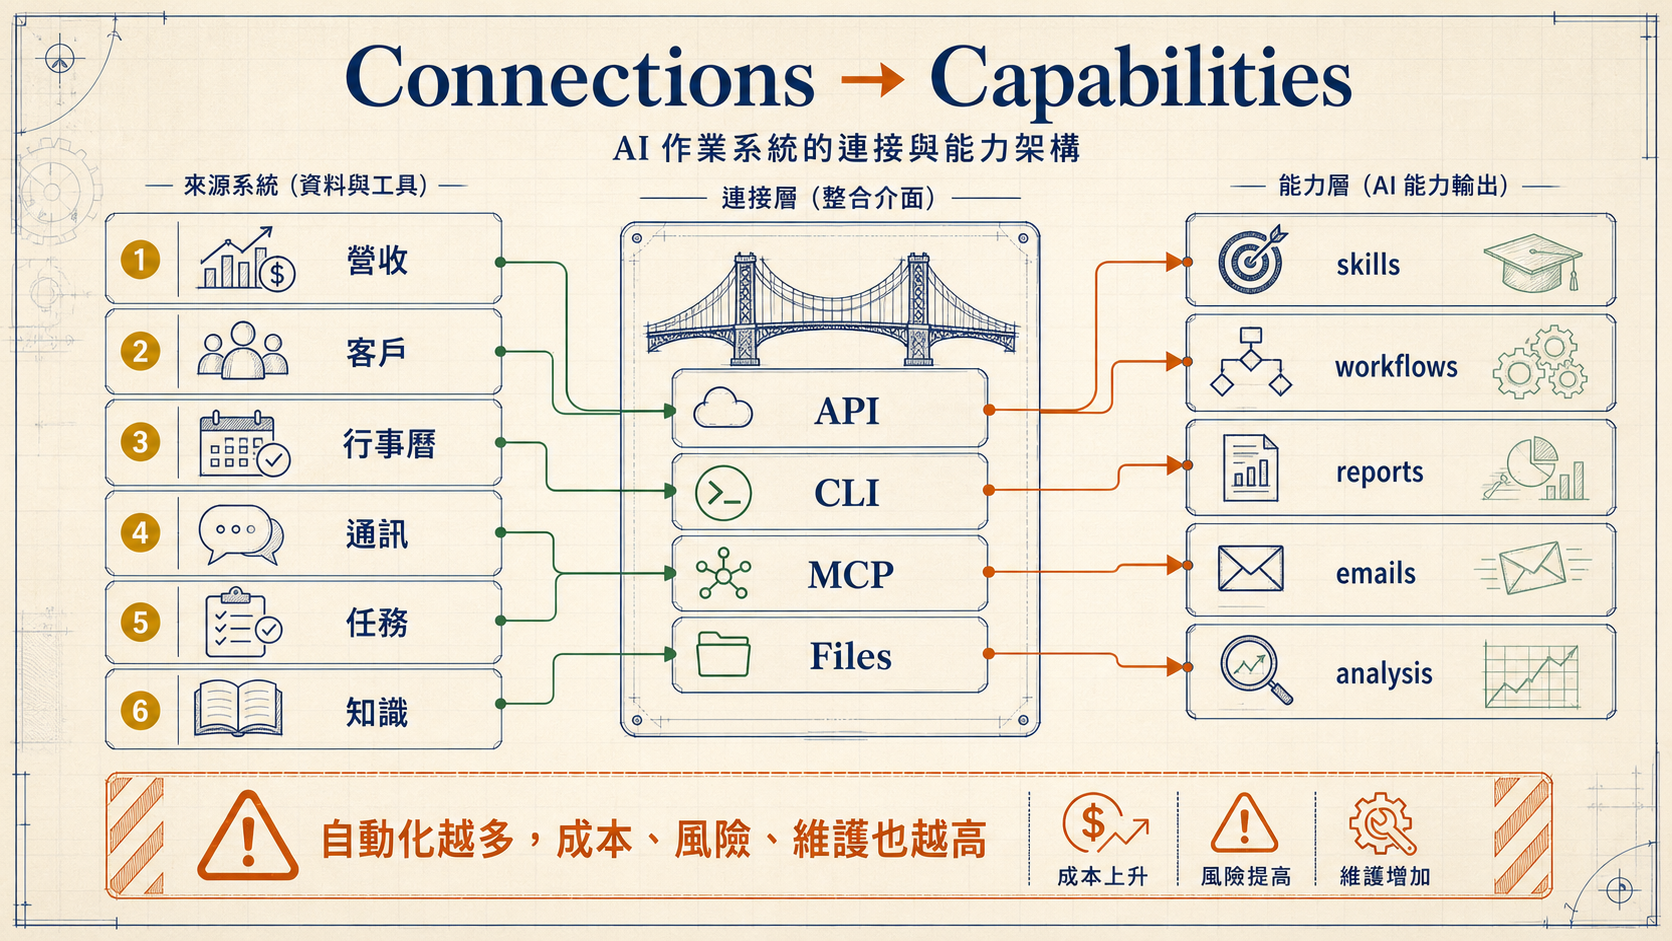
這裡也要保持一點編輯距離:影片是偏實作教學與工具推廣語境,講者自然會展示「我把很多東西接起來了」的爽感。但對一般團隊來說,Connections 最危險的地方也在這裡。只要接上,就會牽涉權限、隱私、資料外流、錯誤操作與成本。
所以比較好的起點不是「能接就接」,而是分層接:
第一層,只讀資料。讓 AI 能找資料、讀文件、摘要報表,但不能改東西。
第二層,低風險寫入。讓它建立草稿、生成報告、更新非關鍵欄位,但需要人確認。
第三層,受控執行。讓它寄信、改狀態、排程、建立任務,但要有 log、dry-run、回滾與明確 owner。
Connections 的目標不是讓 AI 變成萬能鑰匙,而是讓它在正確邊界內拿到正確資料。
4. Capabilities 與技能化|從問答變成可重複工作流
第三個 C 是 Capabilities。當 AI 有 context、也能連上資料,下一步才是讓它做事。
講者的建議很直接:當你本來要開一個 Chrome tab 寄 email、拉報表、查資料、整理內容時,先問自己這件事能不能在 AIOS 裡完成。工具有 API endpoint 嗎?有 CLI 嗎?能不能包成 skill?能不能變成 workflow?
這裡的關鍵字是「可重複」。一次性叫 AI 幫你寫一封信,仍然只是聊天;把寫信前要讀的資料、語氣規則、收件人限制、來源引用、草稿檢查與人工確認都寫進 skill,才開始接近系統能力。
影片中講者示範幾個例子:讓 Claude 根據他的背景與專案產出介紹影片;讓它整理頻道、課程與業務資料;讓它透過 API 或 CLI 拉資料;讓它用 skills 執行任務。這些例子的共同點不是模型回答很華麗,而是它能在既有資料與既有流程中行動。
但 Capabilities 也有陷阱。能力越多,不代表系統越成熟。每個 skill 都會引入維護成本:資料來源是否還有效?API 權限是否過大?錯誤時怎麼停?輸出是否需要人工審核?模型是不是在沒有來源的情況下補故事?
好的 skill 不只是「幫我做 X」,而是:
- 先讀哪些資料。
- 不准碰哪些東西。
- 輸出格式是什麼。
- 怎樣算完成。
- 哪些情況要停下來問人。
- 錯誤要怎麼寫回記憶。
魚塘自己的 media-to-editorial pipeline 其實也是同一種思路。它不是「叫 AI 寫一篇文章」而已,而是把影音 URL、轉錄、摘要、圖片、長文、frontmatter、schema validation、build gate 串成一條可驗證的流程。AI 寫文章只是其中一段;真正讓它能上站的是契約和 gate。
5. Cadence 與自動化風險|能睡覺時跑,也要有人醒著負責
第四個 C 是 Cadence。這一步最誘人,也最容易出事。
講者說,Cadence 是讓事情在你睡覺時也能運轉:事件觸發、固定排程、定期報告、客戶行為後的 follow-up、每週一更新、每天早上檢查資料。這聽起來像是 AIOS 的最終形態,但他也強調,這一步必須 earned。
也就是說,只有 battle-tested 的 skills 才適合進 cadence。你要先知道這個 skill 在手動模式下穩定,知道它會錯在哪裡,知道成本大概多少,知道怎麼驗證輸出,知道怎麼停止它。否則自動化只是把錯誤從「你看得到」變成「你醒來才發現」。
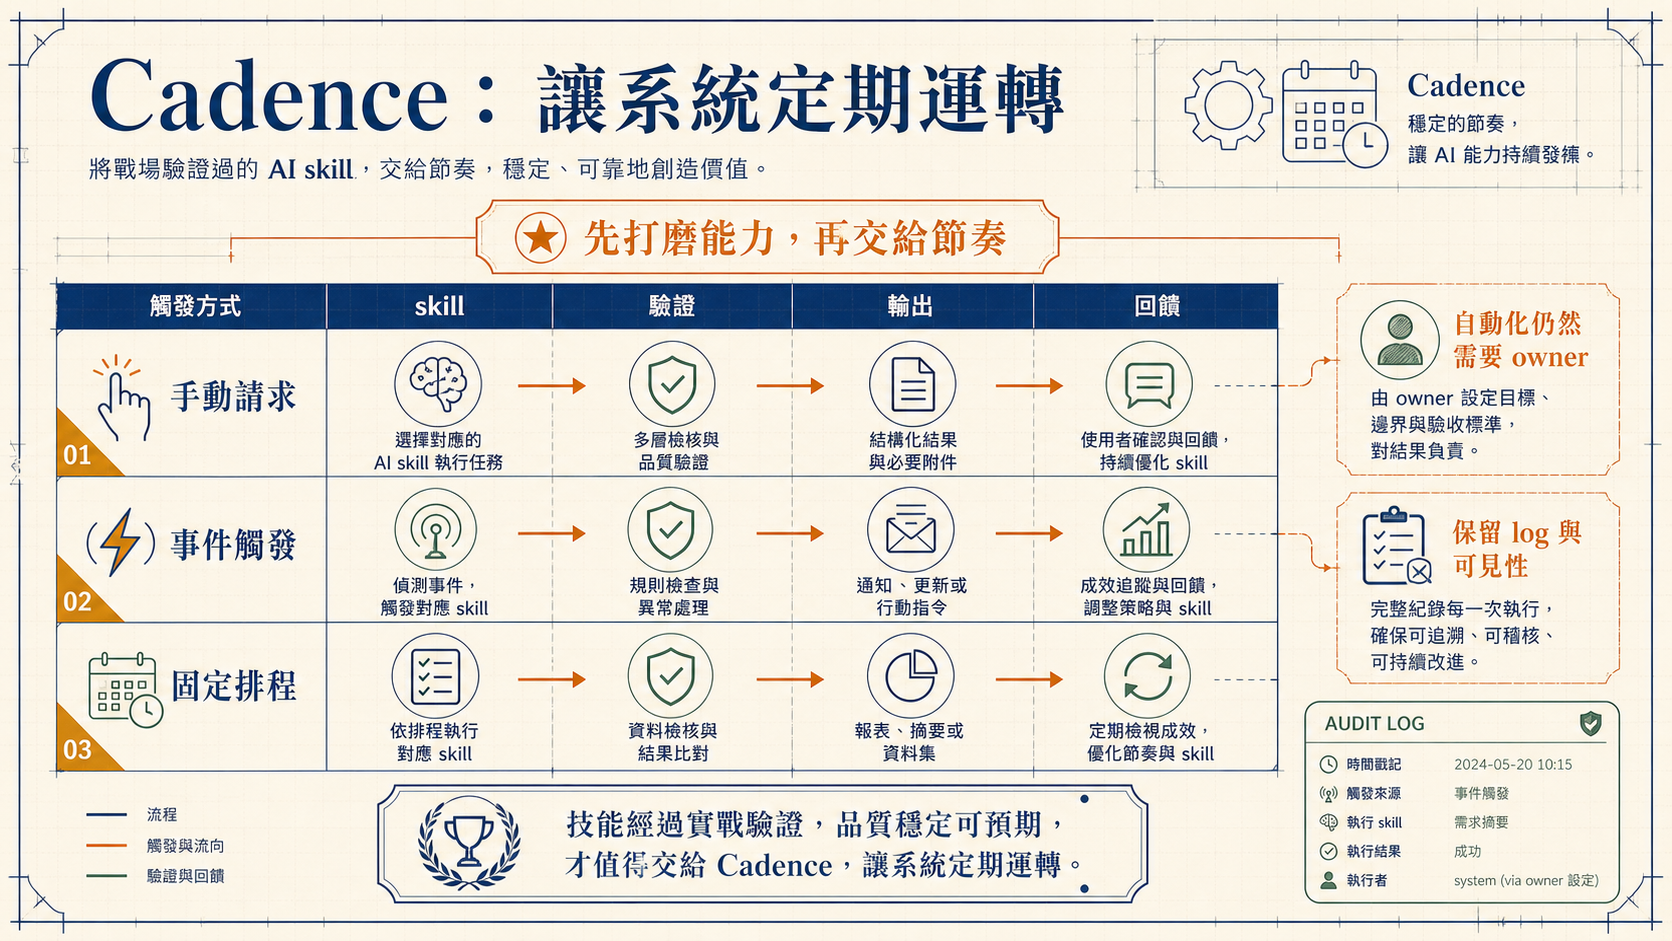
影片中有一句很重要的提醒:自動化越多,成本、風險與維護都會上升。這句話值得放在所有 AI agent 設計文件的第一頁。
更多 autonomy 不代表你可以忘掉它。相反,越自動化越需要 visibility。至少要有 log、狀態、輸出預覽、錯誤通知、owner、停止條件與審核點。沒有這些,AIOS 就不是作業系統,而是看起來很聰明的黑箱排程器。
實務上,可以把 cadence 分成三類:
手動請求:使用者明確叫它做,風險最低,適合早期 skill。
事件觸發:某個事件發生後自動啟動,例如新 email、新客戶預約、新 issue、新訂單。這需要明確 scope 和通知機制。
固定排程:每天、每週、每月自動跑。這最需要成本監控與輸出驗證,因為它可能在沒有人注意時持續花錢或累積錯誤。
如果一個流程還沒有明確驗證方式,就不要急著讓它進 cadence。先讓它在手動模式下被用到無聊,再考慮自動化。
6. 使用習慣|可以外包思考,不能外包理解
影片後段的 usage tips,比工具清單更有價值。因為真正能不能長期用好 AIOS,最後取決於人怎麼用。
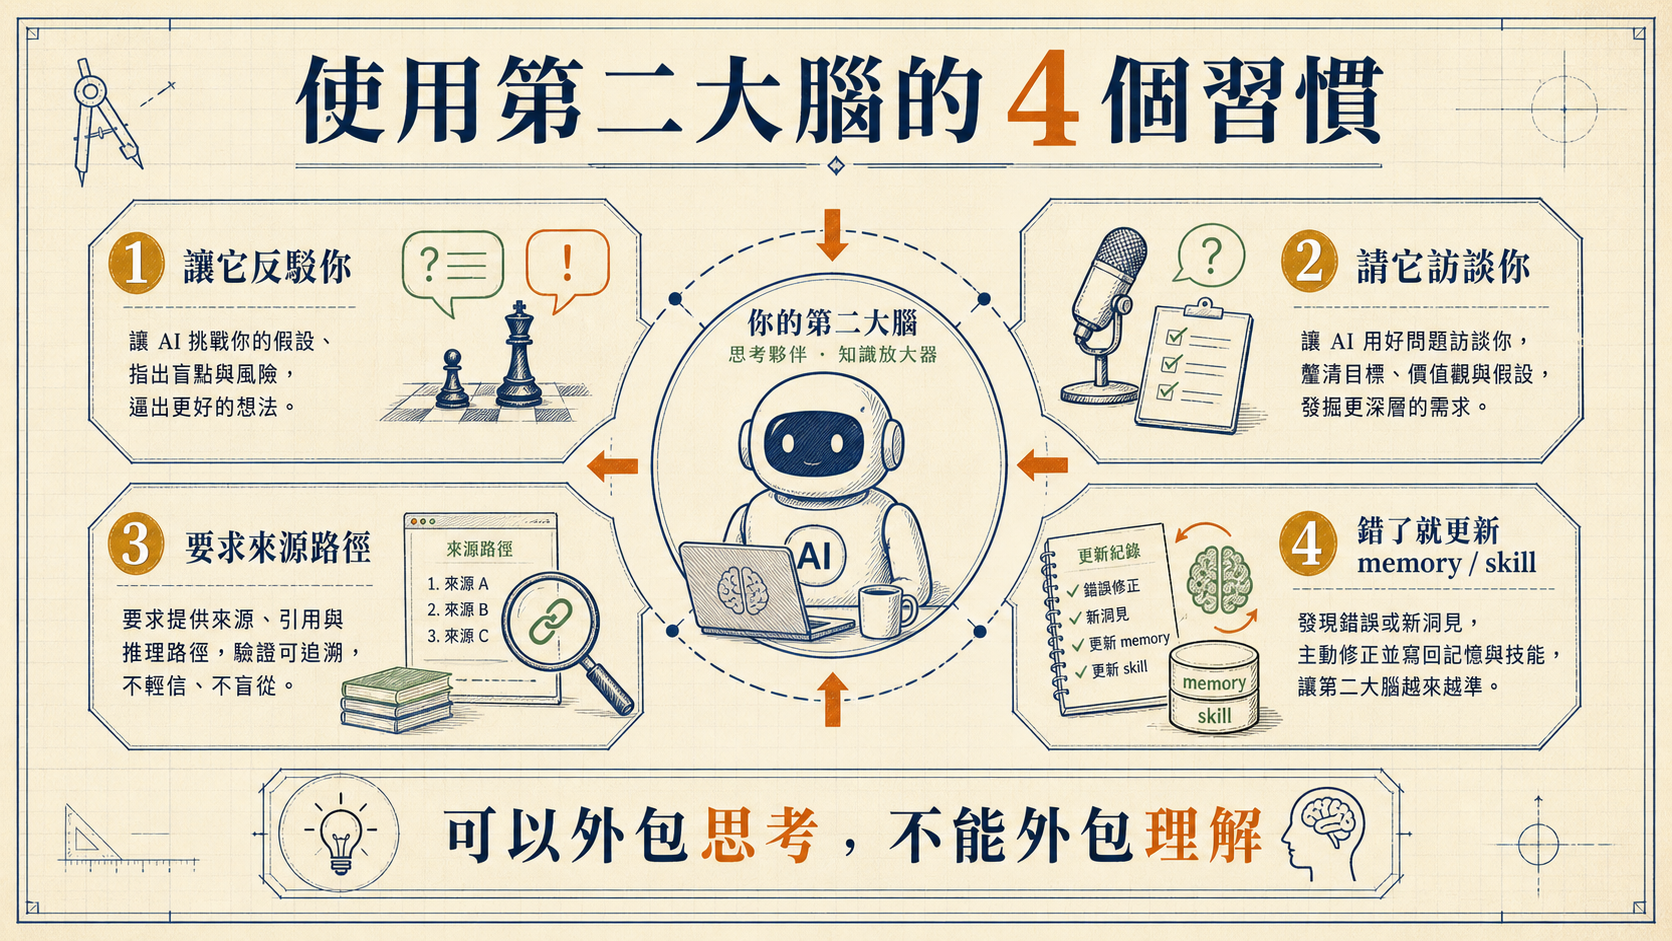
第一,把 AI 當 thought partner,但不要把它當裁判。你可以讓它腦力激盪,讓它提出反方,讓多個 subagents 或不同 persona 辯論。但最後要由你做判斷。模型有時會迎合使用者,所以你要主動要求它挑戰你,而不是只稱讚你的想法。
第二,讓它訪談你。講者提到一個 grill me skill,用來追問問題、逼自己把模糊想法說清楚。這其實是非常好的 AI 使用姿勢:很多時候問題不是 AI 不會做,而是人還沒有把需求、限制、背景與判準講清楚。
第三,錯了就更新系統。當 AI confidently gets something wrong,不要只修這次答案,而是把錯誤回寫到 claude.md、memory 或 skill。讓錯誤變成系統學習,而不是一次性糾錯。
第四,要求來源。尤其是 second brain 場景,AI 最容易產生一種「它好像很懂我」的錯覺。你應該要求它指出資料來自哪個檔案、哪個路徑、哪個 API、哪段記錄。沒有來源的自信,對工作系統來說不是智慧,是風險。
講者在 Q&A 也提醒資料去向:如果使用 Claude models,資料會送到 Anthropic;如果處理高度敏感資料,就要重新評估閉源模型是否適合。這一點在第二大腦場景尤其重要,因為你越想讓 AI「懂你」,就越可能把更多私人、公司、客戶與財務脈絡放進去。
所以本文的編輯結論是:AI second brain 的重點不是讓模型知道更多秘密,而是讓系統知道更多路徑。好的 AIOS 應該讓資料可定位、權限可控、任務可驗證、錯誤可回寫、自動化可監控。
如果只是多一個聊天視窗,你得到的是回答。如果你建立 context、connections、capabilities 和 cadence,你得到的才可能是一個工作系統。
但最後仍然要記得:可以外包思考,不能外包理解。API 細節、文字草稿、報表初稿、資料整理可以交給 agent;判斷、責任、邊界與風險不能。