010. 閱讀前提|「外洩」是敘事入口,不是本文結論
這支影片以「Claude Code 原始碼因 source map 被上傳到 npm 而外洩」開場,並表示講者據此分析了約 1,900 個檔案。這是一個很有吸引力的故事,但在進入技術內容前,必須先把兩件事分開:第一,這是影片講者對事件的描述;第二,影片展示的架構模式是否合理、是否值得開發者借鏡。
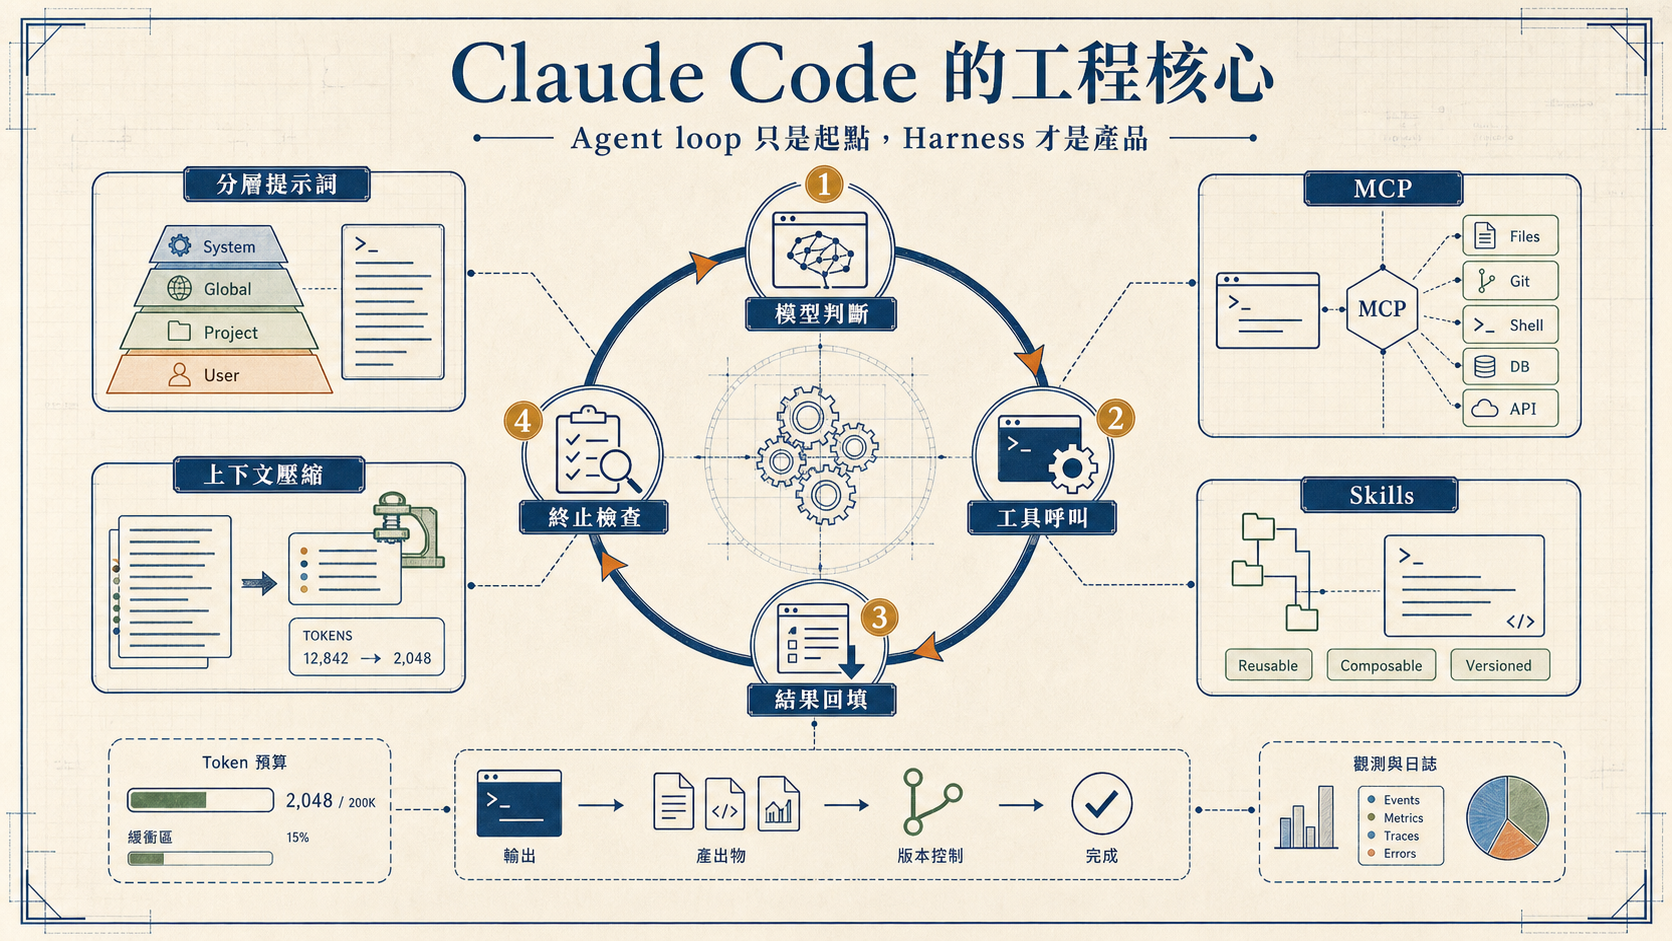
本文採取後一種讀法。我們不把「外洩」當成已由 Anthropic 證實的事實,也不把影片中的檔名、統計或內部註解當成官方文件。真正值得整理的是六組工程問題:agent loop 如何持續運作、提示詞如何依狀態組裝、工具如何被治理、上下文如何壓縮、MCP 如何接入外部能力,以及 Skills 如何把流程按需載入。
來源影片:10 分鐘速通 Claude Code 洩露原始碼核心架構,頻道「軒轅的編程宇宙」,片長約 12 分鐘。
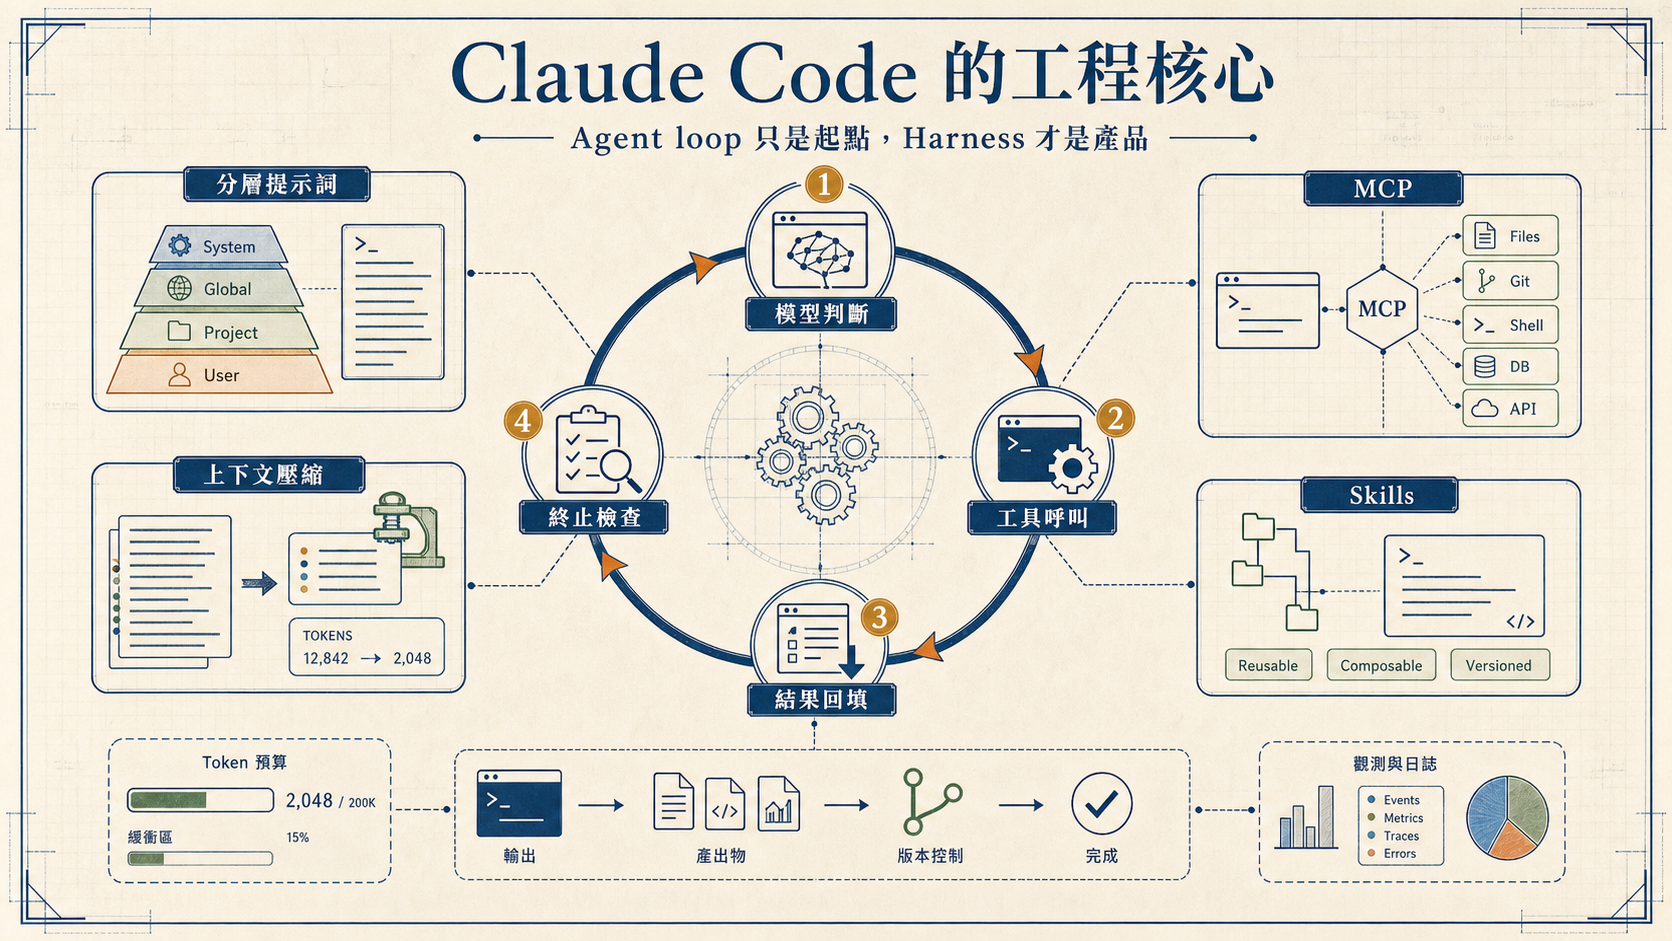
把所有細節抽掉,coding agent 最核心的部分其實非常樸素:模型讀取目前狀態,決定要不要呼叫工具;工具執行後,結果被追加到對話歷史;模型再讀一次,繼續下一步,直到完成或觸發終止條件。真正困難的不是寫出這個迴圈,而是讓它在真實專案中不失控。
這也是理解 Harness 的好起點。Harness 不是另一個模型,而是模型周圍那套「讓工作能持續、安全、可追蹤地推進」的工程系統。它處理預算、權限、檔案、終端、錯誤、壓縮、觀測與擴充。模型回答「下一步做什麼」,Harness 決定「這一步能不能做、怎麼做、做完如何回報、何時必須停」。
021. Agent loop|簡單迴圈如何成為可控產品
影片把 Claude Code 的核心描述成一個串流驅動的迴圈。模型回應不是一次完整送達,而是逐段到達;執行器一邊解析內容,一邊辨認文字、工具呼叫與用量資訊。當模型要求使用某個工具,系統執行它,把結果包成新的訊息,再連同既有歷史送進下一輪。
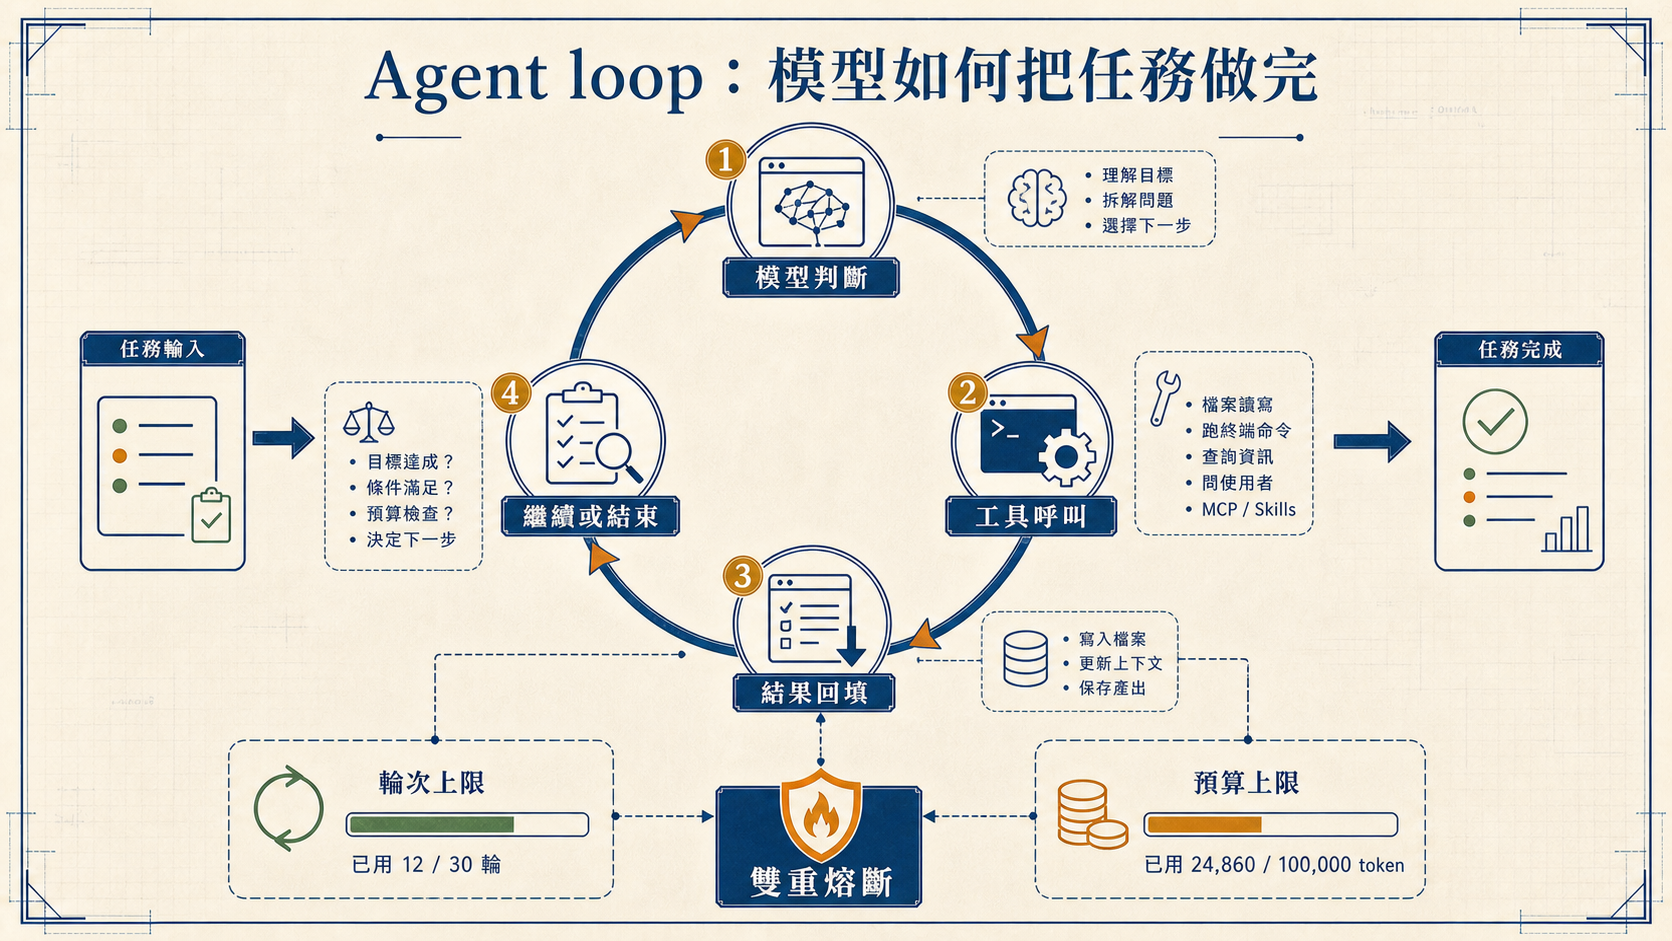
這個結構可濃縮成四步:
- 模型判斷:根據任務、歷史與環境,產生文字或工具呼叫。
- 工具執行:檔案、終端、搜尋或其他工具在受控環境中運作。
- 結果回填:標準輸出、錯誤、檔案差異與狀態被寫回 conversation。
- 終止檢查:完成就結束,否則進入下一輪。
如果只有這四步,系統仍然很容易失控。影片特別指出兩種互補的限制:最大輪次與最大預算。只限制輪次,模型可能在少數幾輪產生大量 token;只限制金額,系統又可能用很低的單輪成本陷入漫長死迴圈。兩個條件同時存在,分別控制「時間上的不收斂」與「成本上的突然放大」。
這個設計可延伸成更完整的終止矩陣:輪次、token、金額、牆鐘時間、連續相同工具呼叫、連續相同錯誤,以及使用者取消。可靠的 agent 不該只有「成功完成」一種出口;它也要能清楚地說明自己為什麼停下來。
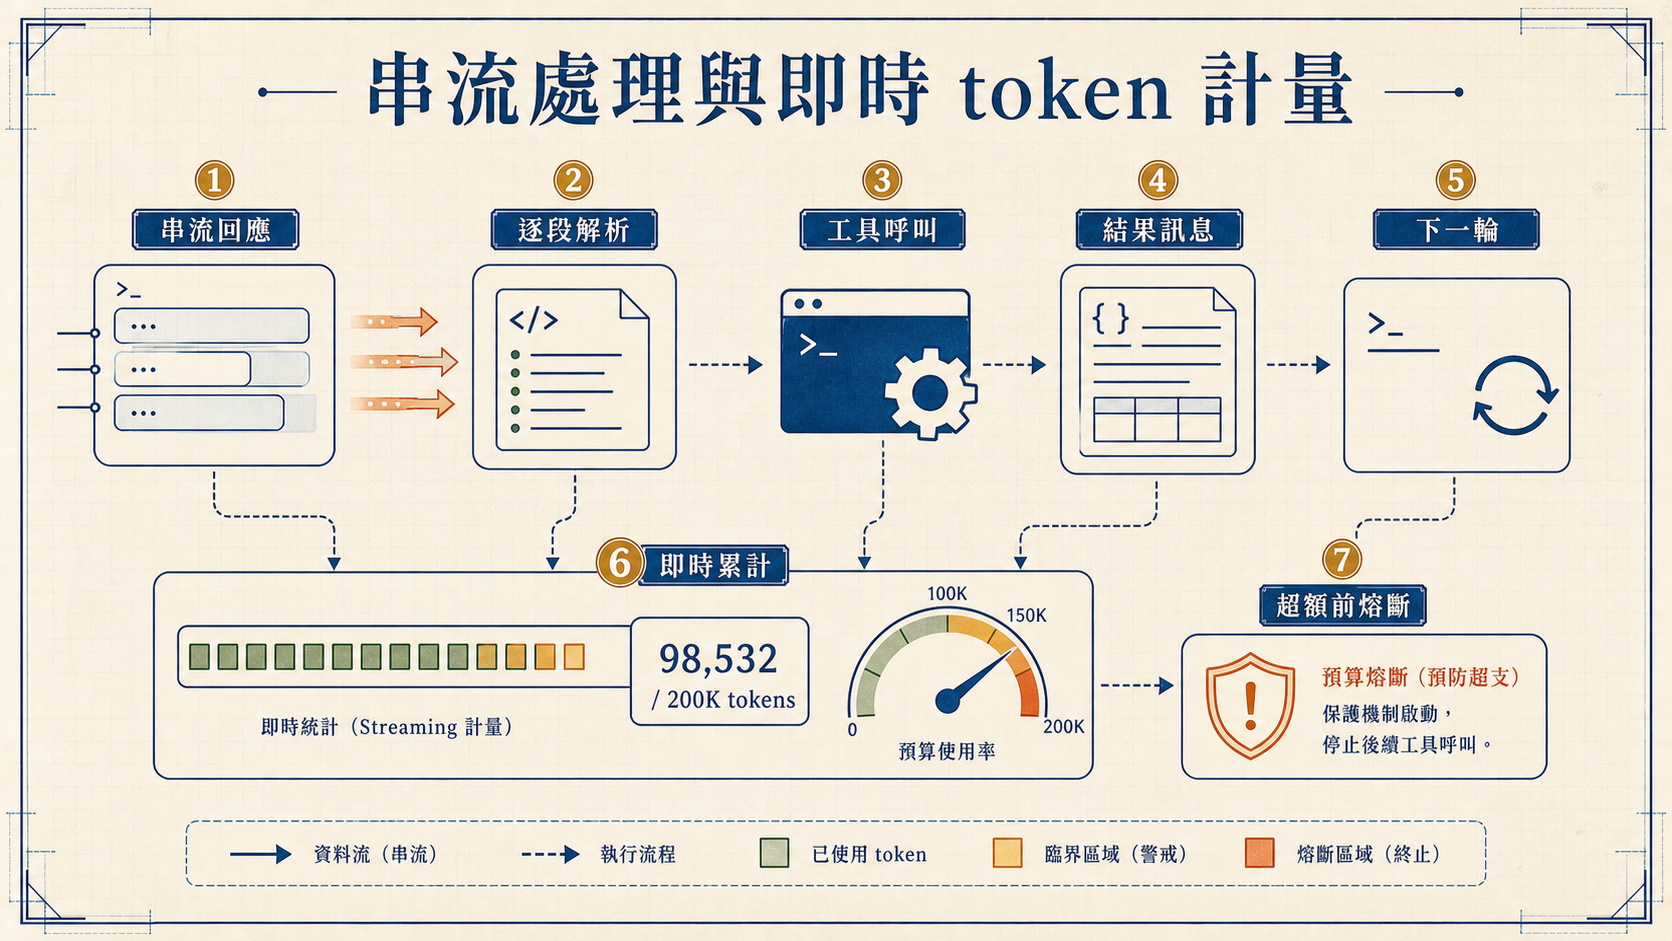
影片還提到 token 用量是隨串流回應即時累計,而不是等整輪結束後才結算。這項細節很重要:如果預算檢查只發生在回應完成後,超額早已發生;即時計量則能讓系統在接近上限時提早終止、縮短輸出,或切換到較便宜的策略。
從產品角度看,成本不是報表上的事後數字,而是 agent runtime 的即時狀態。它應該像 CPU、記憶體與逾時一樣被監控,並直接參與控制流程。
032. 提示詞裝配|狀態比「超長 system prompt」更重要
很多人把 agent 的提示詞想成一篇巨大的祕密文件,好像只要找到那段文字,就能複製整個產品。影片提供的另一種圖像更接近工程現實:提示詞是依當前狀態動態裝配的多層結構。
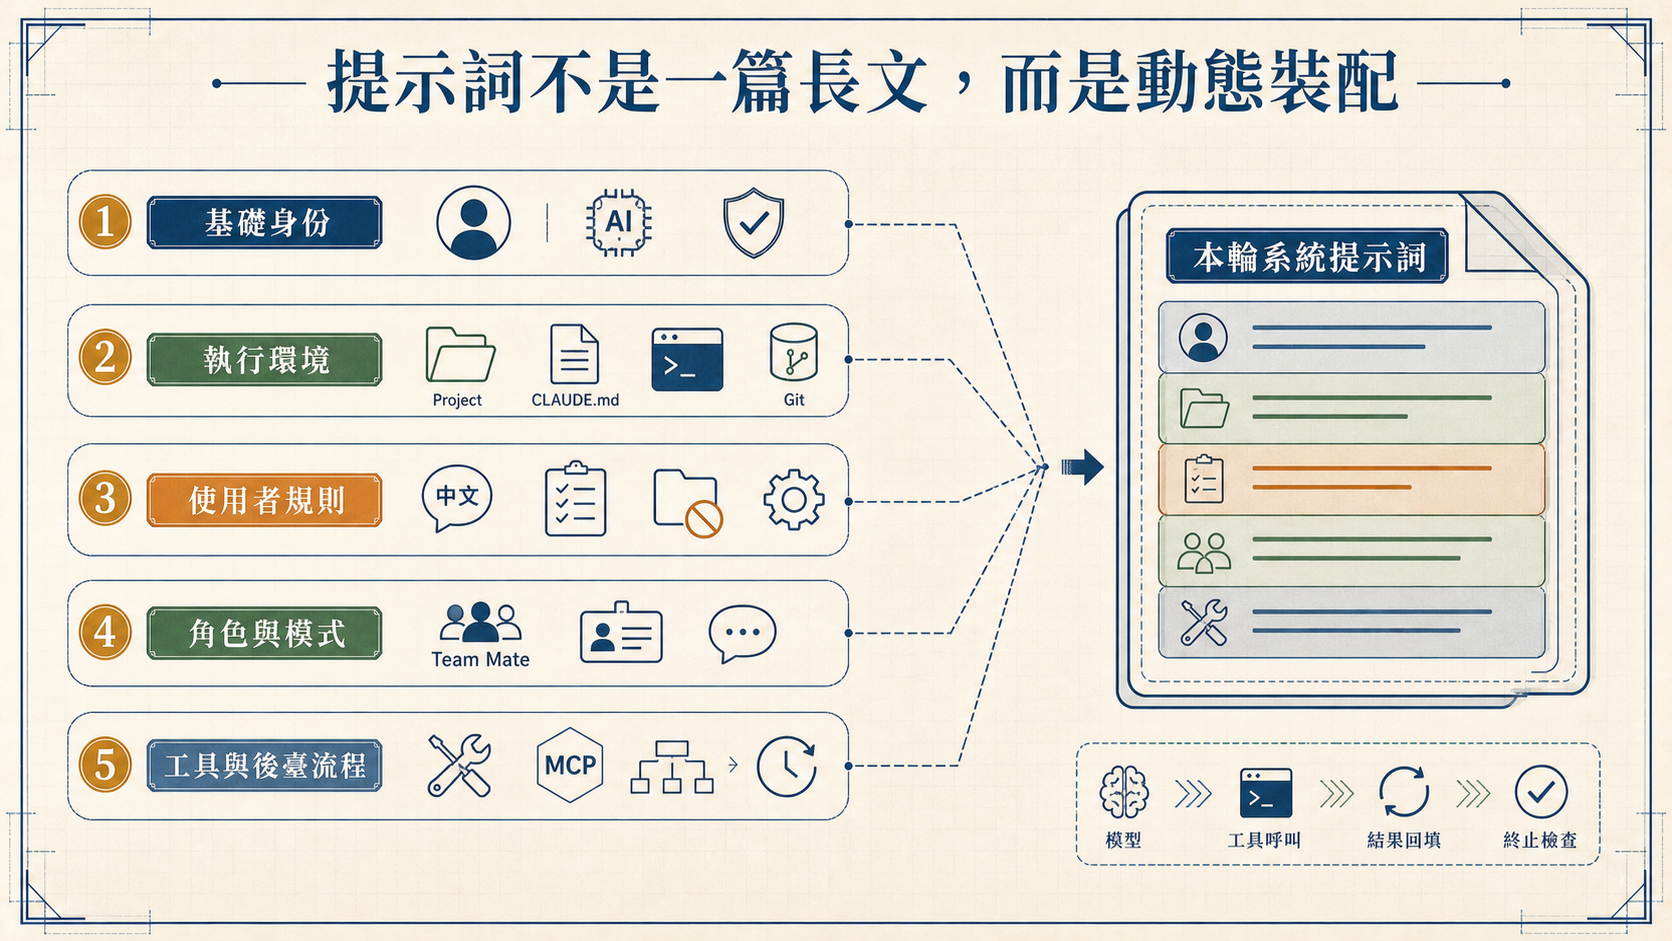
影片將系統側資訊分成五層:
- 基礎身份:定義它是面向軟體工程的互動式 agent,而不是一般聊天機器人。
- 執行環境:注入目前目錄、Git 狀態、日期、語言偏好、
CLAUDE.md與 MCP server 指令。 - 使用者規則:加入長期偏好與限制,例如回覆語言、工作方式、禁止觸碰的目錄。
- 角色與模式:依目前是主 agent、子 agent、規劃模式或其他協作角色補上約束。
- 工具與後臺流程:提供各工具的適用條件,以及初始化、壓縮等專用流程的提示詞。
這裡最值得注意的不是「五」這個數字,而是責任分層。身份不該和專案狀態混在一起;使用者規則不該被某個工具說明覆蓋;子 agent 的通訊契約也不該靠模型自行猜測。分層後,每一塊資訊都能有自己的來源、更新頻率與優先順序。
動態裝配還帶來另一個好處:減少過期資訊。Git 狀態與日期每輪都可能改變,應由 runtime 重新生成;專案規則相對穩定,可從檔案載入;工具說明只在工具可用時加入。與其追求一份無所不包的 prompt,不如先建立清楚的 context pipeline。
這也解釋了為什麼同一個模型放進不同 coding agent,體感可能差很多。差異未必來自模型本身,而是它每一輪究竟看到了哪些可靠、及時、沒有互相衝突的狀態。
043. 工具系統|有能力不等於會正確使用
沒有工具時,模型只能描述「應該怎麼改」;有了檔案與終端工具後,它才可能真正讀取專案、修改程式碼、執行測試並觀察結果。影片把內建工具概括成四類:檔案、環境、規劃控制、協作擴充。
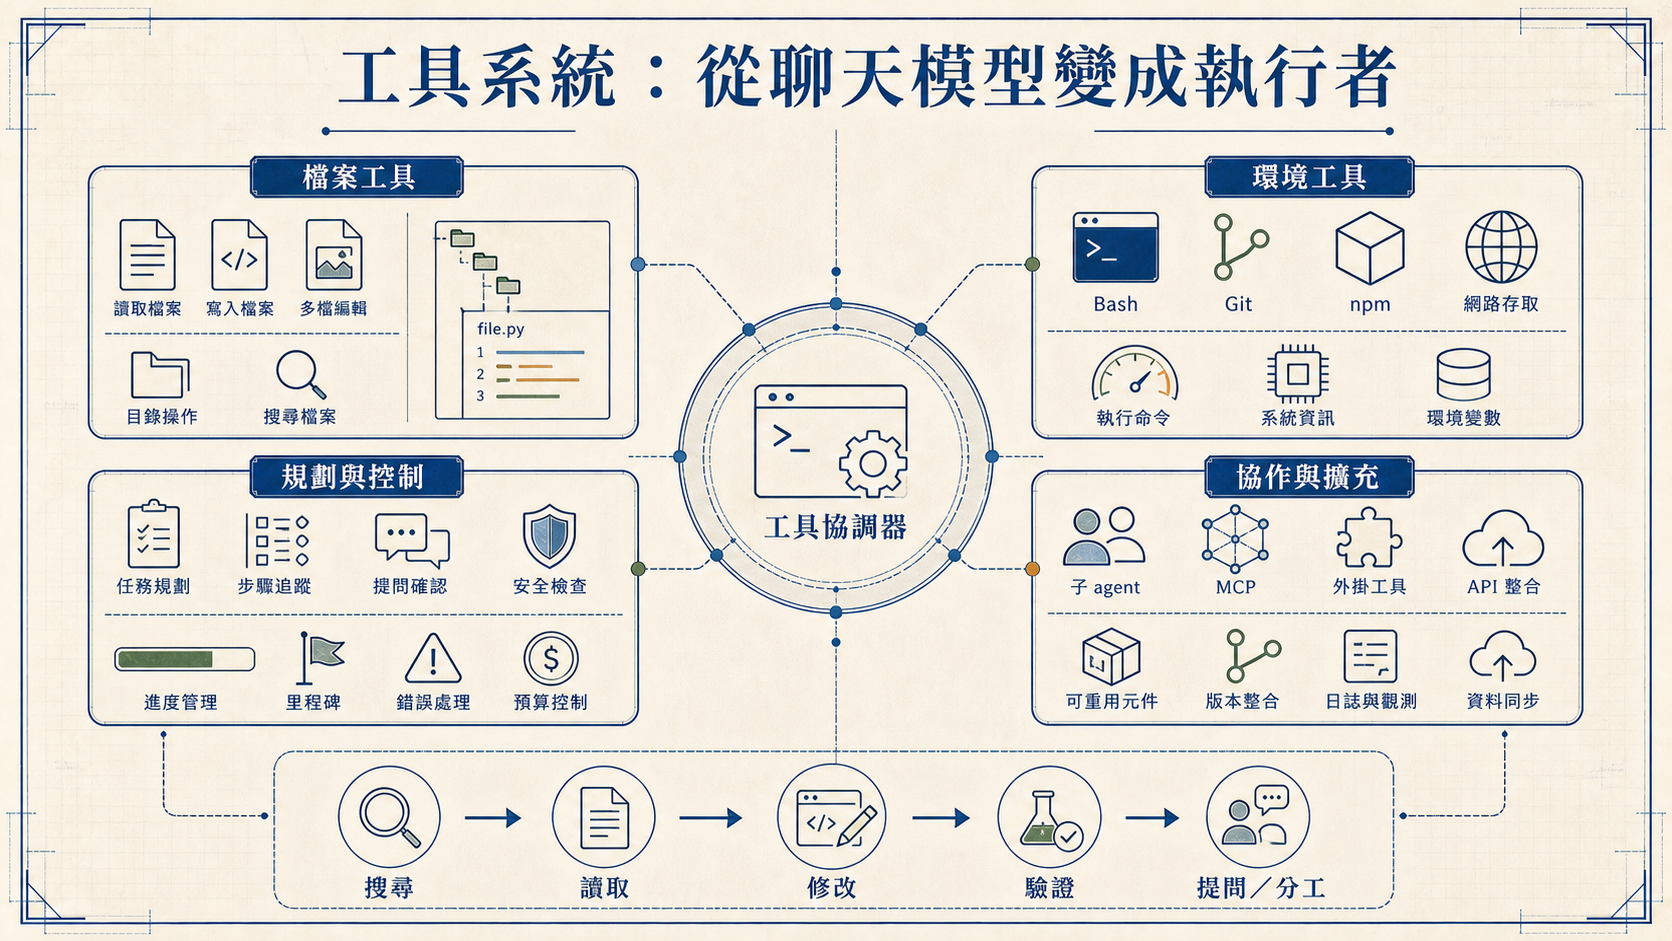
檔案工具負責讀寫與差異套用;環境工具以 Bash 為代表,連接編譯器、測試、Git 與其他 CLI;規劃控制工具處理任務清單、向使用者提問與狀態切換;協作擴充工具則把工作拆給子 agent,或接上 MCP 等外部能力。
但工具系統的重點不只是數量。每個工具至少包含四層契約:
- 能力契約:輸入、輸出、錯誤格式與副作用。
- 選擇契約:什麼情況該用、什麼情況不該用。
- 權限契約:可讀寫哪些路徑、能否連網、是否需要批准。
- 回報契約:哪些結果要回填給模型,哪些資訊應摘要或截斷。
影片提到 Bash 等工具本身也帶有提示詞,協助模型在多個工具之間選路。這並非多餘說明,而是工具治理的一部分。當兩個工具能力重疊時,模型需要知道哪一個更精確、風險更低、輸出更容易解析。
成熟的 coding agent 通常會形成固定節奏:先搜尋,再讀取;理解後修改;修改後驗證;遇到無法合理推定的選項才詢問;工作可拆且彼此獨立時再分工。這些行為不是單一工具帶來的,而是工具設計、提示詞與執行政策共同塑造的。
安全性也藏在這裡。寫檔、刪檔、執行 shell 與對外發送資料,風險完全不同。可靠系統必須把權限與審批放在 runtime,而不是只寫一句「請小心」交給模型自律。
054. 上下文生命週期|壓縮不是補救,而是排程
長任務最終都會碰到 context window。檔案內容、工具輸出、測試日誌與模型推理不斷累積,如果等視窗真的填滿才處理,系統甚至可能沒有足夠空間產生摘要。
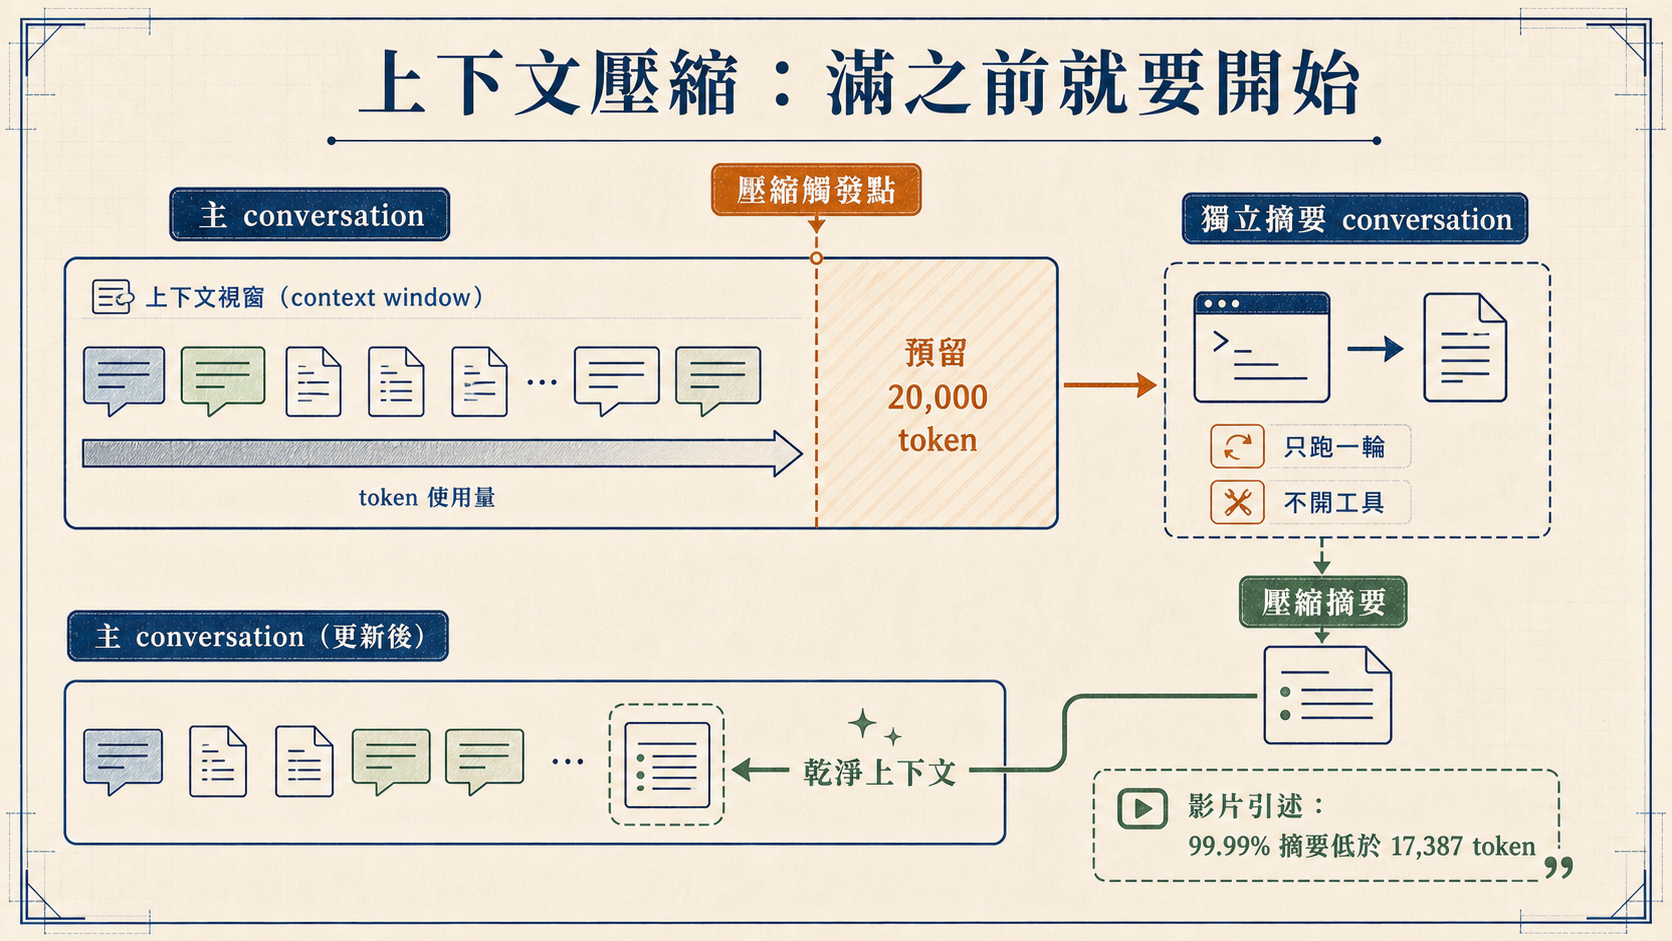
影片描述的做法是提前預留壓縮空間。它引述程式碼註解稱,系統保留 20,000 token 給壓縮流程,歷史資料中 99.99% 的摘要輸出低於 17,387 token。這些數字沒有官方公開來源可在本文獨立核對,因此應視為講者轉述;但其背後的設計原則很扎實:壓縮本身也需要上下文,所以觸發門檻必須包含壓縮成本。
另一個關鍵是隔離。影片稱壓縮會在新的 conversation 裡執行,最多一輪,不提供工具,唯一任務是產生摘要。這樣能避免摘要過程把更多訊息塞進主 conversation,也降低工具呼叫干擾。完成後,只把摘要結果帶回主流程。
一份有用的壓縮摘要不能只是「前情提要」。對 coding agent 而言,它至少要保留:
- 使用者目標與不可違反的限制。
- 已讀過的關鍵檔案與其角色。
- 已完成的修改、尚未完成的工作。
- 測試結果、錯誤訊息與已排除的假設。
- 重要識別符、路徑、命令與決策理由。
如果摘要只保留自然語言故事,卻遺失精確路徑與失敗證據,agent 會在壓縮後重走一遍舊路。因此,context compaction 更像狀態 checkpoint,而不是一般文章摘要。
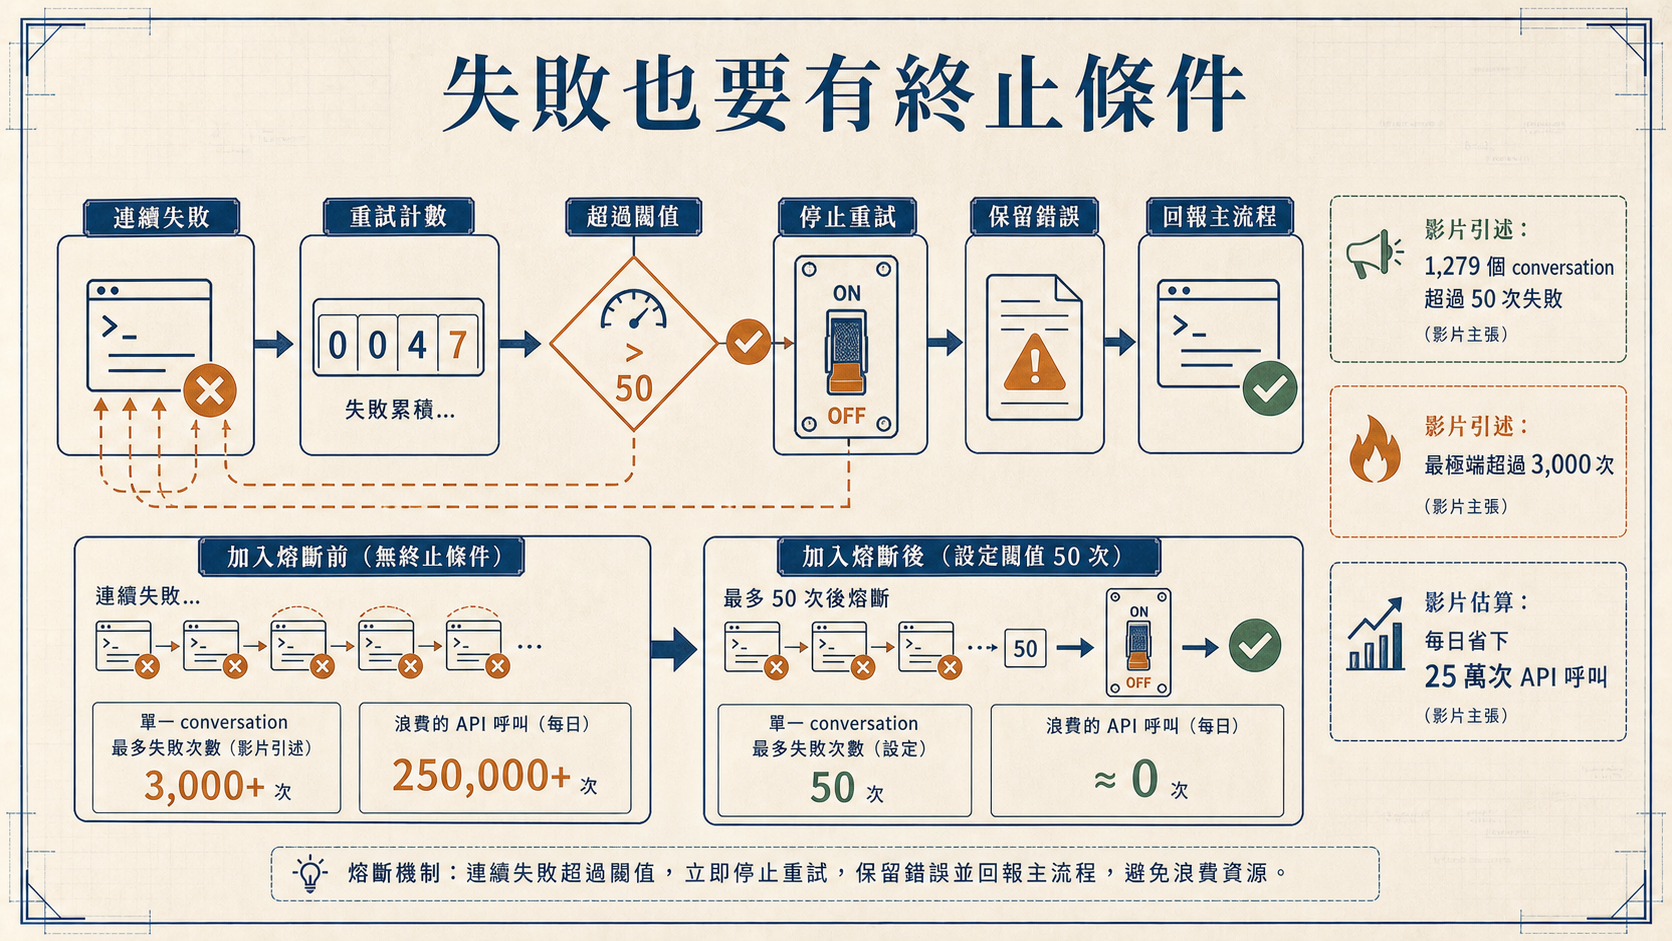
影片也談到連續失敗熔斷,並引述一組內部統計:1,279 個 conversation 曾連續失敗超過 50 次,最極端超過 3,000 次;加入少量熔斷邏輯後,估算每日可省下 25 萬次 API 呼叫。這些數字同樣只能歸屬於影片說法,但問題本身非常真實:agent 若把「再試一次」當成唯一恢復策略,就會把錯誤放大成成本。
良好的熔斷器不只停止。它還要留下最後錯誤、重試次數、已採用策略與建議的人類介入點。停止是控制面,診斷資訊才是恢復面的入口。
065. MCP 與 Skills|一個接能力,一個接經驗
MCP 與 Skills 常被一起討論,但它們解決的是不同問題。MCP 讓 agent 連接外部資料與操作能力;Skills 把一套可重複的工作方法包成按需載入的說明與流程。
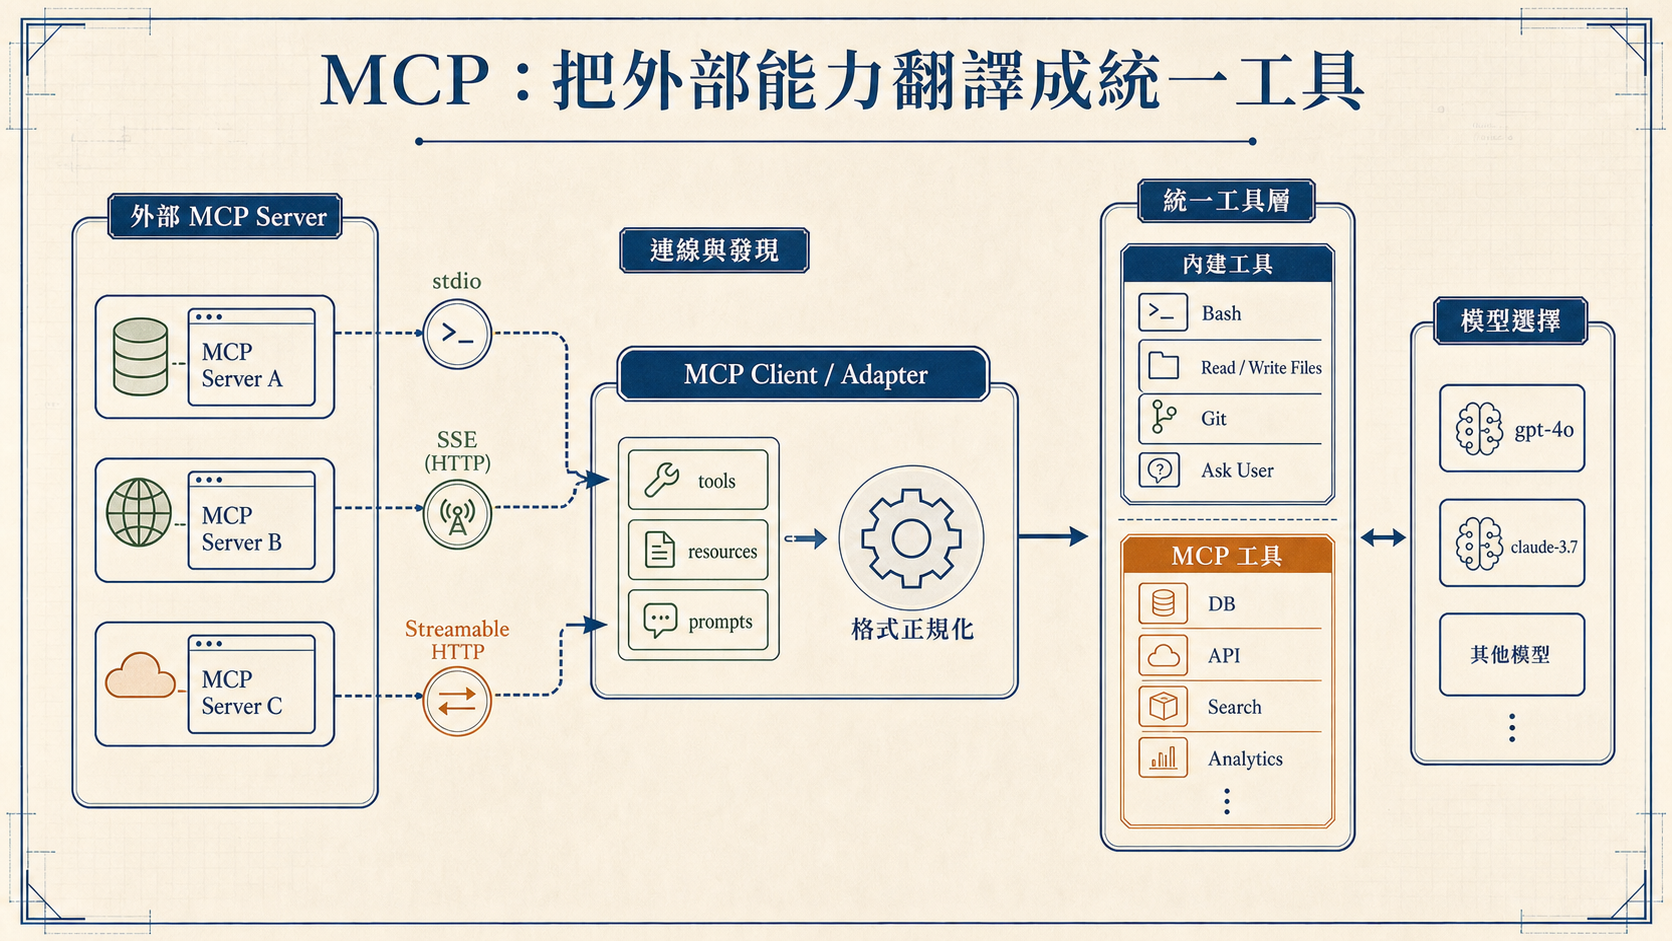
影片把 Claude Code 的 MCP client 描述成一個轉接層:先用協議支援的連線方式接上 server,再發現 tools、resources、prompts 等能力,最後轉成 runtime 內部可理解的物件。完成正規化後,對模型而言,MCP 工具與內建工具位於同一個選擇空間。
這種 adapter 思維很重要。模型不應該理解每個外部 server 的傳輸細節;它只需要看到穩定的名稱、描述、輸入 schema 與結果格式。連線、重試、驗證與錯誤轉換由 MCP client 處理。換句話說,MCP 的價值不只是「工具變多」,而是外部能力可以被一致地發現、治理與替換。
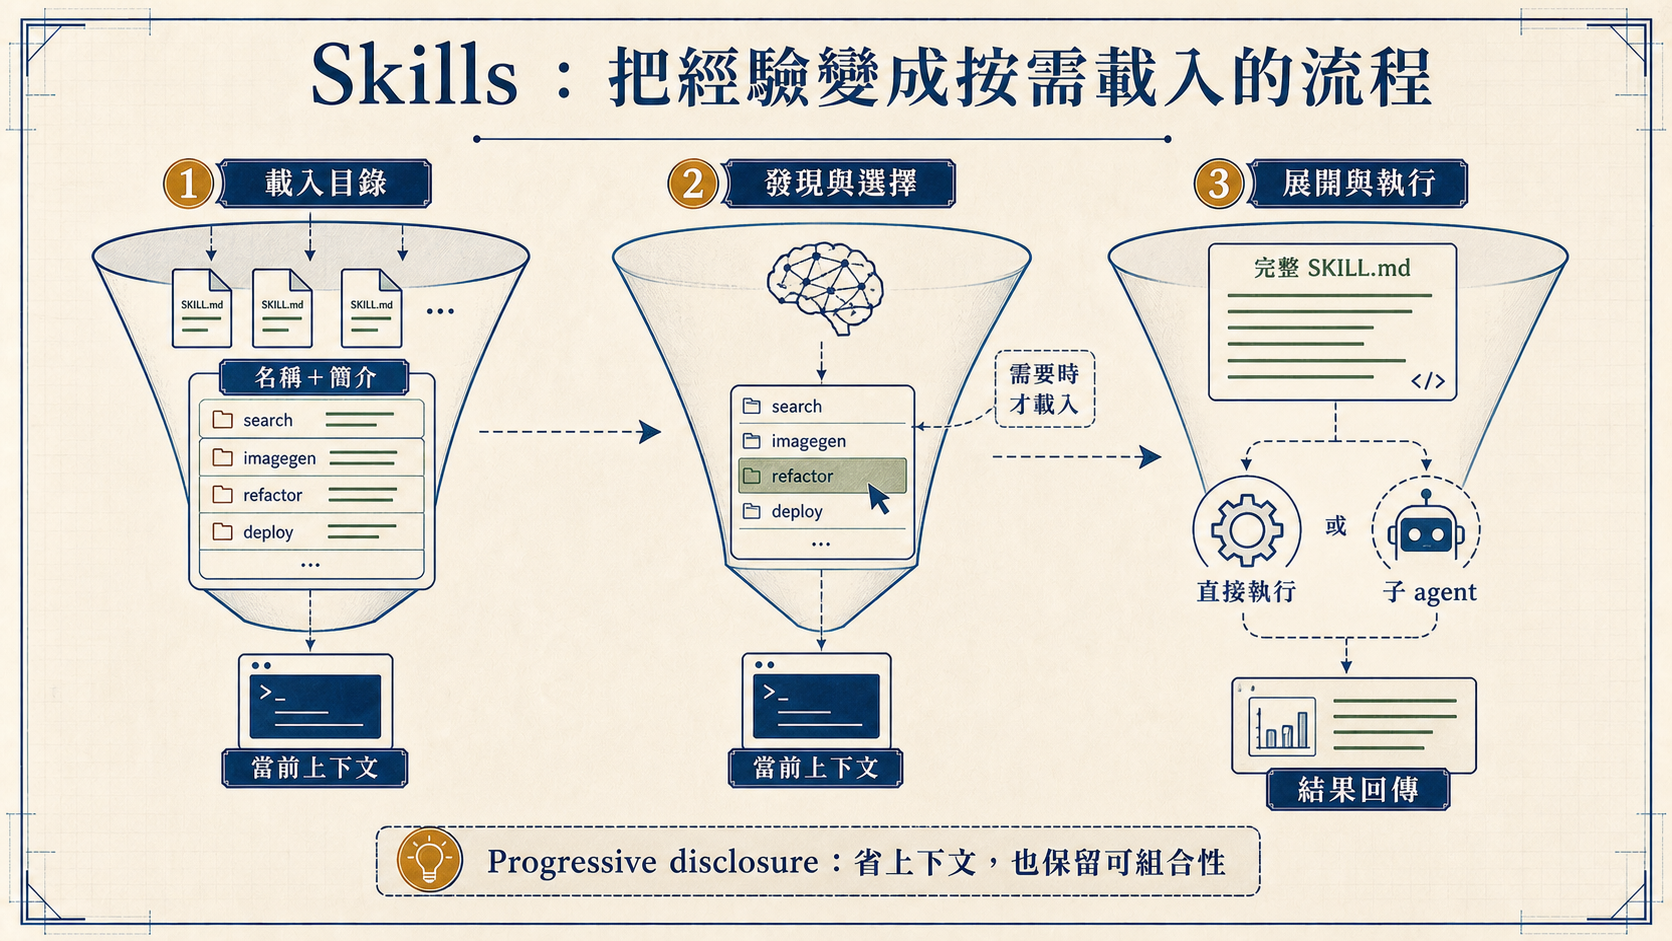
Skills 則呈現另一種模式。影片描述的流程可分成載入、發現與執行三階段:啟動時掃描固定位置的 SKILL.md,但不把每份完整內容全部塞入上下文;先只暴露名稱與簡介,等模型判斷任務需要時,才展開完整說明。複雜 Skill 還可以在獨立子 agent 中執行,再把結果送回主流程。
這就是 progressive disclosure:先提供便宜的索引,再按需求支付完整上下文成本。它同時解決三個問題:可用流程太多、上下文有限、每項任務只需要其中少數能力。
從組織角度看,Skill 也可以被視為可版本化的作業知識。它比散落的提示詞更容易審查,比口頭交接更容易重複,也能明確列出工具、輸出契約與禁止事項。不過,把文件命名為 Skill 不會自動產生品質;真正的價值仍取決於流程是否可驗證、邊界是否清楚、失敗時是否知道如何退出。
076. Harness 工程|模型能力決定上限,系統設計決定日常
把六個模組放回一起,會發現 Claude Code 類產品的結構並不神祕:中心是一個 agent loop,外圍是提示詞裝配、工具治理、預算與終止、上下文生命週期、MCP 接入、Skills 載入,以及觀測與錯誤處理。
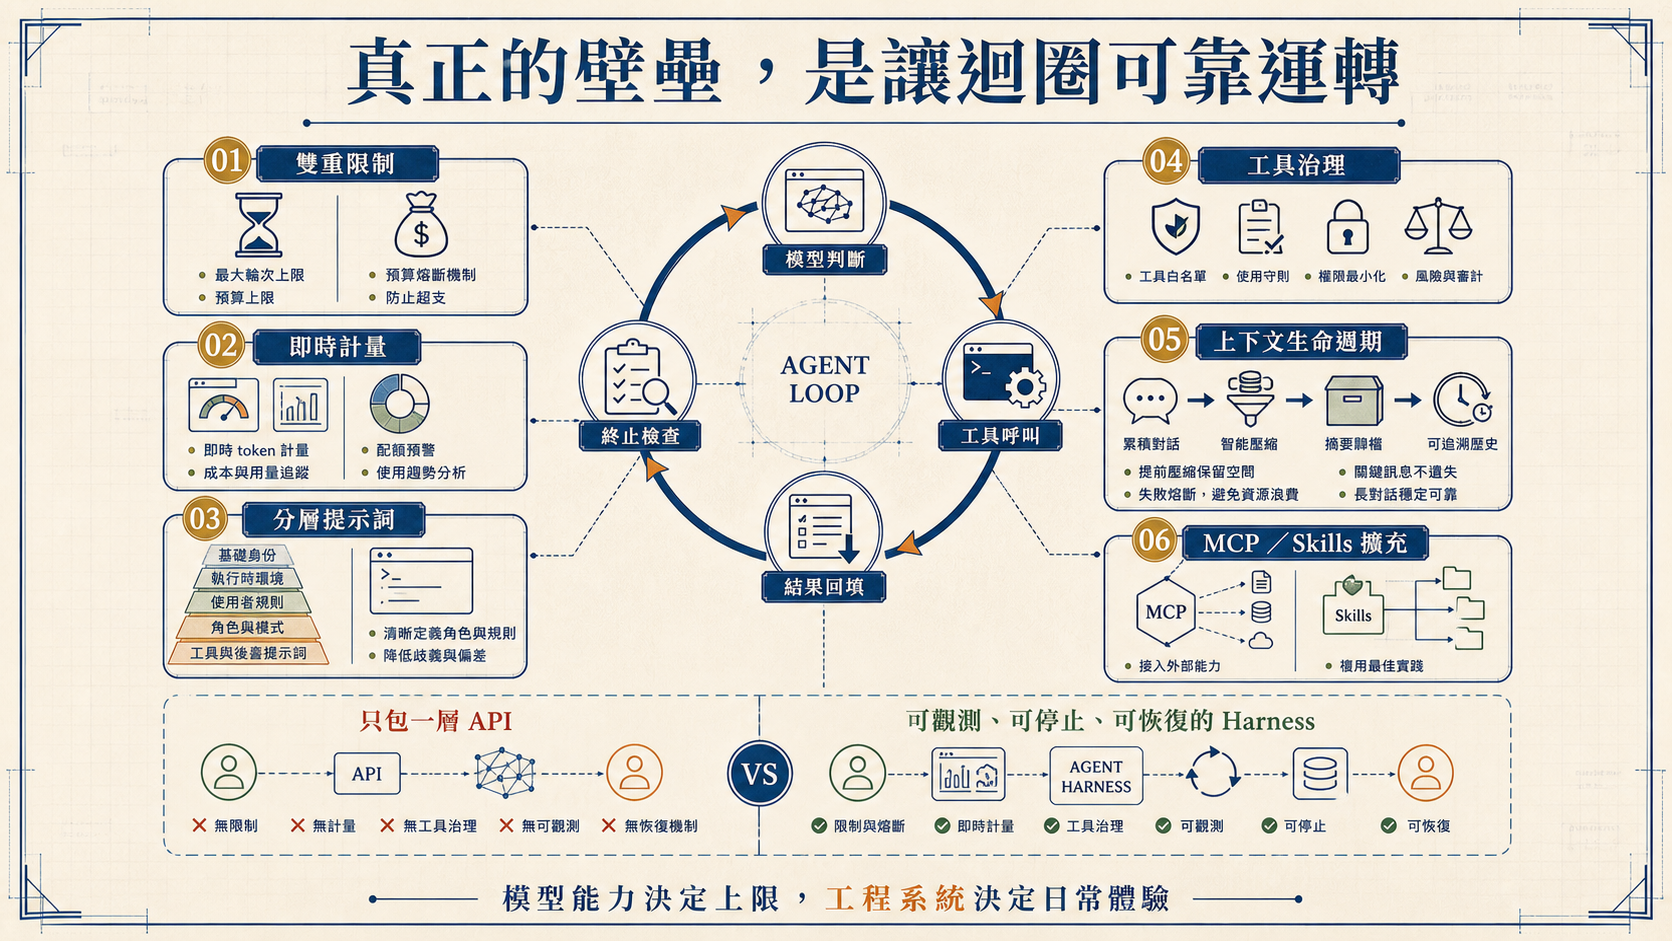
這也說明「包一層 API」與「可用產品」之間的距離。前者可以在 demo 中完成一次工具呼叫,後者必須處理數百種不完美狀況:工具輸出太長、測試卡住、檔案在途中被修改、模型重複同一行動、預算接近上限、上下文需要壓縮、MCP server 離線、子 agent 沒有回報。
對正在打造 agent 的團隊,這支影片可轉成六條實作檢查:
- 先定義所有終止條件,不要只設
max_steps。 - 把成本放進 runtime 狀態,串流期間就更新與判斷。
- 將提示詞拆成有來源與優先序的層,避免巨大字串失去治理。
- 把工具視為受權限控制的介面,而不是任意函式清單。
- 把壓縮設計成狀態 checkpoint,並提前預留生成摘要的空間。
- 區分能力擴充與流程擴充:MCP 接外部系統,Skills 封裝可重複經驗。
影片最後將 Claude Code 形容成工程化程度很高的「AI 作業系統」。這個比喻雖然帶有宣傳感,仍抓到一個重點:使用者感受到的可靠性,多半不是來自某一次驚人的模型輸出,而是來自大量邊界條件被妥善處理。
因此,閱讀這類架構拆解時,最有價值的問題不是「它藏了哪一句神奇 prompt」,而是:
- 系統如何知道自己正在失敗?
- 它在什麼條件下會停止?
- 它如何保留已完成工作的狀態?
- 外部能力如何被標準化與隔離?
- 一套成功流程如何被重複使用,又不永久占滿上下文?
agent loop 讓模型能夠行動,Harness 讓行動可以被信任。這才是從展示走向產品的工程分界。
來源:軒轅的編程宇宙|10 分鐘速通 Claude Code 洩露原始碼核心架構。本文為編輯導讀;影片對「原始碼外洩」、內部檔案與統計數字的描述均保留來源歸屬,不代表 Anthropic 官方確認。