010. 先讀|省 token 不是叫模型「簡短一點」而已
Chase AI 這支影片的標題很直白:How To Make Claude Code Tokens 20x CHEAPER (& 4 More Usage Hacks)。表面上它是在談 Claude Code 怎麼省錢,實際上更有用的地方,是把「token 成本」從一個抽象帳單問題,拆回日常工作流裡幾個可以控制的開關。
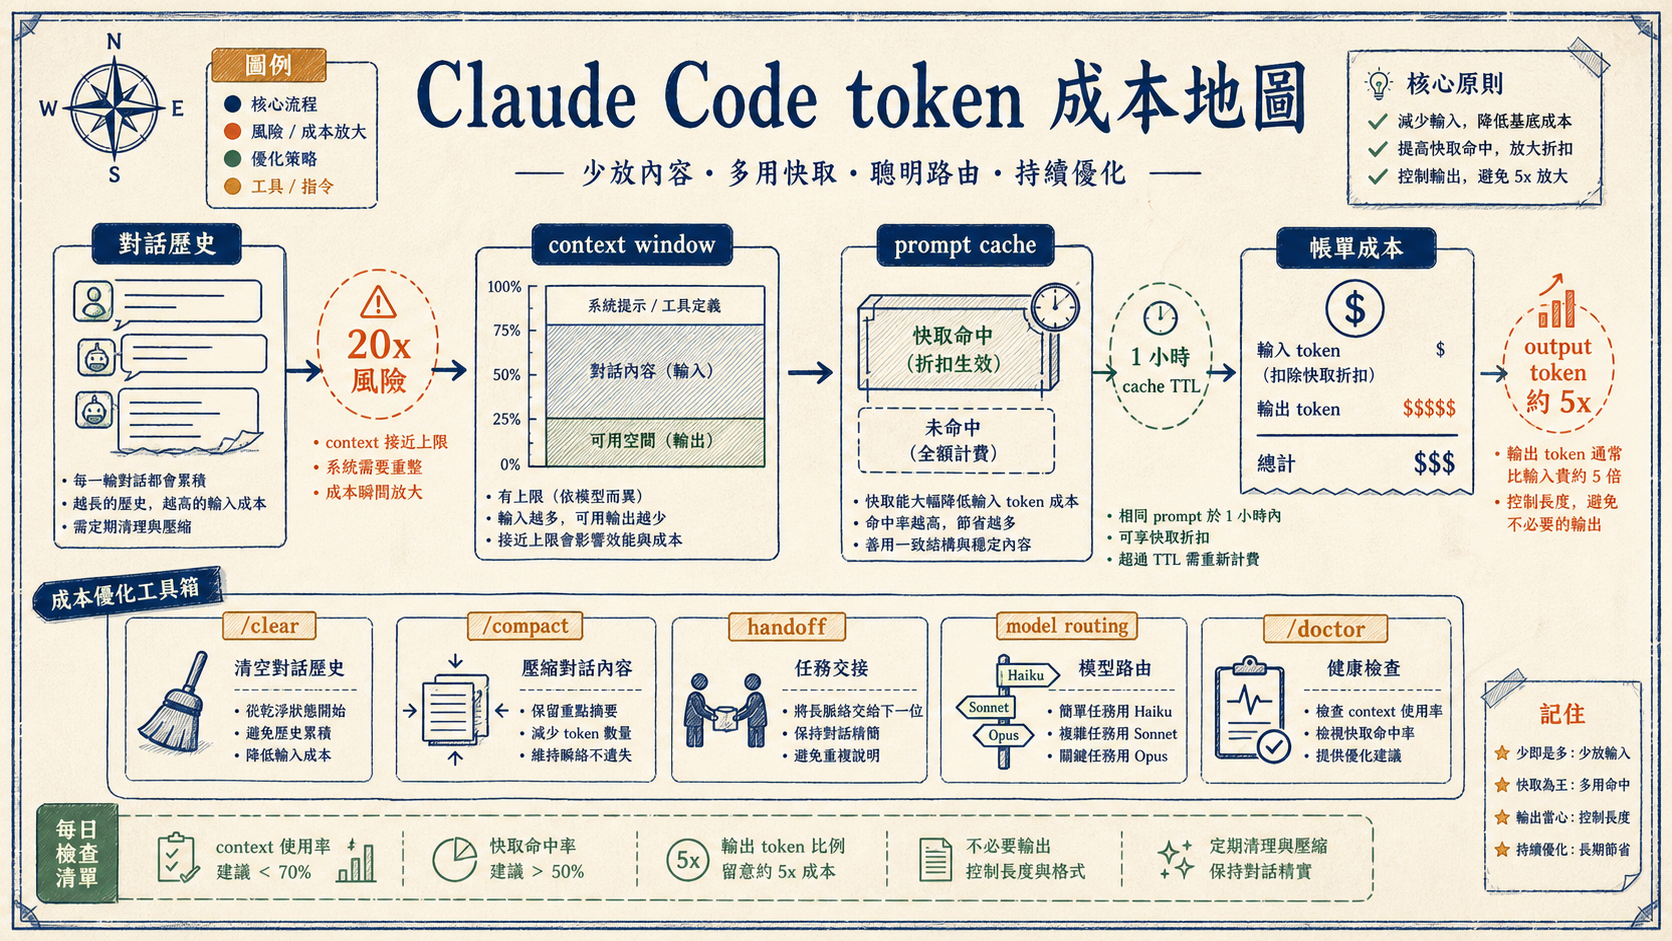
影片開場先提醒一件很多人會低估的事:你可能不是因為多打了幾句話而花錢,而是因為每次 follow-up 都帶著整段對話歷史一起送回模型。只要對話一路累積到幾十萬 token,真正決定成本的就不是最新那句「幫我繼續」,而是前面整個 context window 如何被重新讀取、是否命中 prompt cache、cache 是否已經冷掉。
這個觀點很重要,因為它把省錢從「壓抑輸出」拉回「管理上下文」。很多 Claude Code 使用者會在 CLAUDE.md 裡寫「Be brief」,或裝一些讓模型少輸出的 skill。這些做法不是沒用,但它們通常只處理 output token。影片真正想說的是:如果你的 prompt cache 失效,或你在 400K、500K token 的長對話裡硬撐,那一點點 output token 節省很快就會被完整 input context 的重新計費吃掉。
所以這篇導讀不會把它整理成「五個省錢小技巧」。更準確地說,這是一套 Claude Code 成本治理框架:
- 先理解 prompt cache 如何改變輸入成本。
- 冷 cache 之後不要無腦續聊,要選擇
/clear、/compact或 handoff。 - 用 model routing,把大模型留給規劃與判斷,小模型處理可委派工作。
- 定期修剪
CLAUDE.md、skills、MCP 與 context bloat。 - 最後才考慮輸出壓縮、簡短指令或特殊 skill。
這也是 Chase AI 這支影片最值得保留下來的編輯價值:它不是要你少用 Claude Code,而是要你別把長對話、冷 cache、過度 context 和最大模型全包辦,誤認成「高品質工作流」。
021. prompt cache|真正的大頭是「每次訊息都帶著歷史」
影片先用一個簡化模型解釋 token:使用者輸入是 input token,模型回答是 output token;講者表示,output token 通常比 input token 貴很多,約略可用 5 倍這個量級來理解。這不是精確定價表,而是幫你建立直覺:模型長篇輸出當然會花錢,但更容易被忽略的是,每次新訊息都會把先前對話歷史一起送進去。
假設你第一句問候、模型回答、第二句要求「build me an app」。你以為第二句只有幾個 token,實際上模型需要讀到前面整段對話,才知道你在延續哪個脈絡。對話越長,這個「每次都送完整上下文」的成本就越明顯。到了 100K、300K、500K token 的長 session,最新訊息本身反而可能不是主角。
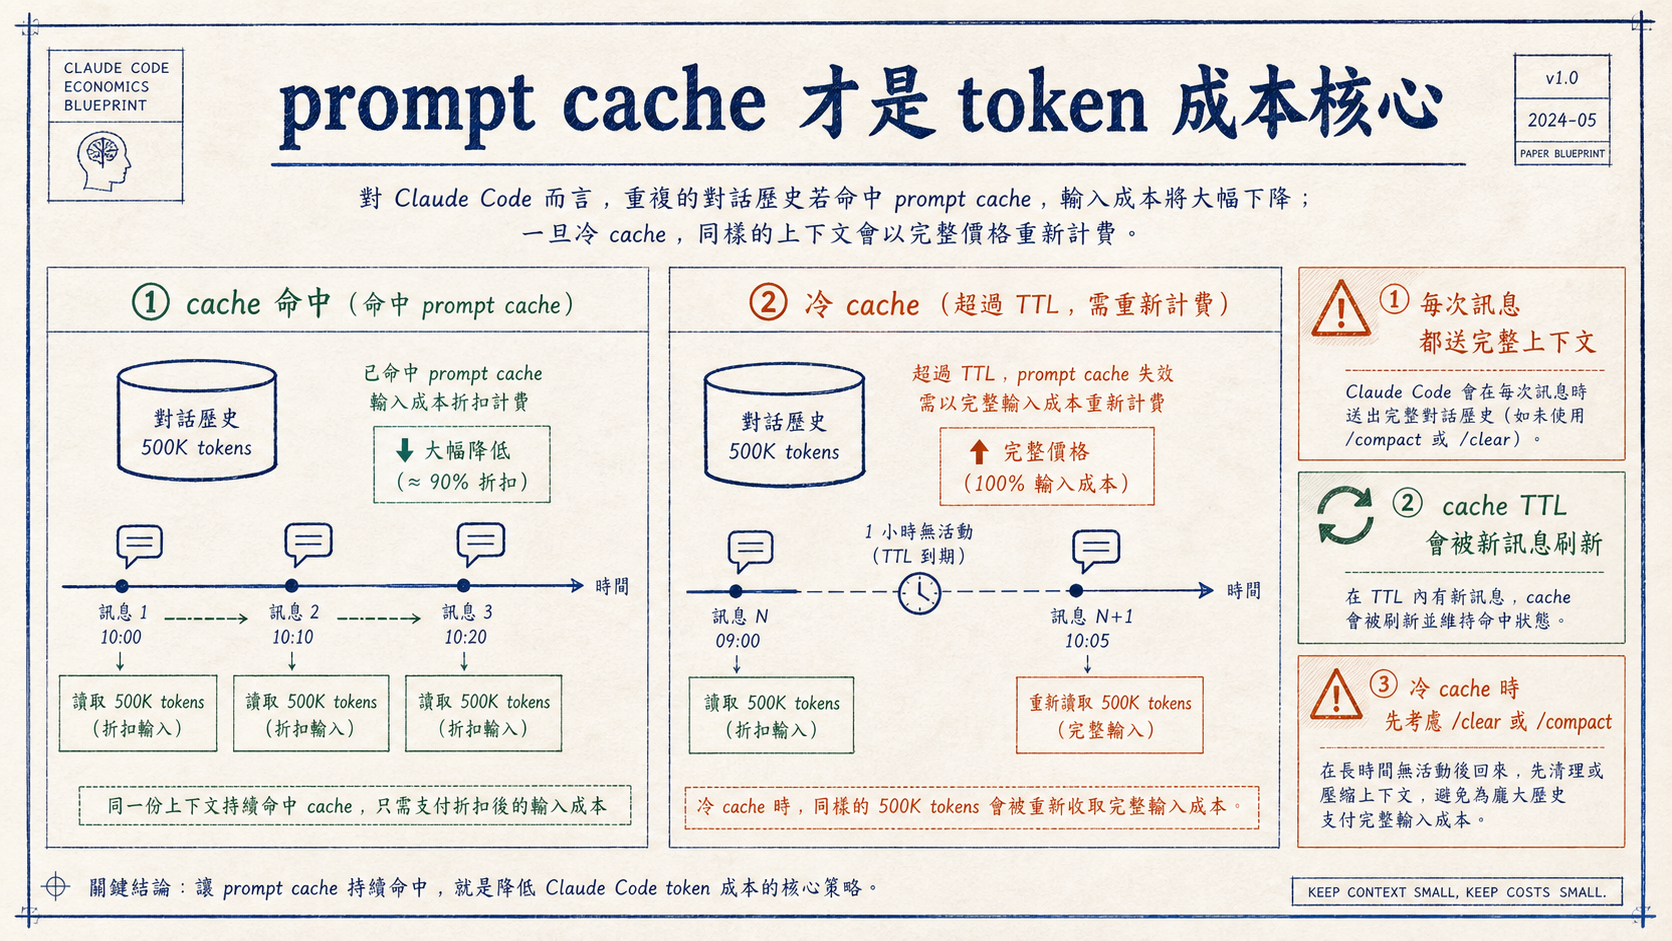
那為什麼大家沒有在長對話裡立刻燒光預算?答案是 prompt cache。可以把它想像成 Claude 端暫時放著的一份對話歷史文件:只要 cache 命中,模型讀取既有上下文時就能用較便宜的 cached input 成本,而不是每次都用完整價格重新計算。這也是為什麼長 session 有時還能合理運作。
但這裡有一個關鍵限制:影片指出,cache 並不永久保存,而是有約 1 小時的無活動 TTL。只要你持續互動,新的訊息會刷新這個 TTL;如果你離開太久,cache 冷掉,下一次回來即使只打一小句話,也可能觸發整段長上下文以完整 input 價格重新讀取。
這就是標題裡「20x cheaper」的核心語境。它不是說所有人都固定能省 20 倍,而是在提醒:若你不知道 prompt cache 命中與冷 cache 的差異,可能會把一段 500K token 的歷史當成「已經在那裡了」,其實下一次訊息要重新付費讀取。
對 Claude Code 這類工具來說,這件事尤其要命。一般聊天頂多是幾輪問答;coding agent session 會帶著 repo、diff、測試輸出、錯誤訊息、設計討論、修正紀錄一路累積。當你把這些都留在 message history 裡,成本問題就不再只是「模型輸出太長」,而是「整個工作現場被塞進 context window,然後一遍又一遍被讀」。
032. 冷 cache 之後|不要在 500K token 對話裡硬續
影片第二個重點,是 cache 冷掉後怎麼辦。講者給了三個選項:/clear、/compact、以及 handoff 類工具。這三個選項的差異,不只是省錢,也關係到你怎麼保存工作脈絡。
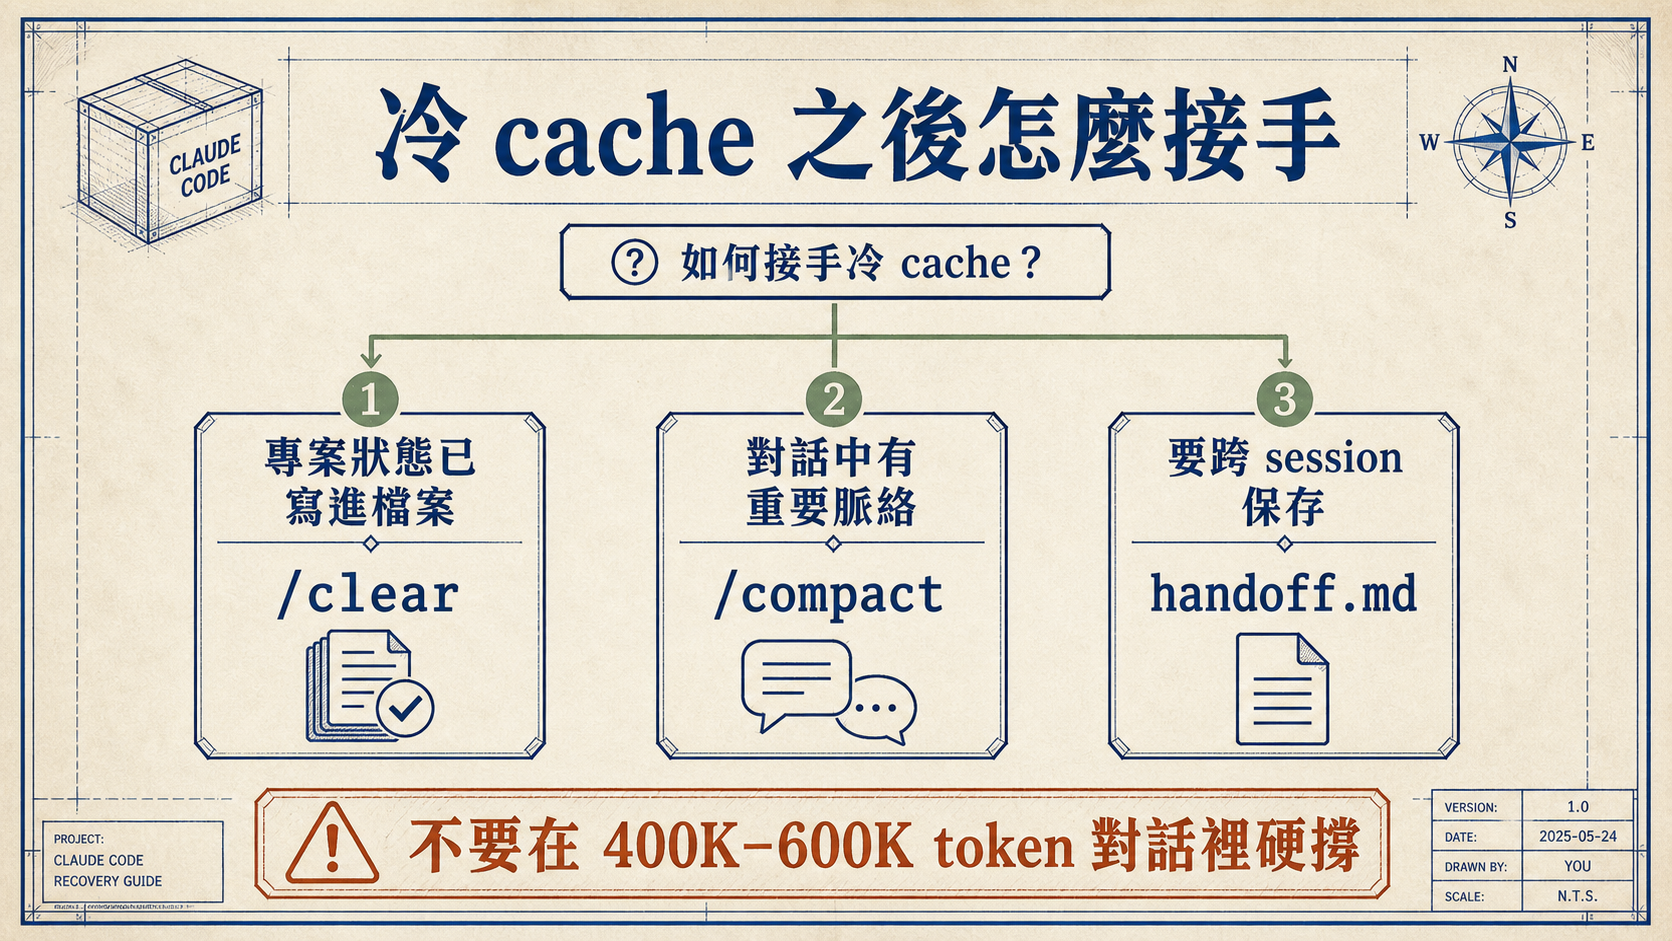
第一個是 /clear,也就是直接清掉對話歷史。這聽起來很粗暴,但在 coding project 裡常常可行,因為真正重要的狀態應該已經寫進檔案、測試、diff、commit、issue 或文件。若 Claude Code 可以重新讀 repo 來理解目前狀態,那你不一定需要把整段舊對話繼續扛在 context 裡。
這裡有個值得延伸的工程原則:可靠的 agent workflow 應該把狀態外部化。檔案、測試結果、任務清單、設計決策,應該存在 repo 或工作目錄,而不是只存在上一輪聊天裡。當你能放心 /clear,代表系統狀態不是被困在模型記憶裡。
第二個是 /compact。Claude Code 會在對話接近上限時自動 compact,但講者建議不要等到 600K、700K、800K token 才做,因為那時不只是成本問題,也開始有 context rot:資訊太多、互相干擾、模型注意力變差。手動 /compact 的意義,是把重要內容整理成摘要,然後以較小的上下文開始新的對話。
第三個是 handoff。它和 compact 很像,都是摘要接手;差別在於 handoff 把摘要寫成磁碟上的 Markdown 檔,例如 handoff.md,讓下一個 session 可以讀取。對需要跨 session、跨工具或跨人的工作來說,這比只把摘要塞在 message history 裡更穩。它也更符合可審查原則:你可以打開 handoff,看 agent 到底認為哪些脈絡重要,必要時手動修正。
這三個選項沒有絕對排名。比較好的判斷方式是:
如果專案狀態已經寫進 repo,/clear 通常足夠;如果舊對話裡有尚未落檔的關鍵脈絡,先 /compact;如果你想讓接手資訊跨 session 保存,就用 handoff 檔。最不理想的,是明明已經冷 cache,還在 400K、500K token 的長對話裡直接打一聲「繼續」,然後讓模型以高成本重讀整段歷史。
043. model routing|大模型負責判斷,不必負責每一鏟土
第三個技巧是 model routing:不要讓最強、最貴的模型做所有事情。這也是 coding agent 工作流裡越來越重要的設計題。講者提到可以用 advisor mode:較強模型負責規劃或提供建議,較便宜的模型負責執行;如果遇到困難,再把 context 分享回強模型。
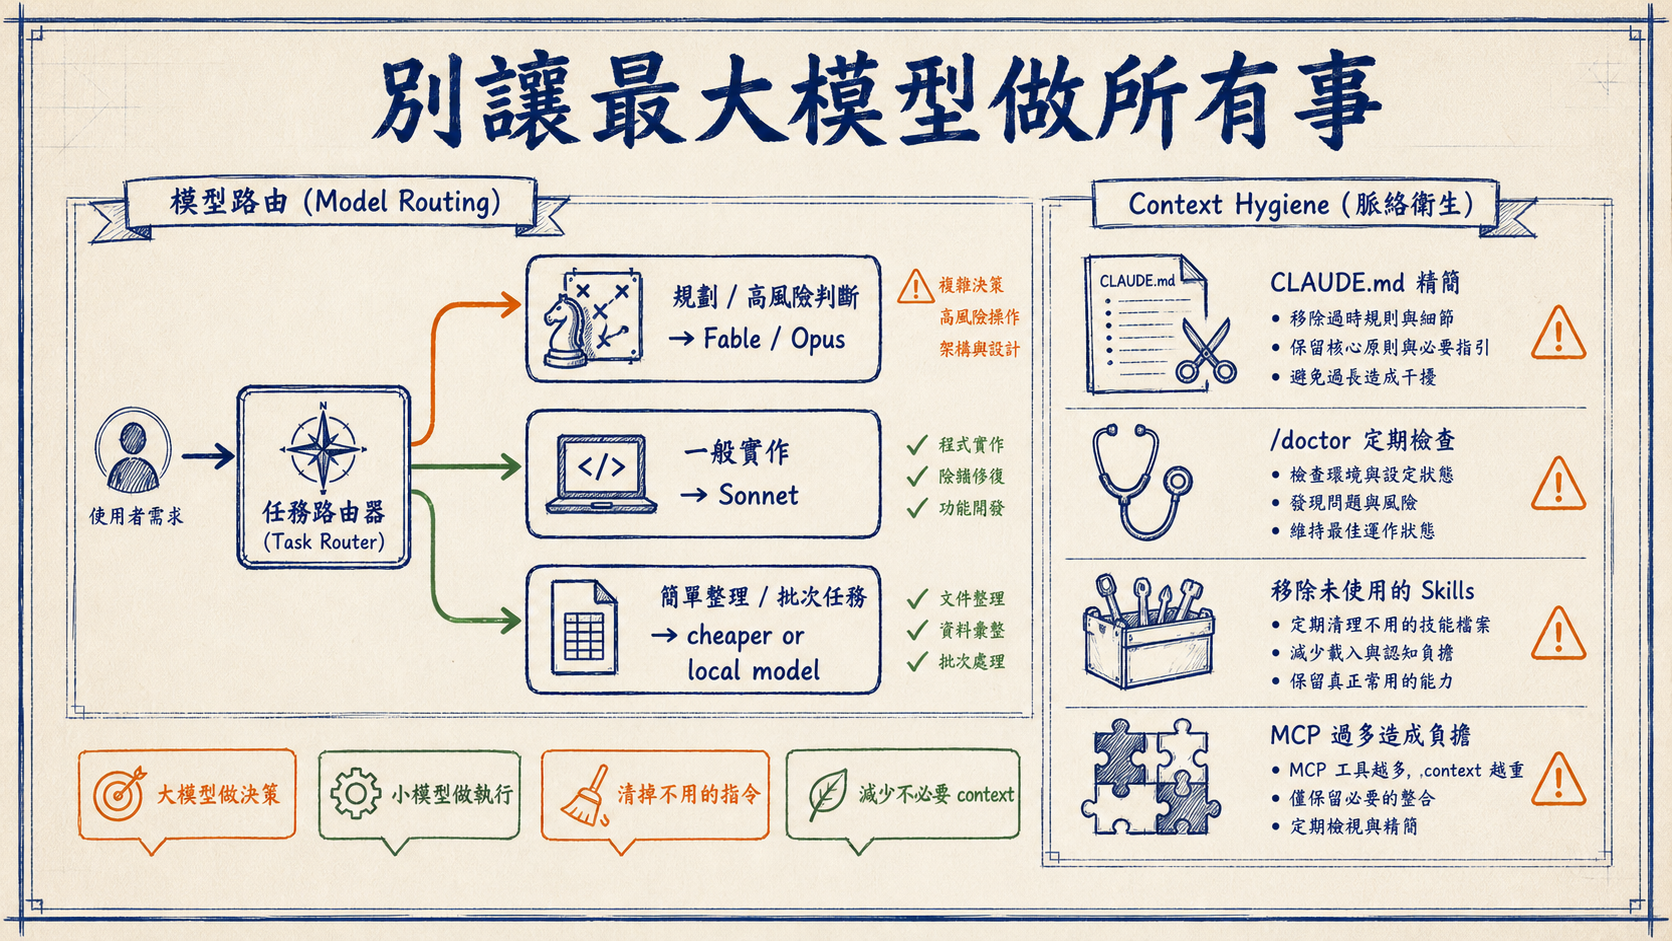
這個模式值得用工程組織的語言理解。真正昂貴的不是「寫一段普通 glue code」,而是判斷問題邊界、辨識風險、設計架構、做不可逆決策。這些地方適合讓更強的模型介入。相反地,格式整理、批次修改、簡單重構、測試輸出歸納、文件同步,很多時候可以交給便宜模型或本地模型。
影片也提到可以把 Claude Code 介面接到其他模型,例如 Codex 或更便宜的 GPT 系列模型。這裡不必把它讀成「哪一家模型比較好」的品牌比較;真正有用的 takeaway 是:agent harness 應該有任務分流能力。若所有任務都走同一個最大模型,你會得到簡單但昂貴的系統;若分流做得太激進,又可能把需要判斷的工作丟給不適合的模型。
比較好的分界是:
規劃、風險判斷、跨模組設計、產品語氣與安全性決策,留給更強模型;可驗證的實作、重複性修改、資料整理,交給較便宜模型;非常局部、可離線處理的任務,才考慮 local model。重點不是追求「每一步都最便宜」,而是讓每一步的模型能力剛好夠用。
這裡也連回 prompt cache。advisor 和 executor 若是不同模型或不同 session,它們各自有自己的 context 與 cache。分流不是免費午餐,因為你仍然要設計 context 交換方式。真正成熟的 model routing,不只是叫便宜模型多做事,而是知道哪些資訊該傳、哪些狀態該落檔、哪些決策必須回到強模型確認。
054. context hygiene|CLAUDE.md、skills、MCP 都會變成成本
第四個技巧是 Claude hygiene。影片提到 Boris Cherny 曾有「刪掉 CLAUDE.md」這類討論,但講者的結論比較溫和:不一定要刪掉,真正該做的是跑 /doctor,檢查 CLAUDE.md、skills、MCP 和各種 context bloat。
這點很容易被低估。很多團隊一開始導入 Claude Code 時,會把大量規則、偏好、流程、禁止事項都塞進 CLAUDE.md。在模型能力較弱時,這或許有幫助;但模型變強之後,過度詳細的指令可能不但沒有增加品質,反而增加 token、降低速度,甚至製造互相衝突的行為約束。
影片裡有一個很具體的數字感:講者表示自己在新 conversation、一句話都還沒送出時,context window 已經用了約 40K token。裡面可能包含 system prompt、memory、skills、MCP 工具描述、專案文件等。換句話說,所謂「空白對話」其實一點都不空白。
這對 agent 使用者是一個提醒:你裝過的 skill、接過的 MCP、寫過的長規則,最後都會以某種形式進入模型可見環境。它們不只花 token,也會影響模型判斷該使用哪個工具、遵守哪條規則。若你有十個都在講 frontend design 的 skill,模型可能不只是多讀了文字,也更難決定真正該啟用哪一個。
因此 context hygiene 可以分成三層:
第一,修剪 CLAUDE.md。保留真正穩定、重要、專案特有的規則;刪掉過度囉嗦、過期、泛用、模型已經知道的內容。
第二,清理不用的 skills。技能越多不代表能力越強;可觸發、可區分、可維護的技能才有價值。
第三,檢查 MCP 與工具描述。工具很多時,模型要讀更多 schema,也更可能誤選工具。只保留需要的整合,會讓 context 和行為都更乾淨。
這些做法未必像 prompt cache 那樣帶來巨大帳單差異,但它們是低成本、高穩定性的維護動作。更重要的是,context hygiene 同時改善成本、速度與可預測性。
065. 輸出壓縮|有用,但別把它當主菜
影片最後談到一些降低 output token 的方法,例如特定 skill、scaffolding、或在 CLAUDE.md 裡要求模型簡短。講者提到 Ponytail、Caveman 這類工具,主張可以讓 Claude 少寫 code 或降低輸出 token。這些方法可能有幫助,尤其當你的工作流確實被冗長輸出拖慢時。
但這裡要守住一個比例感。output token 很貴,少輸出當然會省;可是如果你的最大問題是 500K token 對話冷 cache 後重新計費,那把回答縮短 30% 或 60%,都不是最主要的槓桿。影片自己的排序也很清楚:prompt caching 是最大頭,冷 cache 接手和 context 管理次之,輸出壓縮比較像最後加上的優化。
這也是為什麼單純寫「be brief」不會解決 Claude Code 成本。它可能讓模型少解釋一點,卻不會自動幫你判斷何時該 /clear、何時該 /compact、哪些 skills 該移除、哪個任務該交給便宜模型。真正的成本治理是 workflow 問題,不只是 prompt style 問題。
比較務實的做法,是把輸出壓縮放在最後一層:
先確保重要狀態已落檔;再確保長 session 不硬撐;再做 model routing;再清理 context bloat;最後才微調輸出長度。這樣做不是因為輸出不重要,而是因為你要先處理成本乘數最大的地方。
076. 編輯結論|Claude Code 的省錢能力,來自可接手的工作流
這支影片最值得帶走的一句話,不是「裝某個省 token skill」,而是:Claude Code 的成本,很大一部分其實是工作流設計的結果。
如果所有狀態都留在聊天裡,你就會害怕 /clear。如果你害怕 /clear,就會讓對話越來越長。對話越長,就越依賴 prompt cache。cache 一冷,你就可能為整段歷史重新付費。接著你會試著叫模型簡短一點,但真正的大頭其實不在那裡。
反過來說,如果你的專案狀態能落在 repo、handoff、測試、文件、commit 和任務清單裡,你就能更常清掉對話、更放心 compact、更容易跨 session 接手,也更容易把不同任務分給不同模型。這不只是省錢,也讓 agent 工作流更可靠。
所以,這篇導讀把 Chase AI 的五個技巧整理成一個優先順序:
- 管 prompt cache:知道 cache 命中與冷 cache 的成本差異。
- 管 session lifecycle:長對話不要硬續,該 clear、compact、handoff 就做。
- 管模型分工:大模型做判斷,小模型做可驗證執行。
- 管 context hygiene:修剪
CLAUDE.md、skills、MCP 與多餘記憶。 - 管 output token:最後再用簡短規則或輸出壓縮工具降低邊際成本。
對重度 Claude Code 使用者來說,這不是「省一點小錢」的技巧,而是把 agent workflow 從一條越聊越長的線,改成一個可以清理、交接、分流、重啟的系統。真正便宜的不是少說話,而是讓上下文有地方可以落地。