010. 一支不到兩分鐘的宣言|Fable 5 賣的不是聊天,而是任務持續性
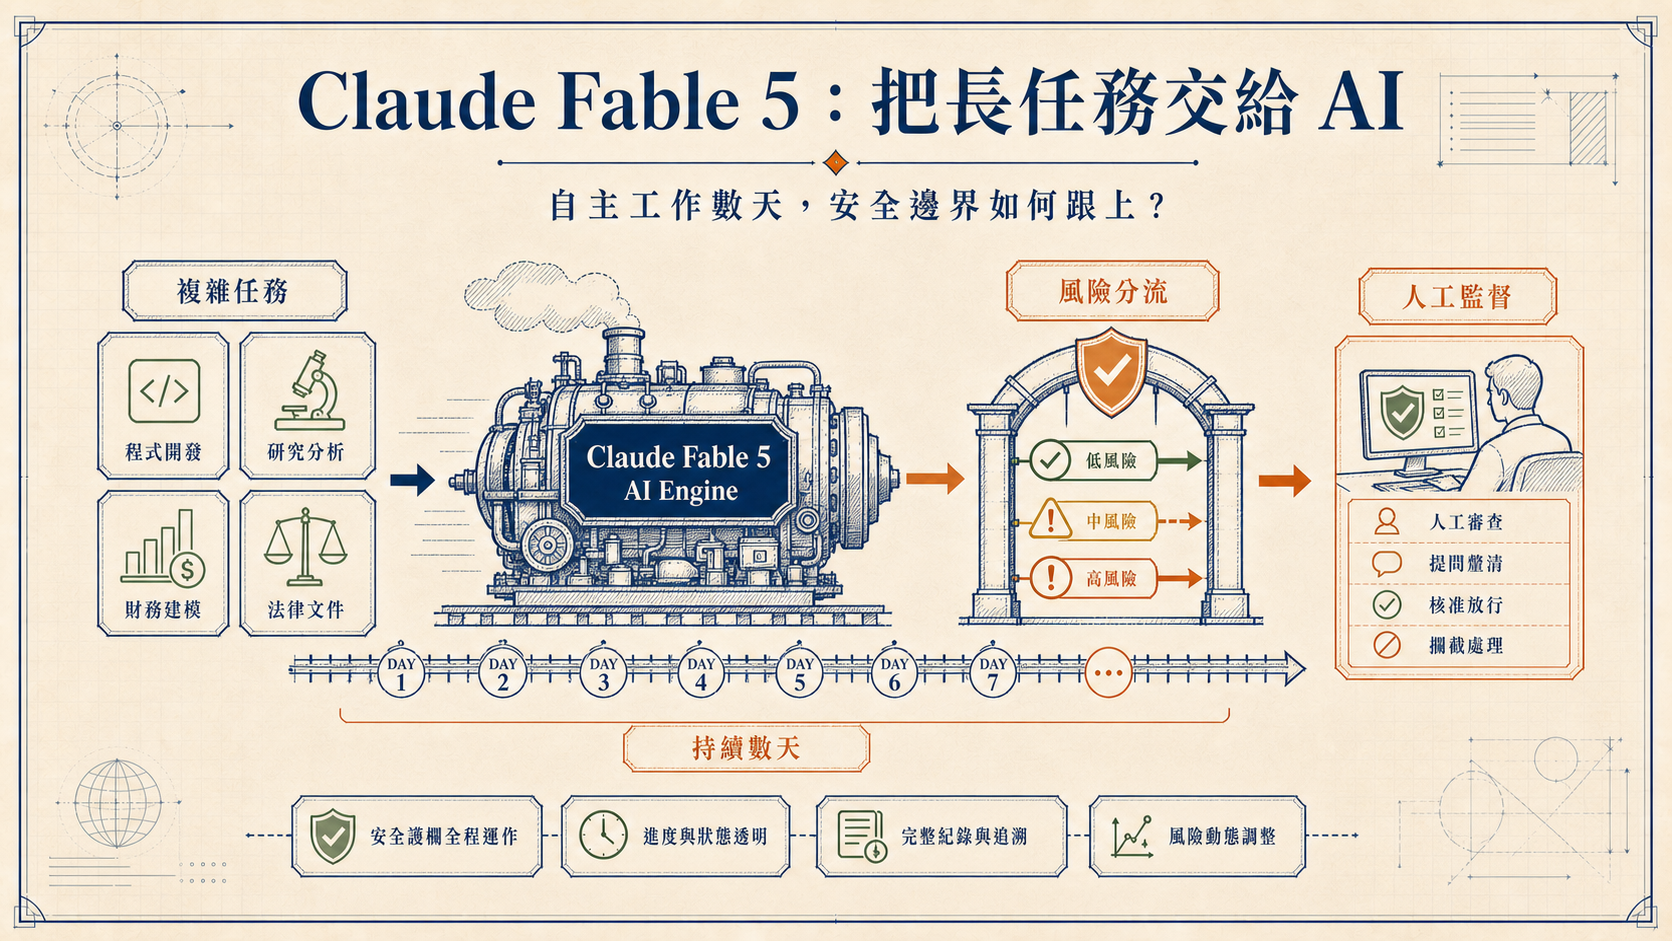
Anthropic 的官方短片 Introducing Claude Fable 5只有 1 分 53 秒,卻把新模型的產品定位講得很集中:Fable 5 不只是回答單一問題的模型,而是要在更長時間內留在同一個複雜任務上,跨越 coding、research、finance、economics 與 law,直到形成可交付成果。
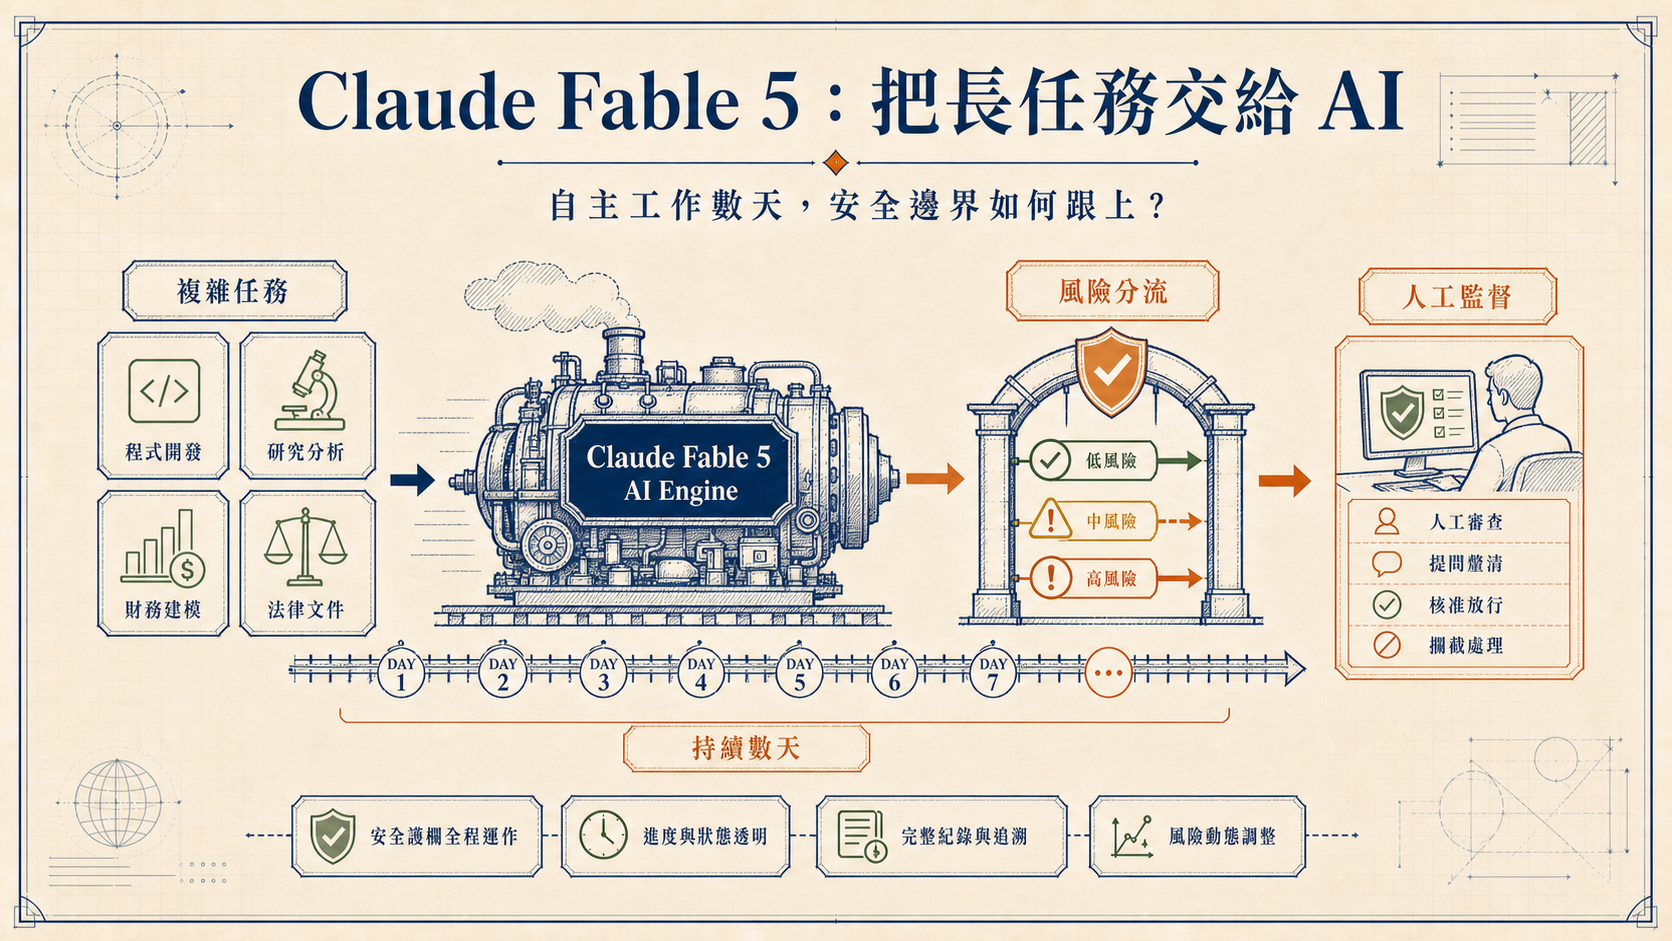
這和傳統聊天機器人的成功條件不同。聊天看重眼前回答是否流暢;長任務則要求模型數小時甚至數天後仍記得目標、保留決策、知道哪些步驟已完成,並能從工具結果與失敗中繼續工作。Anthropic 在影片裡使用「operate for days without intervention」這個強烈說法,等於把可持續自主性放到驗收台上。
不過,官方短片本質上仍是發布宣傳。它說明設計意圖,卻沒有替每一種工作負載保證效果。魚塘更關心的是:要讓「自主數天」成為可靠產品能力,系統必須具備哪些狀態、護欄與驗收條件?
021. 從 Mythos Preview 到 Fable 5|先控制能力,再擴大取得
影片先回顧 Anthropic 為什麼沒有把 Claude Mythos Preview 直接交給一般使用者。官方表示,測試時發現模型能找到數千個 cybersecurity 漏洞;同一種能力既可協助防禦者修補,也可能被用來攻擊,因此先透過 Project Glasswing 等受控方式提供給保護關鍵軟體的人。
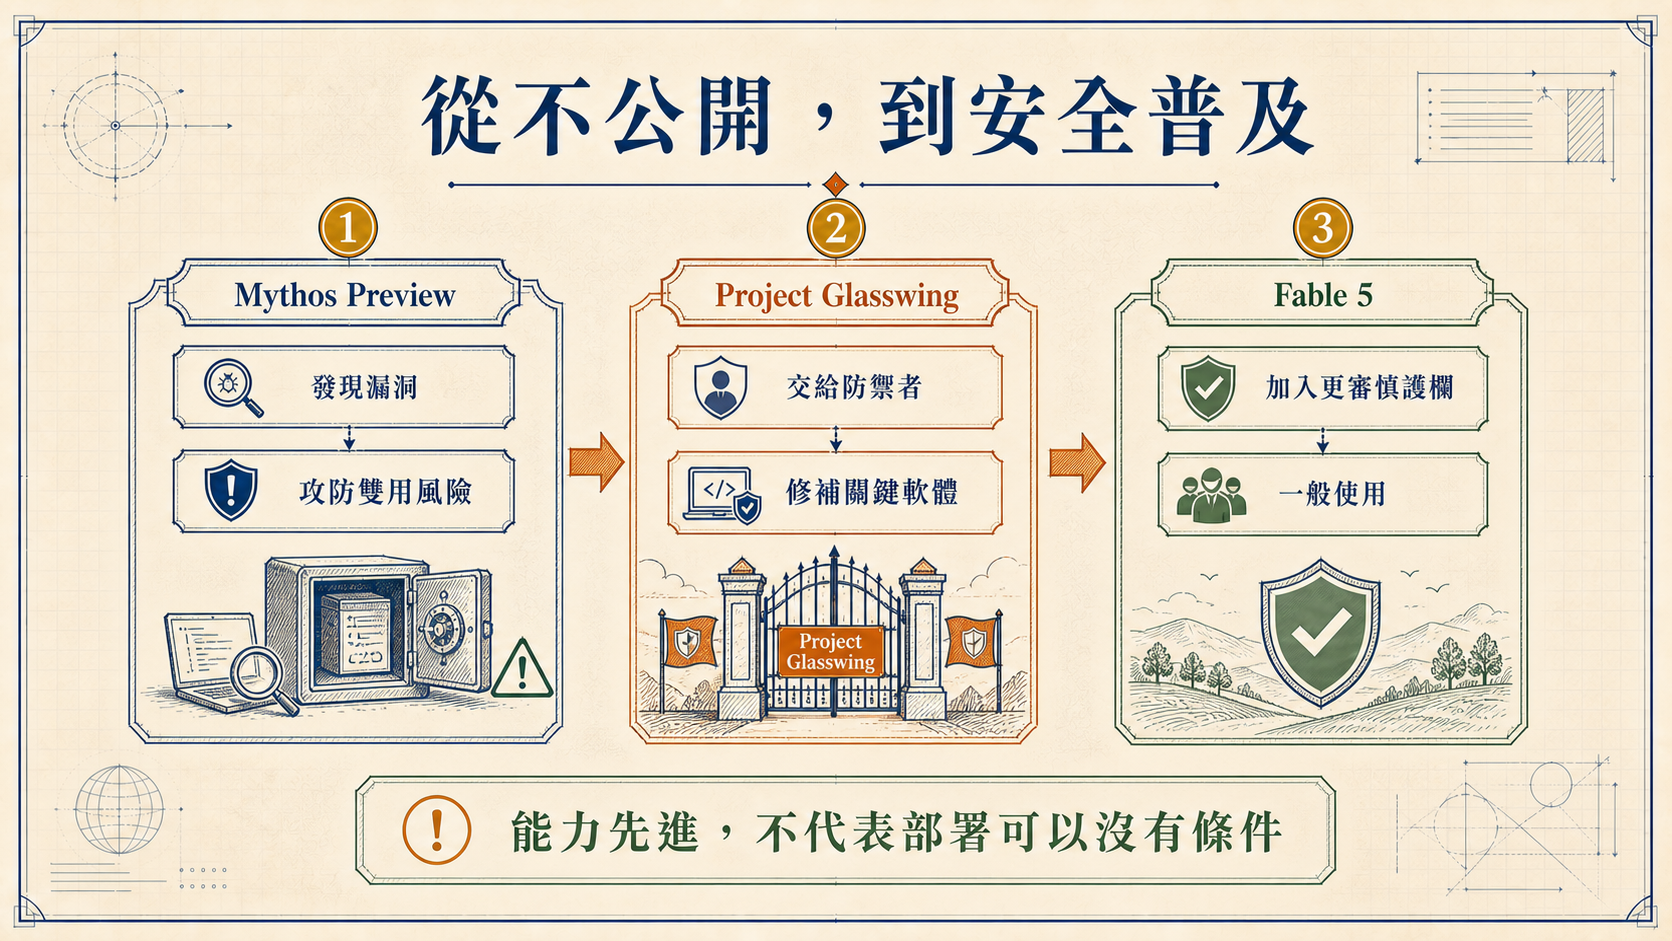
這段敘事很重要,因為它把發布延後描述成一個「先防禦、後普及」的安全決策,而不是單純的產品排程。Anthropic 的目標不是永久封閉能力,而是找到一種能讓大多數人使用、又不直接開放高風險能力的部署方式。
Fable 5 因而不是能力突然變得無害,而是模型外圍增加了更審慎的控制。官方宣稱它是可廣泛提供的 Mythos-class 模型,意思是能力層級與安全部署被分開處理:先辨識危險請求,再決定由哪個模型或政策路徑接手。
這也是當代前沿模型發布的核心矛盾。能力若只能鎖在少數實驗室,社會價值無法擴散;若一次全面開放,高風險用途又可能跑在治理前面。Fable 5 提出的答案不是消除風險,而是用分層存取與動態路由管理風險。
032. 高風險請求自動分流|安全其實是一套路由架構
影片給出了一個罕見而具體的產品細節:Fable 5 的安全系統會自動審查涉及 cybersecurity 或 biology 等高風險領域的請求,並把它們轉交給 Opus 4.8。這表示護欄不只是「回答或拒答」的二元開關,而是模型路由。
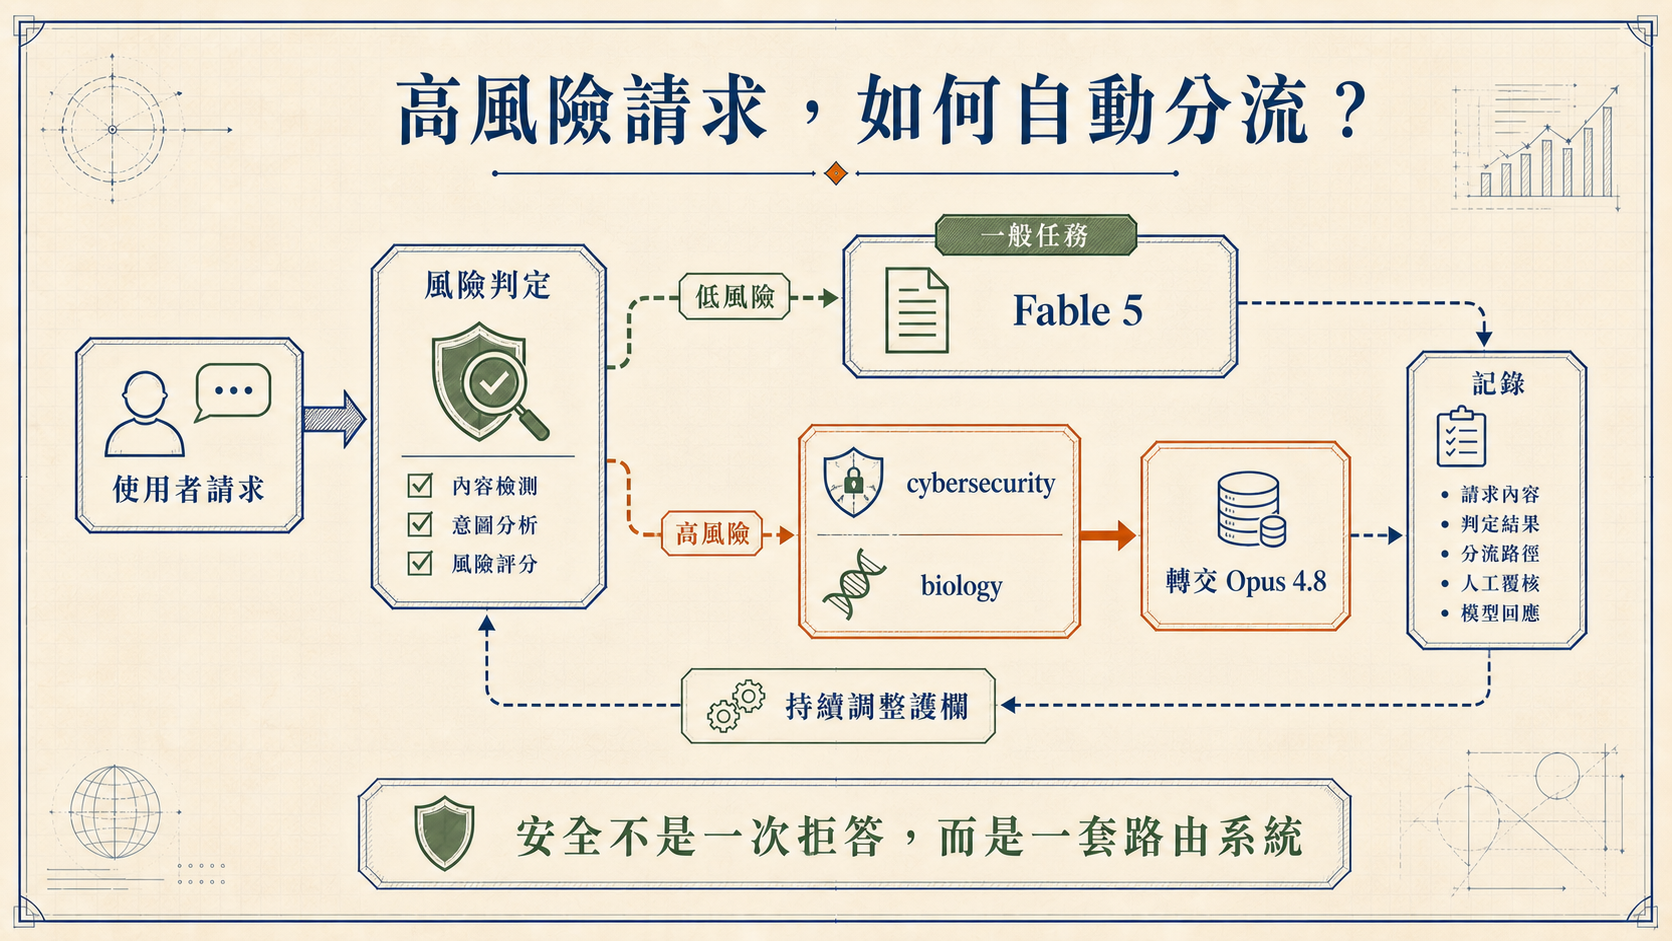
從系統角度看,一個請求先經過風險分類,再進入不同能力與限制組合。一般任務可以使用 Fable 5;落入高風險範圍的內容,則由限制更合適的模型處理。這種設計允許產品保留大部分新能力,不必因少數危險領域而全面降級。
代價是分類一定會有誤差。護欄過寬,合法的資安研究、藥物分析或教學請求也可能被降級;護欄過窄,危險請求可能漏過。Anthropic 在影片中承認目前範圍較廣,未來會持續調整,讓安全請求更容易通過。
因此,使用者實際感受到的 Fable 5 並不只由底層模型決定,也取決於風險分類器、政策、替代模型與後續調整。評估模型時若遇到某些領域表現突然改變,不能只問「Fable 5 會不會」,還要問「這個請求實際被路由到哪裡」。
043. 自主工作數天|真正稀缺的是可持續狀態
影片最醒目的承諾,是 Fable 5 可以在無人介入下運作數天。官方公告進一步提到,模型能在長任務中跨越大量 tokens 維持專注,並利用自己的筆記改善後續輸出。這指向一個常被低估的差別:長任務能力不只是 context window 變大,而是狀態管理變好。
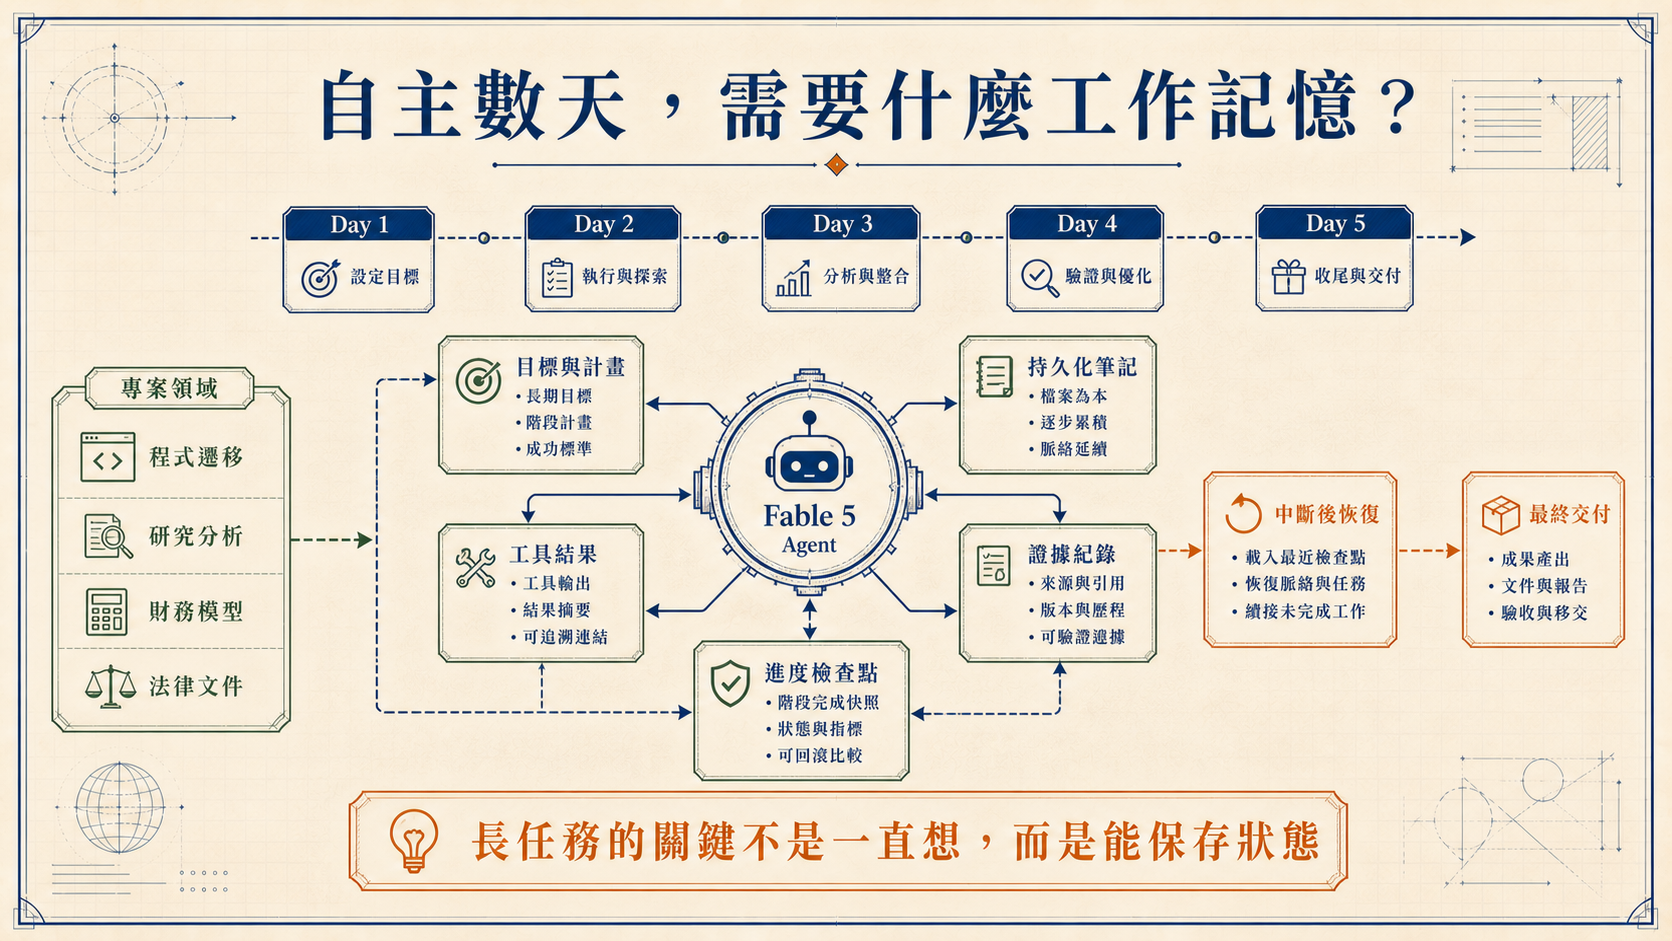
一個 agent 若只把所有歷史塞在對話裡,很快會被舊資訊淹沒。可靠的長任務需要外部化狀態:任務計畫、決策紀錄、檔案變更、工具結果、待辦清單、驗證證據與 checkpoint。發生中斷後,系統應能根據這些狀態恢復,而不是重新閱讀全部內容後猜測進度。
這也是「無人介入」容易被誤解的地方。它不代表人類完全退出,而是把監督從每一步盯場,改成事前設定邊界、事中查看 checkpoint、事後驗收證據。若任務沒有清楚的成功條件,再強的模型也可能把數天算力花在錯的方向。
不同專業領域還需要不同證據。程式遷移要通過測試與 diff review;研究分析要保留引用與來源;財務模型要能重算並解釋假設;法律文件需要版本比較與條款追蹤。自主性只有和可驗證性綁在一起,才是生產力,而不是延後被發現的錯誤。
054. 把宣傳承諾變成驗收|真正的自主,是不用一直盯著
官方短片最後把問題拋給使用者:「我們知道 Fable 5 能做什麼,有趣的是你會用它做什麼。」對團隊來說,更務實的問題是:哪些任務值得讓它跑數天,以及如何判斷它真的比舊流程更好?
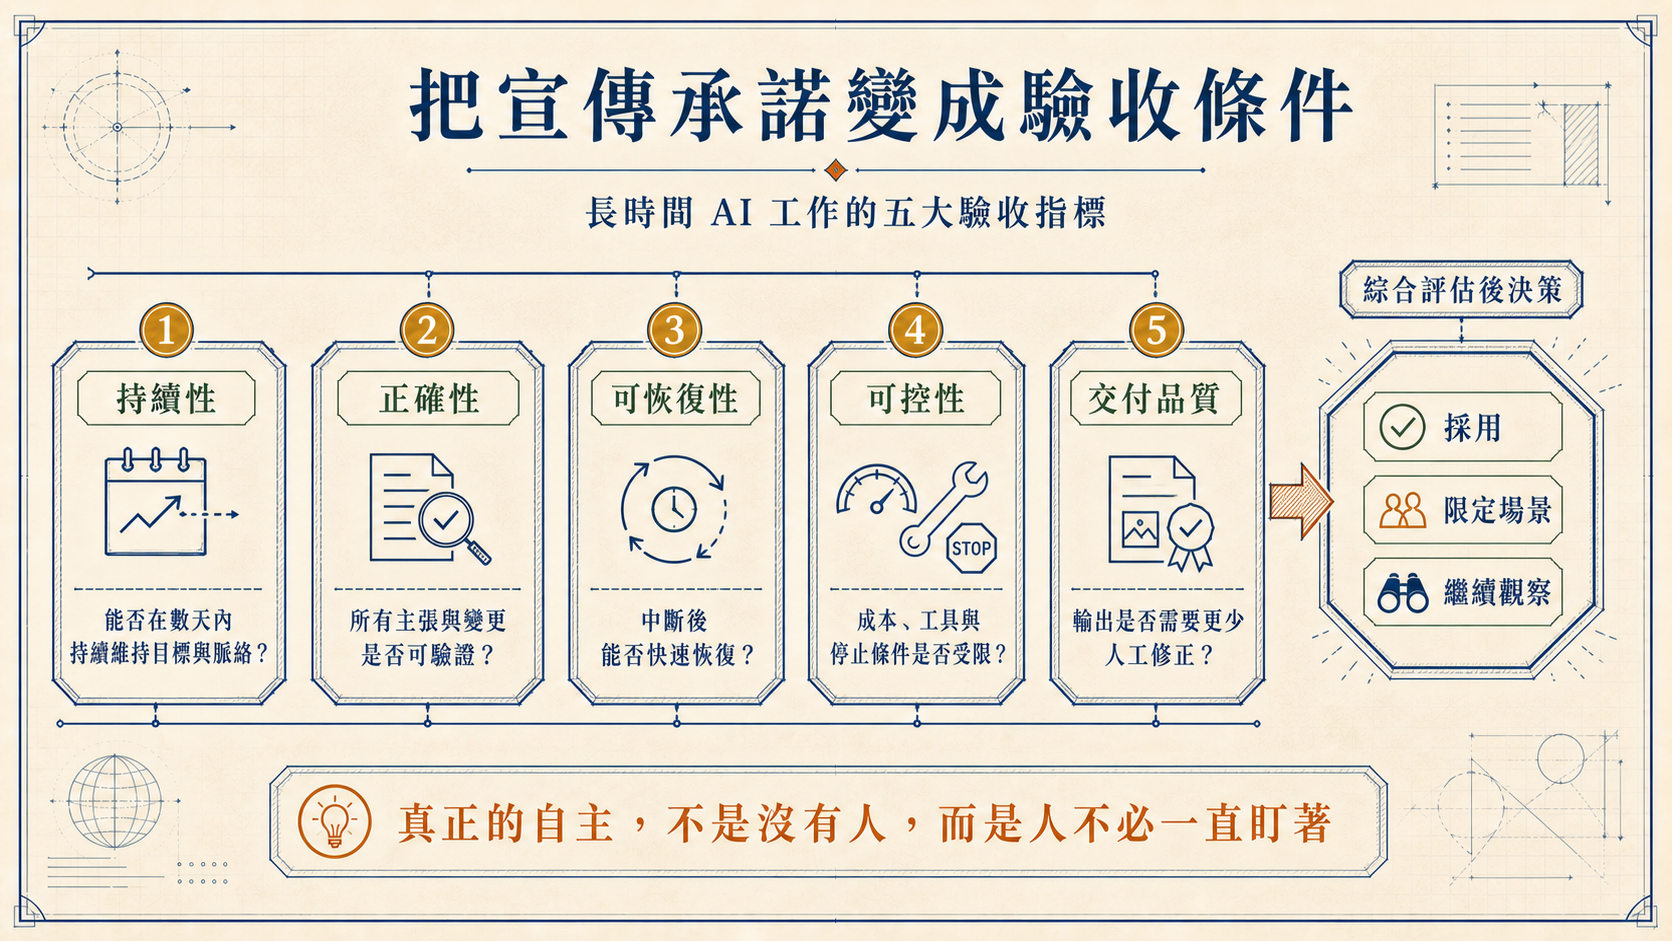
第一項是持續性:經過數小時或數天後,模型是否仍遵守原始目標與限制。第二項是正確性:它提出的事實、修改與結論是否有可檢查證據。第三項是可恢復性:session 中斷、工具失敗或環境重啟後,能否從明確 checkpoint 接續。
第四項是可控性:工具權限、預算、步數與停止條件是否受限。第五項是交付品質:最終成果是否真的減少人工修正,而不是把監督成本從過程移到最後一次爆發。
最適合先測的,不是完全開放的「幫公司變好」,而是範圍明確、可驗證、又足夠複雜的任務,例如跨 repo API 遷移、長篇研究資料整理、合約版本差異分析,或需要反覆視覺檢查的網站改版。這些任務能測出模型是否真的維持狀態,也能用測試、引用或畫面驗證結果。
Anthropic 的官方敘事把 Fable 5 描繪成從聊天走向持續工作的轉折點。這個方向值得重視,但「能運作數天」不是終點。真正成熟的自主系統,應該讓人不必一直盯著,同時仍能隨時知道它做了什麼、為什麼這樣做,以及何時應該停止。