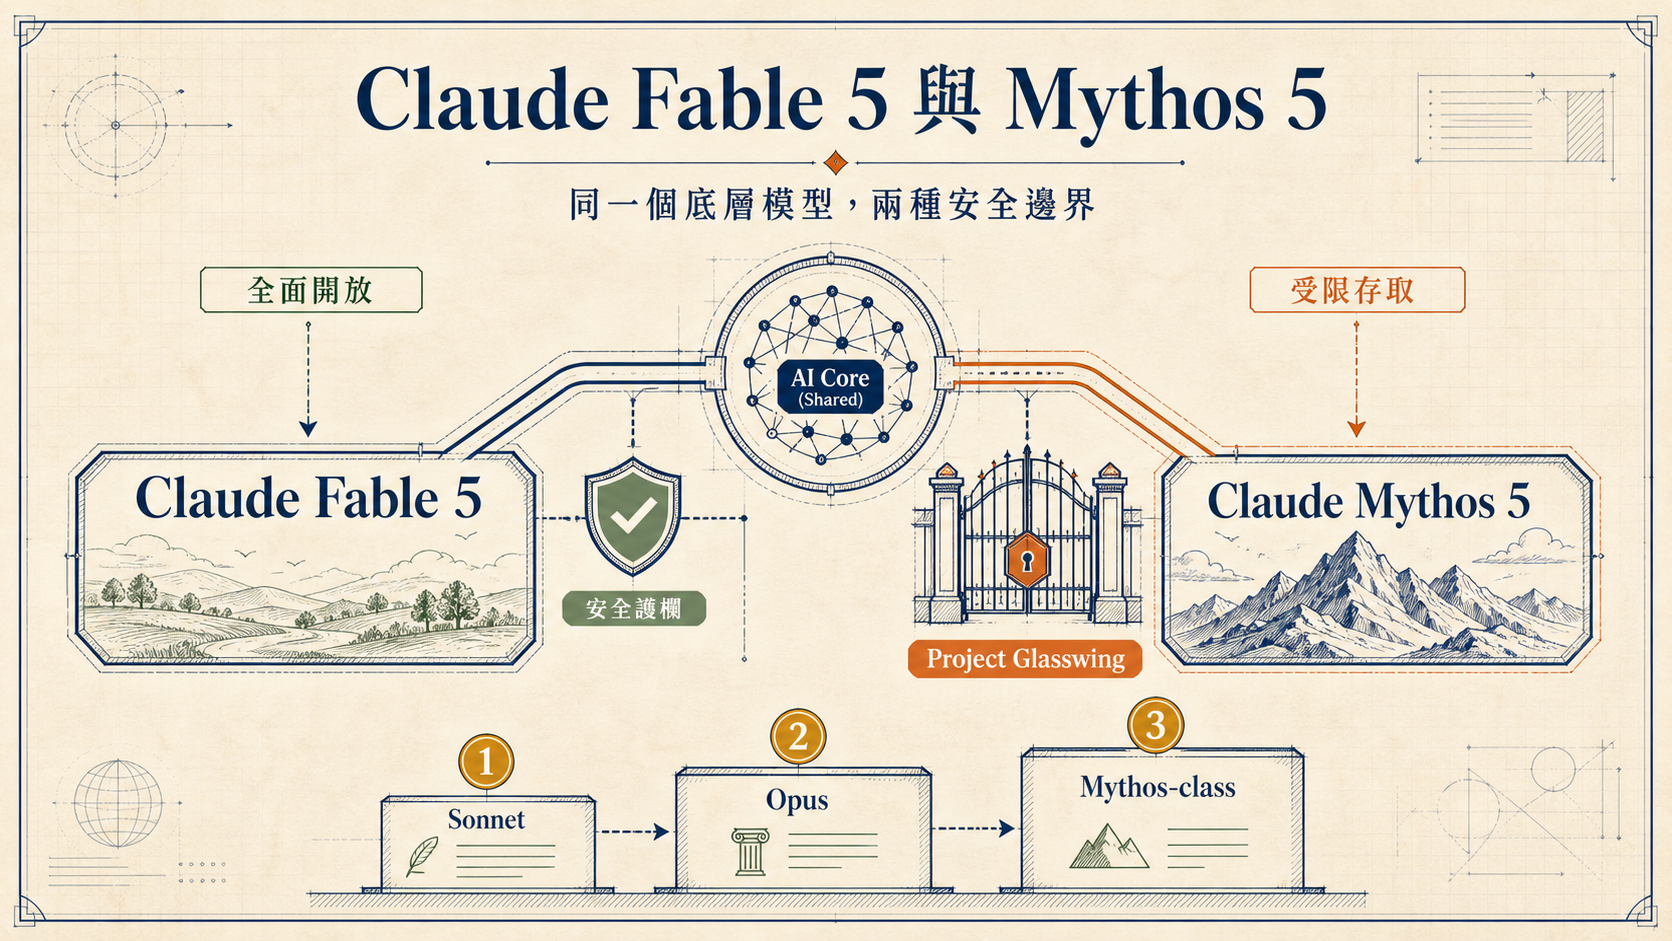
010. 發布不是只有一個新模型|先看懂 Fable 5 與 Mythos 5 的關係
Anthropic 在 2026 年 6 月 9 日發布 Claude Fable 5 與 Claude Mythos 5。Nate Herk 的原始影片用不到九分鐘快速整理價格、開放範圍、Benchmark 與他最想測的工作流;若把影片和 Anthropic 官方公告放在一起看,這次發布最重要的訊號不是「Claude 又多了一個型號」,而是能力、安全與供應方式被拆成三個不同旋鈕。
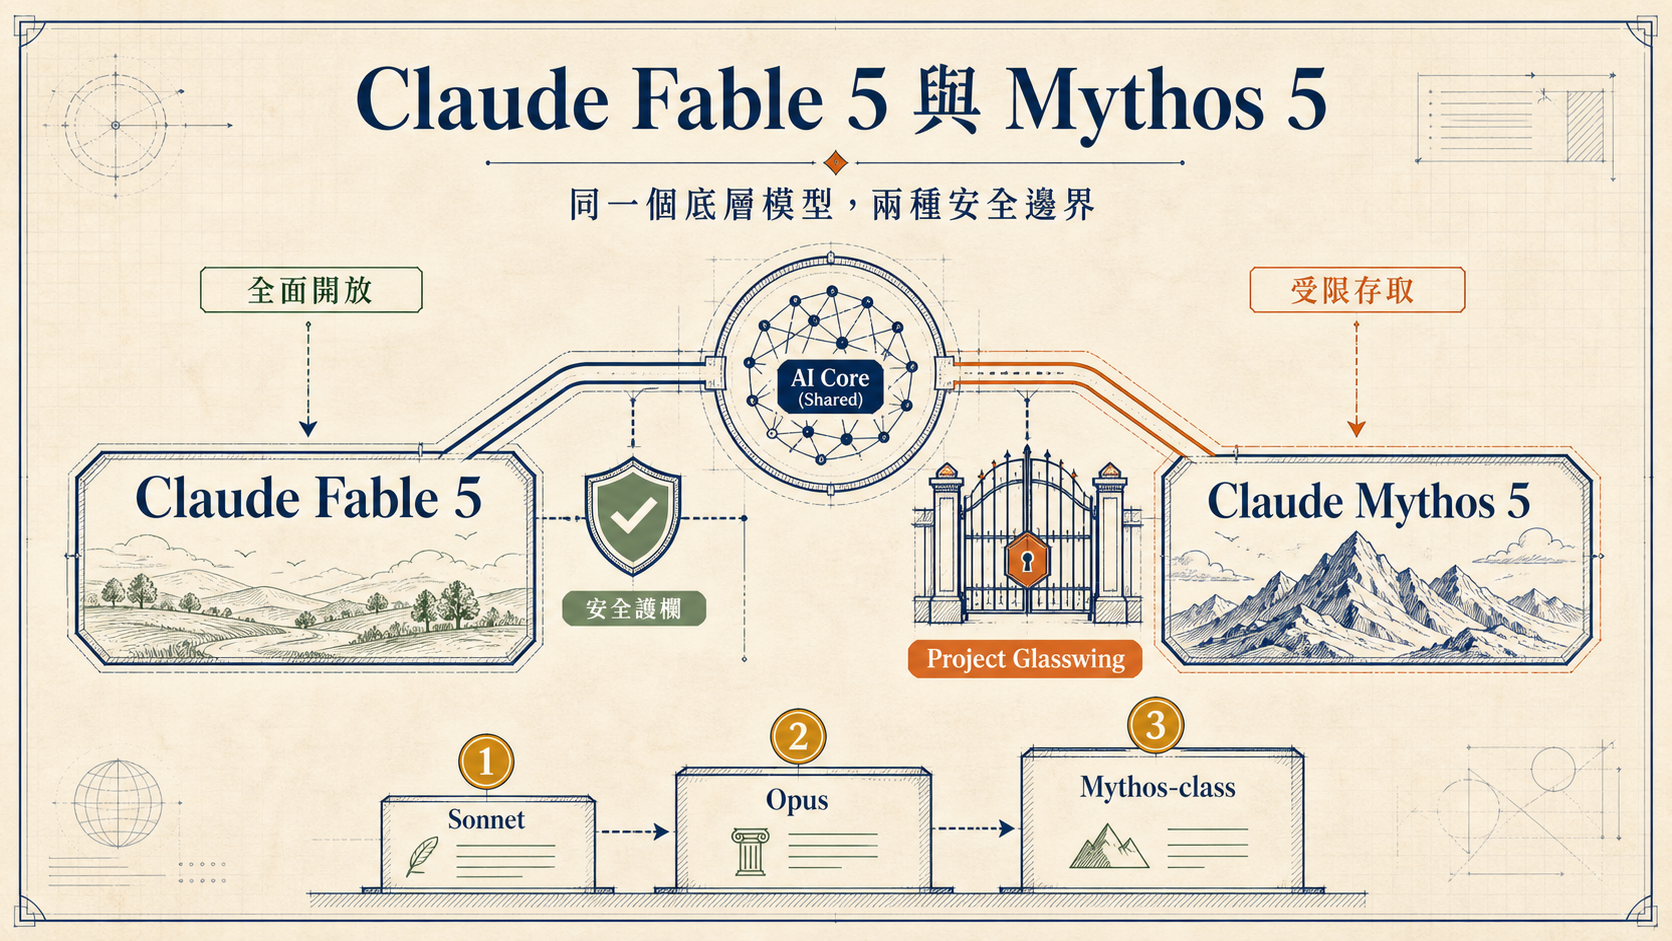
Fable 5 是一般使用者能取得的 Mythos-class 模型。所謂 Mythos-class,是 Anthropic 對能力高於 Opus 的新層級命名。Mythos 5 則不是另一個完全不同的底模;依官方說明,它與 Fable 5 使用相同模型,但針對特定 cyber safeguards 採不同設定,只透過 Project Glasswing 等受控計畫提供給授權合作夥伴。
這個區分比型號高低更重要。模型「會不會做」是一件事,產品「允許它在什麼條件下做」是另一件事。一般使用者拿到的 Fable 5,代表 Anthropic 認為這組能力已能在保留護欄的條件下廣泛部署;Mythos 5 則代表某些高風險能力只能在身份、用途、環境與稽核都受控時開放。
影片把 Fable 5 形容成較公開的 Mythos 能力,方向上合理;但「被削弱的 Mythos」容易讓人誤會。更精確的說法是:同一個底層模型,因安全政策與部署對象不同,呈現出不同的可用行為。護欄會影響輸出範圍,卻不等於底層推理能力被換成另一套較小模型。
021. 兩週體驗窗|價格、訂閱與容量訊號
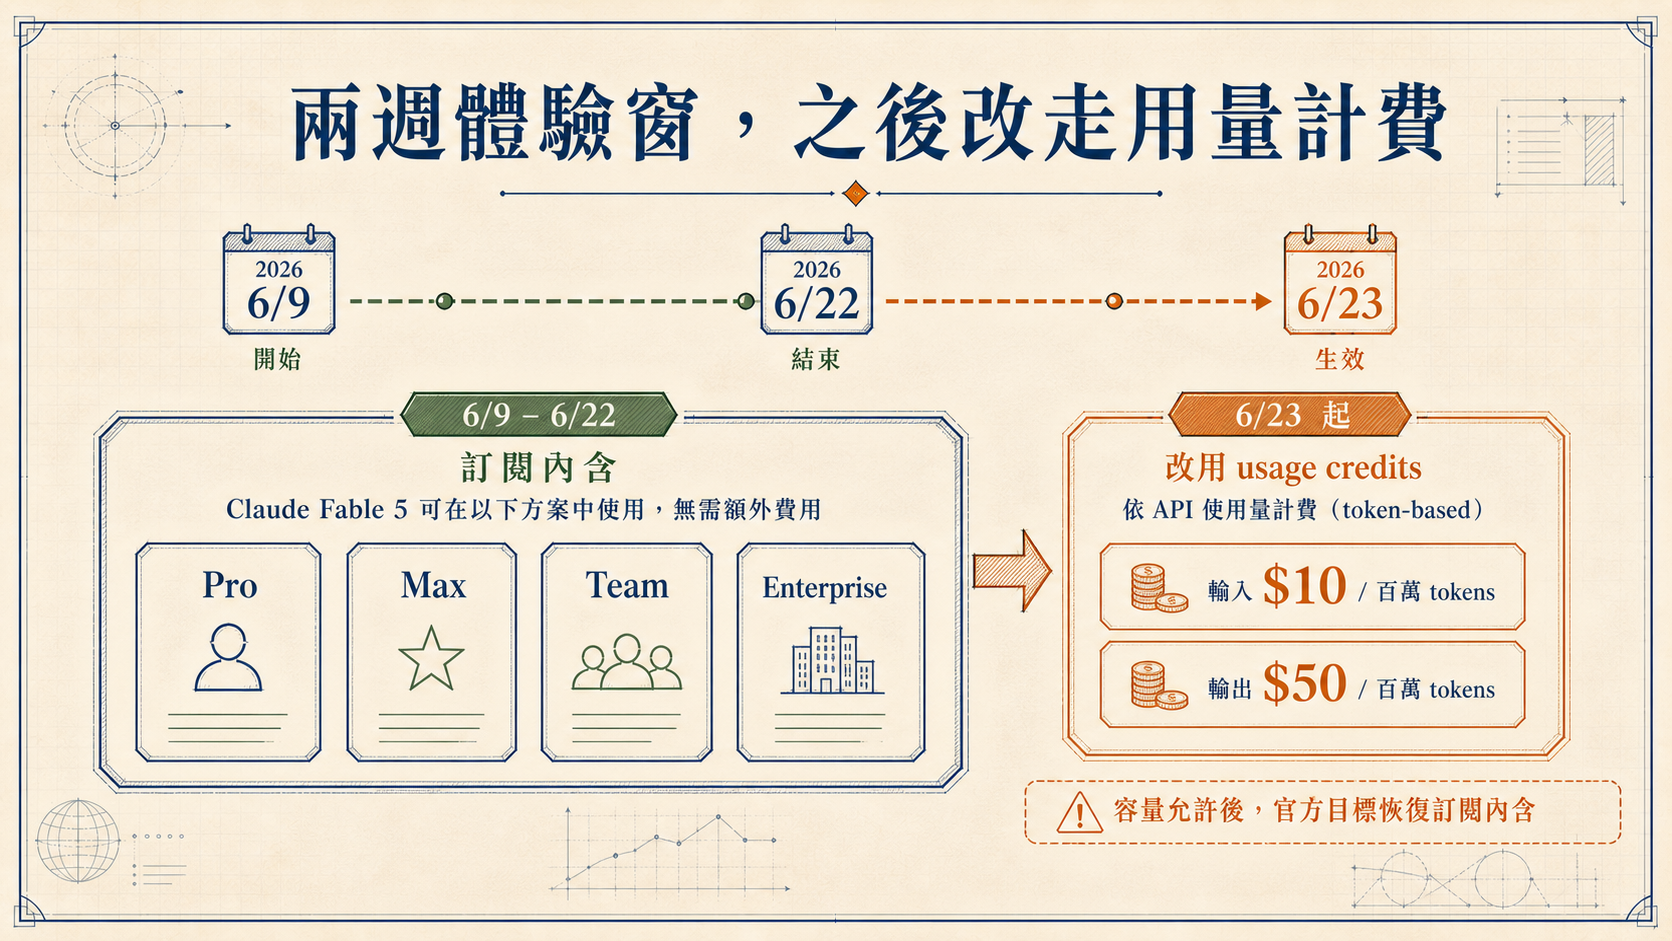
Fable 5 的 API 定價是每百萬 input tokens 10 美元、每百萬 output tokens 50 美元。影片用「約為 Opus 的兩倍」幫觀眾建立價格感,但團隊真正該算的不是價目表倍數,而是一個任務從開始到可交付總共花多少錢。
同一個任務可能因模型更強而減少重試、縮短人工修正,也可能因為更高 effort、更長 context 或更多 tool calls 迅速放大 token 消耗。輸出 tokens 單價尤其高,若 agent 反覆生成長篇中間報告、把完整檔案一再塞回 context,實際帳單不會只比舊模型多一個固定比例。
供應方式還有一個明確期限:從 6 月 9 日到 6 月 22 日,Fable 5 暫時包含在 Pro、Max、Team 與 seat-based Enterprise 訂閱內;6 月 23 日起移出,改用 usage credits。Anthropic 表示,容量足夠後希望盡快恢復為訂閱標準內容,但沒有承諾確切日期。
這不是單純的促銷倒數,而是容量管理訊號。當模型單次推理更昂貴、又主打長時間工作,需求尖峰會直接碰到算力供應。短期內含、之後按量、容量允許再恢復,表示 Anthropic 正用價格與方案控制負載。
因此,這兩週最有效的使用方式不是把日常工作全部換成 Fable 5,而是挑三到五類高價值任務建立基準。免費體驗窗若只拿來感受「好像比較聰明」,期限結束後仍然不知道值不值得付費;若拿來記錄品質、完成時間、tokens、人工修正與失敗率,之後才有能力做模型路由。
032. 同底模、不同護欄|Mythos-class 的部署政治
Fable 5 與 Mythos 5 的差異最集中在 cybersecurity。官方把 Fable 5 描述為已調整到能安全供一般使用的 Mythos-class 模型;Mythos 5 則透過 Project Glasswing 先部署給資安防禦者、基礎設施提供者與政府合作場景。
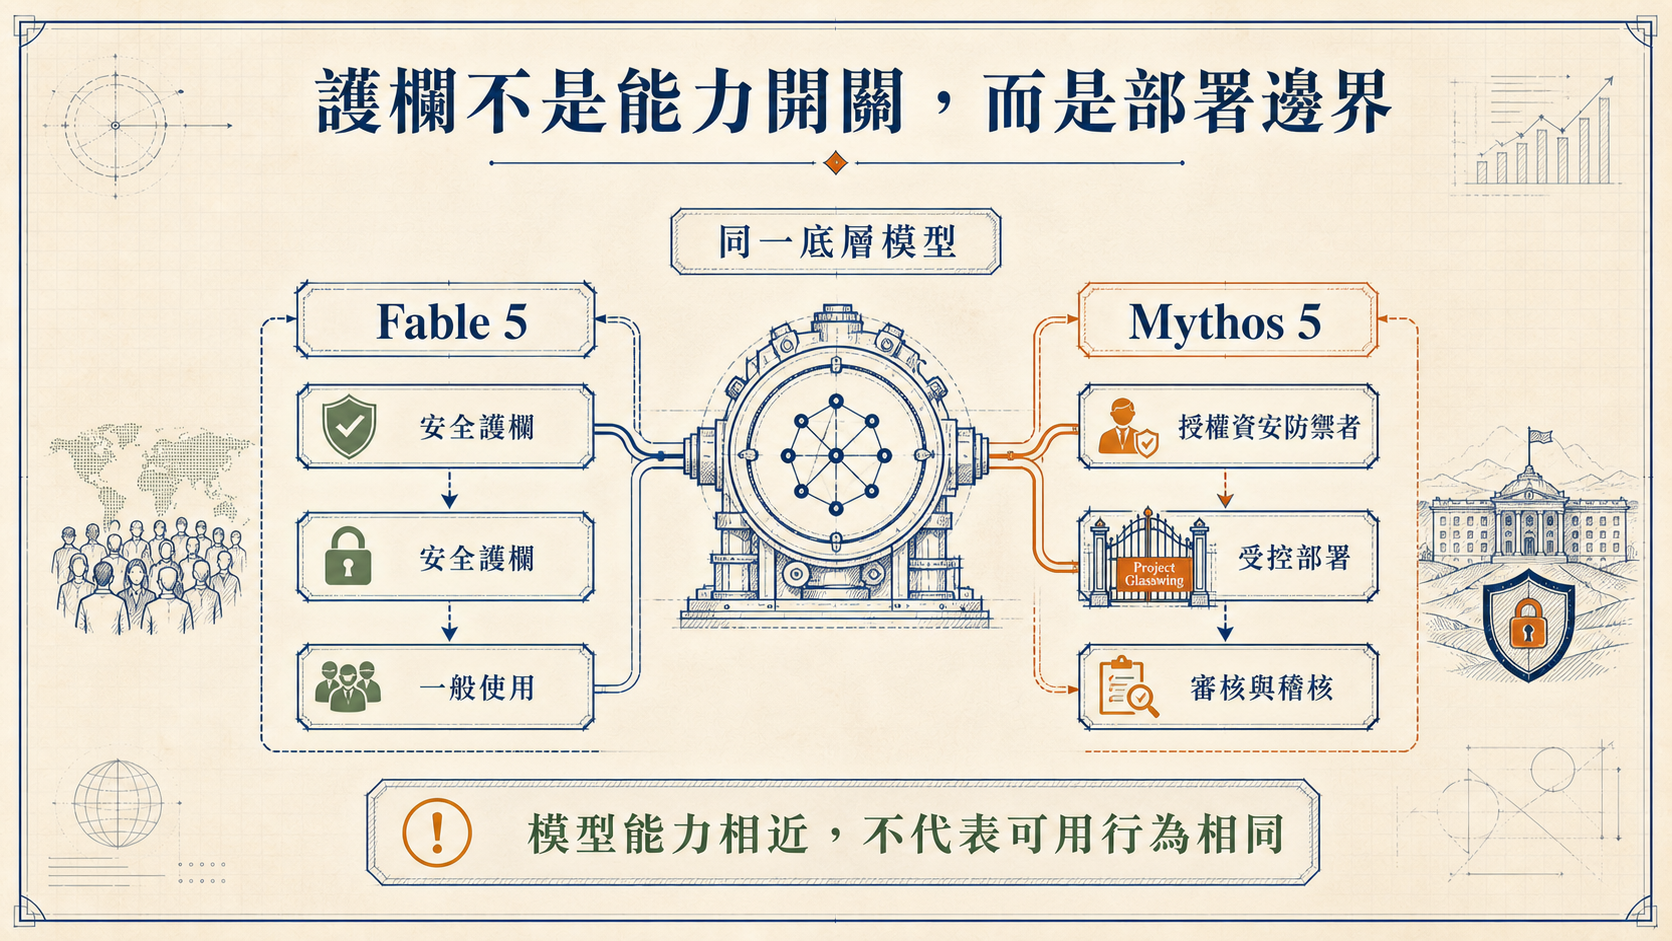
影片在 5 分 30 秒附近有一處口語字幕容易造成混淆:它先說 Fable 5 移除了 safeguards,後續又正確說明是 Mythos 5 在受控環境解除相關限制。依官方公告,應以後者為準:Fable 5 保留一般部署所需的 cyber safeguards,Mythos 5 才是對授權對象提供不同限制的版本。
這種分層發布反映一個正在成形的 AI 治理模式:不是把所有能力一律公開或一律封鎖,而是把高風險能力綁定到可信身份、明確用途、隔離環境與稽核機制。模型公司因而不只是在賣 API,也逐漸扮演能力分發與存取治理者。
講者認為模型本身是中性的,善惡取決於使用者意圖。這個直覺只說對一半。人的意圖當然重要,但模型供應者仍能透過資料、系統提示、工具權限、拒答政策、監控與帳號治理,改變濫用的成本與規模。能力越強,不能只依賴「使用者應該做對的事」,而要把防線放進整個部署系統。
對企業使用者而言,這也提醒我們:安全不是模型名稱附帶的一個屬性。即使使用公開版 Fable 5,仍要自行設定資料邊界、工具最小權限、敏感操作確認、日誌與異常中止。官方護欄只能處理一部分風險,無法替每個組織理解內部系統與業務責任。
043. Benchmark 是方向|真正的問題是能否在你的 workload 兌現
Anthropic 強調 Fable 5 在軟體工程、知識工作、Vision、科學研究與資安等評測的提升。影片對 Benchmark 保留了一點距離:它們值得看,卻不能單獨決定模型是否適合真實工作。這是整支影片最值得延伸的判斷。
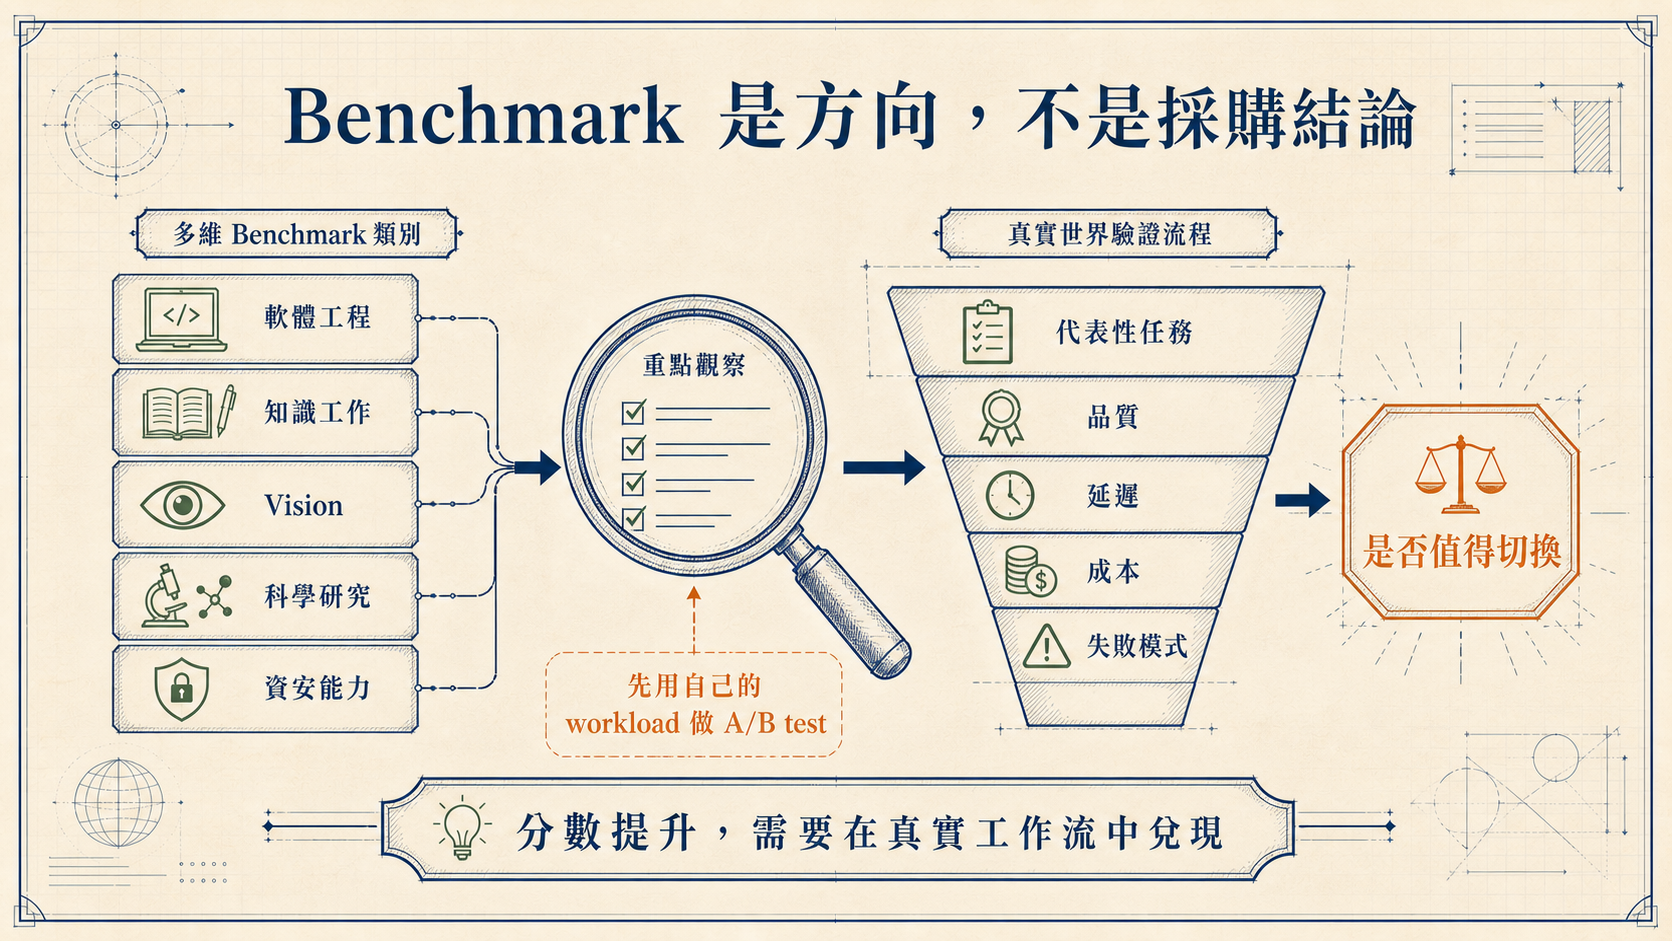
Benchmark 回答的是「在特定題目、評分方式與推理設定下,模型表現如何」;團隊要回答的則是「在我們的資料、工具、權限、延遲與錯誤成本下,它能否更穩定地完成任務」。兩者相關,但從來不是同一題。
例如 coding 分數提高,不代表模型就更懂你的 monorepo、部署限制與歷史技術債;Vision 進步,也不代表它能穩定辨識你產品裡細微的 UI regression。知識工作表現更強,仍可能在引用、數字或時間敏感資訊上出錯。若只看平均分數,很容易忽略少數但昂貴的失敗。
合理的測試應該包含代表性 workload,而不是只丟一道漂亮 demo。每一類任務至少記錄五件事:最終品質、完成時間、token 成本、人工修正量,以及失敗是否可被偵測。若新模型把一次完成率從 60% 提高到 85%,即使單價較高也可能更便宜;若品質只小幅改善、輸出卻變得更長,成本反而可能惡化。
影片也提到部分 coding benchmark 的可信度爭議。編輯上不需要因單一爭議否定所有評測,但應降低對任何單一榜單的依賴。最穩健的做法,是把官方 Benchmark 當候選訊號,再用自己的 hidden test set 與 blind review 決定是否採用。
054. 長時間 Agent|能力提升與成本失控會一起發生
Fable 5 的產品定位之一,是處理 complex long-running work。影片把它連到近期流行的 agentic loops:不再只由人提示一個 agent,而是讓 planner、worker、reviewer 或其他 agent 形成循環,持續拆解、執行與檢查。
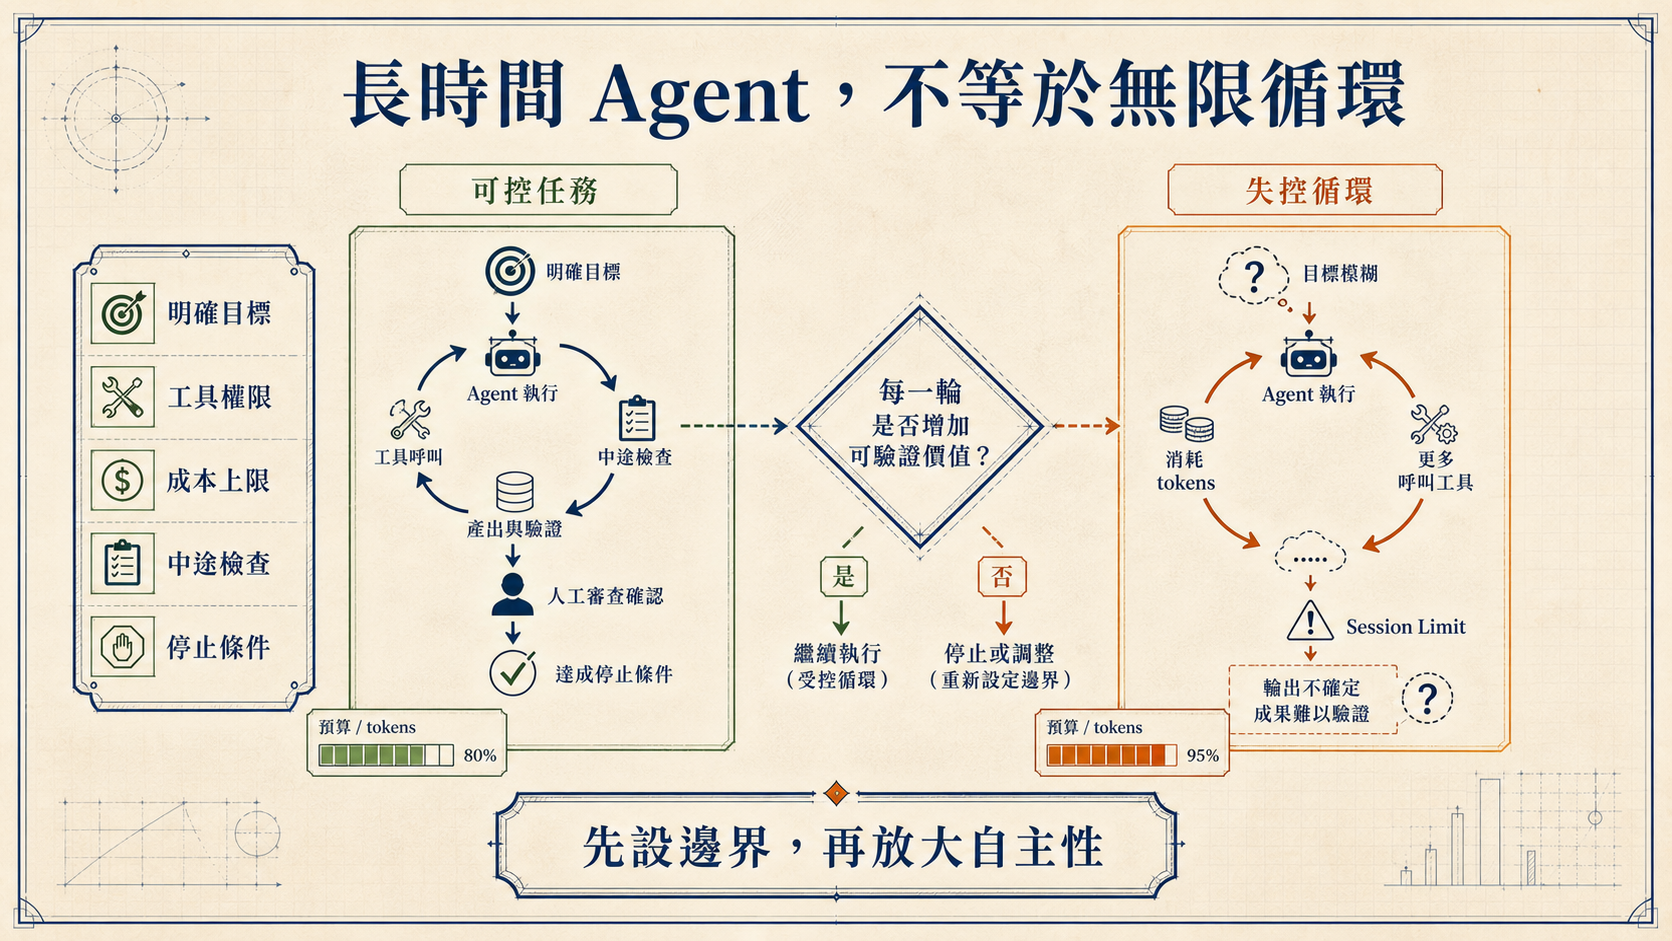
長時間工作能力確實可能改變自動化上限。過去模型常在多步任務中忘記目標、過早結束或累積錯誤;若 Fable 5 能更穩定維持計畫、使用工具與視覺驗證,它會特別適合 code migration、研究整理、測試修復、簡報製作與網站 QA。
但「能跑更久」不是「應該一直跑」。沒有停止條件的 agent loop,可能只是在更昂貴地反覆改寫同一個答案。模型供應者從更多 token 使用獲得收入,使用者則承擔預算、權限與錯誤累積,因此兩者對「多跑幾輪」的誘因不完全一致。
一個可控的長任務至少要有五道邊界:明確的完成定義、工具最小權限、成本或步數上限、中途 checkpoint,以及無進展時的停止條件。Reviewer 也不能只問「答案看起來好不好」,而要檢查測試、引用、diff、截圖或其他可驗證證據。
Effort level 也應成為路由參數,而不是永遠開到最高。影片觀察到,舊模型的 X-high 與 Max 有時體感差異有限;若 Fable 5 的 low effort 已能處理多數任務,較高 effort 應只留給真正困難、且錯誤成本高的案例。最強模型配最高 effort 並不是預設答案,而是一個需要證明回報率的昂貴選項。
065. 七天測試法|怎麼判斷團隊該不該切換
這次短期訂閱體驗窗,正好適合做一個七天評估,而不是倉促全面換模。
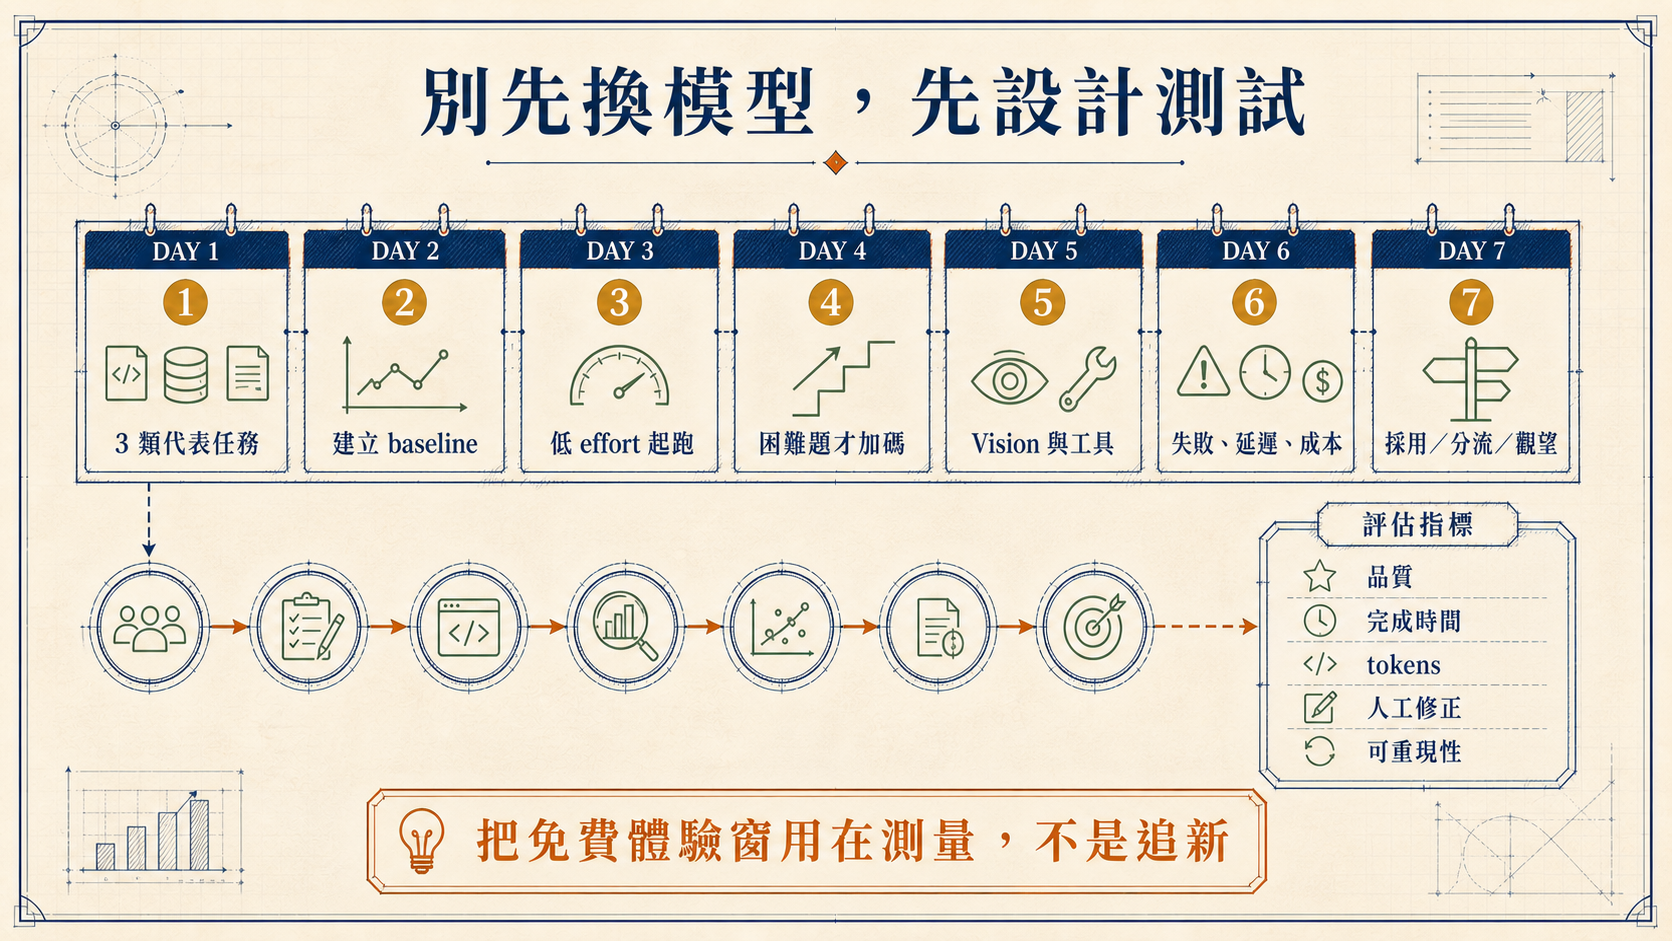
第一天,挑三類代表性任務:例如 repo 級 coding、需要查核來源的知識工作,以及含截圖或 UI 的 Vision 任務。每類準備簡單、中等、困難案例,避免只選最適合新模型的展示題。
第二天,用目前模型建立 baseline,固定提示、工具、資料與驗收標準。記錄完成時間、tokens、人工修正與失敗模式。
第三天,先用 Fable 5 的低 effort 跑相同案例。若低 effort 已勝過 baseline,就不要急著增加推理成本。
第四天,只把較高 effort 用在低 effort 失敗或不穩定的困難題,觀察品質增量是否值得額外延遲與費用。
第五天,測試工具使用與 Vision verification。不要只看它能否產生內容,也要看它能否辨識錯誤、引用證據並在修改後重新驗證。
第六天,集中檢查最差案例。平均表現好看不代表可上線;真正決定風險的是幻覺、權限誤用、無限循環與難以察覺的錯誤。
第七天,做三種決策之一:全面採用、只對特定任務分流,或暫時觀望。多數團隊最合理的答案會是「選擇性路由」:普通任務留在較便宜模型,複雜長任務、跨工具工作與高價值驗證才升級到 Fable 5。
Nate Herk 的影片很好地捕捉了發布當天的興奮:更強的 coding、知識工作、Vision 與長時間 agent 能力,確實值得立即測試。但魚塘更在意的是興奮之後如何決策。這次發布真正成熟的用法,不是把「Mythos 終於來了」當成結論,而是把新能力放進成本、安全與可驗證工作流裡,看看它是否真的替你的團隊完成更多工作。