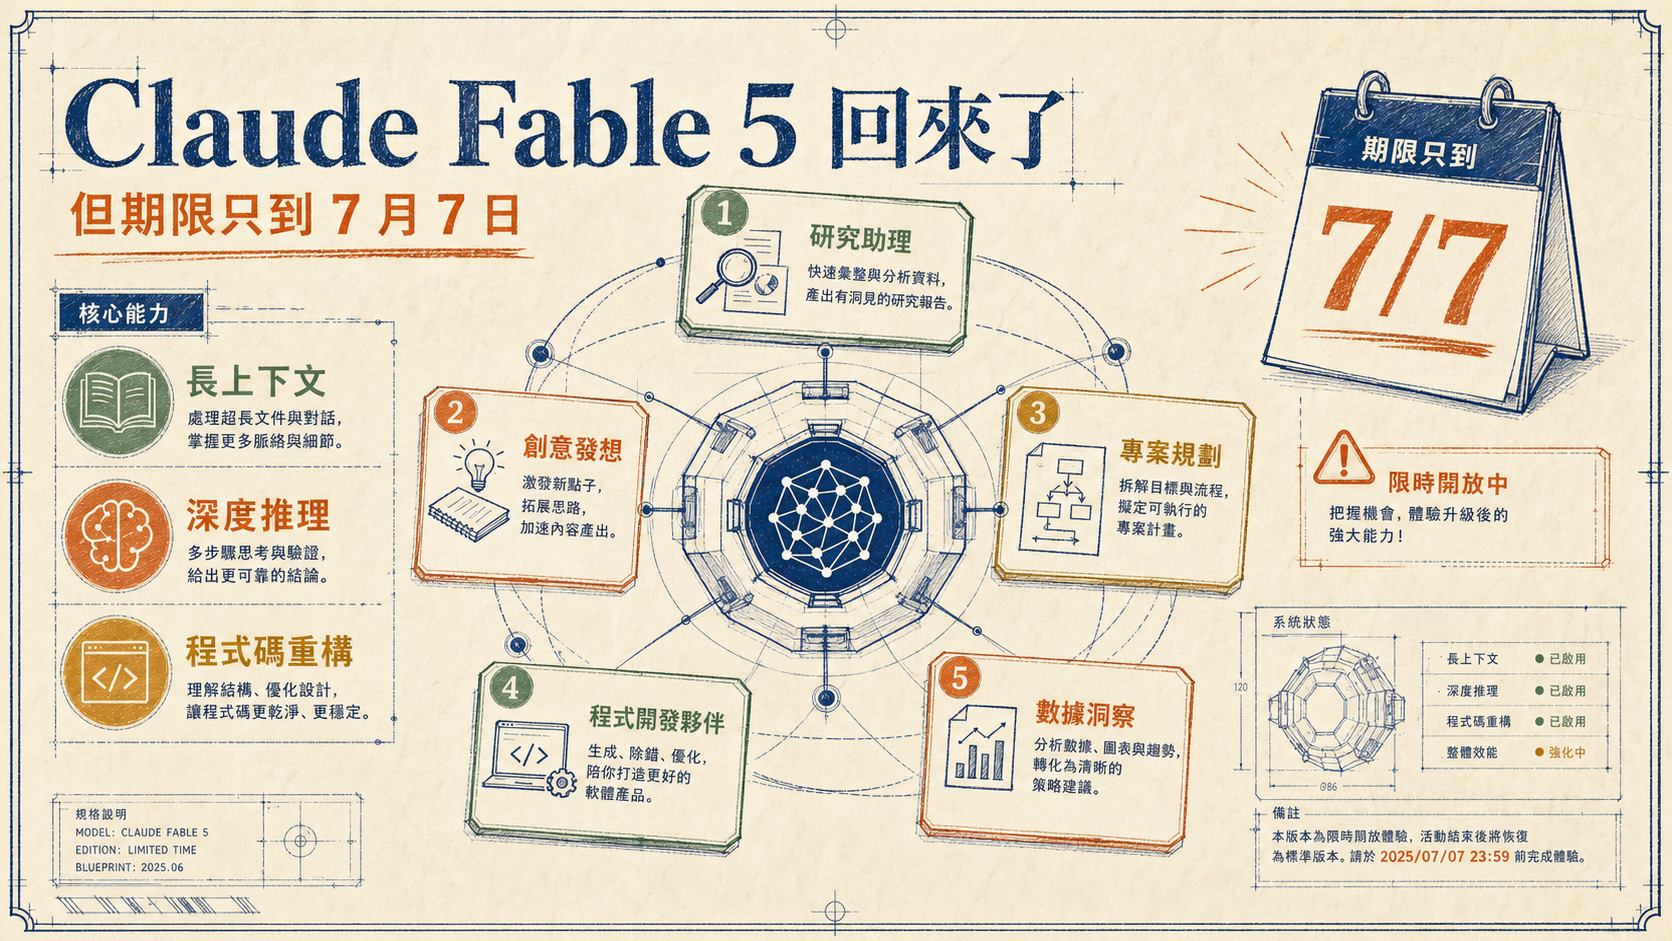
010. 先看期限|這不是「又一個模型推薦」,而是資源分配問題
Peter Yang 在 2026 年 7 月 1 日發布的影片 Claude Fable 5 Is Finally Back: 5 Must-Try Use Cases Before July 7 裡,主軸不是單純說某個模型很強,而是提醒觀眾:如果一個高推理模型有期限、有用量限制、有 API 成本,那真正重要的問題會變成「什麼任務值得花這個額度?」
他在開場表示,Claude Fable 5 回到 Claude 訂閱中,但只開放到 2026 年 7 月 7 日;而且訂閱用量打到每週限制的一半後,就不能再用訂閱額度跑 Fable,之後要走 pay-as-you-go API credits。這些數字與期限都是影片中的說法,本文不把它們寫成平台公告,而是把它當成一個更普遍的工作方法問題:當最貴、最慢、最會思考的模型不是無限資源時,你應該怎麼用?
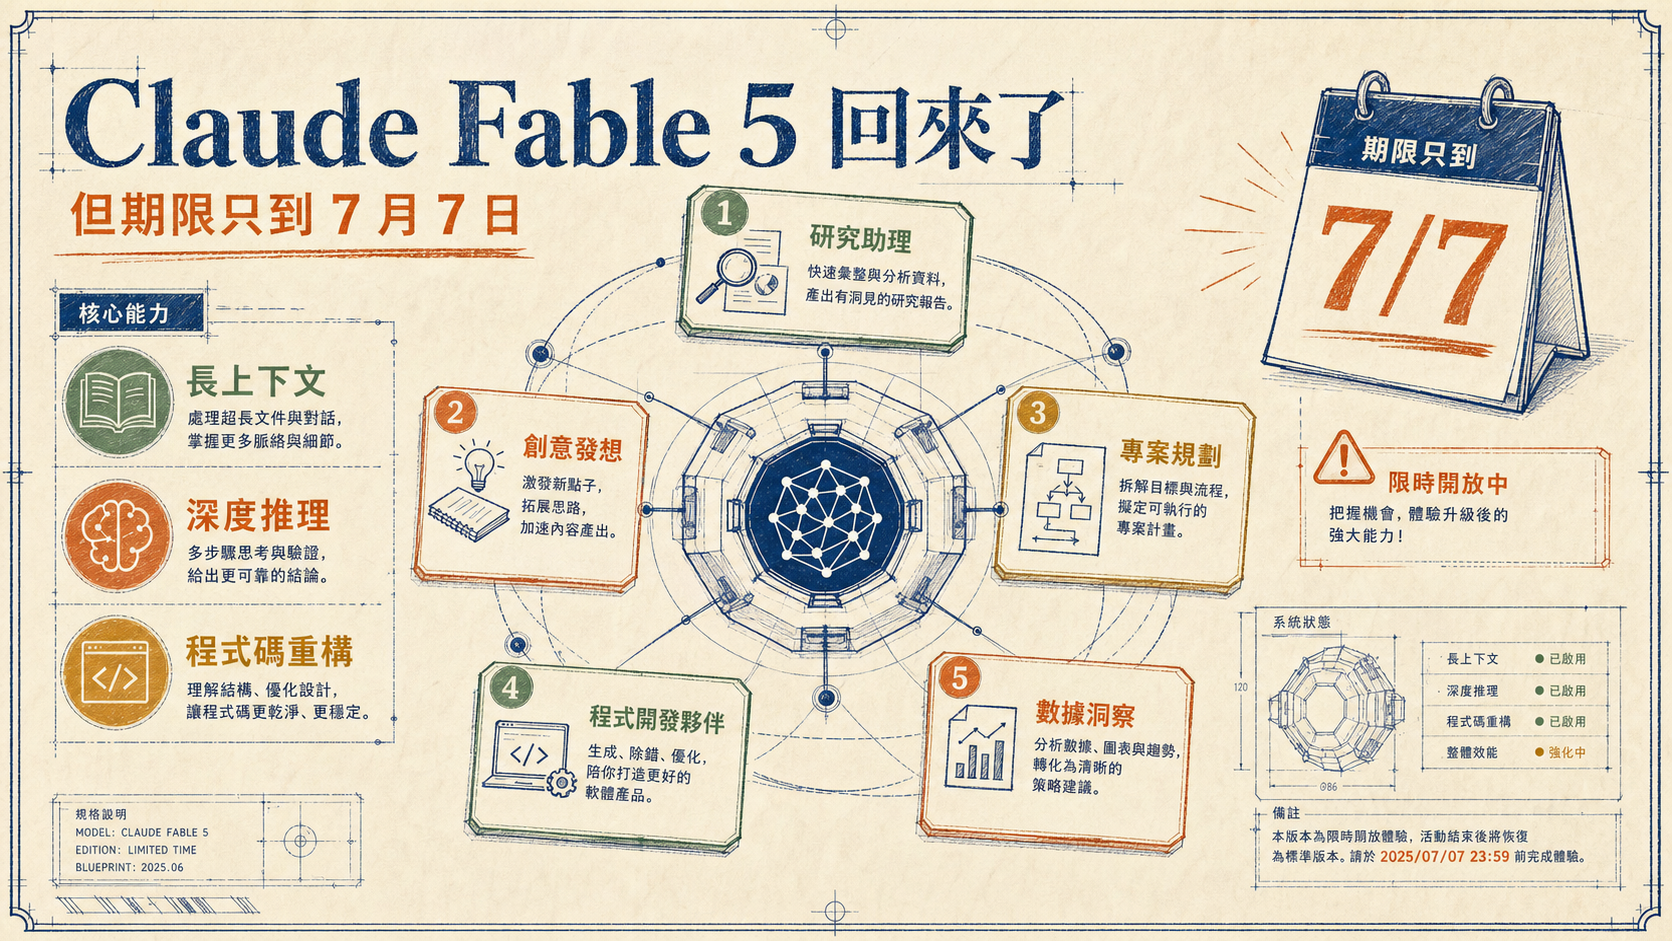
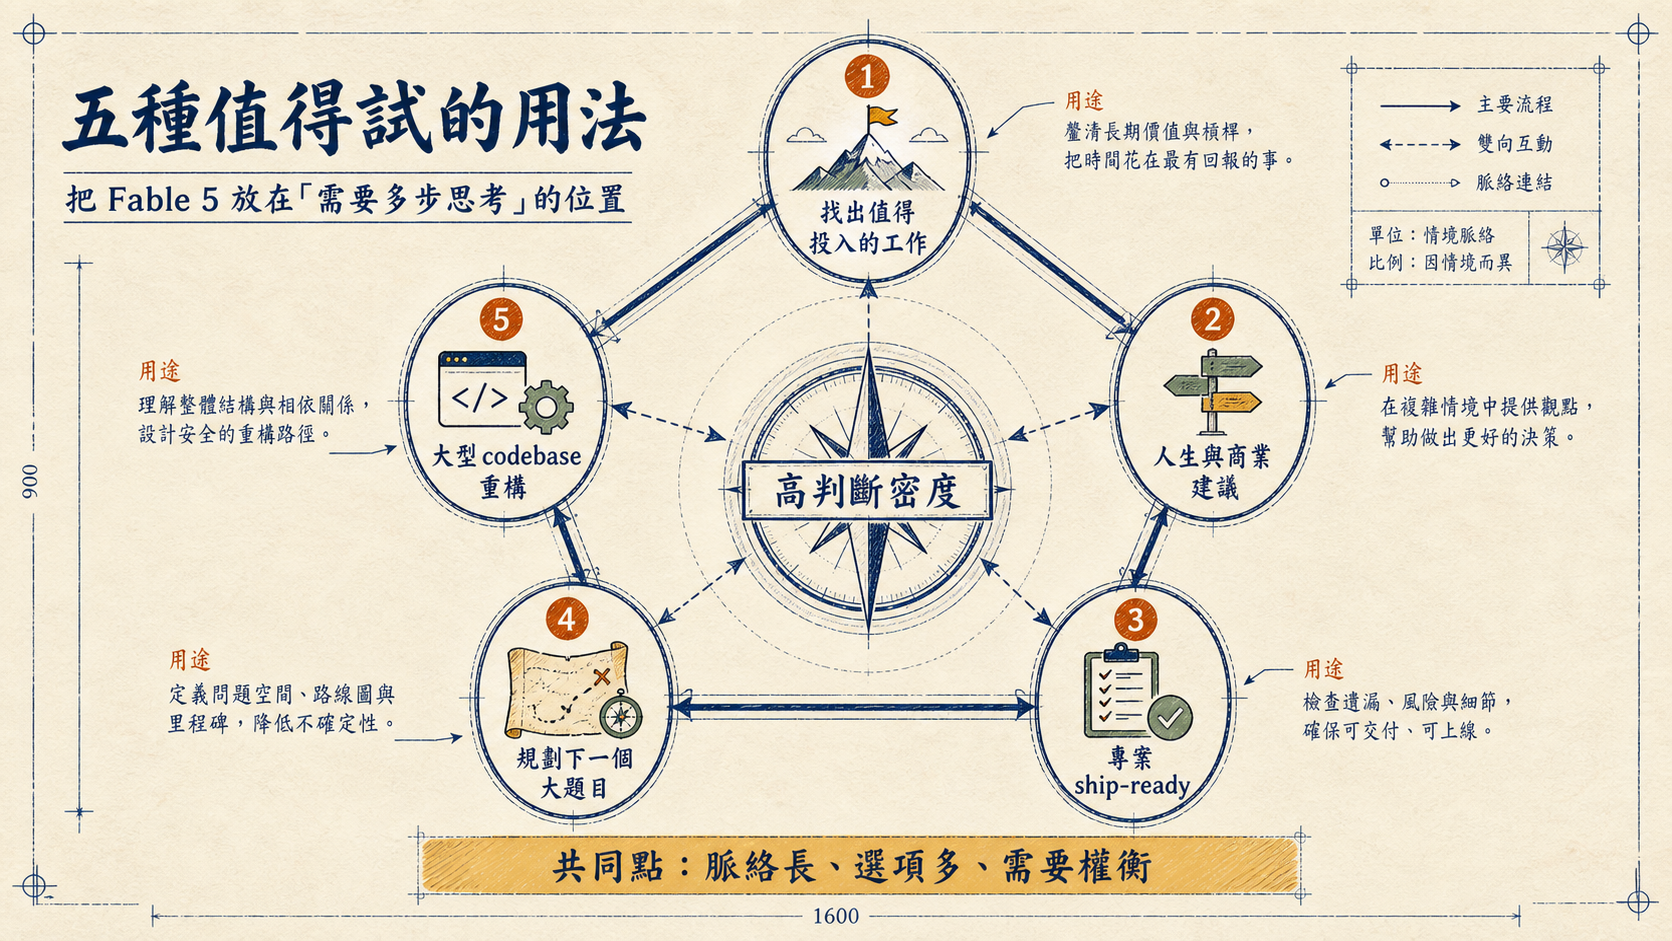
影片列出五個 use cases:找出值得交給 Fable 的工作、取得人生與商業建議、把專案整理到可上線、規劃下一個大題目,以及重構大型 codebase。表面上這是工具教學,底層其實是一套「高判斷密度任務」的分流規則。低價模型和一般 agent 可以負責準備材料、收集上下文、做初稿;高價推理模型應該被放在選項多、牽涉長期決策、需要跨資料整合,而且錯誤代價相對高的位置。
這也是這支影片最值得魚塘讀者帶走的地方。不要把「用最強模型」理解成每件事都開最高檔,而是把它當成一個稀缺資源:你要先定義值得投入的任務,準備好上下文,控制迴圈,再把它用在少數真正能放大判斷力的地方。
021. 找出 Fable-worthy work|先問模型自己能幫你做什麼
第一個 use case 有點反直覺:不是直接叫 Fable 工作,而是叫它先讀你的記憶、檔案、資料和現有系統,幫你找出「哪些工作值得交給它」。Peter 的說法是,如果 Claude 已經累積很多關於你的上下文,那它可以從大量資訊裡抽取洞察,進一步建議下一步行動。
這個方法的價值不在於模型比你更懂人生,而在於它可以把分散在不同地方的 pending work 重新排序。人常常知道自己有很多事要做,卻不知道哪一件卡住了最大槓桿;也常常把高推理模型浪費在「眼前看得到的小任務」上,而不是讓它掃描整個工作面,找出真正值得花 token 的問題。
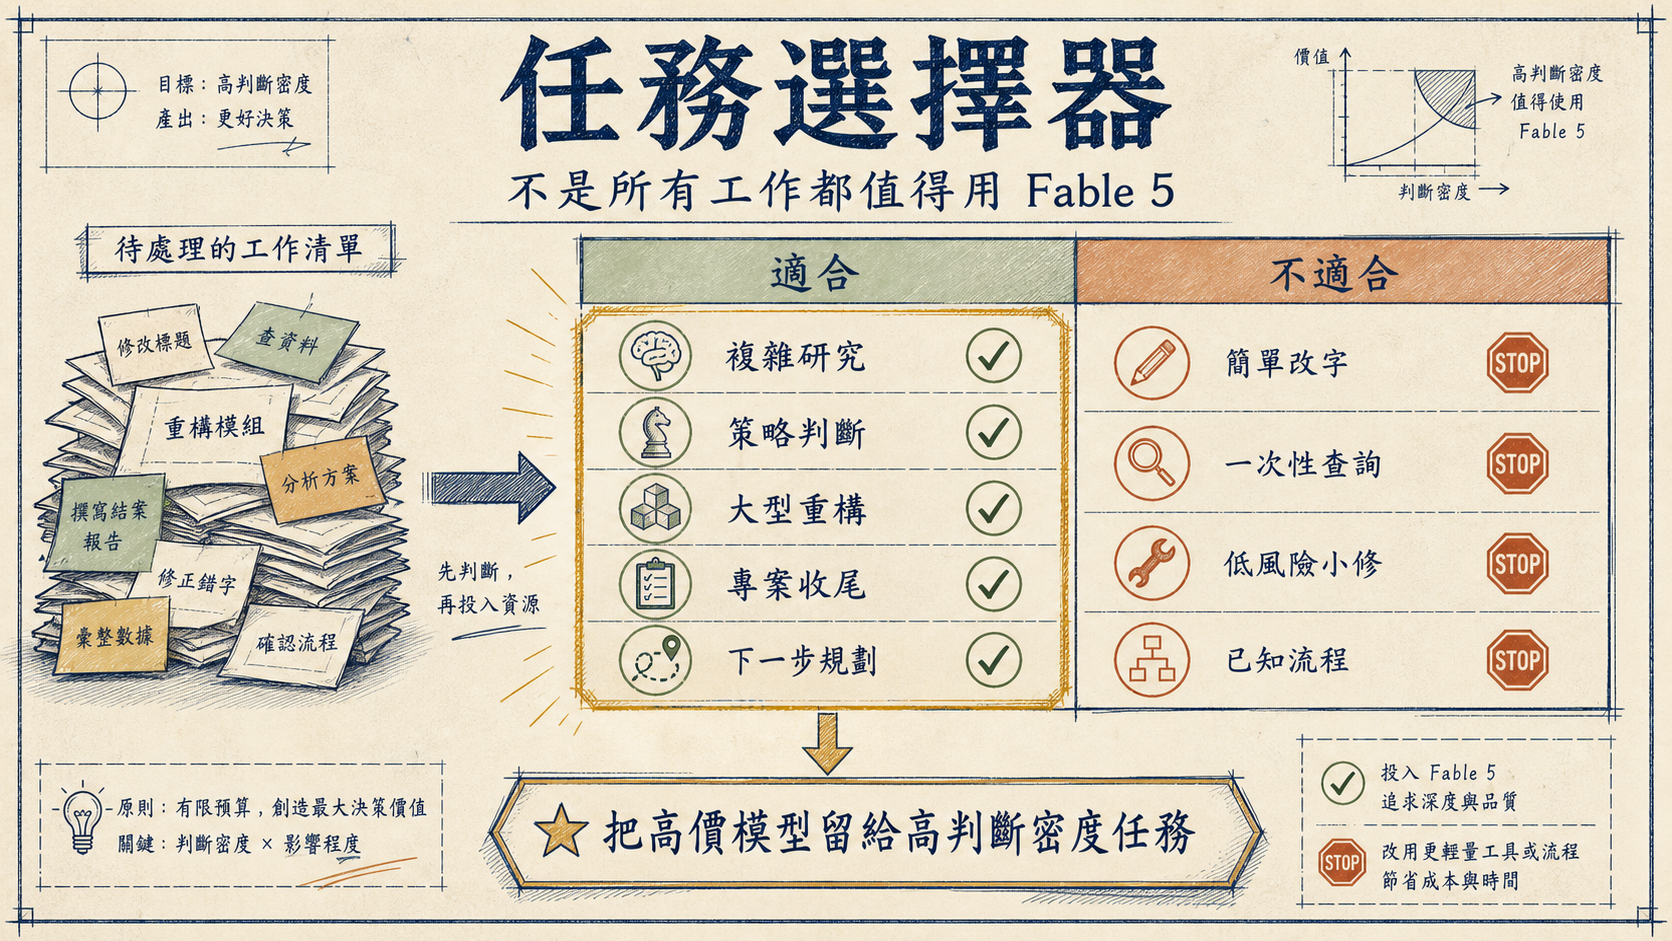
不過這一步有一個前提:上下文要夠乾淨。若你讓模型讀一堆過期文件、半成品想法和沒有標籤的素材,它也只會產生一份看似完整、其實混亂的建議清單。比較好的做法,是先用便宜模型整理資料,移除過期項目,標示正在進行、暫停、放棄和待決策的狀態,再請 Fable 找高價值切入點。
因此,第一個 use case 可以被改寫成一個 workflow:便宜模型整理資料,Fable 判斷優先順序,人類決定是否執行。這讓高推理模型扮演 portfolio reviewer,而不是瑣事代辦。
032. 人生與商業建議|不是算命,而是對長期計畫做 stress test
第二個 use case 是請 Fable 給人生與商業建議。這種說法容易讓人反感,因為它聽起來像把判斷外包給模型。但影片裡比較具體的做法是:先準備一份 plan document,放進個人或事業現況、目標、限制、資料來源和想檢查的問題,再讓模型做長期建議。
這裡的關鍵不是「AI 比你知道人生答案」,而是「它可以用另一套視角 stress test 你的計畫」。你可以要求它找盲點、指出矛盾、提出替代路徑、估算風險,或把你的選項拆成 3 個月、6 個月、12 個月的不同後果。Peter 在影片中說,這類建議可能影響接下來三個月、六個月,甚至一年的行動,因此他認為是最高槓桿的活動之一。
這句話需要加上編輯距離。長期建議的價值不是模型說了算,而是它能把你已經知道、但沒有好好排列的資訊攤開。尤其是創業、職涯和產品方向,真正難的通常不是「缺一個答案」,而是每個答案都有代價。好的模型輸出應該讓代價更清楚,而不是替你取消代價。
如果要把這個 use case 用得穩,prompt 不應該只寫「給我建議」。比較好的格式是:這是我的現況、這是我目前的假設、這是我不想犧牲的東西、這是我能承受的風險、這是我已經試過的路徑;請你從反方、投資人、客戶、未來的我四個角度挑戰它。如此模型比較像董事會裡的一席,而不是神諭。
043. 專案 ship-ready|最後 20% 通常不是寫功能,而是把未知變少
第三個 use case 是把專案整理到可上線。Peter 用自己的 vibe-coded fitness app 當例子,讓 Fable 檢查問題、找 bug、補 launch 前的缺口。他的結論是,這可能是高價模型最值得做的事情之一,因為它能在發布前找出很多容易被忽略的問題。
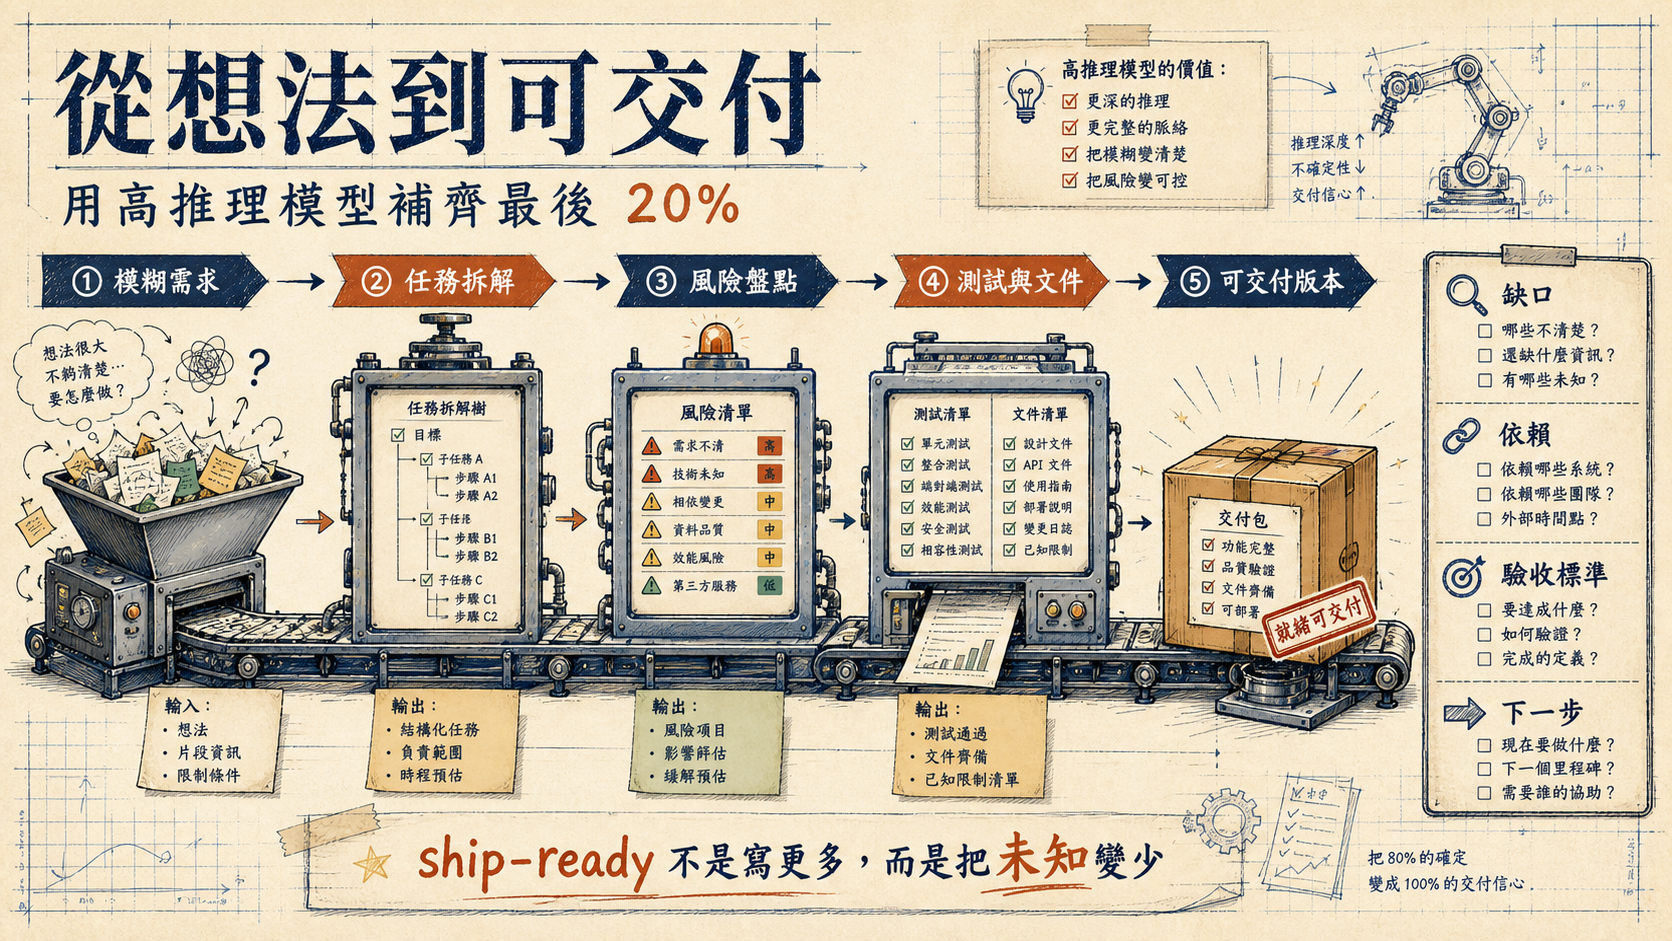
這點很實用。許多 AI-assisted project 最麻煩的地方不是 demo 做不出來,而是 demo 到 production 之間有一段沒有被命名的灰區:錯誤處理不完整、空狀態沒設計、資料 schema 沒鎖、權限邊界不清楚、測試沒有覆蓋真正的使用路徑、文件只寫了 happy path。這些不是最有成就感的工作,卻是決定能不能交付的工作。
高推理模型適合放在這裡,因為它可以同時讀需求、程式、issue、測試和使用者流程,提出一份 launch readiness checklist。更重要的是,它可以把模糊的「差不多好了」拆成可驗收的項目:哪些 bug 必修、哪些體驗問題可延後、哪些安全問題不能上線、哪些資料 migration 需要 rollback plan。
但這裡也有風險。若你讓模型直接「幫我修到能上線」,它可能會用大量局部 patch 把測試跑綠,卻增加系統複雜度。比較好的用法是先讓它產出 audit report,再由人決定修復順序;真正進 code 時,要求每一批改動小而可回滾,並保留清楚 diff。ship-ready 的核心不是多寫一堆功能,而是把未知變少。
054. 規劃下一個大題目|讓強模型寫 plan,讓執行模型照 plan 做
第四個 use case 是「planning the next big thing」。Peter 說,他會用 Fable 來規劃大功能,然後把計畫交給 Opus 或 GPT 做實作。這其實是一個很合理的分工:高推理模型負責定義問題、拆解架構、產生 Markdown 或 HTML plan;執行模型負責按步驟落地。
對軟體團隊來說,這比「叫模型直接寫完整功能」更可控。大功能最容易失敗的地方通常在前面:需求不清楚、資料邊界不清楚、狀態模型沒想完、既有系統限制沒有盤點、驗收標準太抽象。若先讓高推理模型做設計文,並要求它列出 assumptions、risks、migration steps、testing strategy 和 open questions,後續執行會穩很多。
這裡也呼應魚塘過去常談的 agent harness 問題。好的 AI workflow 不是單一模型一路跑到底,而是把任務切成不同階段:探索、規劃、執行、檢查、收斂。Fable 這類模型若真的比較擅長深度推理,就應該站在規劃層;而不是拿去做每一個小改字。
實務上,可以把這個 use case 固定成一個模板:請模型先寫 spec,不准改 code;spec 必須包含目標、非目標、現有系統讀後摘要、方案比較、推薦方案、資料模型、API 或 UI 變更、測試計畫、風險、分批實作步驟。等人類確認後,再交給較便宜或較快的模型執行。這會比直接「build this」少很多返工。
065. 大型 codebase 重構|先畫地圖,再動刀
最後一個 use case 是重構大型 codebase。Peter 在影片中提到一個說法:Stripe 用 Fable 重構 5,000 萬行 Ruby code,並在一天內完成 migration。這裡同樣需要歸屬語氣,因為這是影片引用的案例,不是本文獨立查證的事實。但它指向的問題很清楚:大型 codebase 的困難不只是改幾行,而是理解依賴、邊界和安全路徑。
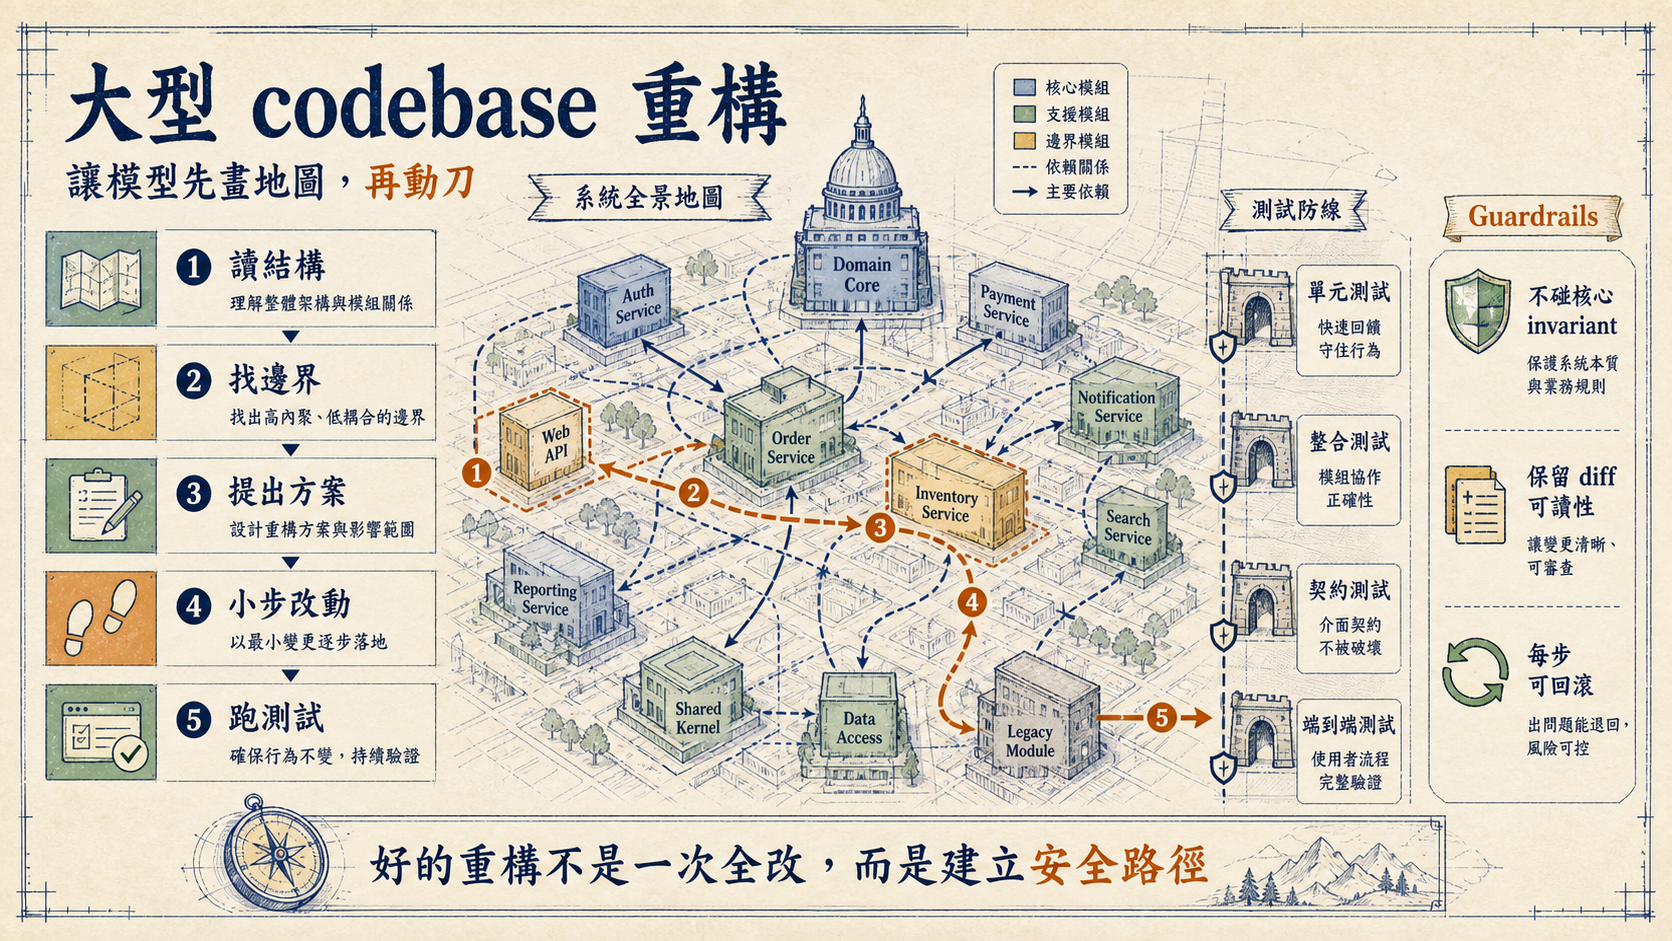
高推理模型在這裡的合理位置,仍然不是「一次全改」。更穩的方式是先叫它讀 codebase,畫出模組地圖、資料流、外部依賴和測試缺口;再提出分階段重構計畫,標出每一步的風險和 rollback 方式。只有在這張地圖足夠清楚後,才開始讓 agent 做小批次改動。
這對個人工作也有用。影片最後提到,個人不一定有大型 codebase,但可能有自己的 personal OS、skills、文件系統或一堆自動化腳本。這些東西也會累積技術債,只是規模比較小。高推理模型可以幫你找重複流程、壞掉的 skill、過期文件、命名不一致和缺少測試的自動化。
真正要守住的是 guardrails。第一,不碰核心 invariant,除非它先能用文字解釋 invariant 是什麼。第二,每一步都要能用測試、型別或人工檢查驗收。第三,diff 要保持可讀,不要把重構、格式化和功能修正混在一起。第四,模型提出的「更一般化抽象」要特別審慎,因為大型重構最常失控的地方,就是為了處理未來可能性而引入今天不需要的複雜度。
076. 三個使用原則|準備、限時、保留判斷
影片最後給了三個 tips。第一,用便宜模型先準備。也就是用 Opus、GPT 或其他較便宜的模型整理 plan document、接好 API/MCP、準備上下文,再把整理好的材料交給 Fable。這能避免高價模型把額度花在資料清洗和基本脈絡補齊。
第二,不要讓它無限制 loop。Peter 特別提醒,token 很有限,不要讓模型一直迴圈燒額度。這點對 coding agent 特別重要:一旦任務定義不清楚,agent 會很努力地試、修、再試,但不一定朝正確方向前進。高推理模型應該有明確任務、明確驗收標準和明確停止條件。
第三,用它在真正能改變方向的地方。影片五個 use cases 的共同點,不是「看起來很酷」,而是都需要長上下文與多步權衡:找高價值工作、檢查長期計畫、讓專案可交付、規劃大功能、重構複雜系統。這些任務不一定每天發生,但一旦做對,後續影響很大。
所以這支影片的導讀結論可以很簡單:不要把最強模型當成日常打字機。把它當成一個稀缺的判斷資源,先準備材料,再問困難問題,最後由人類保留取捨權。模型可以擴大你的搜尋和推理,但不應該替你取消責任。