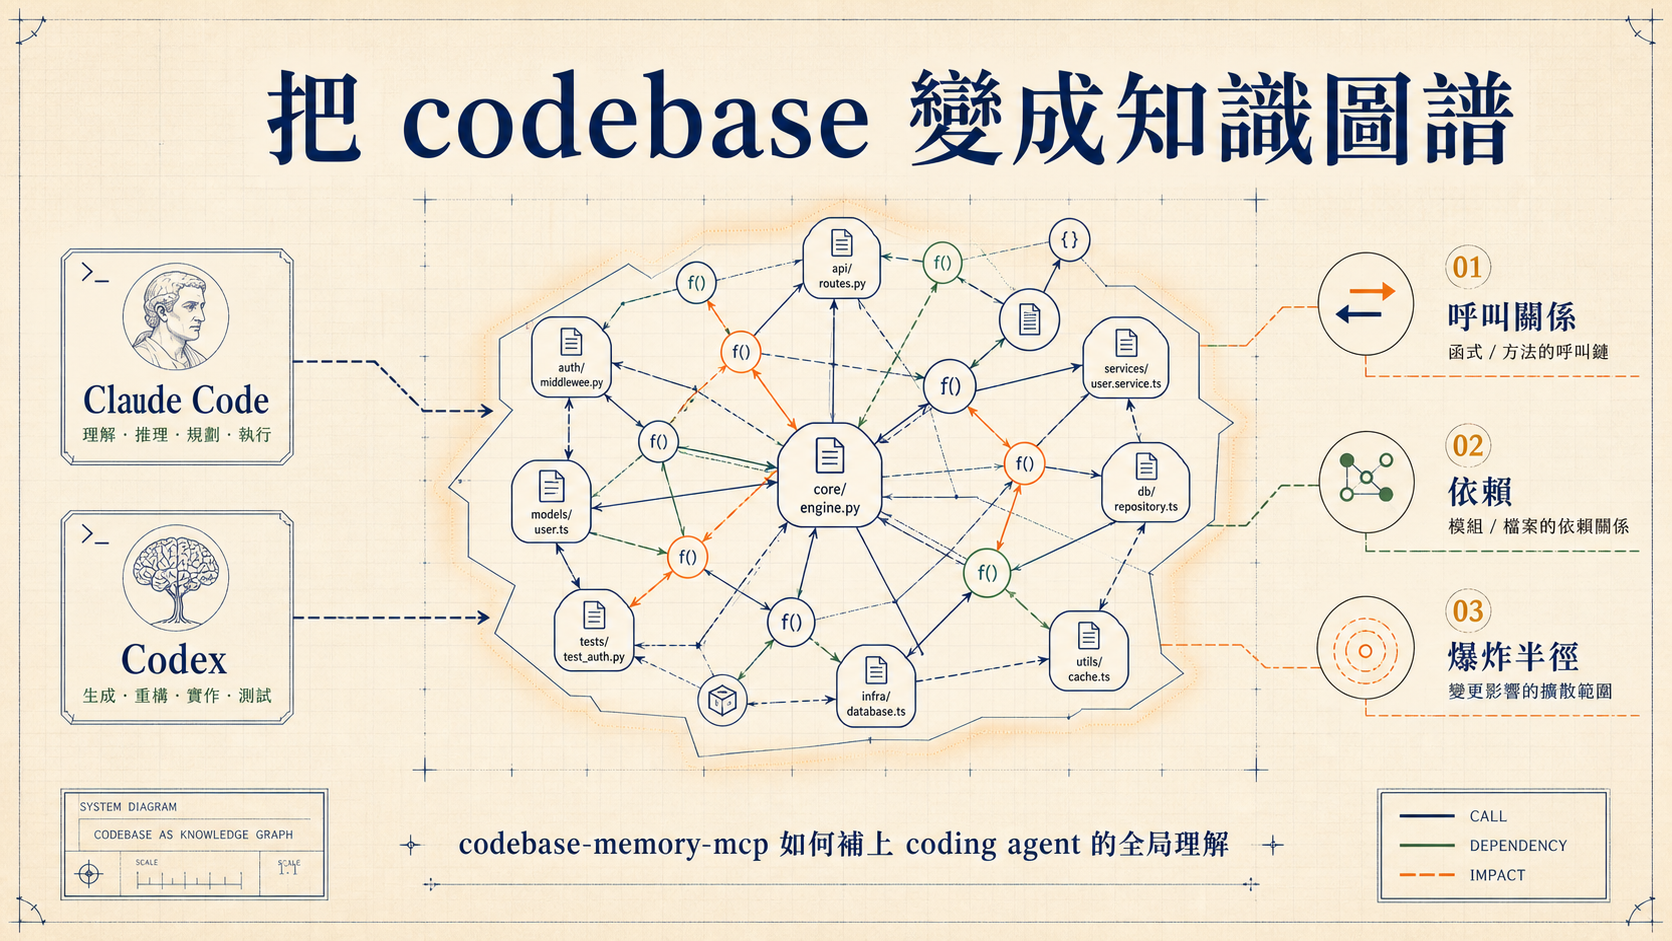
這篇導讀整理自 AI超元域的原始影片。影片主題是 codebase-memory-mcp:一個透過 MCP 把程式碼庫索引成知識圖譜,讓 Claude Code、Codex、Cursor 這類 coding agent 更容易理解大型專案的工具。
這支影片最值得看的一點,不是單純宣稱某個工具「超越」另一個工具,而是它點出 AI coding 正在遇到的下一個瓶頸:模型已經會讀檔、搜尋、修改、跑測試,但當 codebase 變大,真正困難的是看懂跨檔案關係、影響半徑與可遷移的架構模式。
010. 不是讓模型更聰明|而是給 agent 一張可查的 codebase 地圖
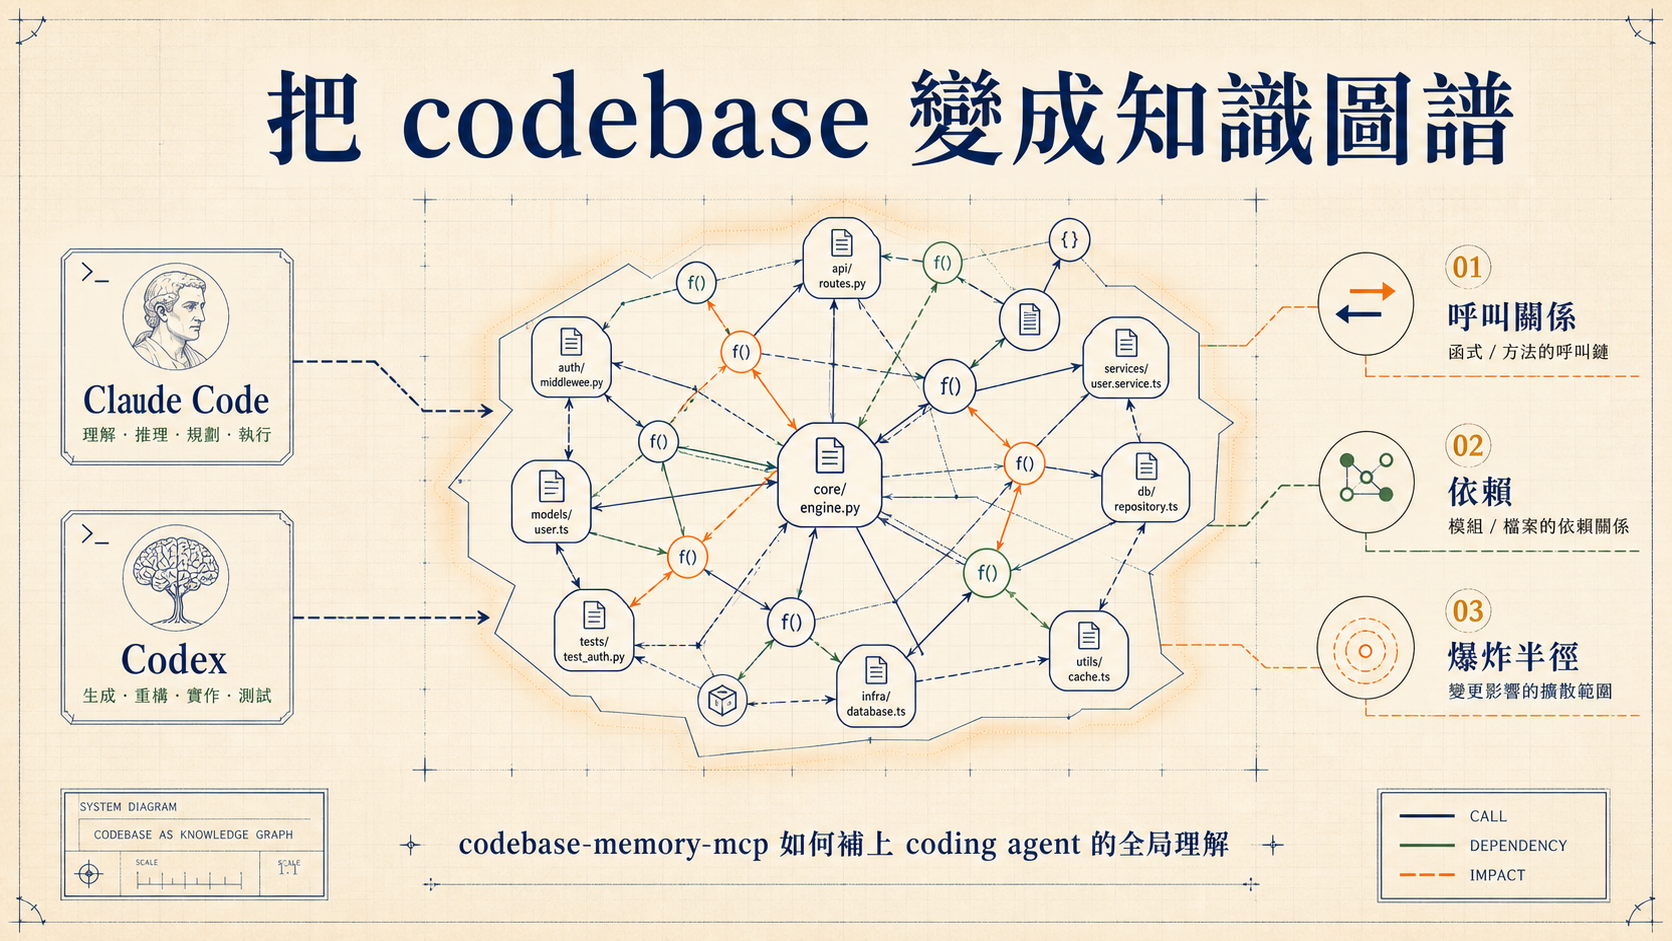
影片一開始先把 codebase-memory-mcp 放在 GitNexus、Graphify、CodeGraph 這類工具的脈絡裡:它們都試圖把程式碼庫從「一堆檔案」轉成「一張可探索的圖」。差別在於,codebase-memory-mcp 透過 MCP 介面,把這張圖直接交給 Claude Code、Codex 等 agent 使用。
這裡的核心不是視覺化本身。漂亮的 3D 節點圖容易讓人以為重點是展示,但對 coding agent 來說,真正有價值的是圖背後的結構化關係:哪個函式呼叫哪個函式、哪個模組依賴哪個模組、某次修改可能擴散到哪些路徑、哪些節點是高耦合熱點。
一般 agent 在陌生專案裡工作時,常靠 grep、檔名搜尋、語意搜尋和局部閱讀建立理解。這些方法有用,但它們天然偏向「找到相關片段」。知識圖譜的企圖則是把片段之間的邊也保存下來,讓 agent 不只知道「這段程式碼在哪裡」,還能追問「它和其他地方怎麼連」。
講者特別強調 codebase-memory-mcp 是純 C 編寫、零依賴、單檔案二進位。這種設計若如影片所述,對 agent tooling 很實際:工具越容易安裝,越有機會被 Claude Code 或 Codex 在一個新 repo 裡自動配置;工具越少依賴,越不容易因 Node、Python、套件版本或系統環境卡住。
但更重要的是,這類工具把 coding agent 的上下文從「文字片段」推向「可查詢的結構」。模型本身仍然負責判斷與生成;MCP 工具負責把 codebase 以更穩定的格式餵給模型。這不是取代 LLM,而是替 LLM 補上一種它自己不擅長長期維護的外部記憶。
021. 對比 CodeGraph|速度與深度不是同一個指標
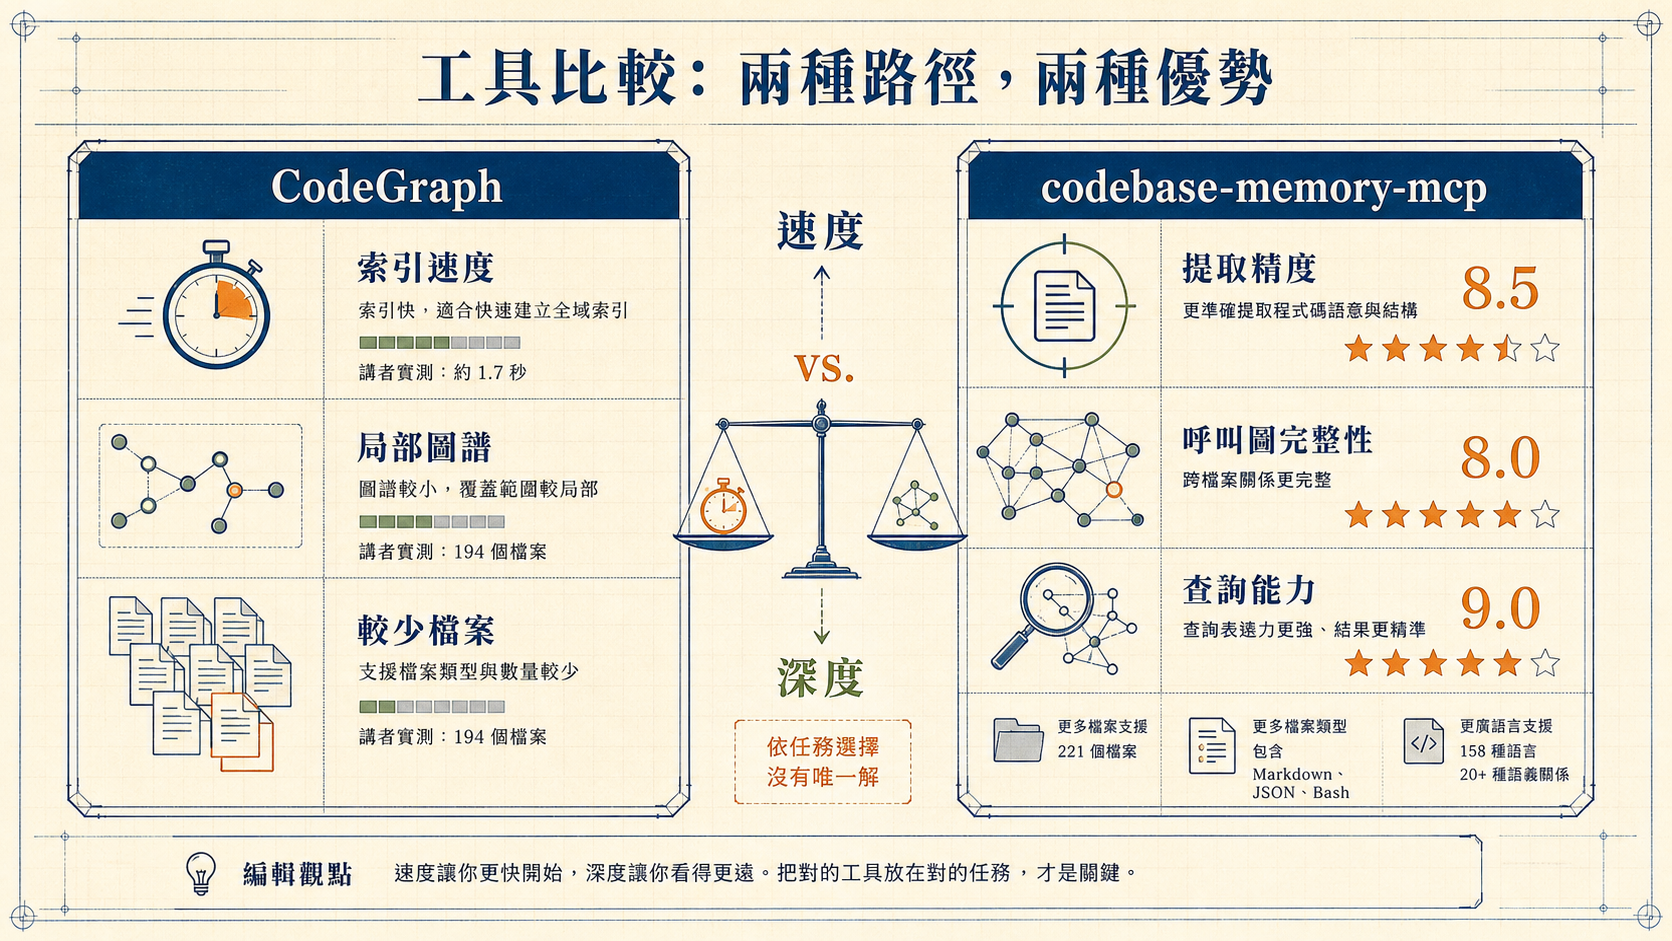
影片中段用一個 OpenClaw 記憶外掛專案做比較,讓 Claude Code 同時使用 CodeGraph 與 codebase-memory-mcp 索引同一個程式碼庫,再要求它用相同符號核對真值,評估提取準確度、呼叫圖完整性、查詢能力與索引速度。
講者展示的結果裡,CodeGraph 索引了 194 個檔案;codebase-memory-mcp 索引了 221 個檔案,還包含 Markdown、JSON、Bash 指令碼等更多檔案類型。索引耗時則反過來:講者表示 CodeGraph 約 1.7 秒完成,codebase-memory-mcp 約 16 秒。
這個差異很適合拿來提醒團隊:速度與深度不是同一個指標。若任務只是快速摸一下檔案分佈,速度快的工具可能更順手;若任務需要跨檔案呼叫圖、依賴、查詢能力與更多語料覆蓋,較慢但資訊更厚的索引可能反而更有用。
影片展示的評分中,codebase-memory-mcp 在提取精度拿到 8.5、呼叫圖完整性 8.0、查詢能力 9.0;CodeGraph 在索引速度拿到 9.5。平均分幾乎持平,只差 0.1。若只看「誰贏」,反而會錯過真正的工程判斷:不同任務需要不同工具輪廓。
講者也列出 codebase-memory-mcp 的強項,包括 openCypher 圖查詢、語義向量搜尋、複雜度與熱點指標、社群聚類、資料流追蹤,以及更精準的真實呼叫圖。這些說法來自影片中的實測展示,讀者若要導入到自己的 repo,仍應重跑一次基準,確認自己的語言、框架、測試檔與 build 系統是否被正確索引。
編輯上要保留一點距離:這不是一篇 peer-reviewed benchmark,也不是多專案、多語言的大規模評測。它更像是一個實務 demo,展示「當 agent 有圖查詢工具時,可以問出哪些原本難問的問題」。這個方向比單次分數更重要。
032. 安裝不是重點|重點是 MCP 讓工具進入 agent 工作流
影片示範安裝方式時,講者做了一個很典型的 agent 操作:直接把 GitHub 倉庫連結交給 Claude Code 或 Codex,要求它閱讀 README,替使用者安裝與配置。這件事看似只是省去手動操作,但其實反映 MCP 工具導入的關鍵。
若工具只能由人手動安裝、手動查詢、再把結果複製貼回對話,它仍然是外部工具;若 agent 能在任務中呼叫它、讀取結果、根據結果決定下一步,它就變成 agent 工作流的一部分。差別不在介面漂亮,而在「模型能不能把它納入推理迴圈」。
這也是為什麼 codebase-memory-mcp 的零依賴單檔案設計值得注意。Coding agent 很擅長照 README 執行命令,但環境越複雜,失敗點越多。對一個希望被 agent 自動配置的工具來說,少依賴不只是部署品味,而是降低 agent 成功率波動的產品策略。
不過,交給 agent 自動安裝仍然需要邊界。README 是外部內容,安裝腳本可能有副作用;MCP server 也可能讀取大量本機程式碼。合理做法是讓 agent 先說明將執行哪些命令、會寫入哪些路徑、會暴露哪些資料,再由人或 policy 決定是否允許。
因此,這支影片可以被讀成一個更大的模式:好的 coding tool 不只是功能強,而是能被 agent 安全、可預期地納入循環。工具越靠近 repo 工作流,越要同時設計安裝路徑、權限邊界與可觀察輸出。
043. 三個實戰場景|陌生專案、PR 影響半徑、死函式
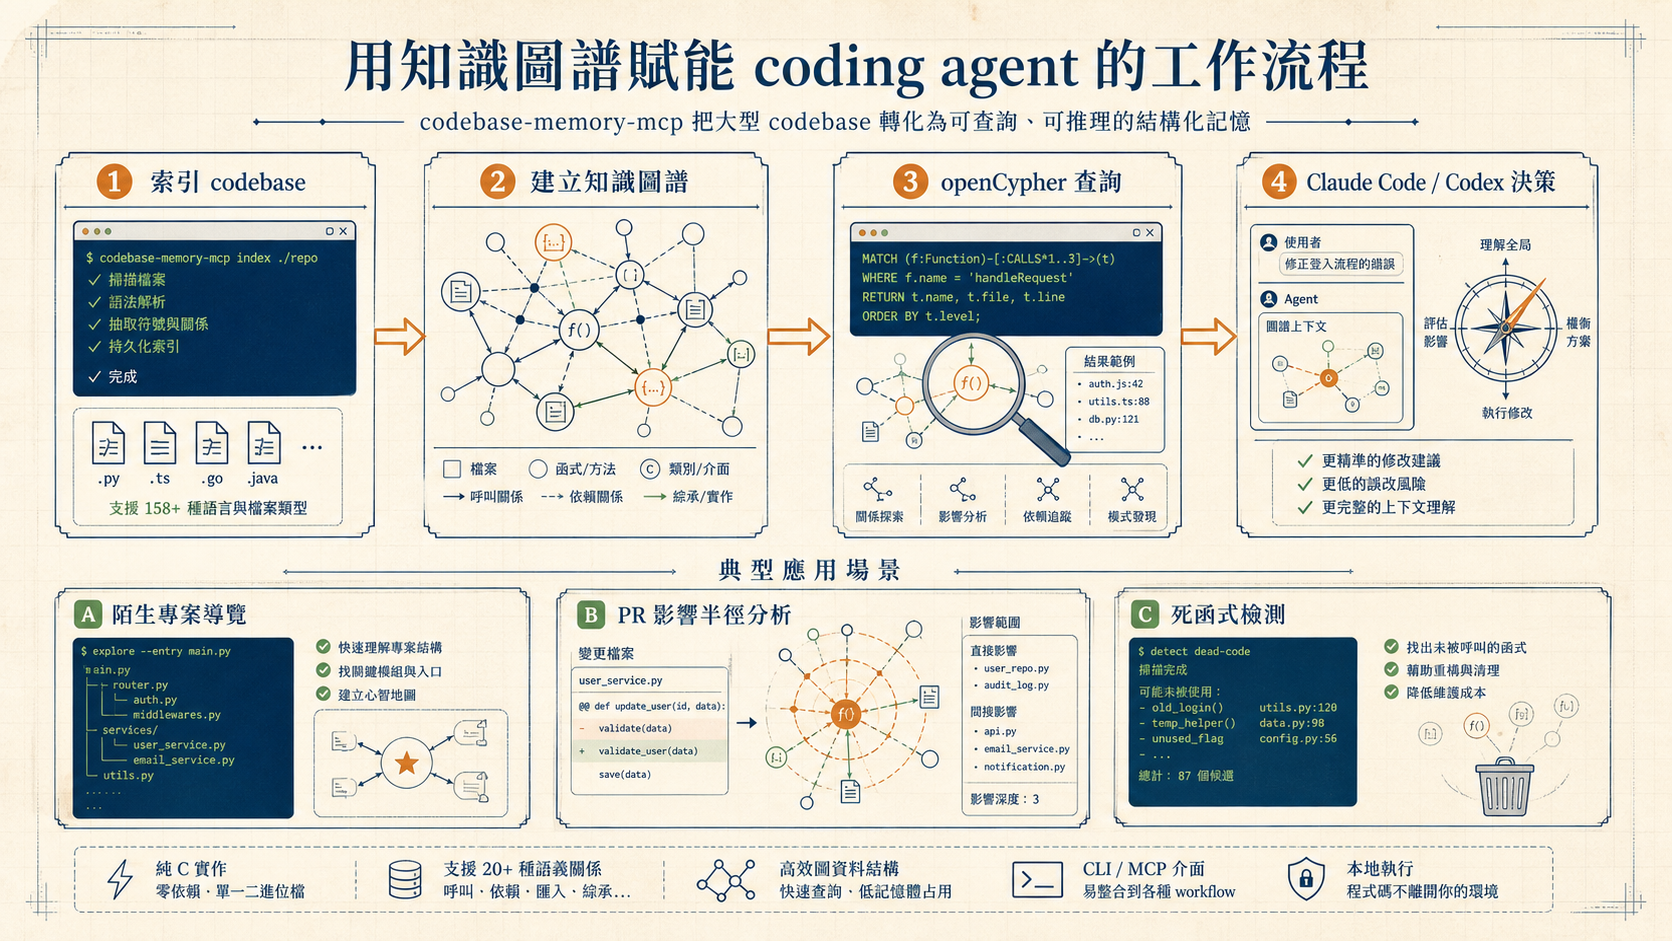
影片後半段轉向更貼近日常工程的場景。第一個是陌生專案導覽。講者讓 Claude Code 使用 codebase-memory-mcp 索引一個開源 AI agent 記憶專案,並要求它快速說明入口、核心模組、分層與主幹資料流。
結果中,agent 找出六個入口,包括 Python code API、HTTP/REST 服務、CLI、MCP、Serverless 入口與 DB worker 子程序入口;接著整理出介面層、領域層、任務層、基礎設施層等分層。這類回答過去也能靠人工閱讀得到,但圖譜工具的價值在於讓 agent 更快沿著入口與依賴往下追,而不是只靠檔名猜架構。
第二個場景是 PR 影響半徑。講者選了一個 PR,要求 agent 分析被改函式的影響範圍,並檢查修改是否收斂。影片展示的結論是「修復正確、測試到位、範圍收斂」。這類任務非常適合圖譜:review 不只看 diff,也要看 diff 連到哪些使用者、哪些測試、哪些下游模組。
第三個場景是死函式檢測。講者要求 agent 找出可以安全刪除的無用程式碼,工具輸出函式名稱、所在位置與備註。這裡也要小心:沒有工具能保證「沒被圖譜找到」就等於安全刪除,尤其動態語言、反射、外部 plugin、字串呼叫和 runtime registration 都可能讓靜態圖漏邊。比較穩的用法是把它當成候選清單,再配合測試、搜尋與人工 review。
這三個場景共同指向一件事:知識圖譜不只是 onboarding 文件,也可以變成 review 和重構前的風險雷達。它不能替人做最後判斷,但能讓 agent 在提出建議前看見更大的半徑。
054. GraphRAG 遷移|圖譜能找出「可移植的結構」
影片最後一段展示更進階的任務:讓 agent 從一個專案中抽取最有價值、可移植到 OpenClaw 記憶外掛的功能。codebase-memory-mcp 協助 agent 找到幾項候選,其中講者特別指出 GraphRAG 是最具價值的功能。
接著,講者要求 Claude Code 基於兩邊結構,給出把 GraphRAG 從來源專案遷移到目標專案的方案:哪些核心邏輯可以一比一重寫、哪些 Python 特有依賴要轉成 TypeScript 等價物、新程式碼應放在哪裡、要新增或改動哪些檔案,以及落地順序。
這個案例比「找呼叫關係」更值得玩味。它把 codebase 圖譜從查詢工具推進到設計輔助:不是只問「A 呼叫 B 嗎」,而是問「這個能力在來源專案中由哪些模組組成?哪些結構可抽象?搬到另一個語言與框架時,哪些地方是概念等價,哪些地方必須重寫?」
當然,影片中的輸出仍是方案,不是完成的移植。GraphRAG 牽涉資料模型、向量搜尋、chunking、圖查詢、召回排序、儲存層與測試策略;agent 可以用圖譜輔助理解,但真正落地仍要回到目標 repo 的介面、效能、資料一致性與失敗模式。
這也形成本文最重要的界線:圖譜不是替你改完程式,而是把可移植的結構找出來。它縮短的是理解與規劃距離,不是消除工程驗證。
065. 對團隊的啟發|把 codebase context 變成可治理資產
如果把這支影片放進 2026 年的 AI coding 脈絡,它其實在回答一個團隊問題:當每個人都有 Claude Code、Codex 或 Cursor,下一個差異化槓桿是什麼?
一個答案是模型;更強的模型當然重要。另一個答案是工具與上下文。大型團隊真正珍貴的知識,往往藏在 codebase 裡:歷史包袱、隱性入口、舊模組的耦合、測試覆蓋缺口、哪些檔案牽一髮動全身、哪些功能看似獨立其實共享狀態。若這些資訊只能靠資深工程師口耳相傳,agent 也只能在表層工作。
codebase-memory-mcp 這類工具的方向,是把 codebase context 變成可查、可重建、可納入工具呼叫的資產。它不只是給新人看,也能服務 PR review、重構評估、incident root cause、跨專案移植與架構盤點。
但這也帶來治理問題。索引結果是否過期?圖譜何時重建?哪些路徑不該被索引?工具是否會把私有程式碼送到外部?agent 根據圖譜做出的結論是否要留下查詢與證據?如果團隊要把這類工具放進日常流程,這些問題要和功能一起設計。
因此,合理的導入順序不是立刻讓 agent 自動重構大型模組,而是先把它放在低風險任務:陌生 repo 導覽、PR 影響半徑草稿、死碼候選清單、架構地圖生成。等工具在自己的 codebase 上表現穩定,再逐步接到更高風險的修改流程。
076. 結論|AI coding 的下一步,是讓 agent 看見關係
這支影片的價值,在於它把 AI coding 的焦點從「模型會不會寫 code」拉到「agent 看不看得見 codebase 關係」。當任務很小,讀幾個檔案就夠;當任務跨模組、跨語言、跨服務,模型需要的是更穩定的外部結構。
codebase-memory-mcp 代表的正是這條路:用 MCP 把知識圖譜交給 agent,讓它能查呼叫、查依賴、估影響、找入口、做遷移方案。它不是萬能,也不該被單次 demo 的分數神化;但它很清楚地指出,未來的 coding agent 不會只靠更長 context window,而會越來越依賴可查詢、可驗證、可治理的 repo memory。
對工程團隊來說,最務實的 takeaway 是:別只問「哪個 AI 最會寫程式」,也要問「我們的 codebase 有沒有被整理成 agent 能可靠使用的形狀」。當 agent 能看見關係,它才比較可能在大型專案裡做出接近工程師的判斷。