010. 導言|誰比較快,要先問你在等哪一段
「哪一臺比較快,要看你在等的是哪一段。」——應援快門
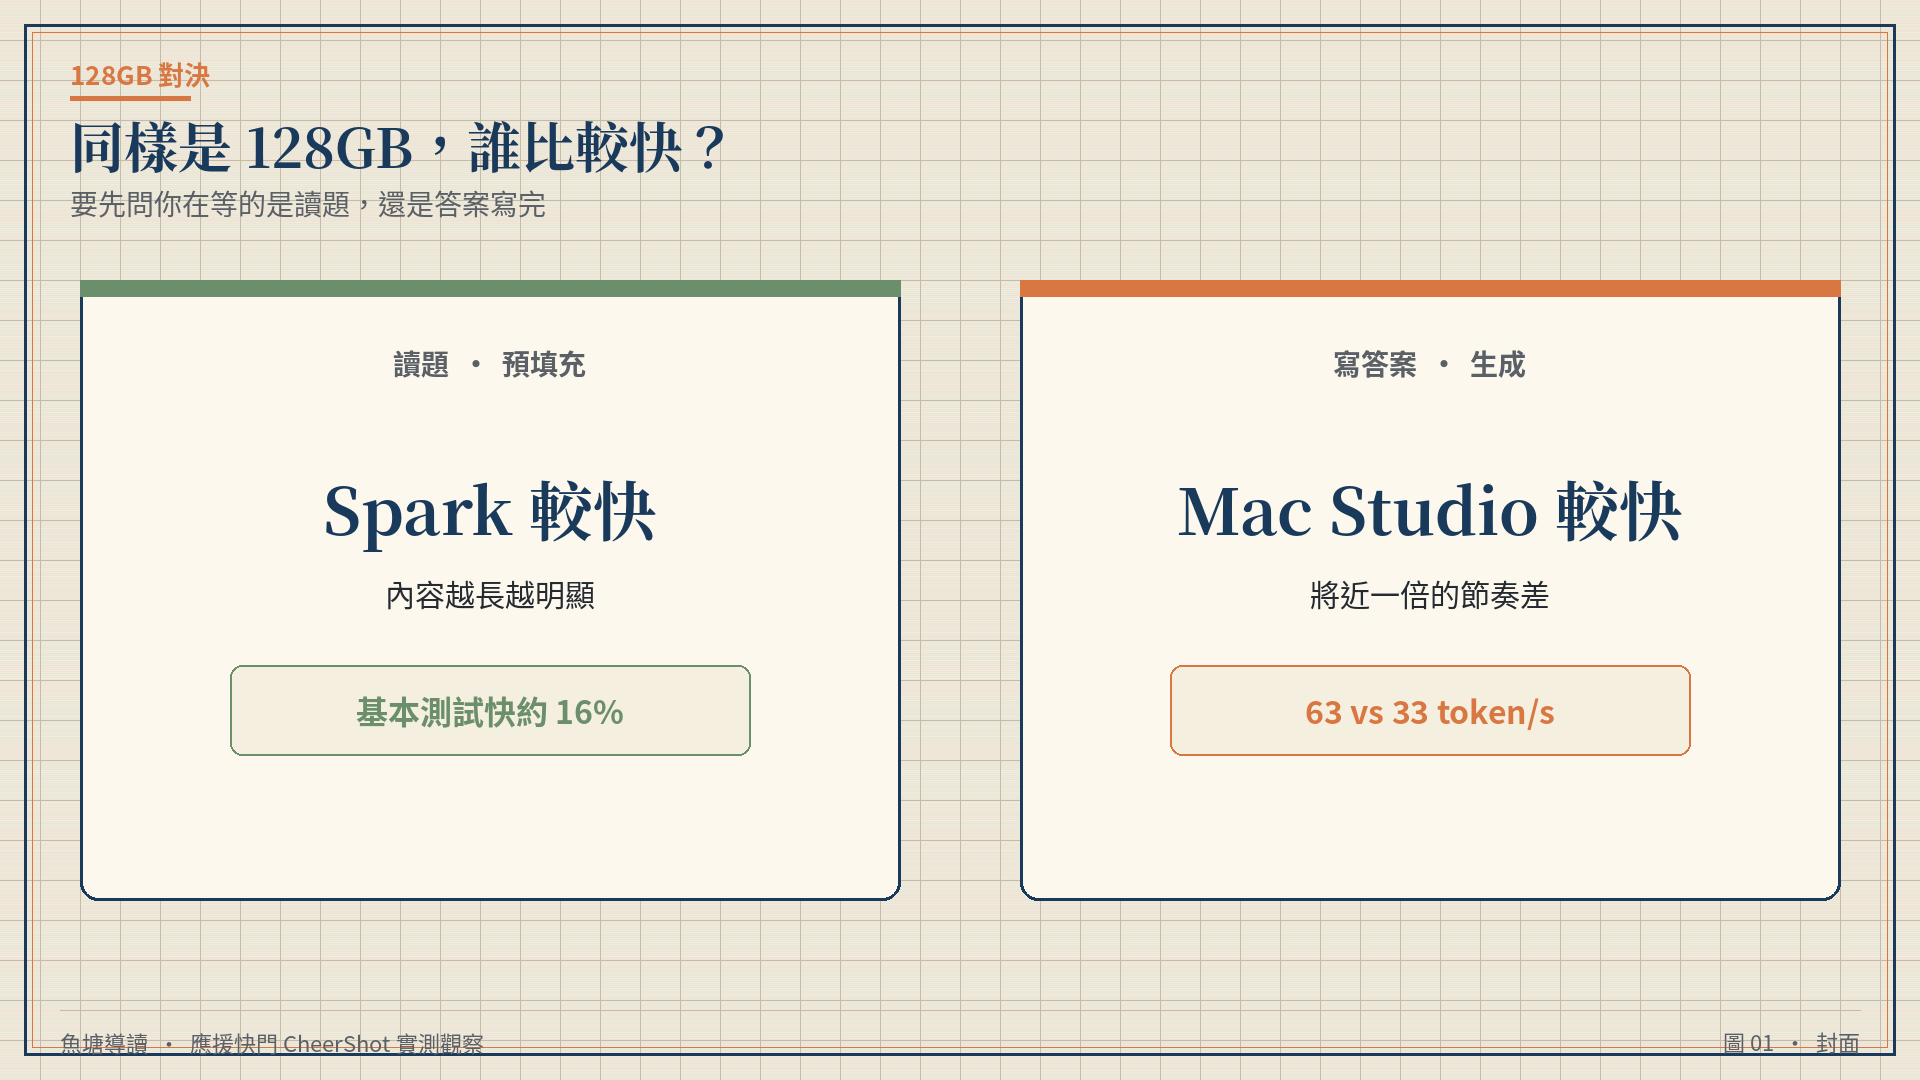
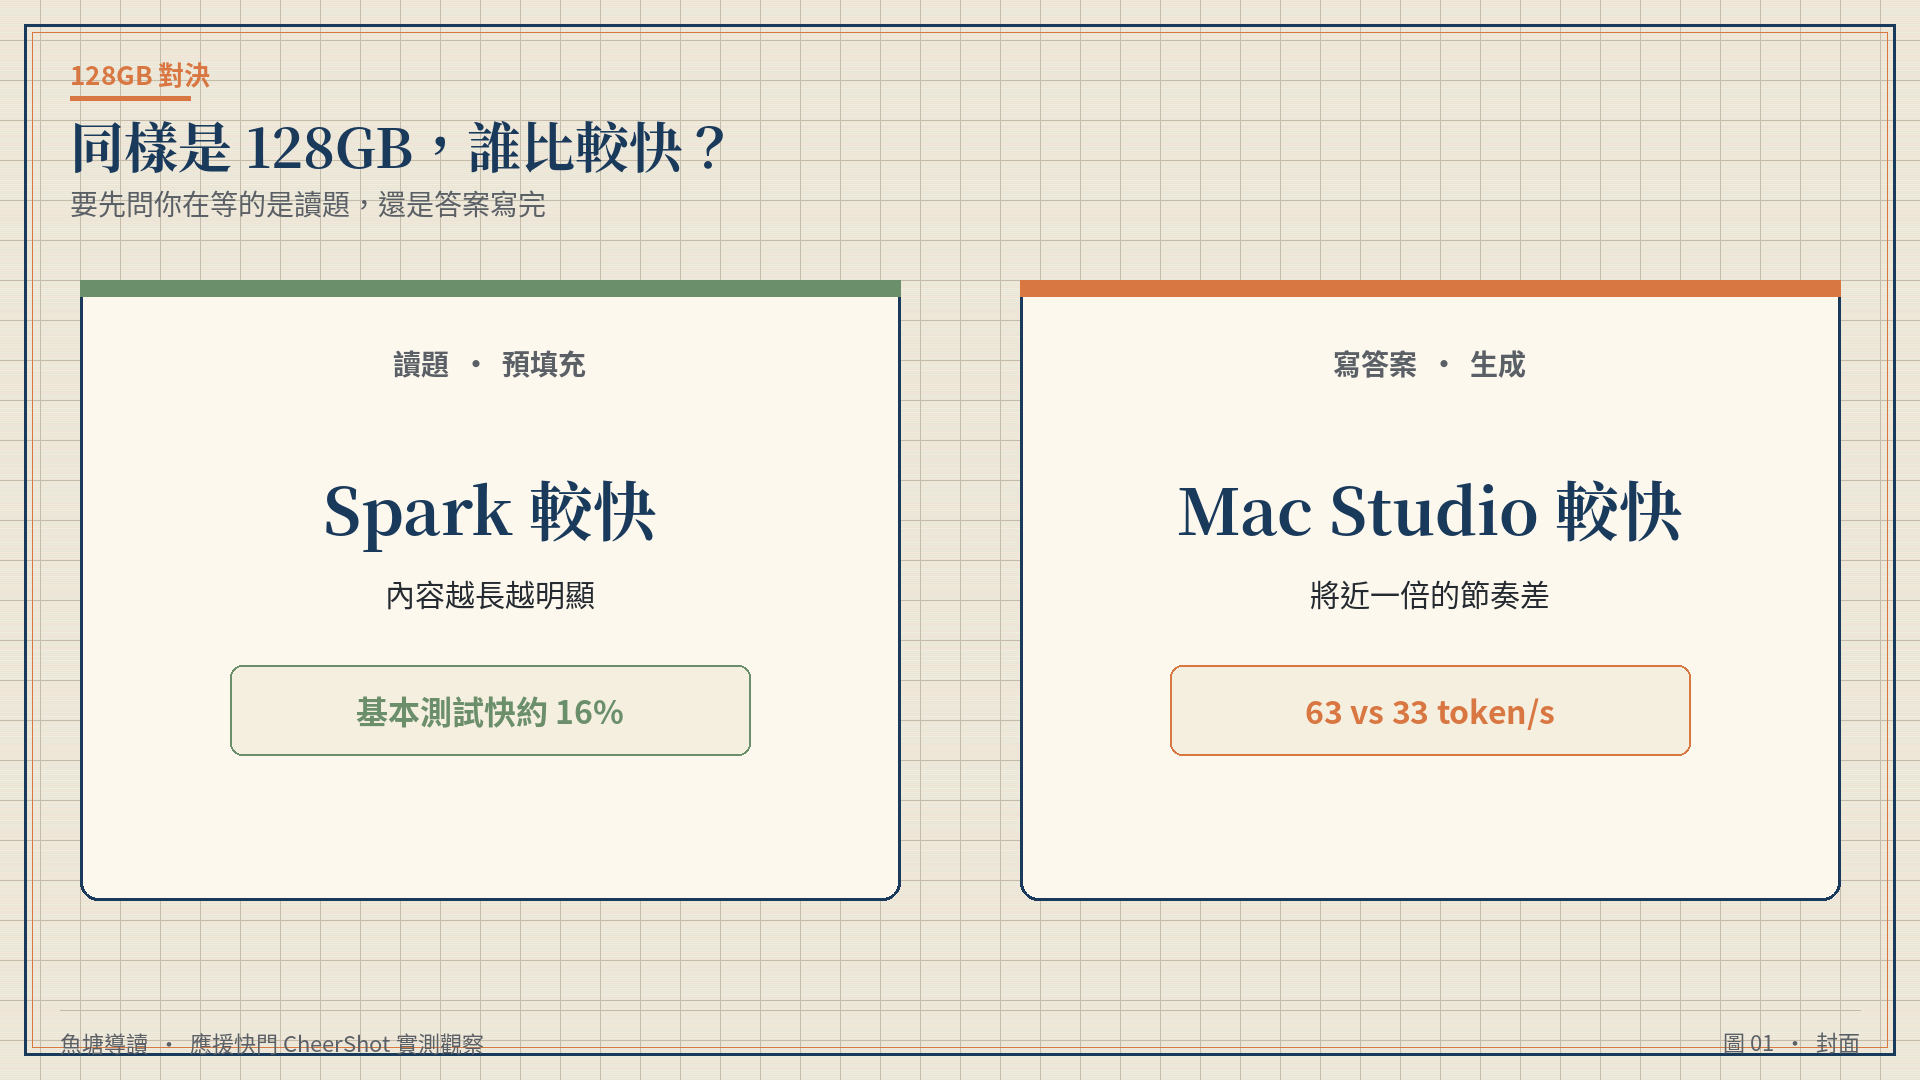
同樣是 128GB 記憶體,價錢只差一萬多元的兩臺桌上型 AI 電腦,哪一臺跑起來比較快?應援快門 CheerShot 這支約 15 分鐘 的影片,一開頭先把觀眾按進這個看似單選的題目,接著立刻把答案拆開:把同一個模型交給兩臺機器,其中一臺寫答案的速度幾乎是另一臺的兩倍;可是換成丟進一份很長的檔案,先開始吐出第一個字的,卻是另一臺。
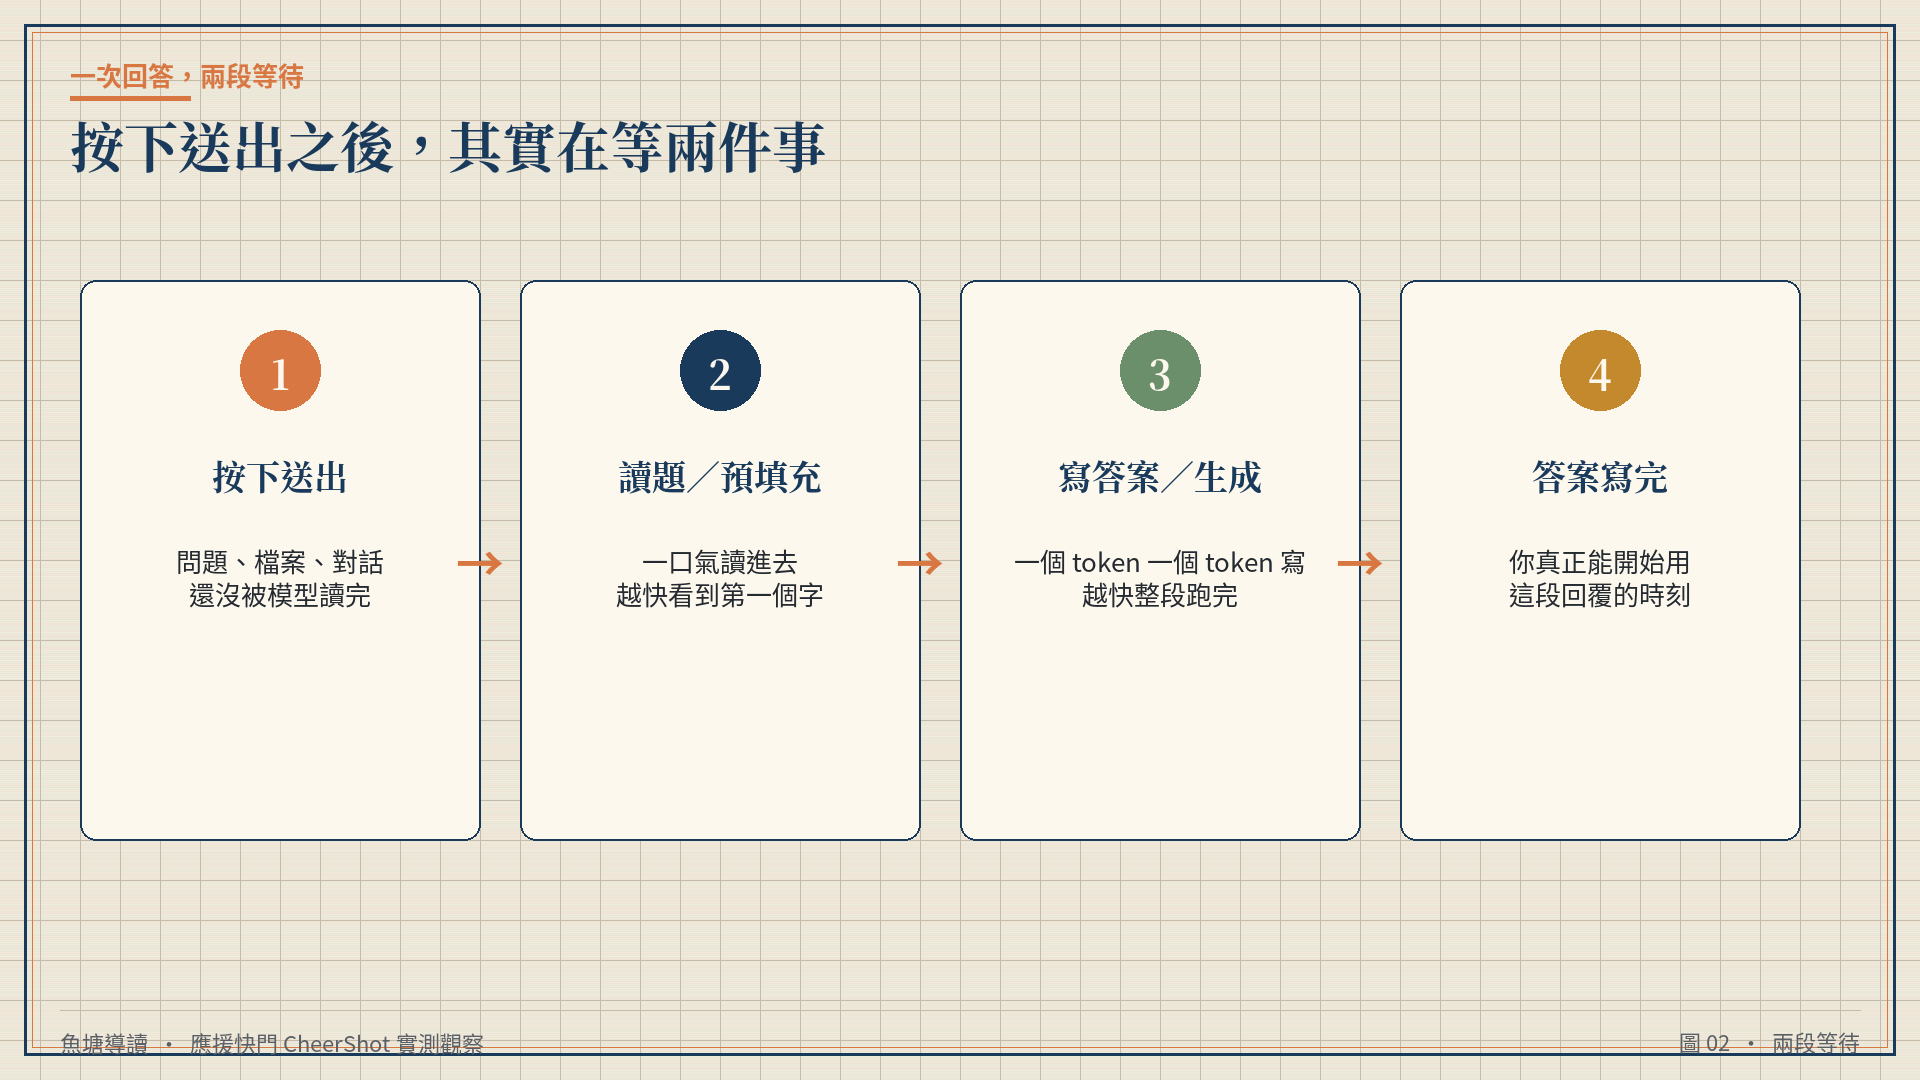
這不是修辭上的轉折,而是整篇測試的方法論。講者把一次 AI 回答切開成兩段等待:按下送出、答案還沒出現之前,模型要先「讀題」;之後才一個 token、一個 token 把答案寫出來。誰比較快,取決於你每天真正在等的是哪一段。
影片的起點,是上一支 128GB 實測上架後的留言,希望 Mac Studio 也加入評測。於是這一支把 NVIDIA 的 DGX Spark,和 Apple 的 Mac Studio 放在一起比。講者自介為應援快門:假日在球場捕捉應援畫面,平日是生成式 AI 應用工程師,負責把相關技術匯入企業 IT 系統。這個位置很重要——影片不是實驗室論文,而是一個經常要把模型放進實際工作流的人,用自己的語言做對照觀察。
兩臺機器有一個共同點:CPU 和 GPU 整合在同一個晶片封裝裡,共用同一塊記憶體。講者特別劃清界線,RTX Pro 6000、RTX 5090、L40S 這類獨立顯示卡,之後會另外做一支來比較。也就是說,本文處理的是「統一記憶體的小型桌上型」,不是高階獨立 GPU 工作站。
本文來源為應援快門 YouTube 影片〈DGX Spark vs Mac Studio:同樣 128GB,讀題和寫答案誰比較快?〉,原始連結:https://youtu.be/mBmzghZqs3E 。文中速度、功耗與報價,主要來自影片中的自述與畫面測試;串接規格則是講者引用的官方資料,且講者明說兩種裝置手上各只有一臺。因此這些數字不應被寫成可直接下單的通用基準,而是一組「特定模型、特定引擎、特定兩臺機器」上的觀察。
還有幾條需要先放在桌上的界線。受測的華碩 Ascent GX10 是 2TB 儲存版本,但後面引用的 PChome 標價是 128GB/1TB 配置;Mac Studio 是朋友的機器,搭載 M5 Max、40 核 GPU 與 128GB 統一記憶體。測試模型與上一支 128GB 實測相同。影片畫面與口播都寫明是 Google Gemma 4 12B,標示 120 億參數、4 位元量化(QAT);這與 Google 官方模型卡的 Gemma 4 12B Unified(總參數 11.95B,對外稱為 12B)以及官方釋出的 4-bit QAT 權重相符。先前逐字稿把「一百二十億/12B」誤聽成「121 參數」,已更正。詳細版本與設定,講者放在影片說明欄,本文未另行取得原始測試檔,因此不指定單一 checkpoint 檔名。
接下來會沿著這條線走:先看統一記憶體這條設計為什麼存在,再看兩臺實機差在哪裡,接著進入三種推論引擎,以及從基本讀寫、長上下文、長檔案、多輪助理到多人同時用的成績單。最後才回到作業系統、報價與購買決策。一萬元的價差很小,真正拉開的,是你每天怎麼工作。
💡 給讀者的 Takeaway
- 不要先問「哪一臺比較快」,先問自己在等的是第一個字出現,還是整段答案寫完。
- 這是創作者在特定機器與特定模型上的對照觀察,不是獨立實驗室基準。
- Mac 是朋友的機器,受測 Spark 儲存是 2TB,報價卻引用 1TB,閱讀數字時要把這些條件一起看。
021. 統一記憶體這條路|用頻寬換容量,用書桌換通道
「記憶體容量像書桌,決定能攤開多少資料;頻寬像送書的通道,決定資料搬得多快。」——應援快門(沿用上一支 128GB 實測的比喻)
講者先花了一段時間,解釋什麼叫 CPU 和 GPU 整合在同一個封裝裡。近年不少桌上型電腦和筆電都走這條路,他點名的例子包括 Apple M 系列、NVIDIA 的 GB10,以及 AMD Ryzen AI Max。和傳統桌機最不一樣的地方,是記憶體的歸屬。
一般獨立顯示卡有自己專用的顯示記憶體。講者的說法是:模型要完整放進那塊記憶體,GPU 才能全速跑;CPU 和顯示卡要交換資料,還得經過 PCIe 再複製一次。整合設計則讓 CPU 與 GPU 共用同一塊統一記憶體,資料放在同一個地方,兩邊都直接讀,不必再來回搬運。
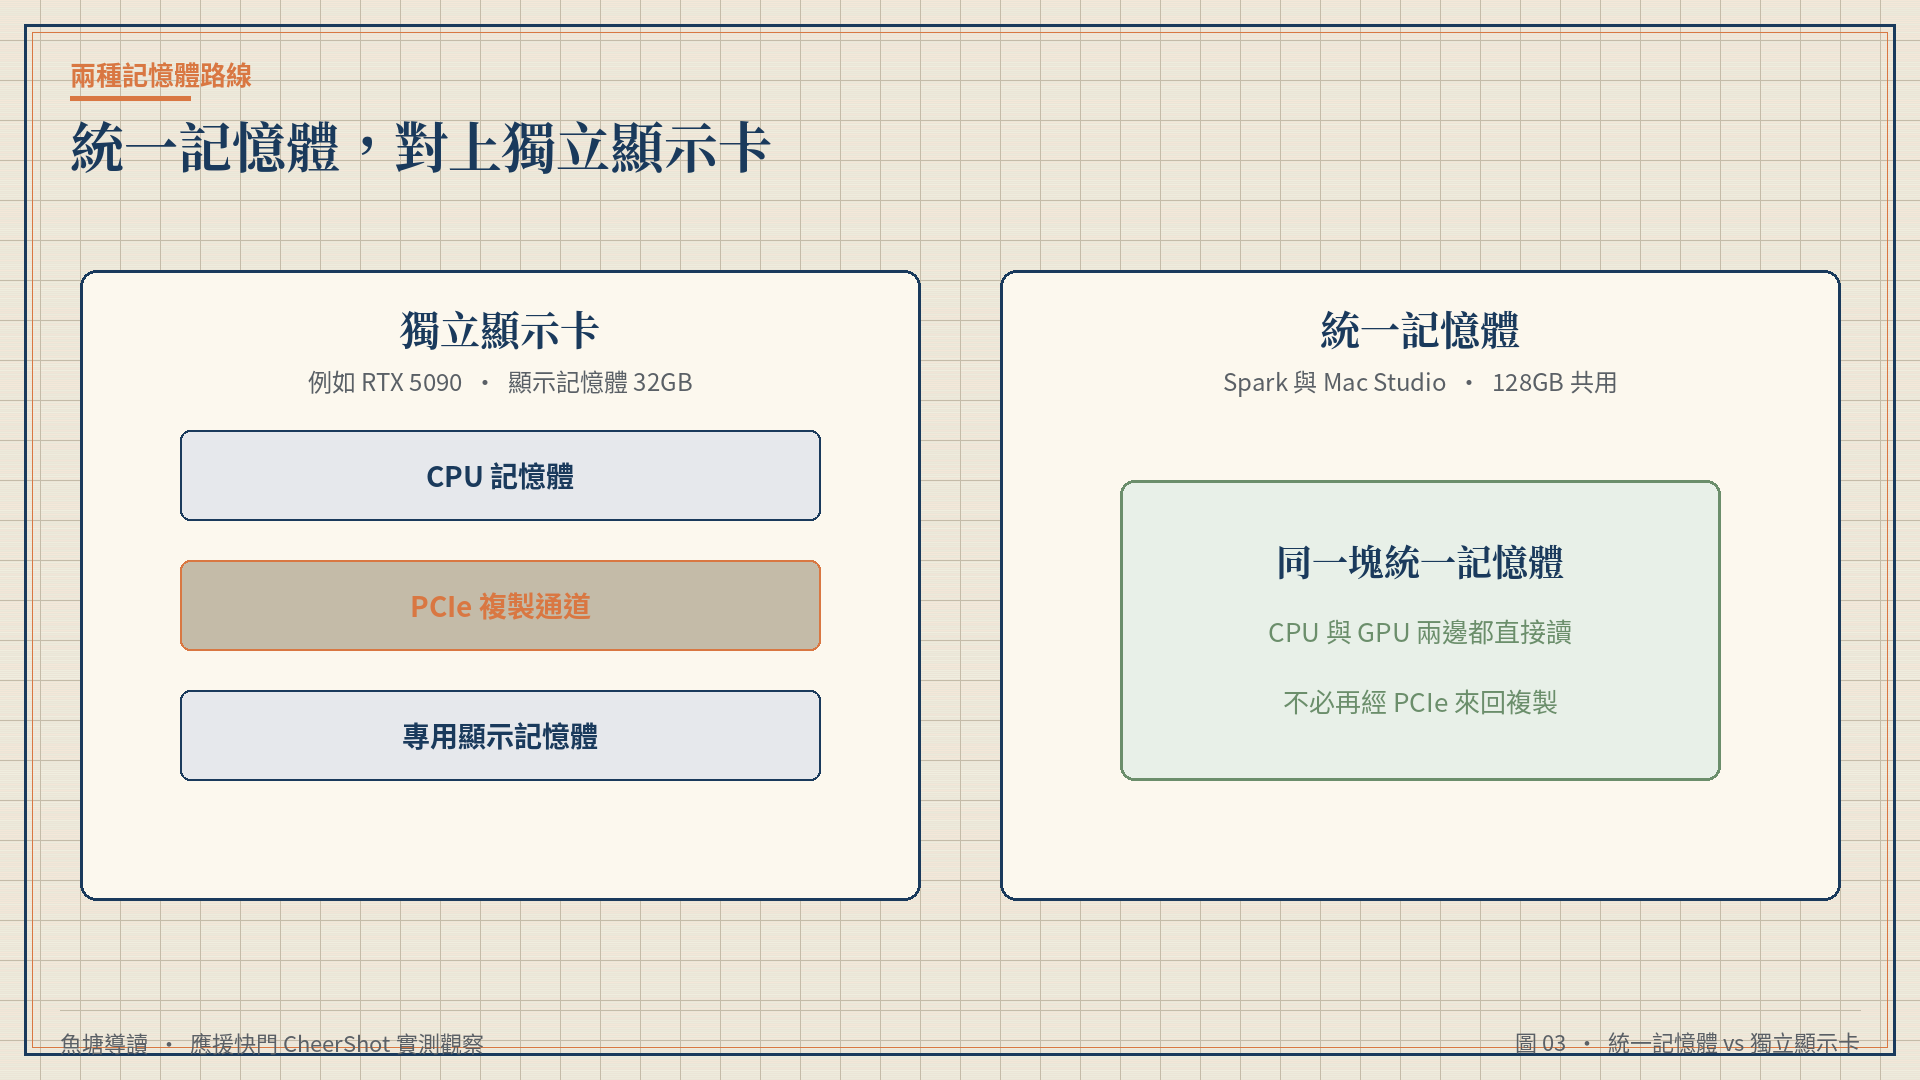
這種設計,講者歸納出三個好處。第一,GPU 能用到的記憶體變得很大——他拿 RTX 5090 的 32GB 顯示記憶體當對照,暗示 128GB 統一記憶體在「放得下多大模型」這件事上,是另一個量級。第二,不用來回複製資料。第三,不必另外裝一張顯示卡,比較省電,機身也能做得很小。
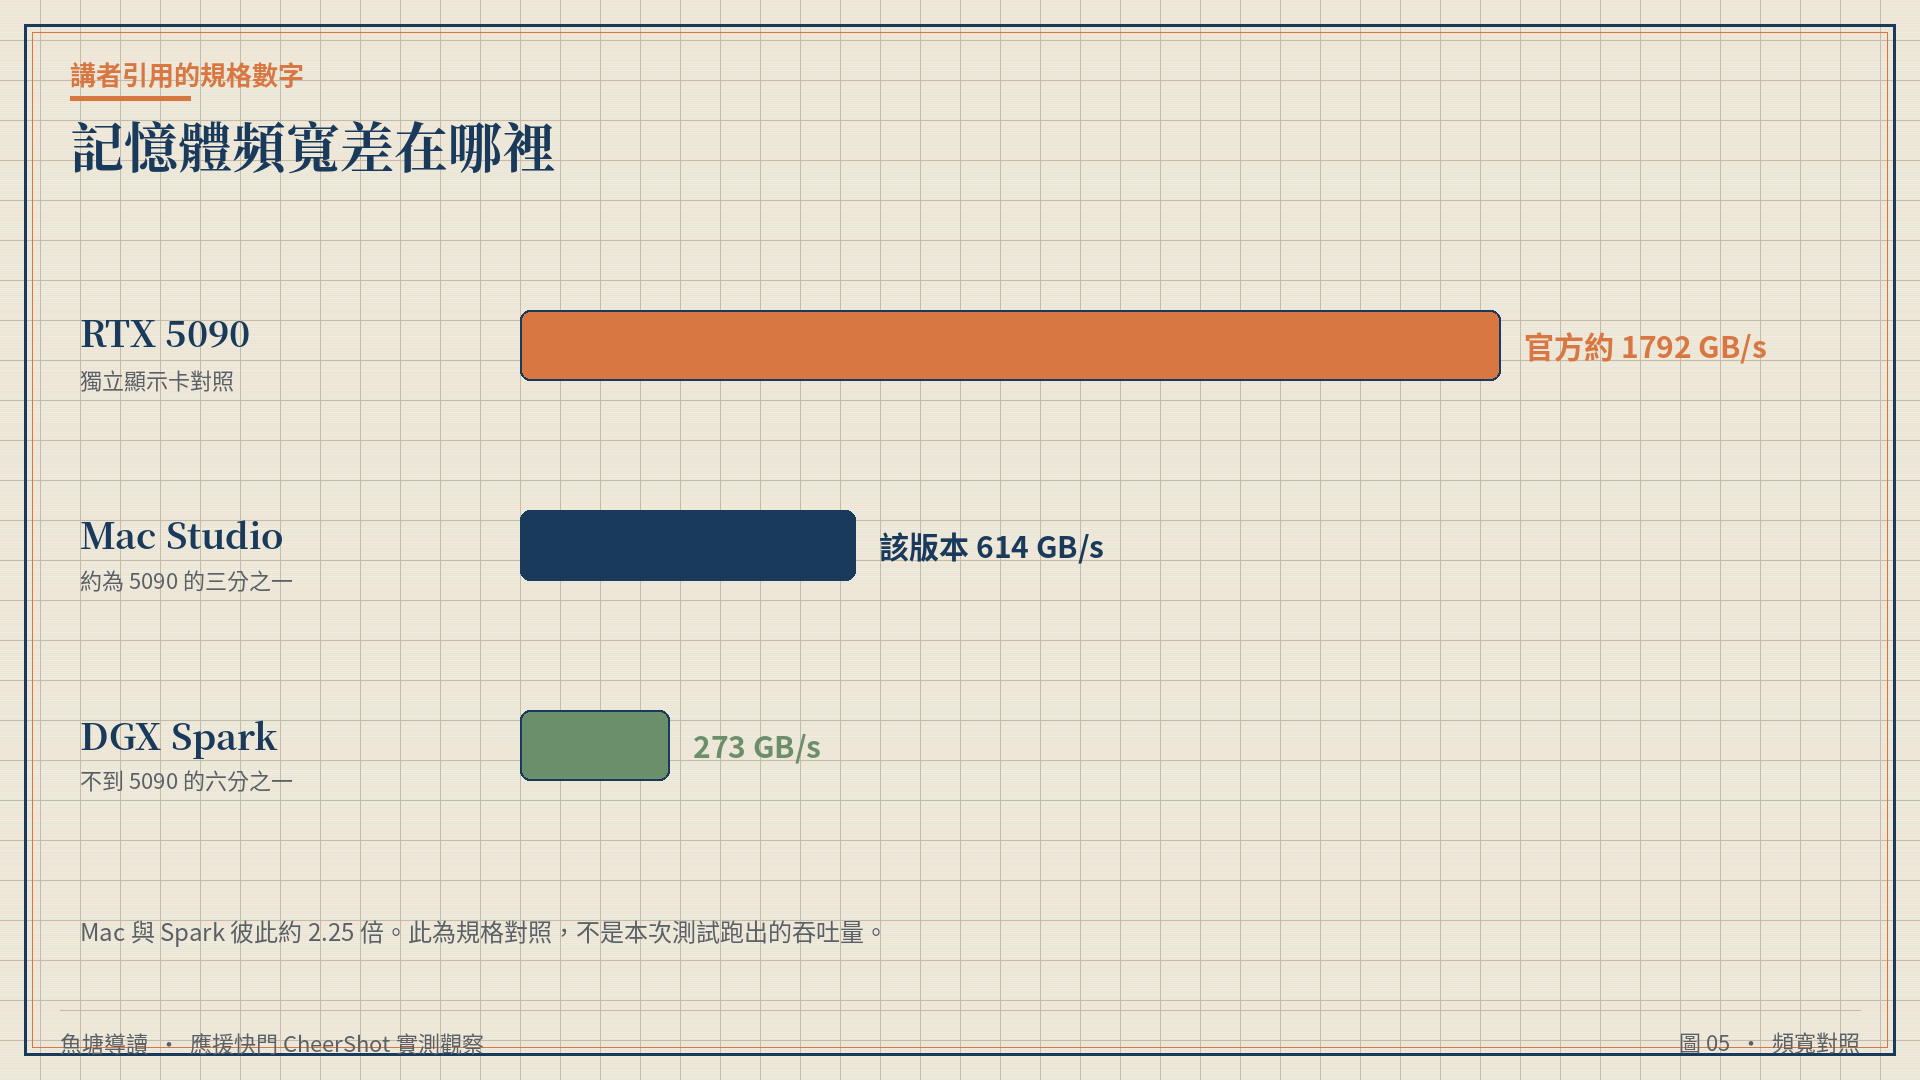
缺點同樣有三個,而且幾乎就是後面所有成績單的伏筆。第一,這類桌機和筆電的記憶體頻寬,比不上高階獨立顯示卡。講者引用的官方數字是:RTX 5090 大約每秒 1792GB,Mac Studio 只有它的三分之一左右,Spark 不到六分之一。第二,CPU 和 GPU 共用同一份供電與散熱,留給 GPU 的功耗,比耗電好幾百瓦的高階獨立顯示卡小很多。第三,記憶體直接焊在封裝或主機板上,買了就不能加,容量要在購買時一次決定。
簡單說,這兩臺的設計,是用頻寬和擴充性,換到大容量、小體積和省電。講者在上一支影片用過的比喻,在這裡會反覆出現:容量是書桌,決定能攤開多少資料;頻寬是送書的通道,決定搬得多快。書桌夠大,資料放得下;通道不夠寬,你還是會在位子上等。
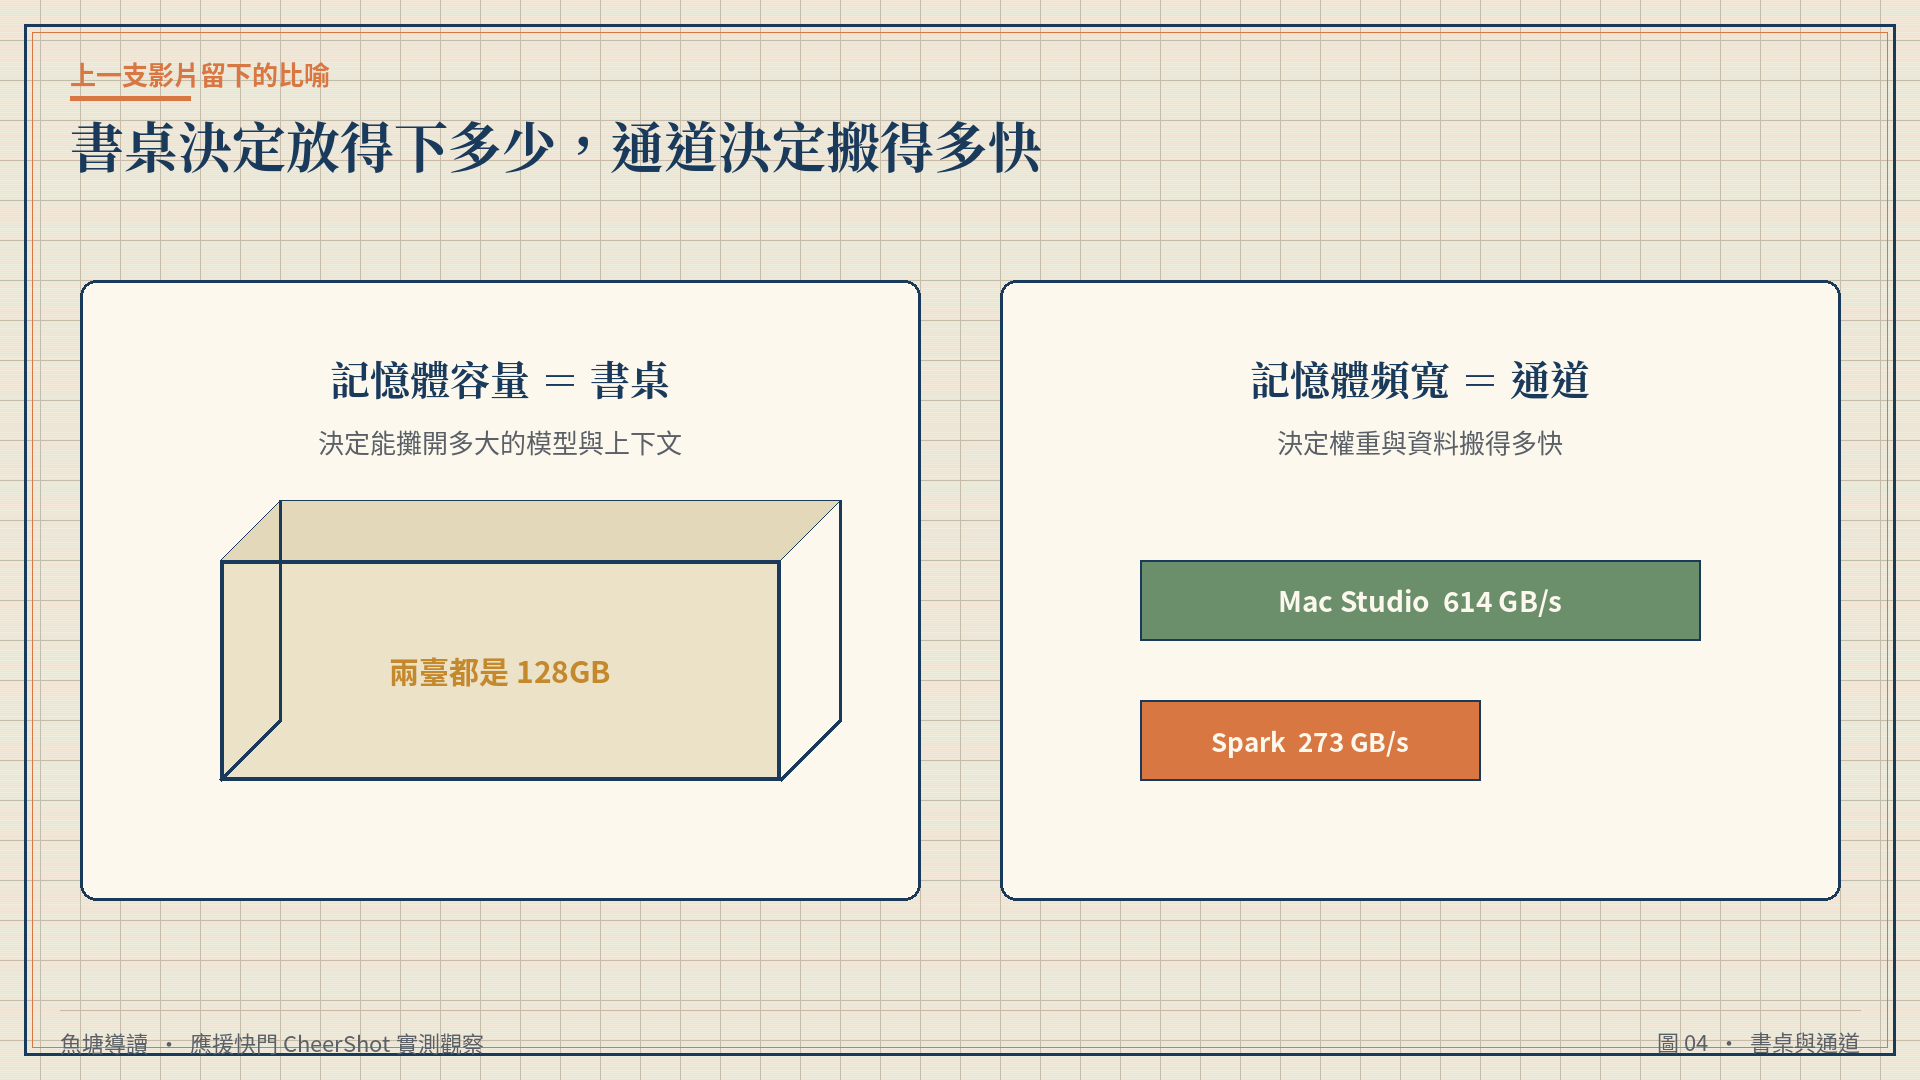
這個區分之所以重要,是因為消費端討論很容易把「128GB」當成速度本身。容量回答的是「能不能跑、能跑多大」;真正決定你盯著遊標要等多久的,往往是頻寬,以及後面會提到的運算能力。兩臺機器選了同一張夠大的書桌,並不表示通道一樣寬,也不表示等的段落會一樣長。
💡 給讀者的 Takeaway
- 統一記憶體路線的核心交換,是用頻寬、功耗頭房與日後擴充,換來大容量與較小的機身。
- 「放得下 128GB 級的模型」不等於「生成會一樣快」。
- 獨立顯示卡對照(5090/Pro 6000/L40S)被講者刻意留到下一支,不應把這支影片的結論直接外推到那條路線。
032. 兩臺實機|15 公分的 Spark,和朋友那臺 M5 Max
兩張書桌一樣大,但 Mac 這邊送書通道寬了一倍多。
實機這一段,講者先拿起華碩 Ascent GX10。它採用 NVIDIA 的 DGX Spark 平臺,受測的是 2TB 版本。機身大約 15 公分 見方,裡面是 GB10 超級晶片:20 核心 ARM 處理器,加上 Blackwell 架構的 GPU。背面有 ConnectX-7 高速網路孔,最高 200Gbps,可以把多臺串在一起。電源是外接的 240 瓦 變壓器。
另一臺是 Mac Studio,搭載 M5 Max。講者明白說,這臺是朋友的機器:18 核心 CPU、40 核心 GPU,還有 16 核心神經網路引擎。記憶體一樣是 128GB,儲存空間是 1TB。機身寬和深都是 19.7 公分、高 9.5 公分,比 Spark 大一圈;電源做在機身裡,背面有 4 個 Thunderbolt 5 連線埠,以及高速有線網路孔。
把規格並排,真正拉開的不是容量——兩臺都是 128GB——而是頻寬。講者給出、且畫面標為「官方規格」的數字是:Spark 每秒 273GB,這臺 Mac Studio 每秒 614GB,大約 2.25 倍。這兩個數字與官方資料一致:NVIDIA 標示 DGX Spark/GB10 的記憶體頻寬為 273 GB/s;Apple 標示 M5 Max「18 核 CPU、40 核 GPU、16 核神經網路引擎」這一檔為 614 GB/s(同系列 32 核 GPU 版本則是 460 GB/s)。這臺受測機是 40 核 GPU,對得上 614 GB/s 那一檔。回到書桌比喻:兩張桌子一樣大,Mac 這一側的通道寬了一倍多。
那 Spark 強在哪裡?講者把焦點放到 GPU 的第五代 Tensor 核心,強調它專門用來加速矩陣運算,並引用 NVIDIA 官方標示:FP4 理論算力最高每秒 1000 兆次運算(畫面補註「理論值、含稀疏性」,相當於官方的最高 1 PFLOP FP4 with sparsity)。通道寬與算力強,哪一個更有感,仍然要回到那句話:你在等的是讀題,還是答案寫完。
這裡有兩件編輯上必須寫清楚的事。第一,頻寬數字是規格對照,不是這次測試跑出來的實測吞吐量;後文的 token 速度,才是影片中的實測觀察。第二,理論算力是官方標示的上限,通常很難直接換算成「讀題一定快多少」。講者自己也沒有把 1000 兆次運算寫成實際成績,只是用來說明 Spark 在運算這一側的設計意圖。
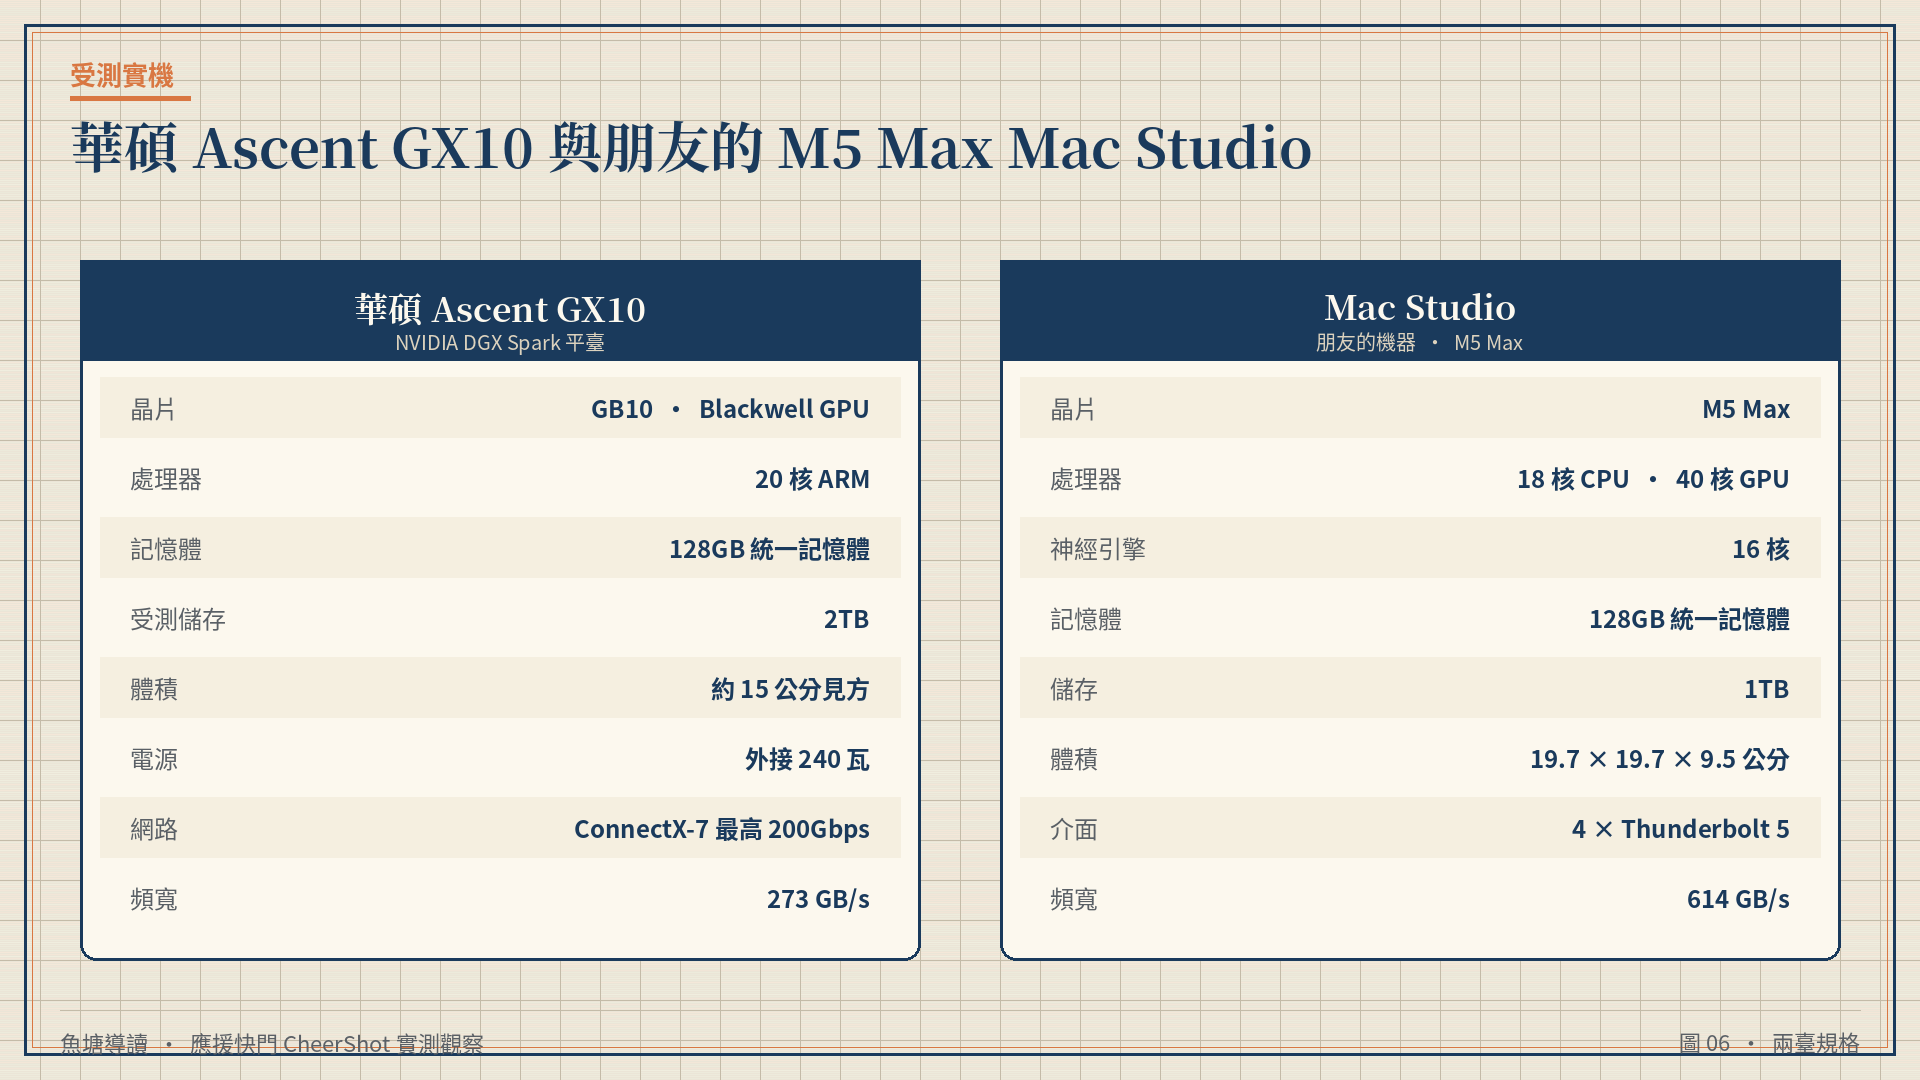
體積與供電方式也值得記一筆。講者說 Spark 機身約 15 公分見方,這指的是正方形底面積;NVIDIA 官方尺寸是 150 × 150 × 50.5 mm,ASUS 標 150 × 150 × 51 mm,是扁盒子而不是正立方。電源是外接的 240 瓦變壓器,與官方規格相符。Mac Studio 大一圈(官方 19.7 × 19.7 × 9.5 公分),但把電源收進機身,介面則是 Thunderbolt 5 與日常桌機更熟的連線方式。這還沒進入作業系統的討論,卻已經看得出兩條產品哲學:一邊更像能串接、能對齊資料中心生態的桌上型模組,一邊更像會長期放在書桌上、順便跑本機模型的 Mac。
💡 給讀者的 Takeaway
- 兩臺都是 128GB,影片裡差最多的規格是記憶體頻寬,約 2.25 倍。
- 受測 GX10 是 2TB、Mac 是朋友的 1TB M5 Max,後續報價與「典型購買配置」不是同一件事。
- Spark 被放在算力與可串接這一側,Mac 被放在頻寬與桌機完成度這一側,誰「更有感」仍要看等待段落。
043. 三種播放器|llama.cpp、vLLM、MLX 為什麼會改寫成績單
「同一個模型,換一套推論引擎,速度可能差很多。」——應援快門
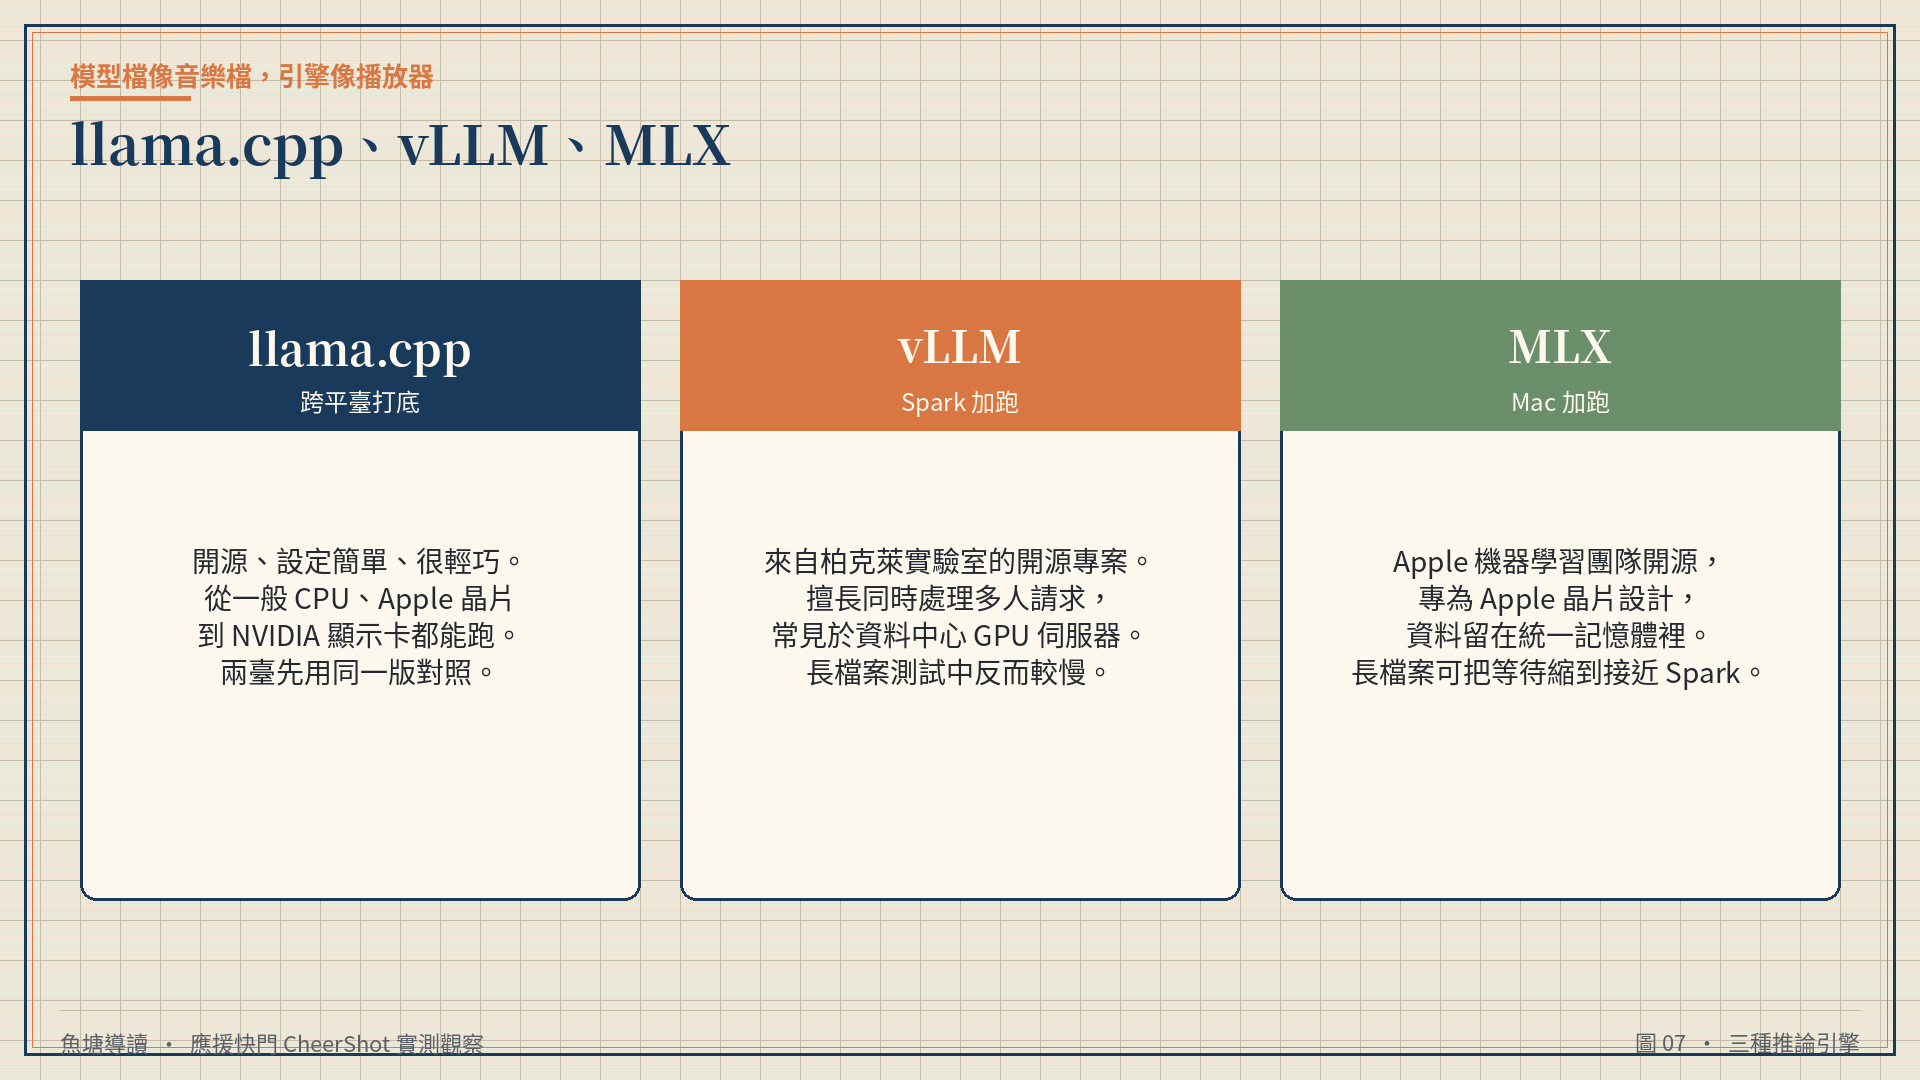
看測試之前,講者要觀眾先認識三個會一直出現的名字:llama.cpp、vLLM 和 MLX。他用了一個很淺、但後面極好用的比喻:模型檔像一首歌的音樂檔,推論引擎像播放器。同一首歌換不同播放器,支援的格式、功能和效率都可能不一樣。
llama.cpp 被描述成開源、設定簡單、很輕巧,從一般 CPU、Apple 晶片到 NVIDIA 顯示卡都能跑,適合在個人電腦上跑模型。vLLM 同樣開源,最早來自美國柏克萊大學的實驗室,主要用在伺服器上提供服務,強項是同時處理很多人的請求,常見於資料中心的 GPU 伺服器。MLX 則是 Apple 機器學習研究團隊開源的框架,專為 Apple 晶片設計,資料直接放在 CPU 與 GPU 共用的統一記憶體裡。
測試方法也在這裡定案。模型和上一支 128GB 實測相同,是 Google Gemma 4 12B 的 4 位元量化(QAT)版本。兩臺先用同一版 llama.cpp、同一個模型檔來跑(畫面註明檔案指紋相同):Spark 走 NVIDIA 的 CUDA,Mac 走 Apple 的 Metal。然後各自再加跑一套自家平臺上較常見的引擎——Spark 用 vLLM,Mac 用 MLX。長檔案和 AI 助理測試,送進去的內容完全一樣。講者還補了一個可核對性的細節:Mac 基本測試一共跑了三次,生成速度三次都是每秒 63 個 token。詳細版本與設定,放在說明欄。
這套設計的好處,是至少先有一組「同一引擎」的對照,避免一開始就把硬體差異和軟體差異攪在一起。但它仍不是完全對稱的實驗:CUDA 與 Metal 本來就不是同一條後端,vLLM 與 MLX 更是為不同場景長出來的工具。後面長檔案測試會看到,引擎一換,等待可以差 20 到 30 秒。把某個引擎的成績直接說成「這臺機器的速度」,會過度解釋。
模型規模現在可以對上官方資料。影片在 5:38–5:46 的畫面寫著「Google Gemma 4 12B」「120 億參數、4 位元量化(QAT)」,口播字幕是「選用一百二十億參數、四位元量化的版本」。先前 Whisper 把這句聽成「121 參數」,是「12B/一百二十億」的誤聽,並不是 121B,也不是 gpt-oss-120b。Google 官方模型卡列出 Gemma 4 只有 E2B、E4B、12B、26B A4B、31B 五個規模,其中 12B Unified 的總參數為 11.95B,對外就叫 12B;Google 也在 Hugging Face 釋出官方 4-bit QAT 權重。影片沒有標出具體檔名,因此本文寫成 Gemma 4 12B 的 4-bit QAT 版本,不指定單一 checkpoint。
💡 給讀者的 Takeaway
- 硬體對照之前,先把推論引擎當成會改寫成績的變因,而不是可忽略的播放器外殼。
- 影片先用同一版 llama.cpp 打底,再各自補上 vLLM 與 MLX,這個層次需要分開讀。
- 測試模型已由影片畫面確認為 Google Gemma 4 12B、120 億參數、4-bit QAT,與官方 12B(11.95B)及官方 QAT 權重相符。
054. 讀題與寫答案|頻寬 2.25 倍,生成速度為什麼接近快一倍
「讀題比較吃運算能力,寫答案比較吃記憶體頻寬。記住這兩句,後面的結果就很好懂。」——應援快門
講者把一次回答拆成兩段。按下送出、答案還沒出現時,模型要先做預填充:把問題、附上的檔案、前面的對話一口氣讀進去。讀題越快,越快看到第一個字。接下來才是生成:模型一個 token、一個 token 往外寫。寫得越快,整段答案越快跑完。他也提醒,token 是模型處理文字的單位,不等於一個中文字。
在這個框架下,基本測試的結果幾乎像課堂例題。讀進 2048 個 token,Spark 每秒大約讀 2250 個,Mac 大約 1940 個,Spark 快了約 16%。換成寫答案,結果整個反過來:Spark 每秒寫 33 個 token,Mac 是 63 個,快了將近一倍。講者說,如果每天都要等它回答,這個差別就很有感——尤其當你看的是答案出現的節奏,而不只是表格上的百分比。
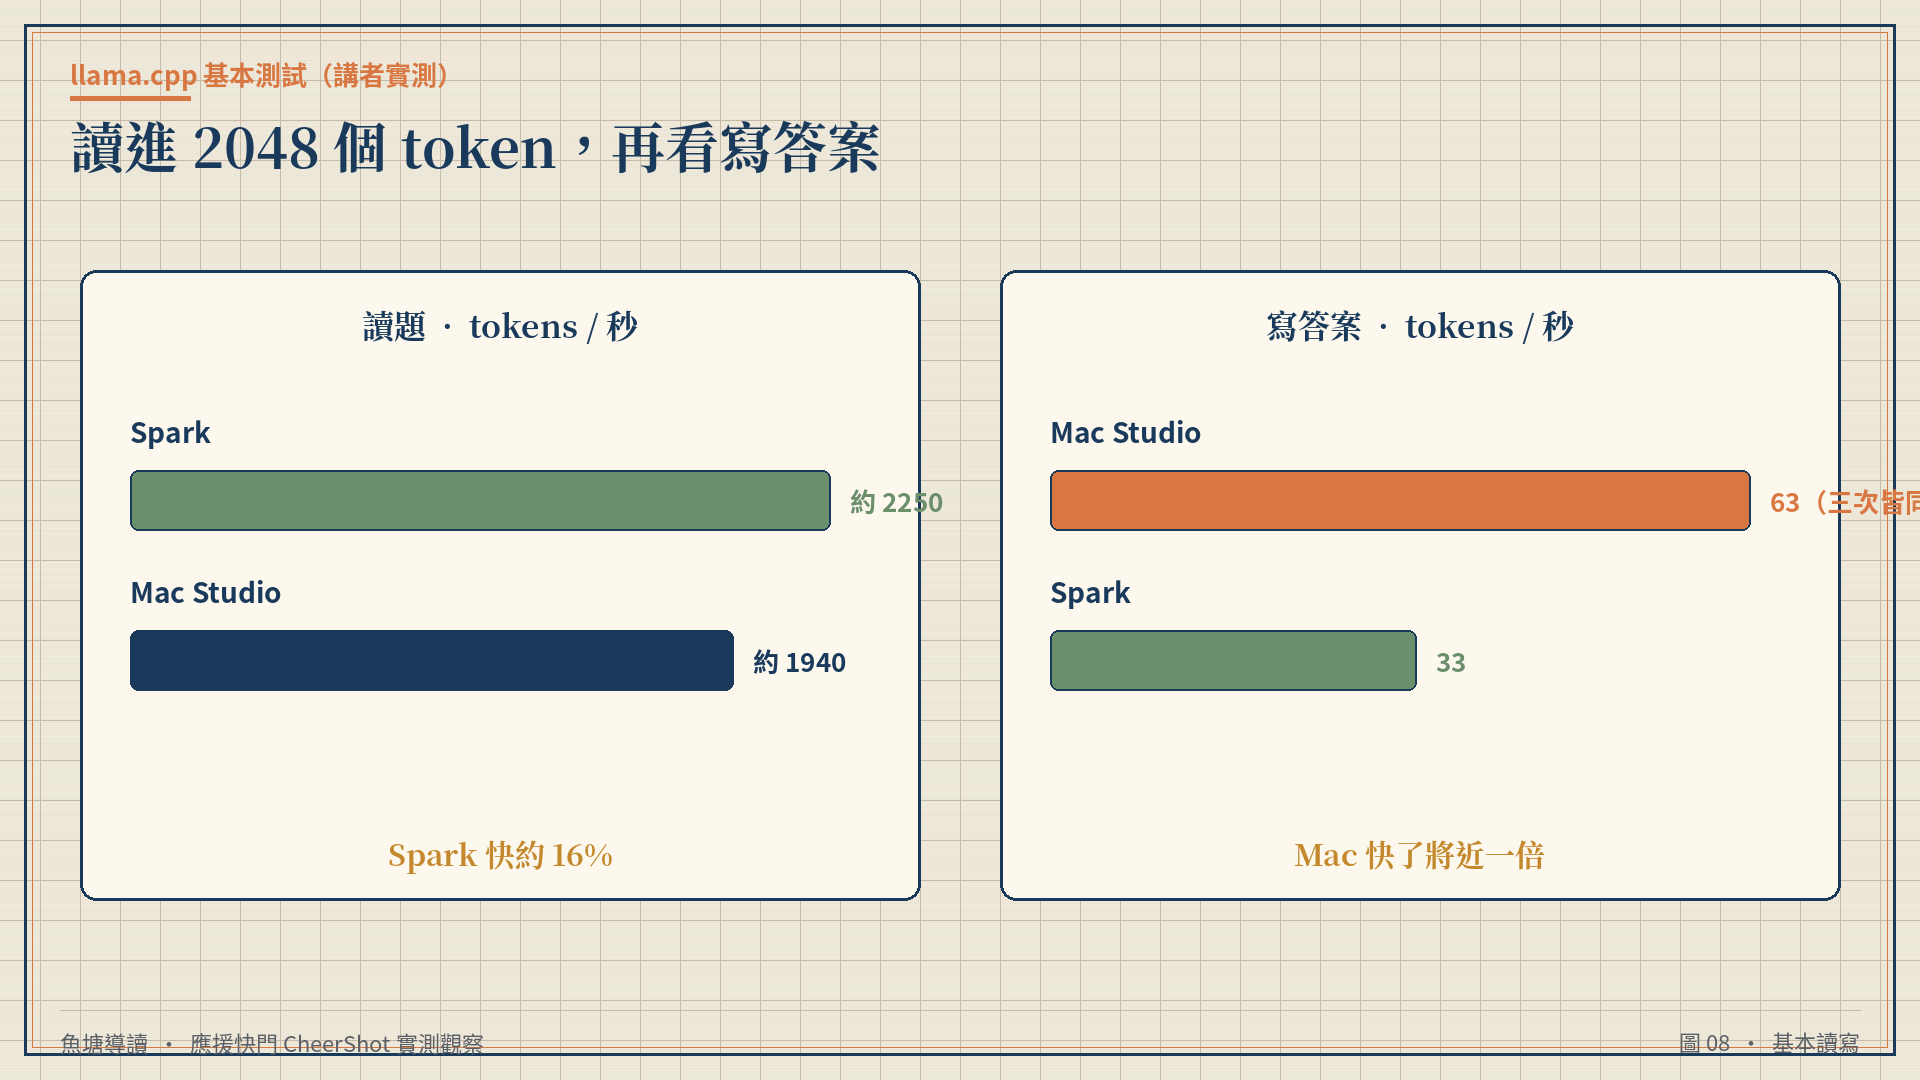
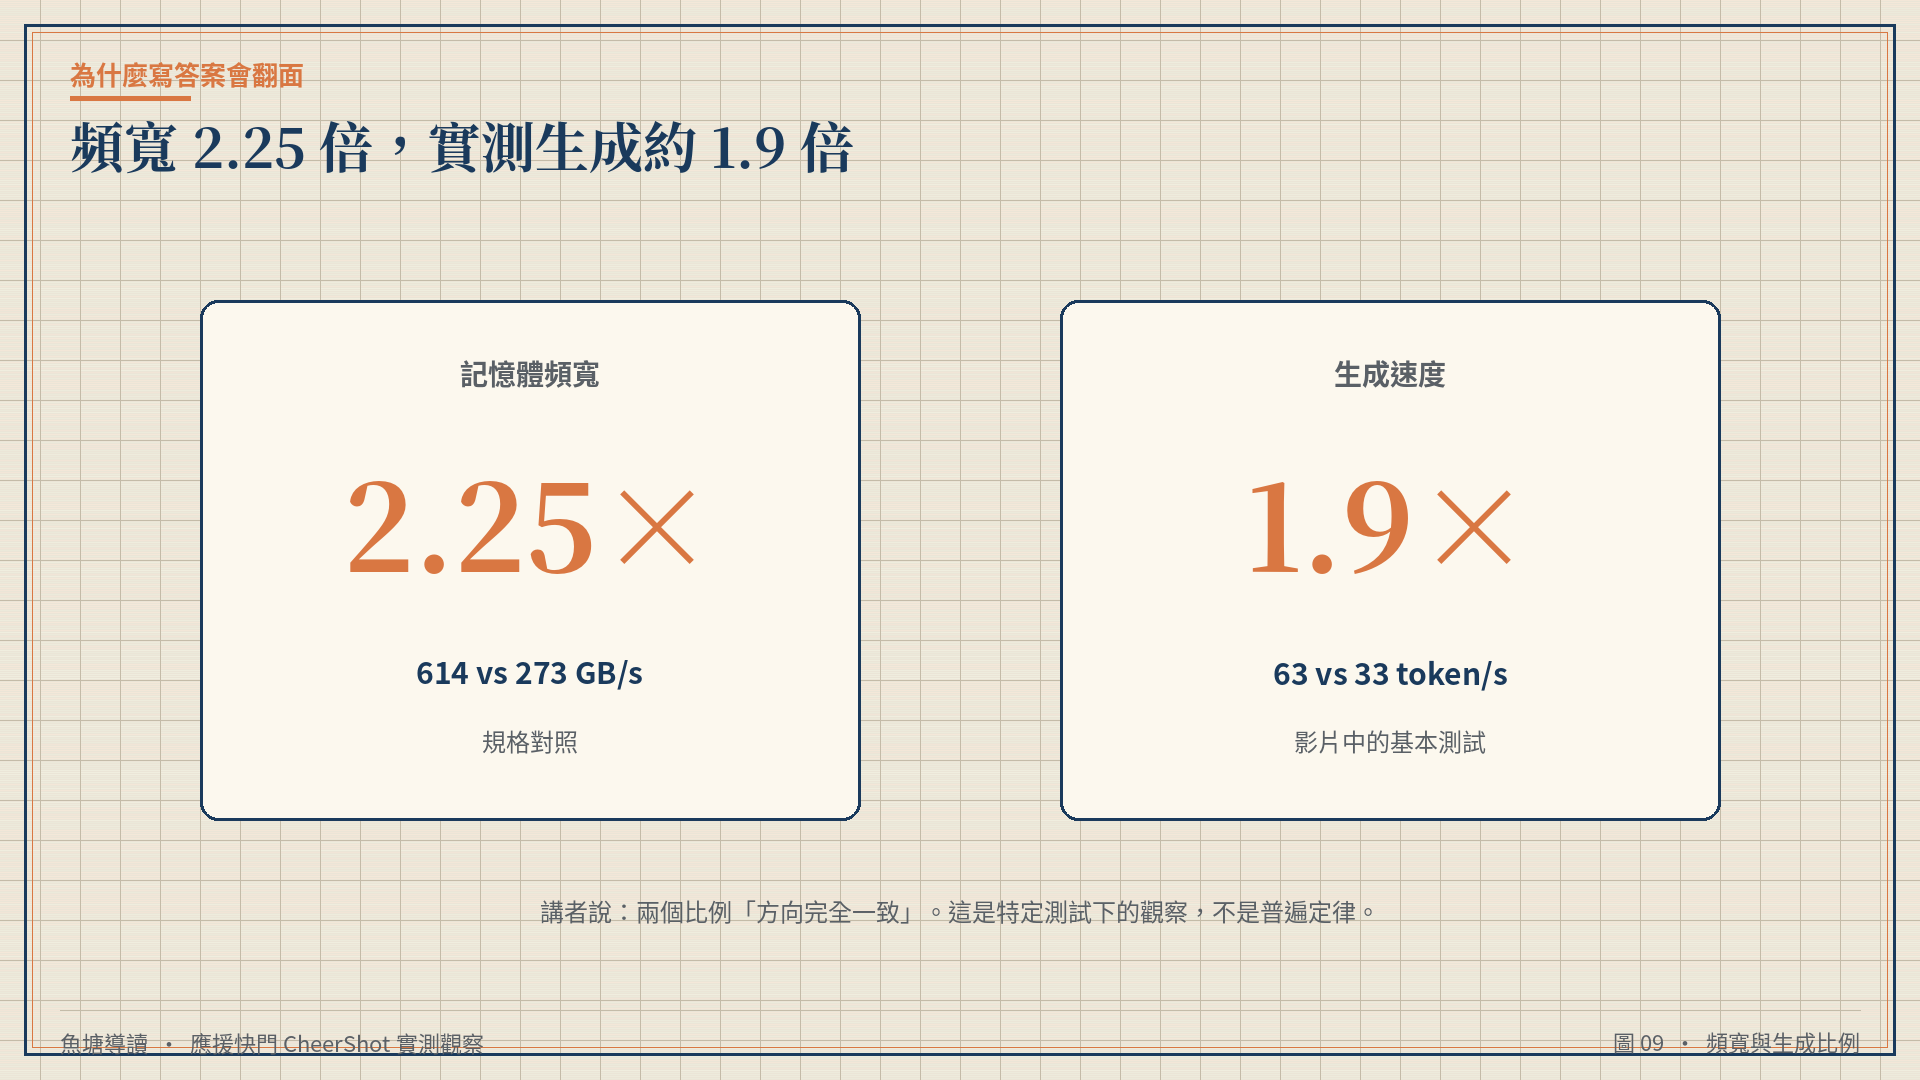
為什麼會翻面?講者給的機制解釋很直白:寫答案時,模型每寫一個 token,都要把整個模型的權重從記憶體讀過一遍,通道越寬,寫得越快。記憶體頻寬是 2.25 倍,實測生成速度是 1.9 倍,「兩個比例方向完全一致」。讀題則是一大批 token 一起算,比的是運算能力,這一項 Spark 比較強。
這段是整支影片最核心的因果鏈,也是最需要保持編輯距離的地方。方向一致,不代表頻寬就是生成速度的唯一變因,更不表示在所有模型、所有量化精度、所有批次設定下都會得到 1.9 倍。它只說明:在講者這組測試裡,寫答案的快慢與頻寬規格的相對位置是對得上的;讀題則沒有跟頻寬走,反而比較靠近 Spark 被強調的運算能力。
把這兩句記住,後面拉長上下文時就不會覺得成績單「突然反直覺」。容量相同,只保證書桌一樣大;你先看到字,還是先看完整段回答,比的其實是兩種不同的物理約束。
💡 給讀者的 Takeaway
- 讀題較吃算力,寫答案較吃記憶體頻寬,這是讀懂後面所有表格的鑰匙。
- 在這組 llama.cpp 基本測試裡,Spark 讀題略快,Mac 寫答案快將近一倍。
- 2.25 倍頻寬與 1.9 倍生成速度「方向一致」,仍是特定測試下的觀察,不是普遍定律。
065. 長上下文與長檔案|從 8K 到 8 萬,等待如何變臉
「內容越長,讀題的等待越明顯。」——應援快門
基本測試像在空曠的桌上解一道短題。真實使用卻常常是:對話越聊越長,或一次附上很長的資料。講者把前面已經有的內容,從 8000 個 token 一路加到 8 萬個,看兩臺怎麼變化。
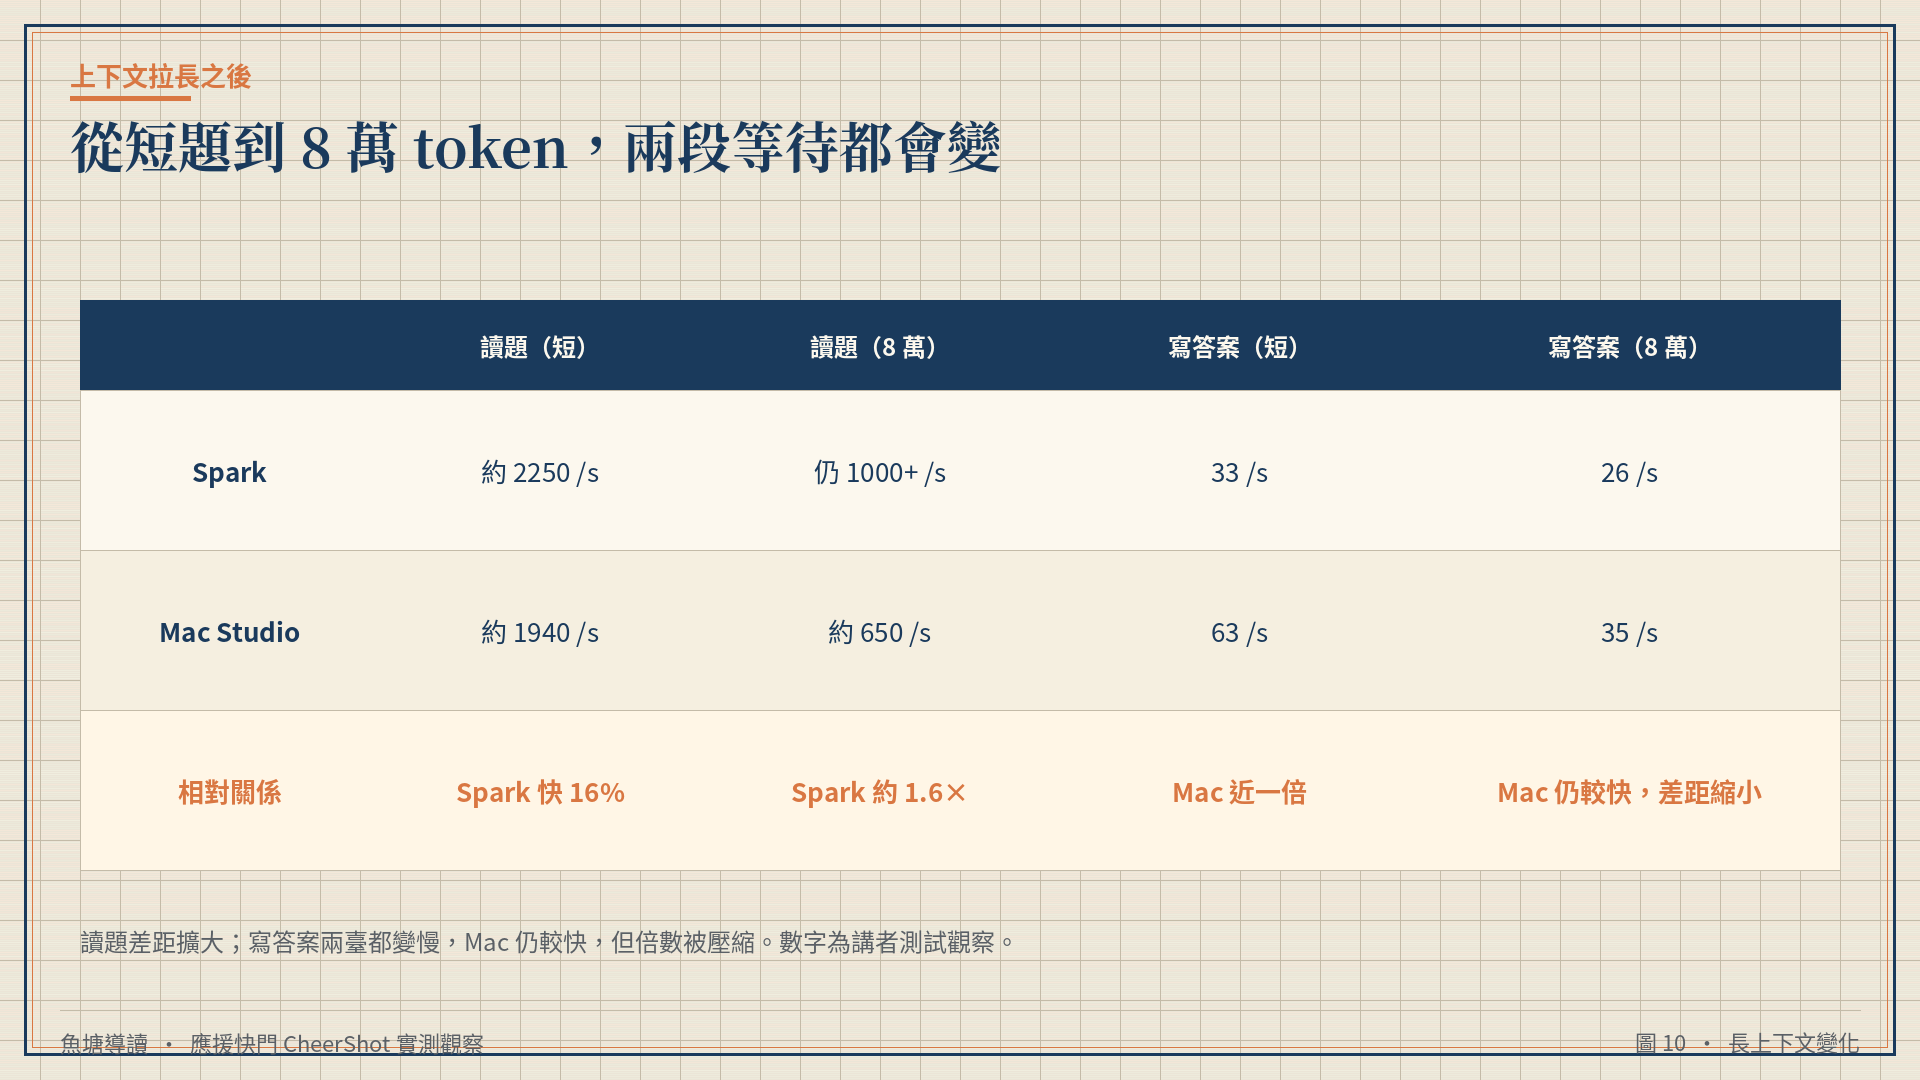
讀題的差距越拉越大。前面已經累積 8 萬個 token 時,Spark 每秒還能讀 1000 多個,Mac 大約 650 個,Spark 變成約 1.6 倍。寫答案則是兩臺都會變慢:Spark 從 33 降到 26,Mac 從 63 降到 35。Mac 還是比較快,但差距縮小了。短題裡幾乎快一倍的寫答案優勢,在長上下文裡被壓縮;相對地,讀題這項原本只有 16% 的差距,被拉得更明顯。
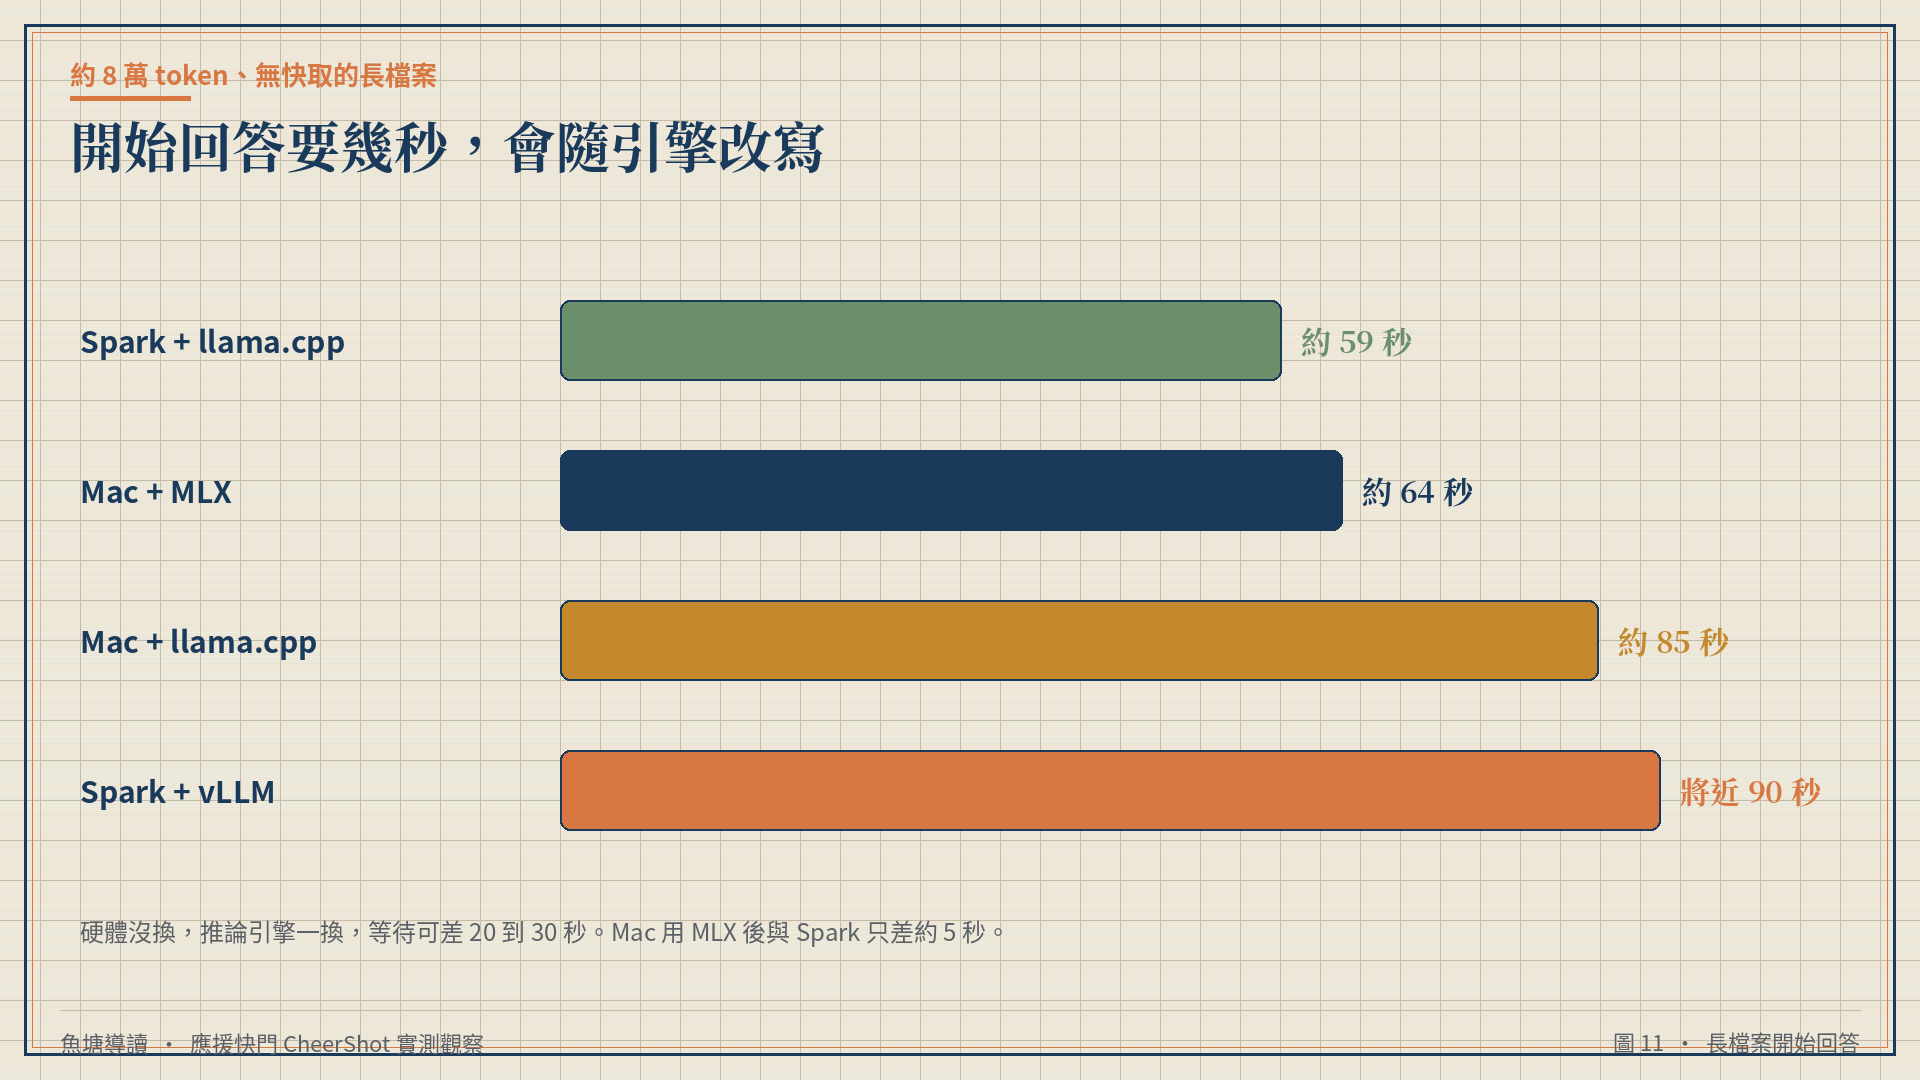
接下來,講者改做一個更接近「丟檔案進去就問」的情境:大約 8 萬個 token 的長檔案,前面沒有任何快取,從頭開始讀。Spark 用 llama.cpp 大約 59 秒開始回答,Mac 用同一套 llama.cpp 要 85 秒;但 Mac 換成自家的 MLX,就縮短到 64 秒,和 Spark 只差 5 秒。反過來,Spark 用 vLLM 跑這個模型,要將近 90 秒。硬體沒換,推論引擎一換,等待就差了 20 到 30 秒。
這可能是整支影片裡,最不宜被簡化成「哪臺比較快」的一組數字。若只看同一套 llama.cpp,Spark 先開始回答,差距有 26 秒;一旦允許 Mac 使用 MLX,差距幾乎被抹平;若再看 Spark 的 vLLM,它甚至比 Mac 的 llama.cpp 更慢。講者自己也立即補上一句:開始回答快,和答案寫得快,是兩件事。等檔案寫答案時,Mac 用 llama.cpp 比較快;檔案拉長到 8 萬 token,換成 MLX 比較快。買硬體之外,推論引擎也要看工作來選。
對讀者來說,這一段的教訓不是「請務必買某一個引擎」,而是:同一臺 128GB 機器,軟體選擇可以把體感從「明顯落後」變成「幾乎打平」,也可以把伺服器取向的引擎用在不合適的單機任務上,反而更慢。vLLM 在介紹裡被定位為擅長同時處理多人請求,用它來跑「一份長檔案、從頭讀」的場景,成績落後並不令人意外,卻很容易在討論裡被誤讀成 Spark 硬體不行。
💡 給讀者的 Takeaway
- 上下文拉長後,讀題等待會變得更顯眼,寫答案的倍數優勢則可能縮小。
- 無快取的 8 萬 token 長檔案上,同一套 llama.cpp 是 Spark 先開始回答;Mac 換成 MLX 後只差約 5 秒。
- 引擎可以在 20 到 30 秒的量級上改寫等待,讀成績時要把軟體條件寫在硬體旁邊。
076. 助理多輪與多人同時用|快取打平之後,差距出在寫完
「開始回答前等待幾乎打平,把答案寫完,差距才拉開。回答越長,差距越大。」——應援快門
講者接著模擬現在很常見的用法:用 AI 助理寫程式、整理資料,一輪一輪工作,每輪加一些新內容,前面的內容留在快取裡。他們模擬了 27 輪,內容從零累積到 8 萬個 token。作為對照,同樣 8 萬個 token 若整份重新讀,要等一分鐘左右;一旦前面留在快取,每一輪只要 2 秒多。
把每一輪「開始回答前」的等待加起來,Spark 用 llama.cpp 是 61 秒,Mac 用 MLX 是 64 秒,幾乎打平。可是如果每輪都要寫出 256 個 token,整段算下來,Mac 用 MLX 是 238 秒,Spark 是 329 秒,Mac 少花了大約四分之一的時間。也就是說,在這種「持續對話、快取有效」的節奏裡,你對第一個字的體感可能差不多;真正拉開的,是答案寫完要多久。回答越長,差距越大。
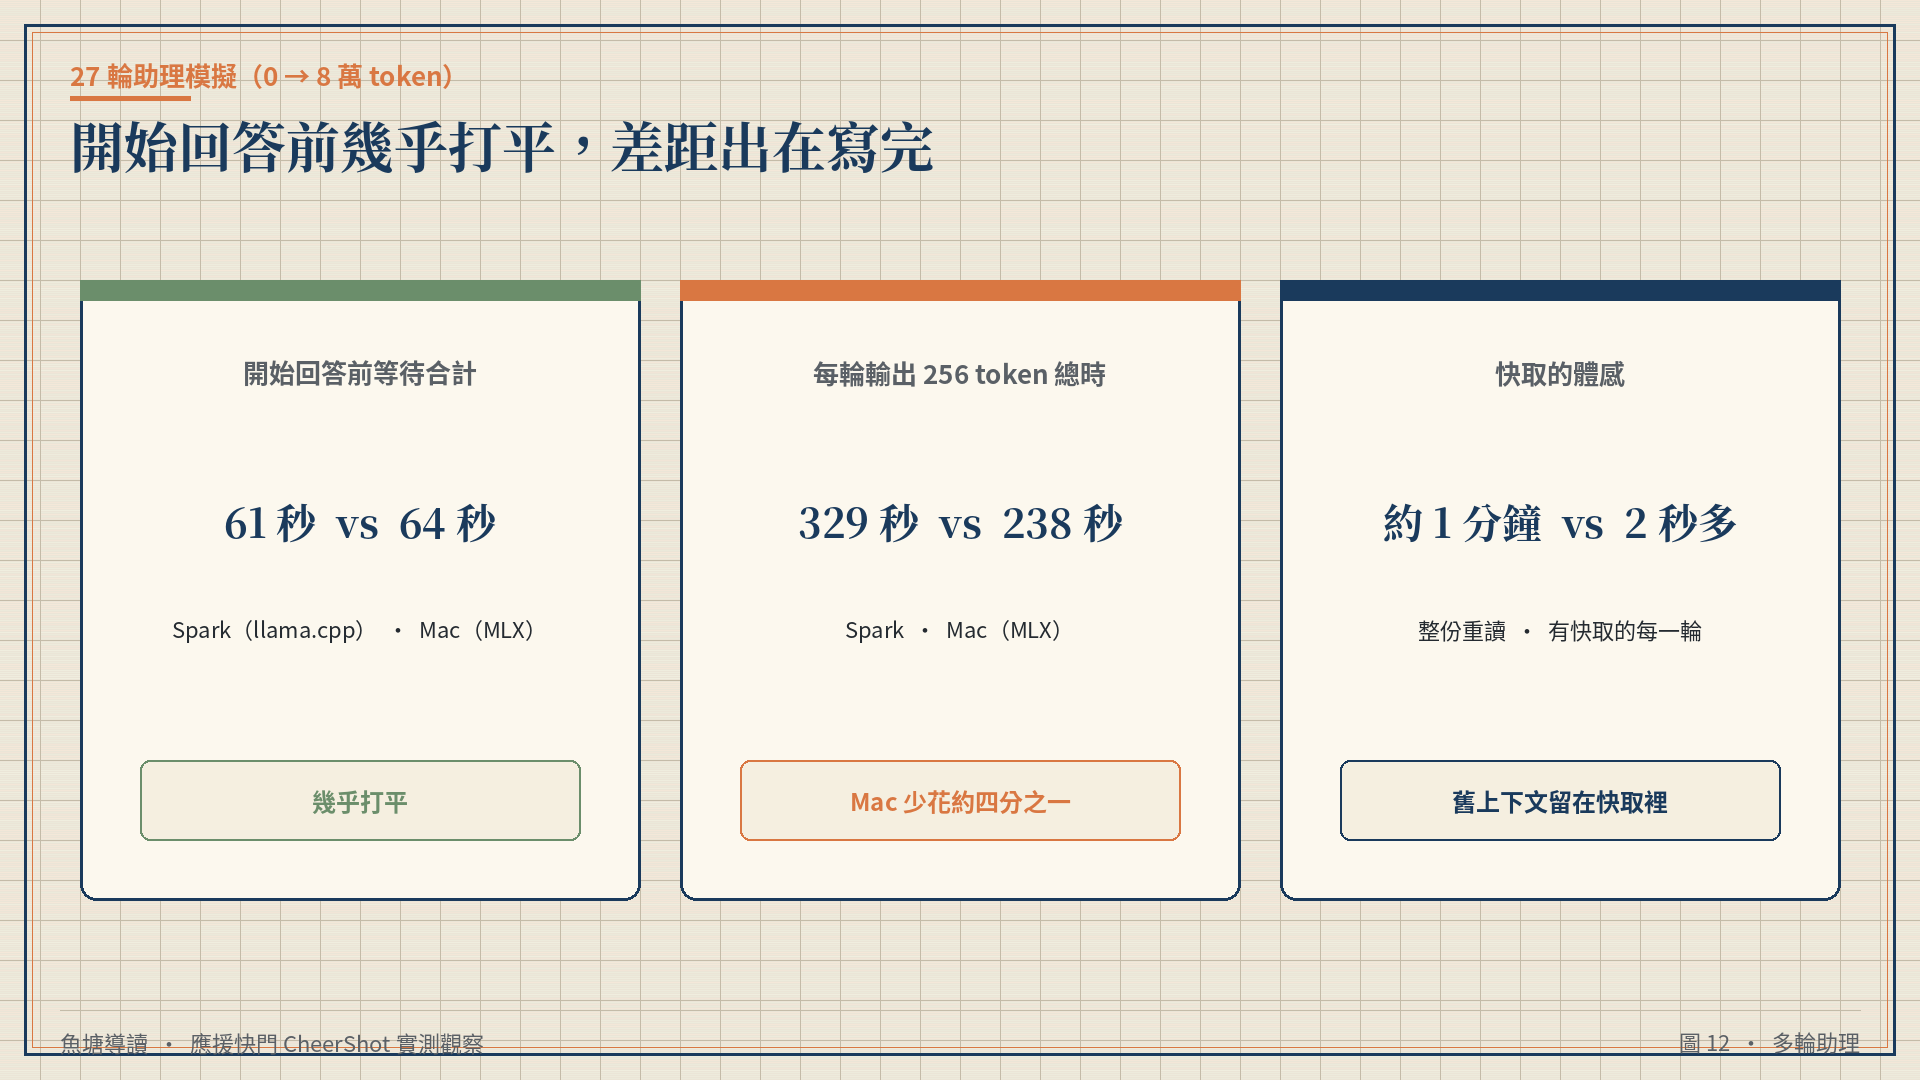
這個設計比單次長檔案更接近很多人的日常。Agent、IDE 助理、把專案摘要反覆丟回去改,通常不是每次都從頭預填充 8 萬 token,而是讓舊上下文留在 KV cache 裡,只對新增那一段付出讀題成本。於是 Spark 在「長檔案從頭讀」時的讀題優勢,在這裡被快取大量削掉;Mac 在寫答案上的頻寬優勢,則會隨著每輪輸出變長而累積。影片給的是 256 token 這個輸出長度下的一組總時,不是所有助理工作的通用公式,但方向很清楚。
如果不是一個人用,而是好幾個人同時問呢?講者的設定是:每個人送進 2048 個 token、各寫 128 個 token,從一個人加到 8 個人。8 個人同時用時,Spark 每秒合計寫出大約 129 個 token,Mac 大約 270 個,一樣是兩倍左右。人數越多,兩臺的合計產量都越高,因為讀一次權重,就能同時替好幾個人寫答案。講者說,要給小團隊用,這一項也值得參考。
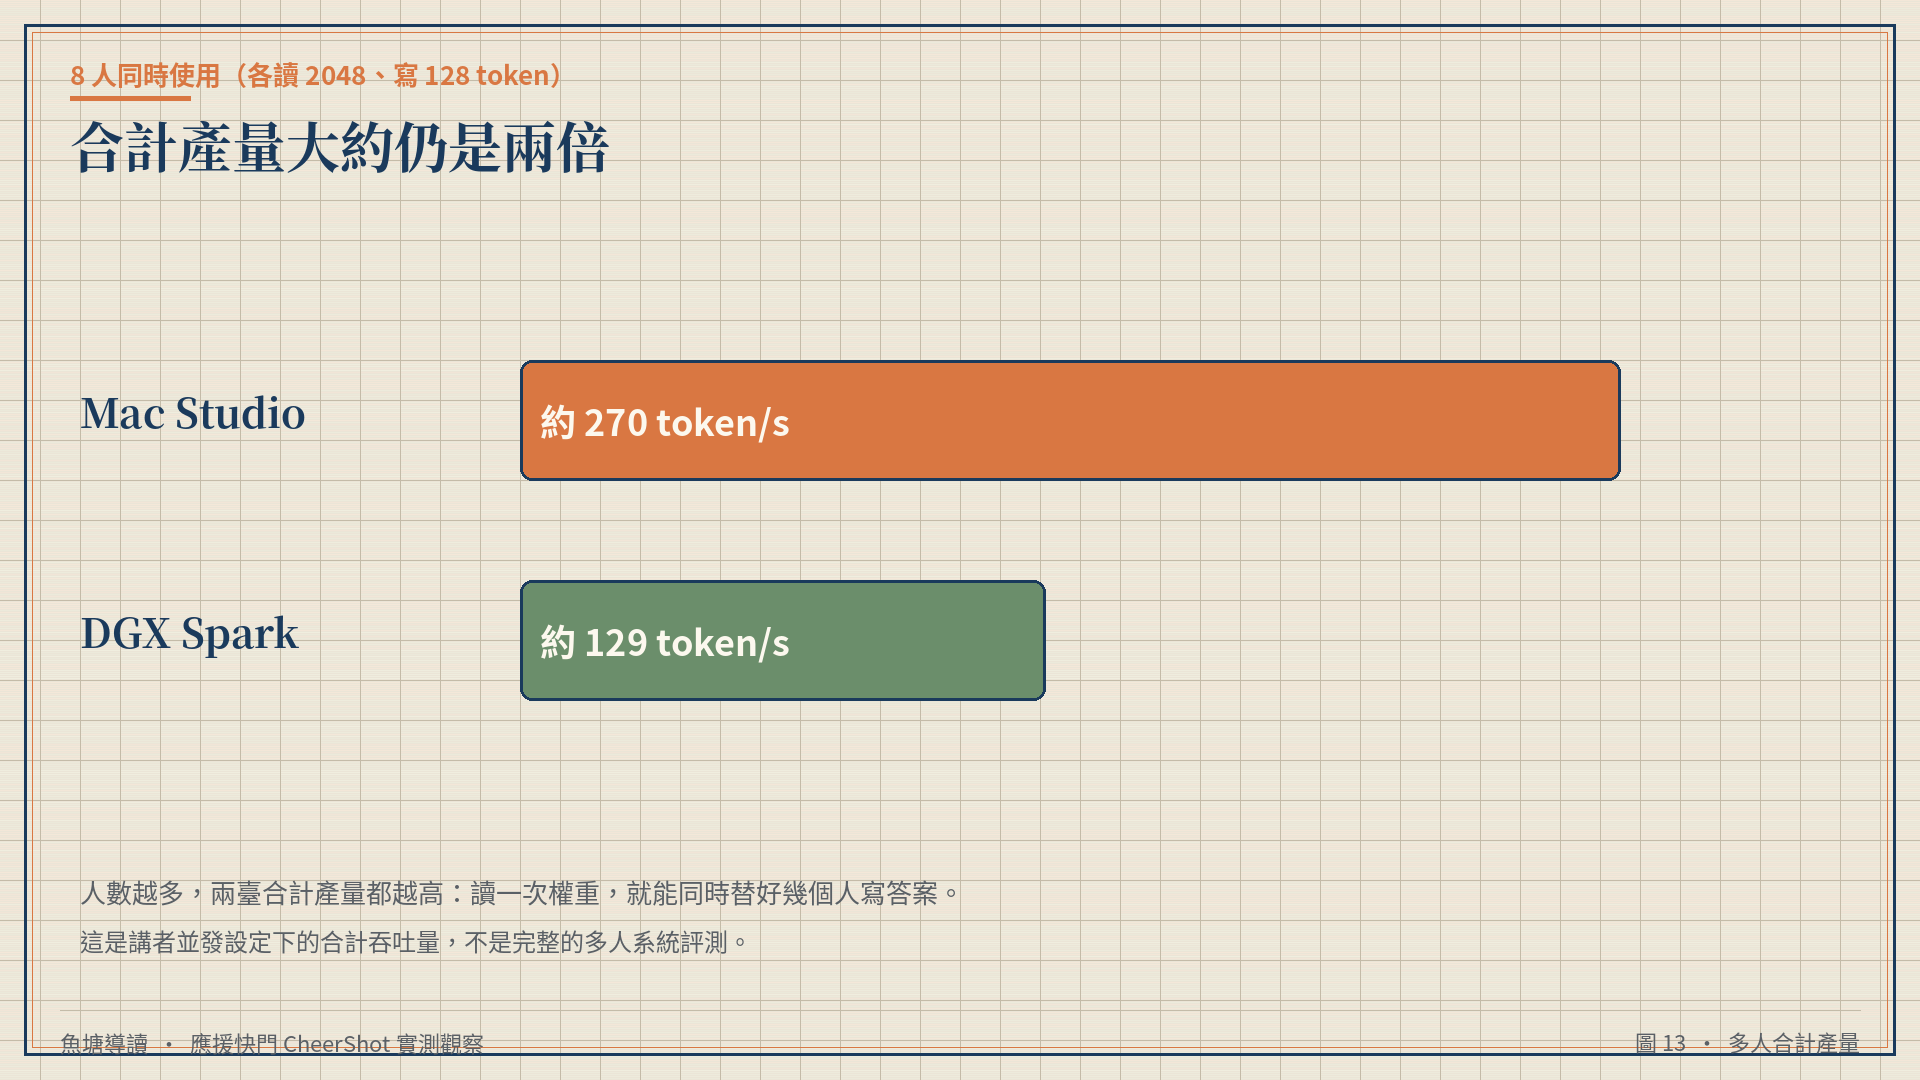
需要小心的是,這仍是同一組測試條件下的合計吞吐量,不是「八個人開視訊會議一起用這臺電腦」的完整體驗,也沒有把網路、排程介面或記憶體碎片一次講完。它比較有用的讀法是:在講者的並發設定裡,寫答案那條頻寬優勢沒有在多人時消失,Mac 大約仍維持兩倍產量;同時,兩臺都展現出「讀一次權重、服務多人」的放大,只是放大後的絕對值不同。
💡 給讀者的 Takeaway
- 有快取的多輪助理,開始回答前的等待可能幾乎打平,差距會累積在把答案寫完。
- 影片中的 27 輪、每輪 256 token 輸出,Mac(MLX)總時 238 秒,Spark 329 秒。
- 8 人同時寫答案時,合計產量仍約兩倍,這對「小團隊共用一臺」有參考價值,但不是完整的多人系統評測。
087. 串接、耗電與作業系統|分數之外,才是每天怎麼工作
串接最大的好處,是放得下單臺裝不下的大模型。——應援快門轉述兩家官方資料
如果一臺的記憶體不夠,能不能把好幾臺串在一起?講者的答案是:兩臺都可以,但這一段用的是官方公佈的資料,因為兩種裝置手上各只有一臺。
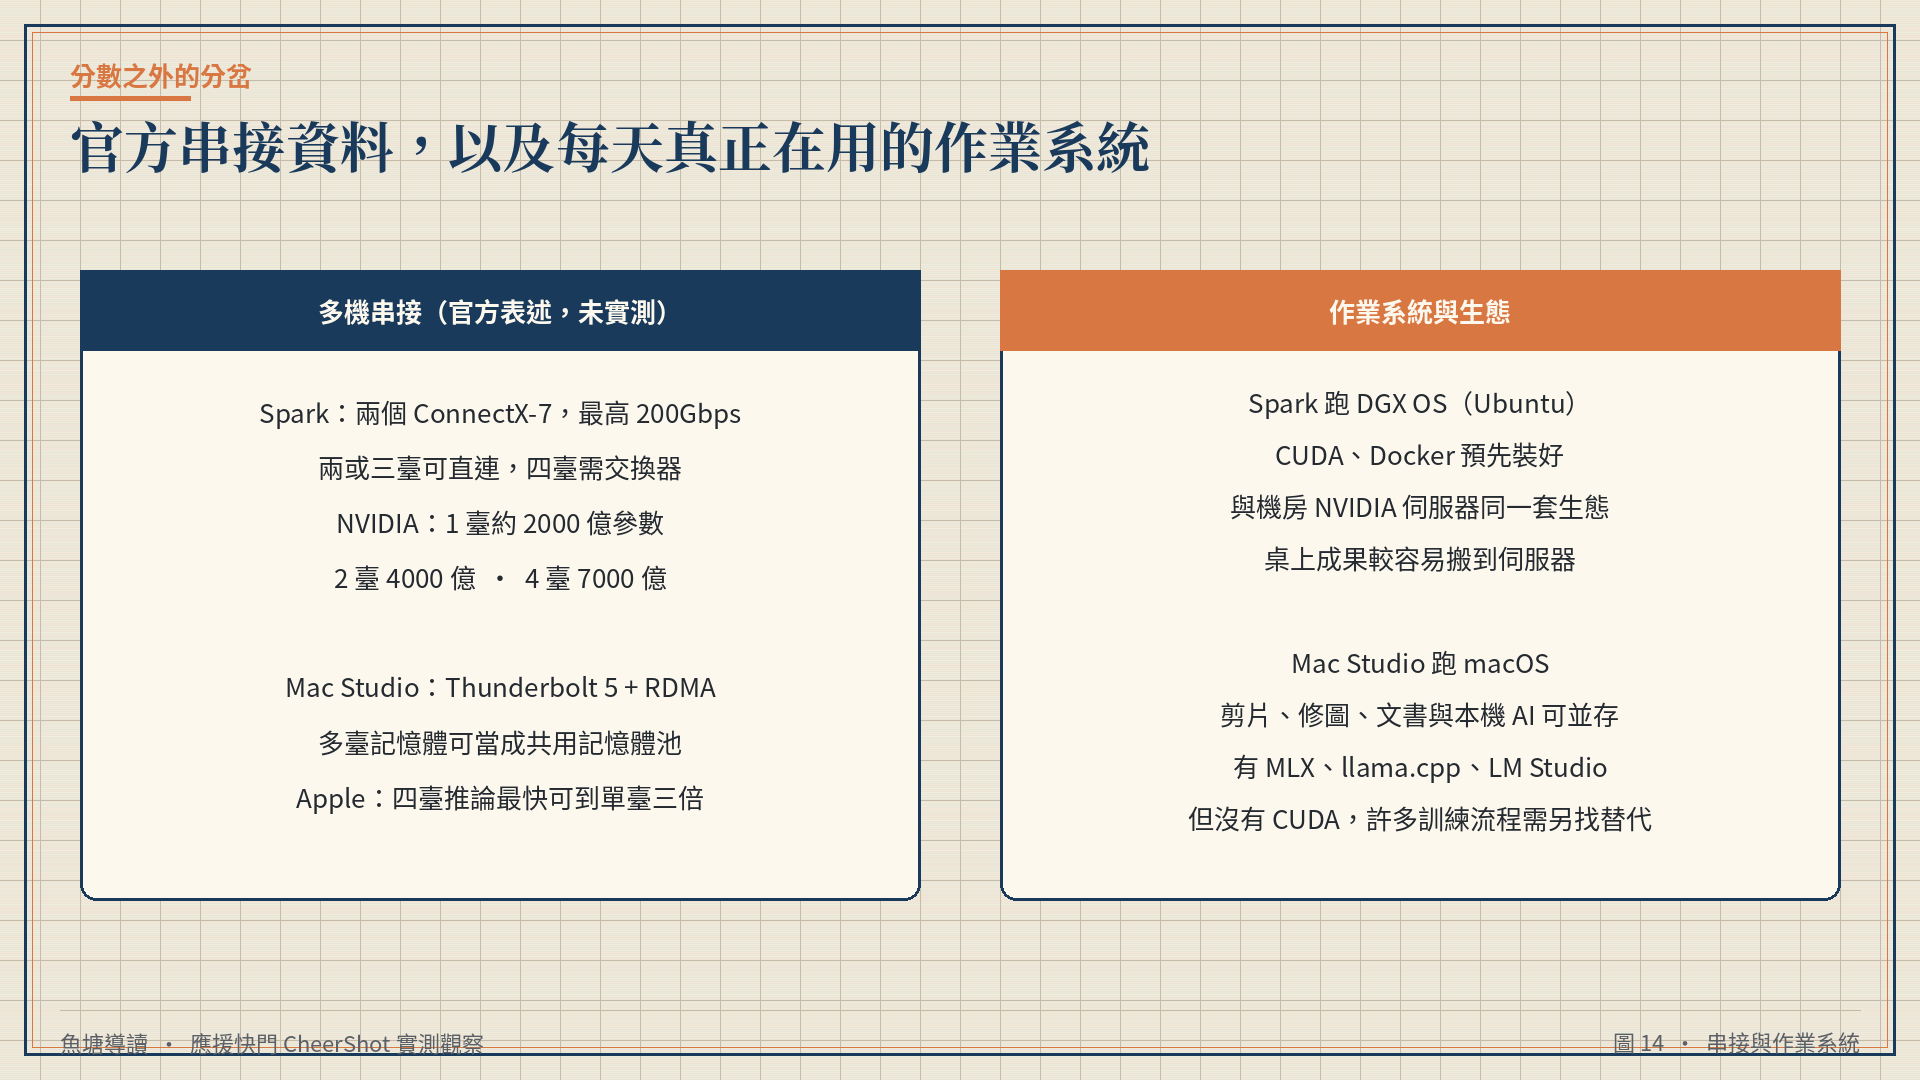
DGX Spark 背面有兩個 ConnectX-7 高速網路孔(官方稱為兩組 QSFP,同屬 ConnectX-7),每個最高 200Gbps。兩臺或三臺可以用一條線直接對接,最多串到四臺,四臺要多加一臺交換器。這與 NVIDIA 使用手冊一致。講者整理、且畫面標為「NVIDIA 官方」的可跑規模是:一臺 128GB 約 2000 億參數,兩臺合計 256GB 約 4000 億,四臺 512GB 約 7000 億。NVIDIA 官方部落格同樣寫雙機最高約 400B、四機最高 700B;使用手冊的雙機數字則更精確地寫成 405B。影片用「約」,兩者並不衝突。Mac Studio 則是用 Thunderbolt 5,加上 macOS 支援的 RDMA,把多臺的記憶體當成一個共用的記憶體池。Apple 表示,四臺串在一起,AI 推論最快可以到單臺的 三倍;這與 Apple 新聞稿的官方表述相符。
這兩組官方敘事其實不在同一個度量上:一邊談的是「串起來之後放得下多大的模型」,一邊談的是「推論最快可以到單臺的幾倍」。它們都指向可擴充,但不該被排成同一列分數。講者把重點放在串接最大的好處——放得下單臺裝不下的大模型——並誠實標示自己沒有做多機實測。對讀者而言,這段適合當成產品路線圖,而不是這支影片已經跑出來的成績。
速度之外,講者也看了耗電。測試期間的晶片回報功耗:Spark 是 GPU 回報,平均大約 60 到 70 瓦;Mac 是 CPU、GPU 加神經網路引擎,平均大約 66 到 82 瓦。兩臺在同一個量級。他立刻加上限制條件:這是晶片自己回報的讀數,不是整臺機器的耗電,兩臺量的範圍也不太一樣,看大概的量級就好。換句話說,不應用這組數字去推算電費,或宣稱哪一臺「更省電」。
更大的差別,講者認為其實是作業系統。Spark 跑的是 NVIDIA 的 DGX OS,以 Ubuntu Linux 為基礎,CUDA、Docker 這些 AI 開發工具都已經裝好。它和機房裡的 NVIDIA 伺服器用的是同一套 CUDA 生態,在桌上開發、測試好的東西,比較容易搬到伺服器上。CUDA 如何讓 GPU 變成 AI 加速器,他指向自己的第二支影片。Mac Studio 跑的是 macOS,剪片、修圖、文書這些日常工作照常用,同一臺也可以跑本機模型;軟體上有 Apple 開源的 MLX,也有 llama.cpp、LM Studio 這類現成工具。但 Mac 沒有 CUDA,很多研究程式和訓練流程只支援 CUDA,在 Mac 上要另外找替代方案。
到這裡,「誰比較快」已經不夠用來做購買決策。一臺是對齊資料中心工具鏈的 Linux 桌上型模組,一臺是日常工作與本機推論可以共用的 macOS 電腦。分數可以討論,生態會決定你明天開啟機器後,到底是接著訓練指令碼、容器與部署,還是先剪一段影片、再把專案丟給本機助理。
💡 給讀者的 Takeaway
- 串接規格來自 NVIDIA 與 Apple 官方表述,講者並未用兩臺以上實機驗證。
- 晶片回報功耗落在同一量級,但不能直接當成整機耗電或電費比較。
- 對許多人來說,DGX OS/CUDA 與 macOS/沒有 CUDA,會比某一項 token 速度更能決定適不適合。
098. 結論|價差一萬元,真正要選的是工作方式
「記憶體容量決定能放多大的模型,頻寬和算力,才決定你要等多久。」——應援快門
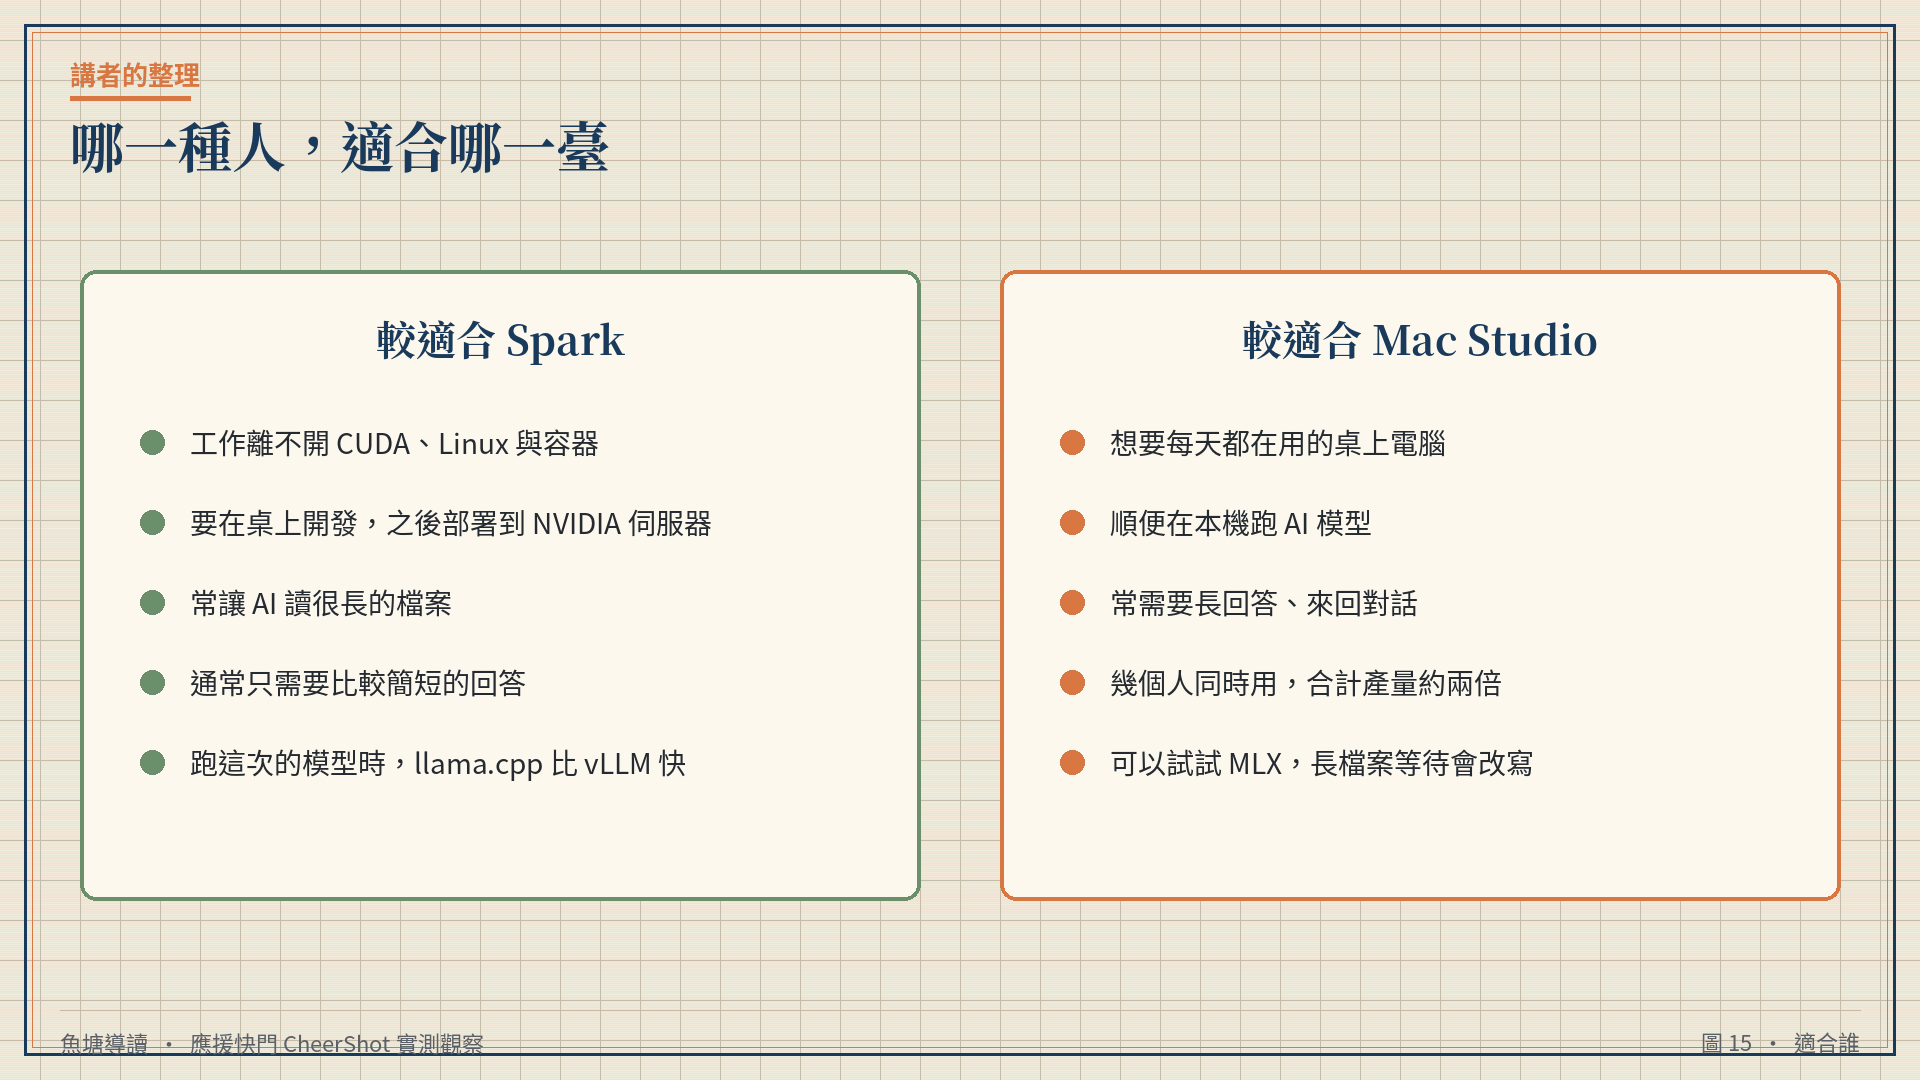
講者最後整理適合誰。如果你是 AI 開發者,工作離不開 CUDA、Linux 和容器,要在桌上開發、之後部署到 NVIDIA 的伺服器,Spark 比較順手;常常讓 AI 讀很長的檔案、只需要簡短回答,Spark 讀題快,也比較有感。如果你想要一臺每天都在用的桌上電腦,順便在本機跑 AI,或是常需要 AI 寫長回答、來回對話,Mac Studio 的寫答案速度會比較有感;幾個人同時使用,合計產量在影片裡大約是兩倍。不管選哪一臺,推論引擎都要挑:Mac 可以試試 MLX;Spark 跑這個模型時,llama.cpp 比 vLLM 快。
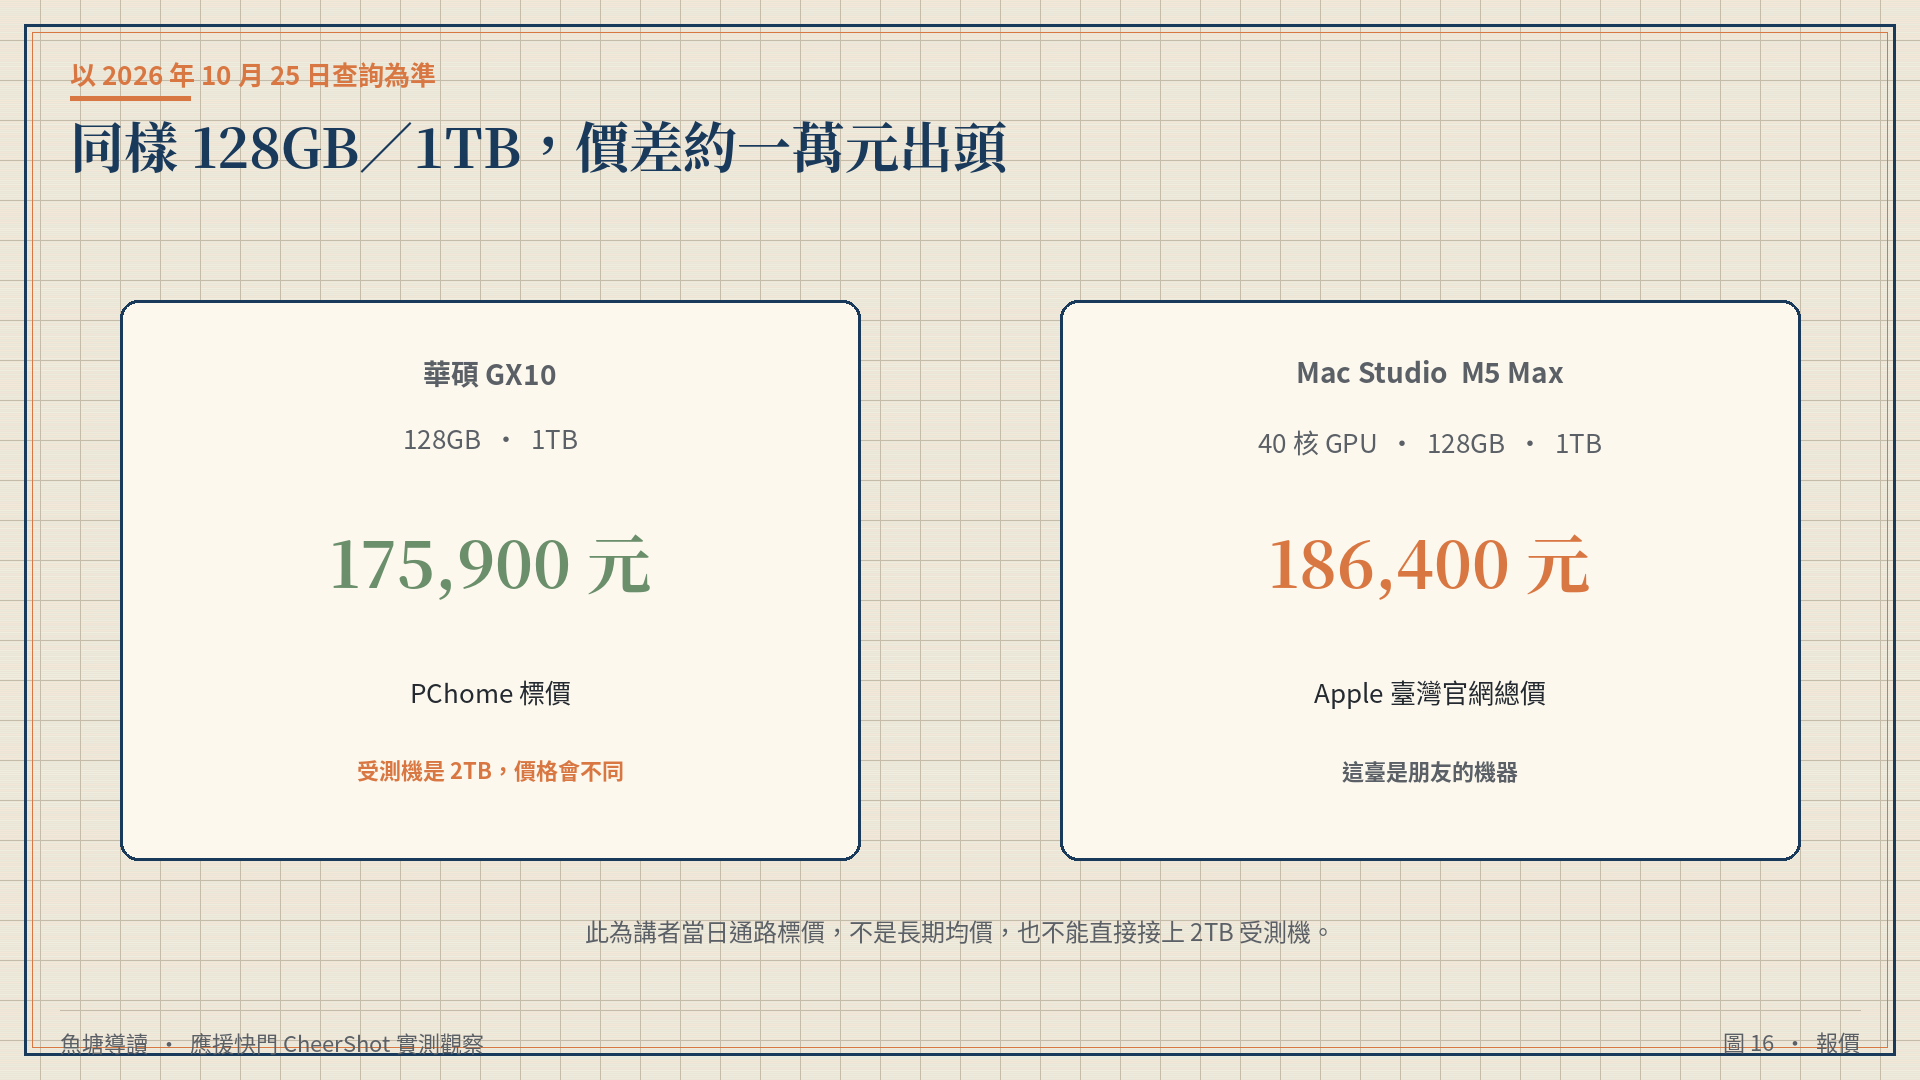
價格被放到最後,而且給了明確的查詢日期。以 2026 年 10 月 25 日 為準:華碩 GX10、128GB、1TB 版,PChome 標價 175,900 元;Mac Studio 選 M5 Max、40 核心 GPU、128GB、1TB,Apple 臺灣官網總價 186,400 元。同樣是 1TB 配置,價差大約 1 萬元出頭。講者也提醒,受測的 GX10 是 2TB 版,價格會不一樣。價格這麼接近,挑哪一臺,還是看你每天怎麼用。
這組報價的讀法應當保守。它是講者在特定日期、特定通路查到的標價,不是長期均價,也不含加購、教育價或後續記憶體無法擴充所隱含的風險。尤其受測機與報價機的儲存容量不同,不能把測試體感直接接上 175,900 元那一列。一年後再看,這個「一萬元出頭」的距離也不保證還在。
回到開頭的問題:同樣 128GB,哪一臺比較快?講者的收束很乾脆——讀題,Spark 比較快,內容越長越明顯;寫答案,Mac Studio 快了將近一倍;多人同時用,也是 Mac 產量比較高。長檔案和 AI 助理這類工作,選對推論引擎,兩臺的差距會改變很多。作業系統則決定每天的工作方式:要 CUDA 和 Linux 的開發環境,還是一臺日常工作與本機 AI 都能兼顧的 macOS 電腦。
值得參考的,是這支影片把「快」拆開來量:預填充、生成、有沒有快取、輸出夠不夠長、一個人還是一群人。它讓購買討論從口號回到工作型態。該存疑的,則是一切被拿去當普遍結論的數字:單一模型與量化版本、朋友的那臺 Mac、2TB 受測機對 1TB 報價、官方串接資料、以及晶片回報而非整機的功耗。這些不是缺陷到讓影片失去價值,但它們標出了外推的邊界。
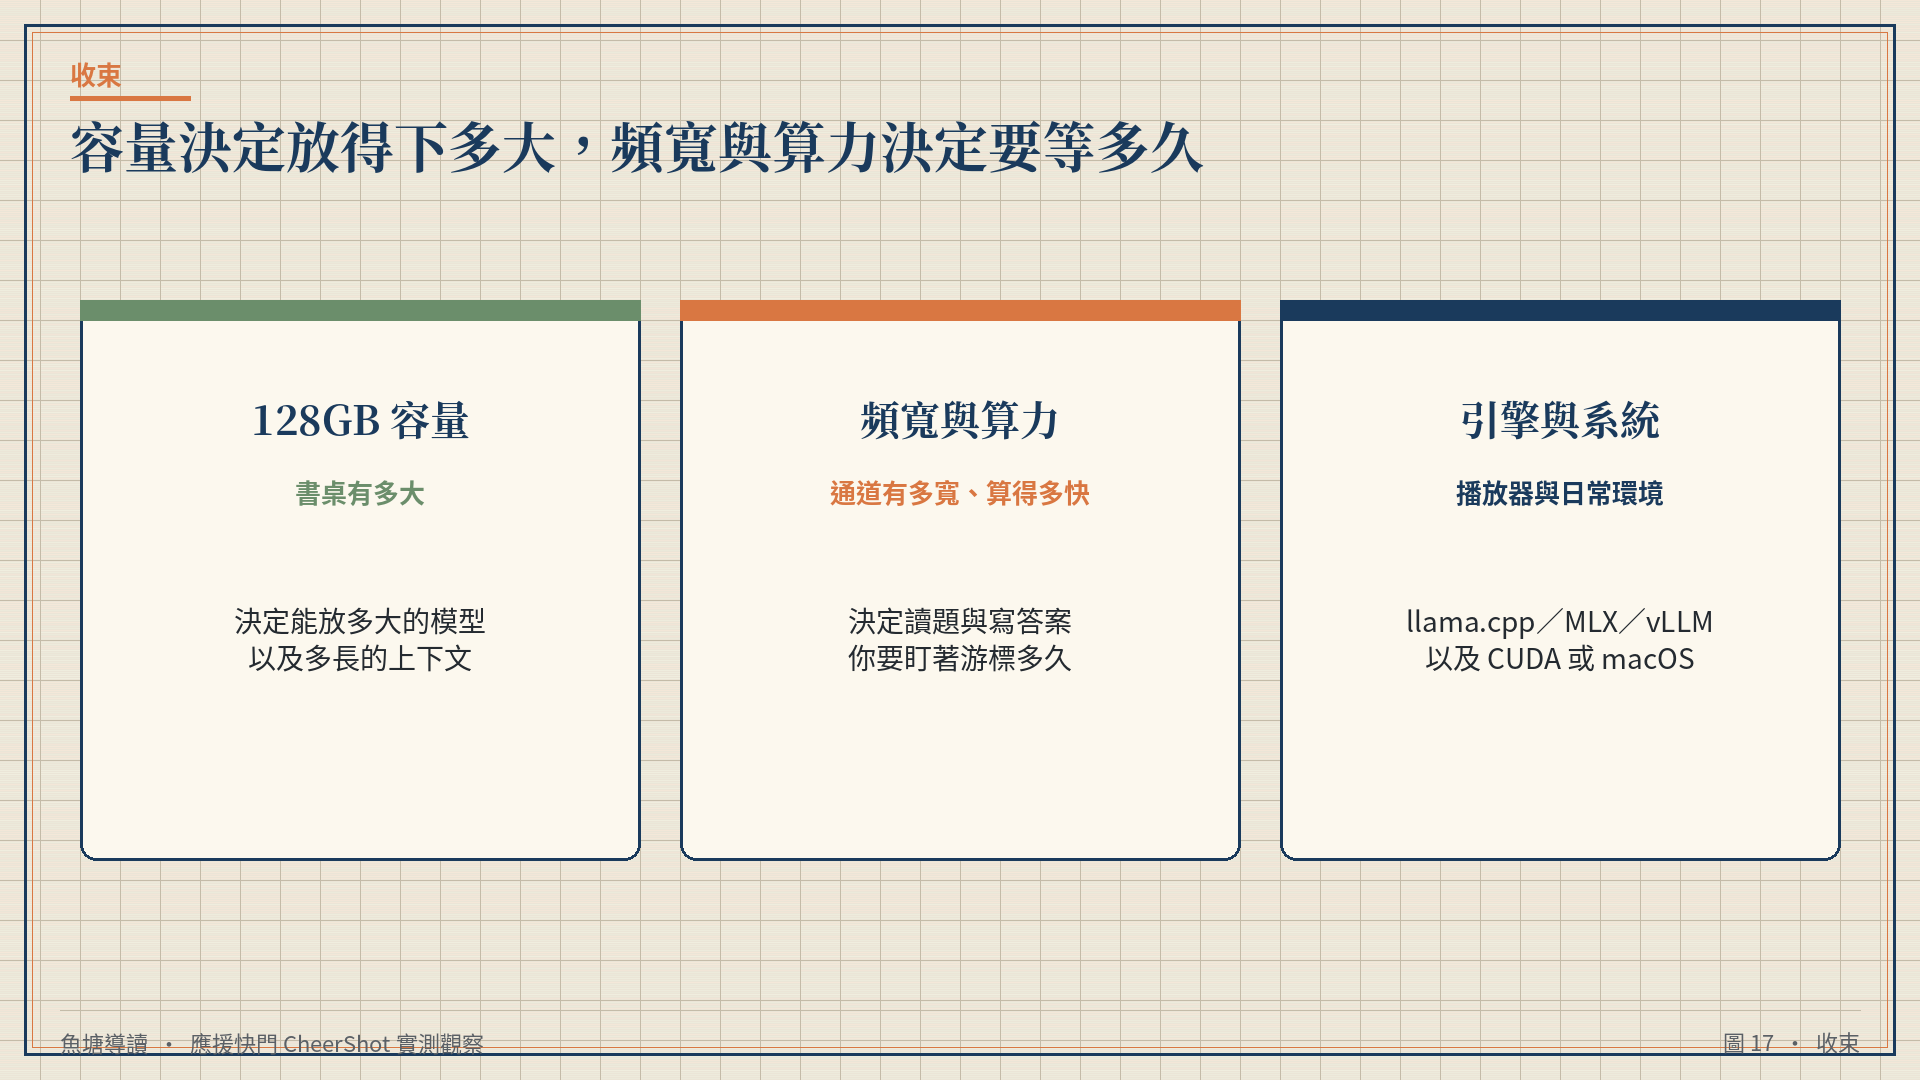
記憶體容量決定能放多大的模型,頻寬和算力才決定你要等多久。現在回頭看開場的猜測,如果把題目換成你自己每天的工作,答案很可能會改變。這或許才是這支 15 分鐘對照真正留下的東西:不是幫哪一臺機器站邊,而是讓「誰比較快」終於問在正確的段落上。
💡 給讀者的 Takeaway
- 在影片的測試裡:讀題偏 Spark,寫答案與多人合計產量偏 Mac;引擎選擇可以大幅改寫長檔案的等待。
- 1TB 配置在講者查價當日只差約一萬元,但受測 Spark 是 2TB,報價不能直接當成測試機售價。
- 真正要選的,往往是 CUDA/Linux 的開發與部署路徑,或 macOS 上日常工作加本機長回答,而不是單一速度冠軍。