010. 這支影片真正談的不是 Jev,而是 Claude Code 裡哪些判斷不該再交給大模型|來源與閱讀方式
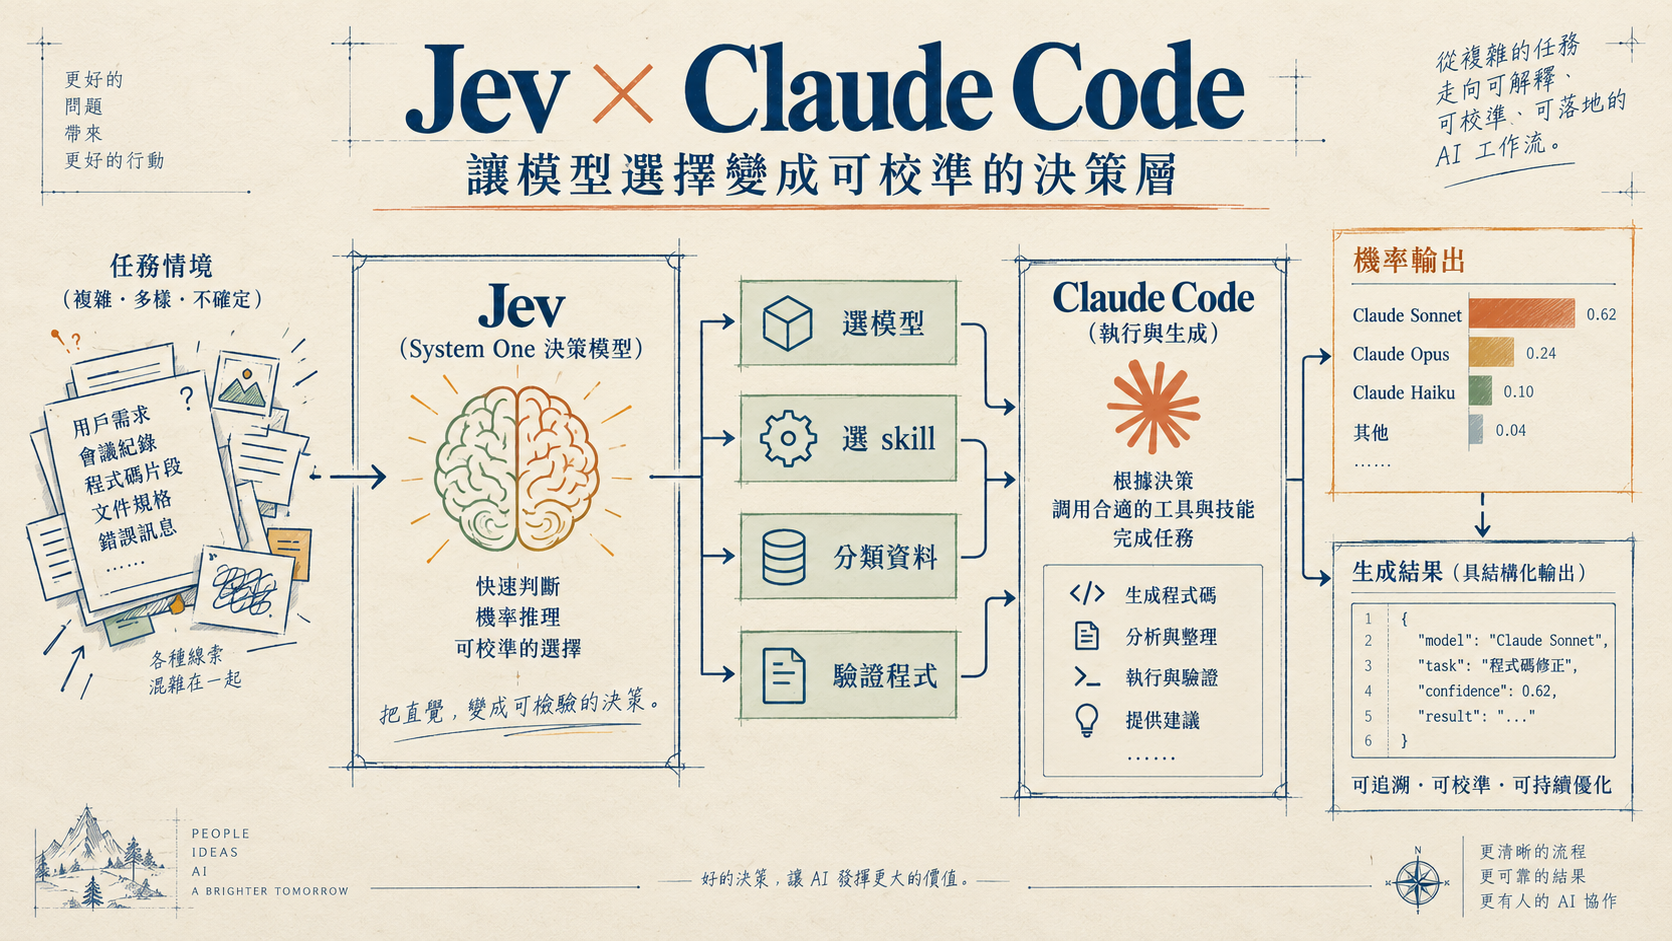
Gary Chen 這支影片〈Jev + Claude,男女搭配,幹活不累〉表面上是在介紹 Jev 怎麼接進 Claude Code,但它更有意思的地方,是把 AI agent 工作流拆成兩種完全不同的動作:一種是生成、推理、修復、規劃;另一種只是選擇、篩選、排序、打分。
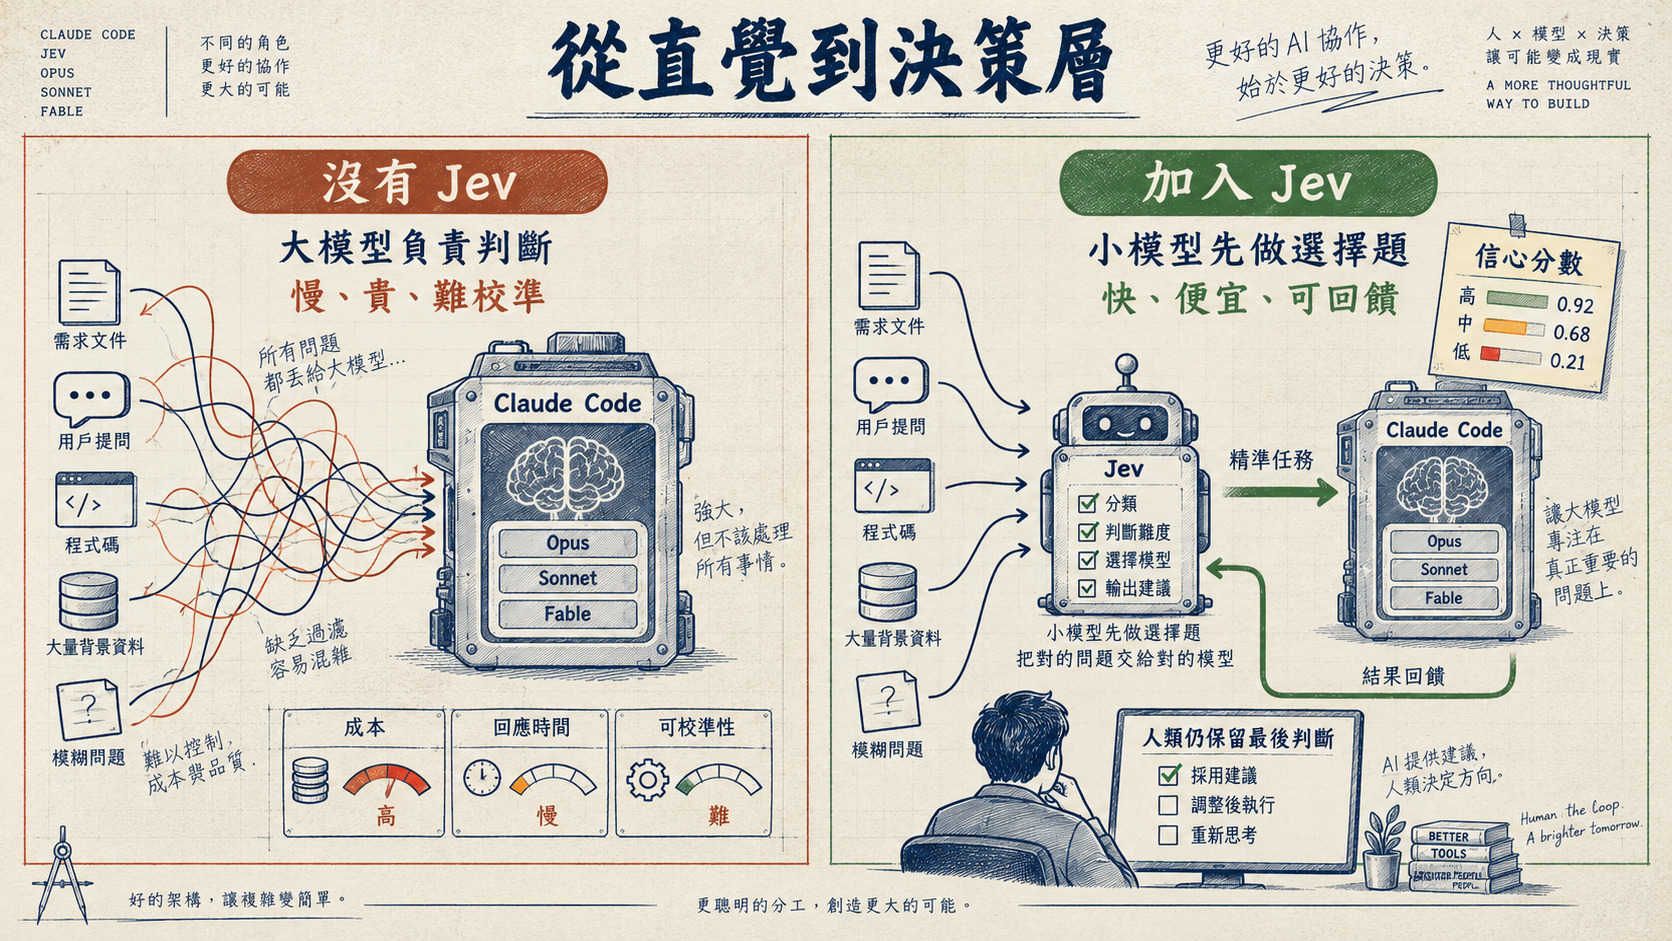
前者仍然適合交給 Claude 這類大型模型。後者如果每次都動用旗艦模型,就像請資深架構師每天坐在門口判斷「這張表單該交給哪個部門」:不是不能做,而是太慢、太貴,也浪費注意力。影片的核心主張是,Jev 這類 System One model 可以把這些高頻、低延遲、可枚舉選項的判斷,從大模型身上拆出來,變成 Claude Code 前後的一層決策神經。
這篇導讀會保留一點編輯距離。影片中提到的速度、成本與社群案例,本文都以「講者表示」「影片整理」的語氣呈現,而不是把所有數字寫成已被第三方驗證的客觀事實。原因很簡單:Jev 的價值不在單一 benchmark 的漂亮數字,而在一個更值得帶走的架構問題:你的 agent 工作流裡,哪些步驟其實只是選擇題?
如果這個問題問對了,Jev 只是第一個答案。未來無論是 TypeSafe、OpenAI、Anthropic,還是其他專門化模型供應商,大家都會往同一個方向走:把「深度思考」和「快速決策」拆開,讓不同形狀的模型各做各的事。
021. Jev 的定位:不是聊天模型,而是工作流裡的選擇題引擎|System 1 不是比較笨,而是比較快
影片一開始把 Jev 說得很直白:這個模型基本上只做一件事,做選擇題。你給它資料、問題和幾個選項,它不回長文,不展開推理鏈,也不試著寫一段漂亮的自然語言答案,而是回傳每個選項的機率。
這個形狀和一般 LLM 很不一樣。一般聊天模型擅長把複雜脈絡整理成文字,擅長解釋、規劃、寫程式、修 bug、寫信、寫文件。但當你真正把 AI 放進產品或工程工作流裡時,很多任務其實不需要一段文字。它們只需要一個決策:這個 request 要不要升級?這段程式要不要 review?這個 skill 該不該載入?這筆資料屬於哪一類?
Gary 用 Kahneman 的 System 1 / System 2 來說明:Jev 是 System 1,負責快速、直覺、低延遲的反射;Claude、Fable、Astra 這些大模型則更像 System 2,負責深度推理。這個比喻不代表 System 1 比較低級,而是代表它被設計來處理不同型態的問題。
在 Claude Code 的脈絡裡,這個差異會變得很實際。開發者每天丟給 Claude Code 的任務,並不全都需要大模型完整出手。有些只是「找檔案」「格式轉換」「看函式參數」「判斷要載哪個工具」。如果這些判斷都由昂貴模型自己做,成本和延遲會在看不見的地方累積。
影片建議的接法也很直接:拿 TypeSafe 的 API key,或透過 OpenRouter 接入,然後請 Claude Code 讀官方文件,把某些判斷包成一個 skill 或開關。開關打開時,對話中適合做判斷的步驟優先丟給 Jev;關掉時,Claude Code 回到原本流程。這個設計的好處是可比較:同一批任務,打開跑一次,關掉跑一次,你可以看 token、延遲、品質是否真的變好。
魚塘的讀法是:不要急著把 Jev 當成「新玩具」,而要把它當成一個檢查清單。凡是答案可以事先枚舉、可以定義選項、可以用信心分數決定下一步的地方,都可能是 Jev 的位置。凡是需要真正理解需求、創造方案、處理開放式 trade-off 的地方,還是該留給 Claude。
032. 第一個接入點:讓 Jev 幫 Claude Code 選模型與選 skill|省下來的不只是錢,還有 context
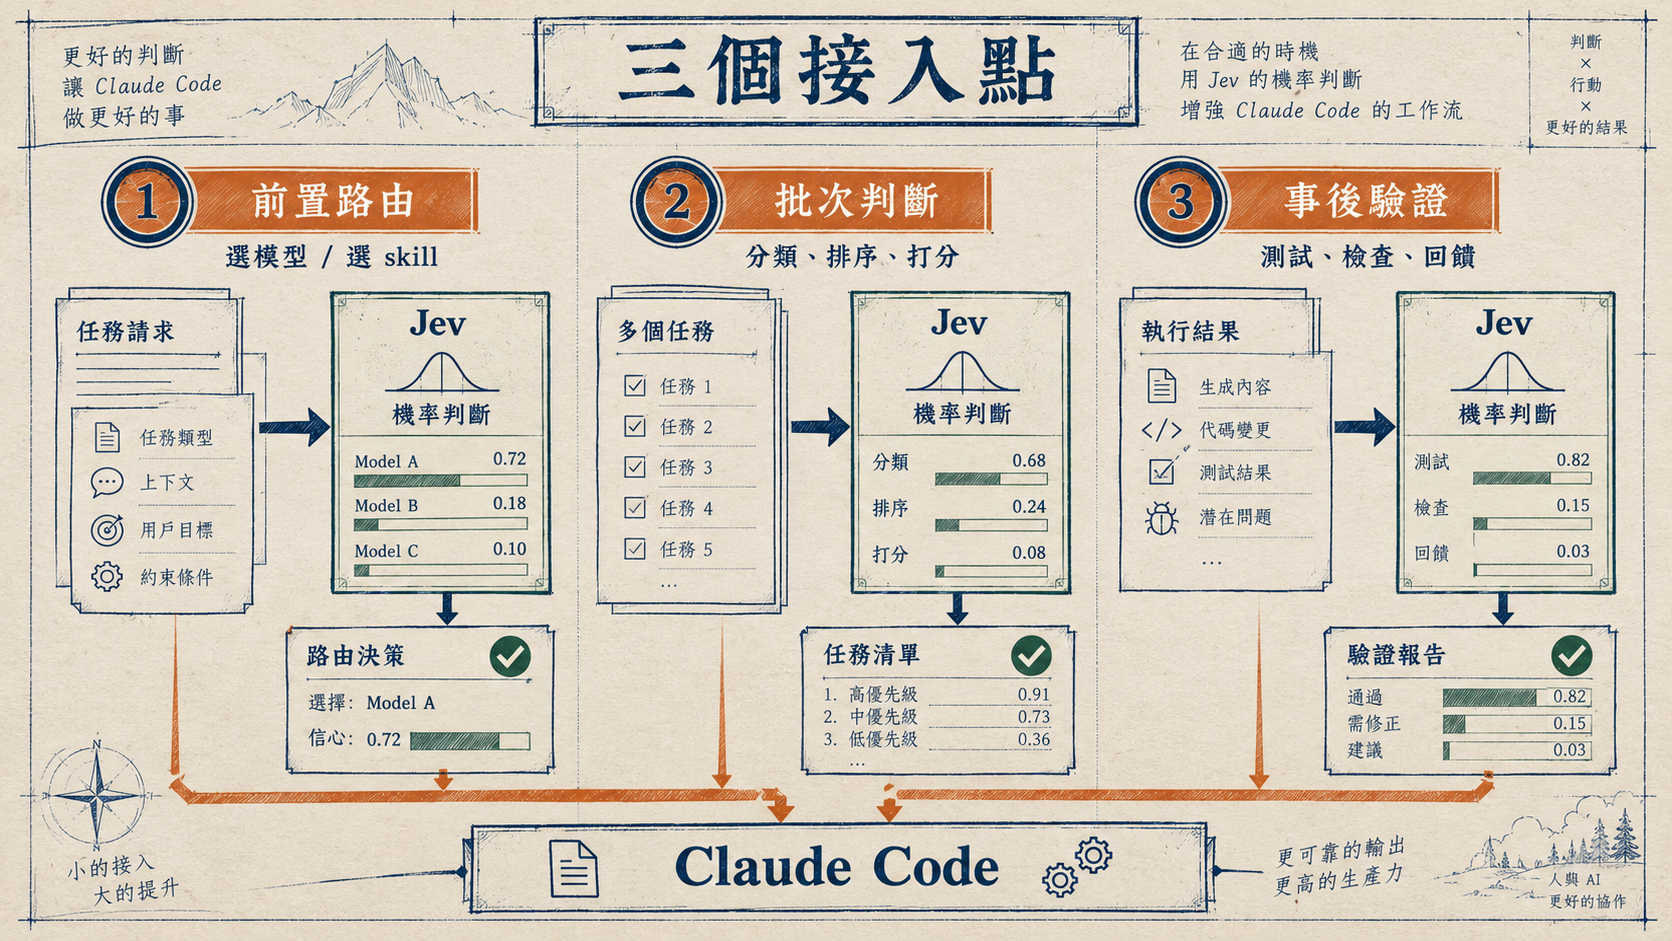
影片最推薦先試的,是把 Jev 放在 Claude Code 的前置路由層。這一層做兩件事:選模型,選 skill。
選模型的痛點很日常。很多人開著 Opus 或 Fable 一路用到底,原因不是每個任務都需要它,而是手動切換模型太麻煩。你不會每打一行 prompt 就停下來問自己:這題要 Haiku、Sonnet、Opus,還是 Fable?久了之後,人就會偷懶,把所有事情都丟給最貴、最強、也最慢的模型。
Gary 提到一組社群對照測試:同樣 12 個任務,一組全部交給 Fable 5.1,另一組先讓 Jev 做路由。影片說,這 12 題裡有 9 題不需要頂級模型,整體花費省了約 70%。他也拿自己七月做過的 model routing 測試對照:當時把規劃、執行、review 拆給不同模型,成本降了 54%;差別在於那是人手動切分,而現在這個判斷可以每次 prompt 都動態重做。
這裡的重點不是「70%」這個數字本身,而是決策權的位置變了。以前模型路由是人類事先設計好的規則:規劃用 A、執行用 B、review 用 C。Jev 代表另一種做法:每次任務進來,先由一個便宜、快速、只負責選擇的模型判斷任務難度,再把任務送到對應模型。
選 skill 則更貼近 Claude Code 使用者。skill 裝得越多,名稱與描述就越可能被塞進 context。裝到一百多個 skill 時,每次對話都可能先燒掉大量 token,只是為了讓 Claude 知道手上有哪些工具。更麻煩的是,大模型還得在這張長清單裡挑出適合的工具,速度會被拖慢,選錯也不是不可能。
影片提到,社群有人在 145 個 skill 的工作區測試 14 次,讓 Jev 挑出相關 skill,總共花不到 5 秒;若交給 Opus 5 自己挑,接近 30 秒。TypeSafe Cookbook 的另一組測試則是 182 個 skill,大模型 agent 自己挑的錯誤比例為 17%,先讓 Jev 做推薦篩選後降到 7.3%。這些數字仍需看測試設計,但方向很清楚:skill selection 本質上就是一道多選題。
這也是為什麼這個接入點門檻最低。它不要求你改變平常怎麼使用 Claude Code,只是在前面多放一個判斷層。它不直接產出你的程式碼,也不直接替你做最終決策;它只是替大模型整理工作台,把不需要出動大腦的判斷先做掉。
比較成熟的做法,會把它包成開關,而不是永久全開。因為模型降級一定有風險:某些團隊的工作容錯率很低,某些任務表面簡單但其實藏著語境。最好的導入方式,是先拿自己最常做的任務跑 A/B test:打開 Jev 跑一次,關掉 Jev 跑一次,比 token、比時間,也比結果是否真的能用。
043. 第二個接入點:把海量資料分類、排序、打分丟給 Jev|Claude 只處理被篩出的精華
如果第一個位置是替 Claude Code 省錢,第二個位置就是讓很多以前做不起的工作變得可做。影片把它稱為海量資料的分類與打分。
這類任務有一個共同特徵:資料很多,但每一筆都在問同一個問題。例如,這則留言是正面、負面、產品建議,還是未回覆問題?這位潛在客戶是不是決策者?這個會員下個月會不會流失?這段訪談是不是適合剪成短影音?這些問題不是沒有語意難度,但它們的輸出空間通常可以枚舉。
Gary 整理了幾個社群案例。影片說,有人拿 1400 則 YouTube 留言分成五類,讓 Opus 5 用同樣 prompt 跑,花了 34 分鐘、23 美元,還有幾則沒分類到;交給 Jev 則是幾十秒、幾美分。另一個案例是 250 位潛在客戶意向打分,依「是否決策者」「是否在美國」等條件評分,影片稱 Jev 4 秒跑完、成本 1 美分。還有 203 位新會員流失風險、1300 則社群貼文分流、227 通客服電話逐字稿歸類等案例。
這些案例背後的流程不是「Jev 取代 Claude」,而是「Jev 先粗篩,Claude 只處理精華」。例如幾千個潛在名單先由 Jev 批次打分,只有分數最高的幾十個,才交給 Claude 做背景調查、撰寫客製化開發信。這樣大模型 token 就花在高槓桿環節,而不是花在一筆一筆做初篩。
內容創作者也能理解這件事。影片提到,長訪談可以先切成幾百個語意片段,讓 Jev 為每段評分,再拉出排名前 10 的高分片段後製。Gary 說他自己不是要讓 AI 取代審美,而是把它當作第二雙眼睛,找回人類疲勞時可能漏掉的金句。
這個說法其實很重要。Jev 擅長的不是「決定什麼最有品味」,而是用一致的規則掃過大量候選,幫人類縮小選擇範圍。它降低的是搜尋成本,不是取消人的判斷。
魚塘會把第二個接入點整理成一句判斷準則:如果你的任務數量很大,而且每筆資料都在問同一個問題,它就是 Jev 的主場。發票可不可疑、Email 是不是垃圾信、留言有沒有違規、退款申請是否符合資格、會員是否可能退訂,都是同一類問題。
但反過來,如果每筆資料要問的問題都不一樣,或者答案不能事先枚舉,Jev 就不一定適合。此時你需要的不是高速選擇器,而是能理解情境、生成方案、承擔複雜推理的大模型。
054. 第三個接入點:放在程式寫完之後做自動化驗證|便宜的 feedback loop 才能真的跑很多輪
影片第三個位置,是把 Jev 放在程式寫完之後的驗證迴圈。這也是對工程團隊最有想像力的部分。
Agentic coding 的品質關鍵,不只是模型會不會寫程式,而是 feedback loop 夠不夠強。程式寫完要 review,review 抓出 bug 要修,修完要再驗證。問題是 review 與測試很貴:燒 token、耗時間,也吃人的注意力。Jev 這類模型如果能把大量語意檢查變便宜,就能讓「多跑幾輪」從口號變成日常。
Gary 提到四種玩法。第一種是語意式 linter。傳統自訂 lint 規則常要寫 AST 規則,對某些語意判斷很彆扭;但如果規則是「這個函式命名是否清楚交代副作用」「log 內容如果是密鑰或金額就報錯、敏感個資就警告」,這種檢查本身像選擇題,也適合用 Jev 做低成本掃描。
第二種是整個 codebase 的地毯式掃描。影片舉例,有人掃老專案註解,找出無意義或誤導性註解;前 150 條註解掃完約 9.3 秒,成本約 1 美分。後續還能掃 code smell,例如重複代碼、dead code、magic number。這類任務若用旗艦模型逐段細看,成本會膨脹;若先用 Jev 找出高風險候選,再由 Claude 或人類處理,就比較像可負擔的工程流程。
第三種是百問清單 code review。每個 PR 送出時,系統對改動拋出 100 個具體問題:有沒有動到不該動的共用模組?有沒有把既有測試改弱?會不會引入效能風險?Jev 先把這些問題評分,只有高風險項目交給 Claude 深度審查。影片說社群估算這能把真正需要人類或高階模型心智的審查內容砍到約十分之一。
第四種是大規模對抗測試。Gary 提到 Browser-use 團隊開發的 Jev 版 browser agent,以及同時併發多個無頭瀏覽器模擬使用者操作的做法。影片也提到 Sentry 資安工程師把 Jev 整合進漏洞檢測 pipeline,據稱準確率提升、延遲降低、成本比原先小型開源模型方案再低 5 倍以上。這些案例仍需看原始實作與評估方式,但它們指向同一個架構:低成本語意判斷,使得驗證可以高頻執行。
這一段最值得帶走的,不是某個工具名字,而是閉環。Jev 在第一線做成千上萬次快速條件判斷;Claude 在後端監控結果,發現偏差時調 prompt、調規則、調 threshold;調完再放回去跑。Gary 把它比喻成 System 2 訓練 System 1:一開始需要深度思考,練久了才會變成肌肉記憶。
工程上,這個比喻可以翻成一句話:你要保留慢模型對快模型的校準權。Jev 不是自己永遠正確的裁判,而是可以被訓練、被監控、被修正的快速判斷器。
065. 風險邊界:機率不是保證,省 token 也不是免責卡|threshold、eval、人類覆核都不能省
這支影片雖然整體偏樂觀,但中間也有幾個重要提醒。最關鍵的一句是:不要看到能省 70%,就無腦全開著不管。
這句話應該被放大。Jev 回傳的是機率分布,不是真理。高信心不代表一定正確,低信心也不代表一定錯。真正能不能放進工作流,要看你怎麼設定 threshold、怎麼收集 eval、怎麼設計 fallback,以及低信心或高風險任務是否會交回人類或大模型。
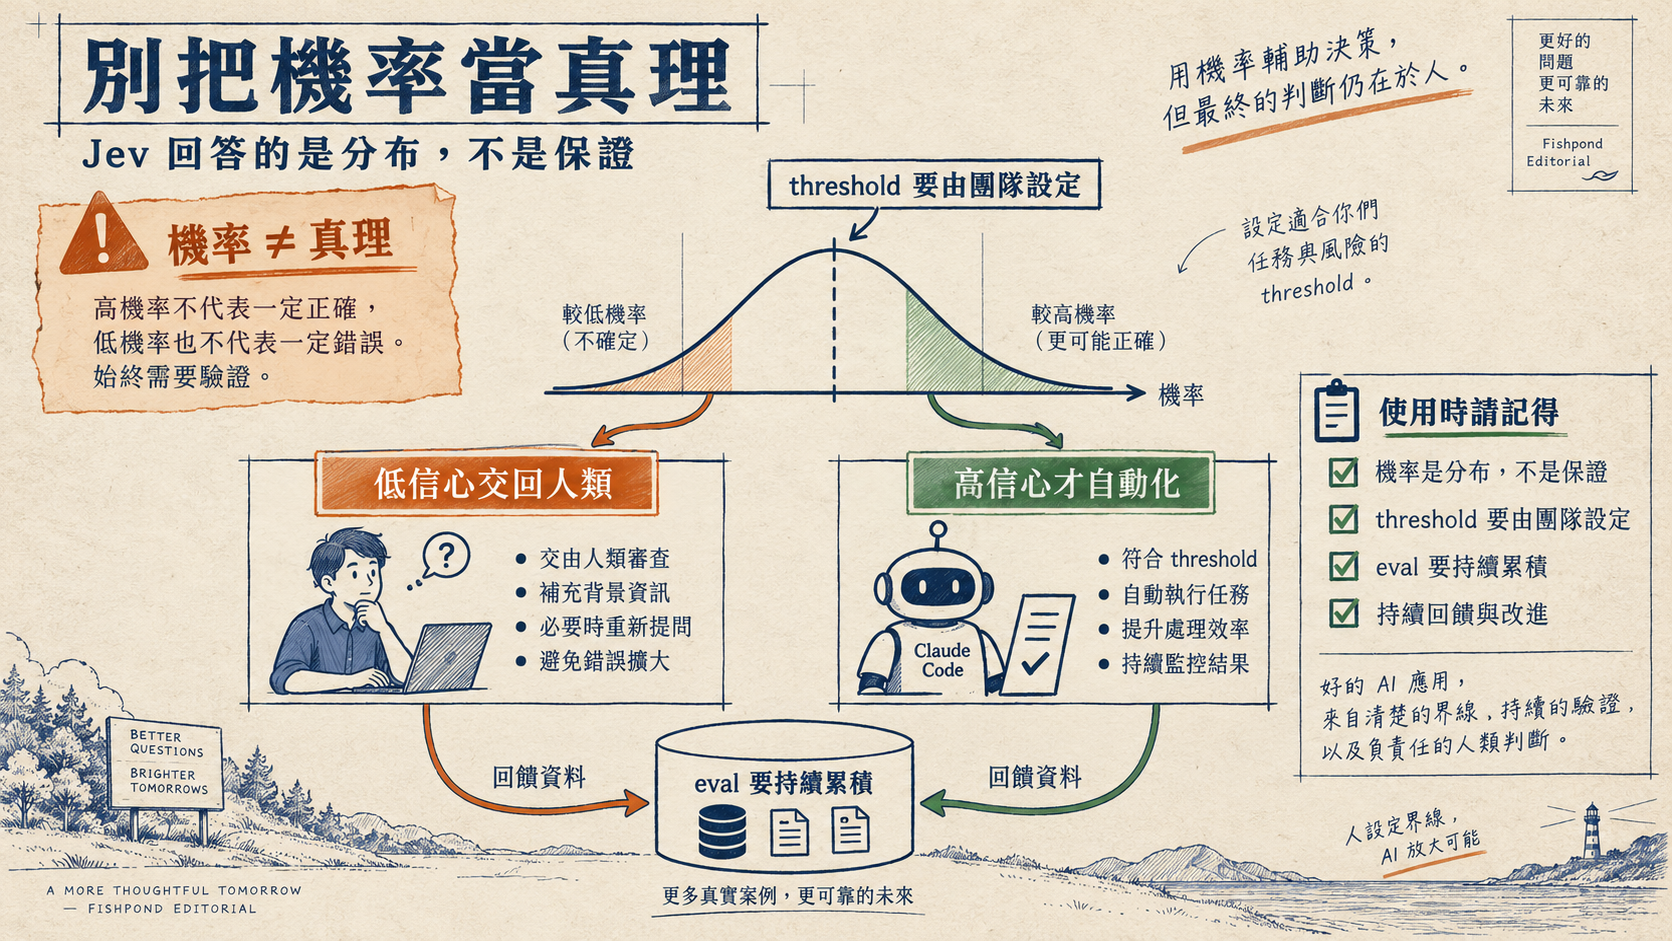
導入 Jev 最容易犯的錯,是把「便宜」當成「可以不用治理」。事實剛好相反:越便宜、越容易高頻自動化,就越需要清楚的界線。因為一個判斷如果只跑一次,錯了頂多修一次;如果它被包進 workflow,每天跑幾千次,錯誤就會被放大成系統性偏差。
所以魚塘會建議用四個問題檢查導入點。
第一,選項是否真的能枚舉?如果答案空間很模糊,硬塞成選擇題可能會遺漏重要情境。
第二,錯誤代價是否可控?留言分類錯一則,成本可能不高;資安漏洞錯放、金流風控錯判,就不能只看便宜。
第三,有沒有 ground truth 或回饋資料?沒有 eval,就無法知道 threshold 該設在哪,也無法知道模型是否漂移。
第四,低信心時怎麼辦?成熟 workflow 不會只問「自動化能不能跑」,而會設計「什麼情況必須停下來」。低信心、資料缺漏、選項分布太接近、任務高風險,都應該進入人工或大模型覆核。
這也是為什麼 Gary 建議先從模型選擇和 skill 選擇起手。這兩個位置通常比較不侵入最終產出,錯誤比較容易觀察,也容易做開關對照。等你對它的行為有信心,再把它推進資料分類、工程驗證、甚至 production pipeline。
076. 最後的架構信號:Coding Agent 會越來越像雙腦系統|System 1 + System 2 不是比喻,而是產品形狀
影片最後收束到一個大方向:未來成熟的 AI agent,很可能都有兩類大腦協同運作。旗艦大模型負責深度邏輯推理、開放式生成、修復與規劃;Jev 這類極速模型負責高頻直覺反射、選項判斷、資料篩選、風險打分。
Gary 也提到一個社群目錄 shipwithjev,收集各種 Jev 案例,並提到 OpenAI 在 DevDay 上也展示類似 Decisions API 的方向。這些具體產品細節仍需以官方文件為準,但架構信號已經很明顯:AI 應用不會永遠只靠一顆通用大模型包辦所有事情。
這其實也是 agent 工程正在發生的分工。過去我們把所有事情都塞進一個 prompt,期待模型自己決定工具、自己讀 context、自己判斷風險、自己產出答案。接下來的方向會更像系統設計:哪一步需要深思?哪一步只是路由?哪一步是批次分類?哪一步要回到人類?哪一步要進 eval?
Jev 的價值在於,它逼我們重新命名那些「看似需要 AI,其實只是判斷」的步驟。一旦命名清楚,就能被抽出來、被測量、被替換、被校準。
這也是這支影片最值得拿走的實作題:把你過去幾週的 Claude Code 對話或 agent workflow 打開,逐步標記哪些地方其實只是分類與篩選。每找到一個,就問三件事:選項能不能枚舉?錯誤代價能不能承受?有沒有資料可以驗證?三個答案都過關,它就可能是 Jev 的黃金位置。
不要把 Jev 想成下一個要崇拜的模型。把它想成一個提醒:大模型不應該負責每一次小判斷。好的 agent 系統,會把昂貴的思考留給真正值得思考的地方,把大量可枚舉的小決策交給更便宜、更快、也更容易被校準的層。