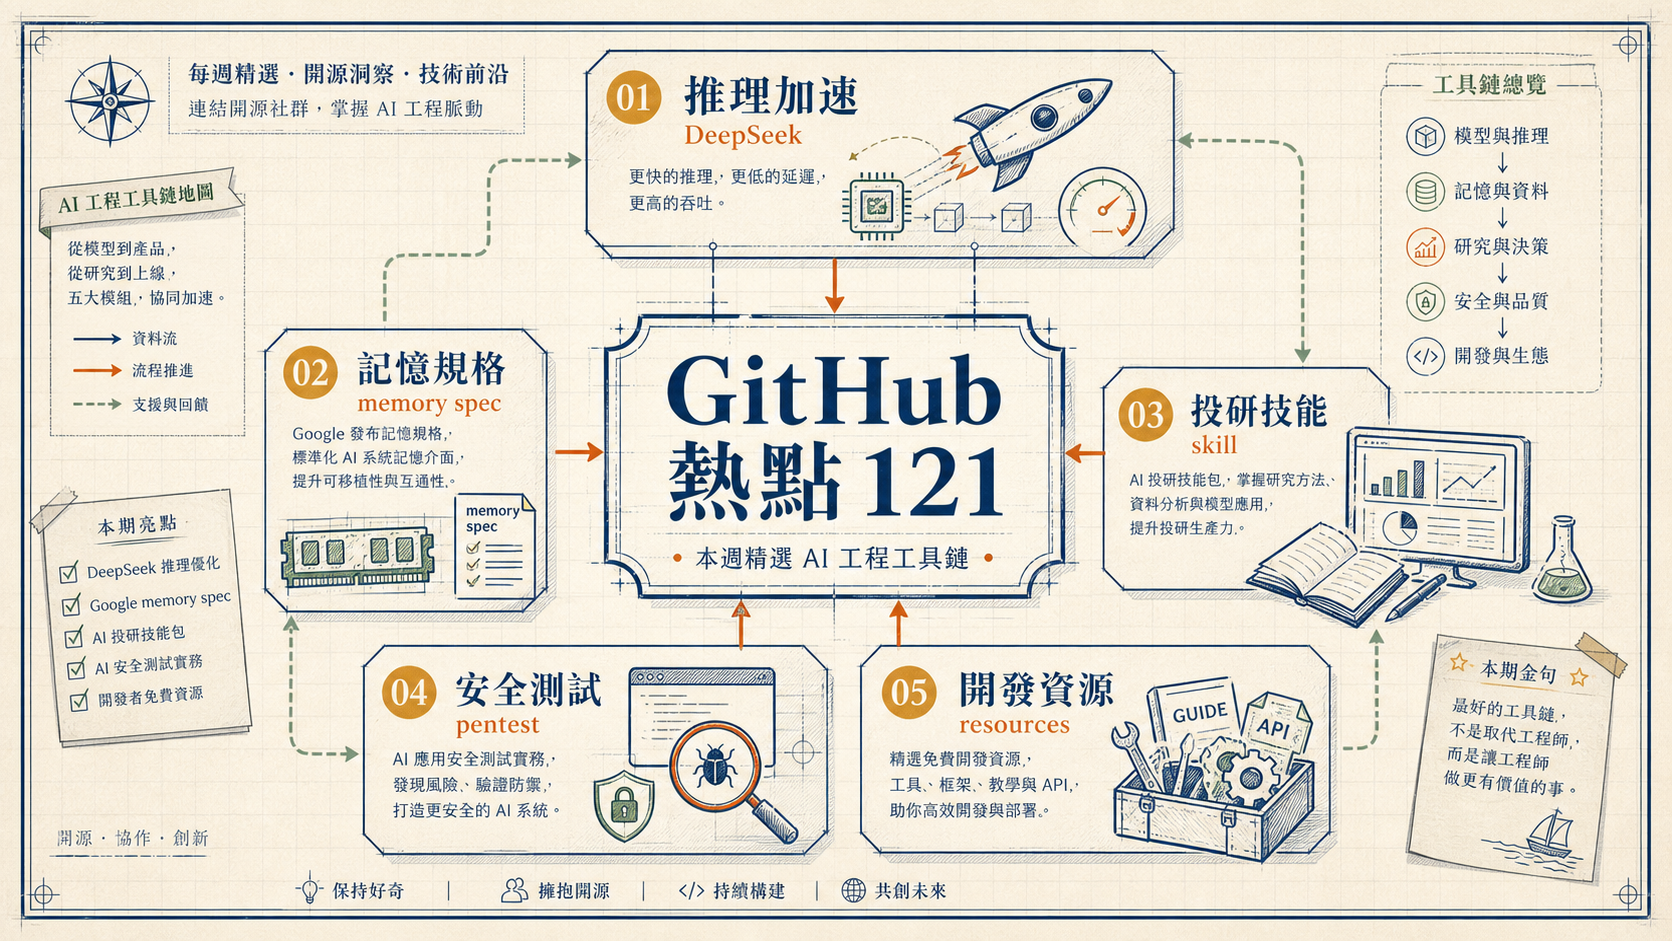
這篇導讀整理自 IT咖啡館的原始影片。影片說明欄列出的五個專案分別是 DeepSpec、DESIGN.md、AI Berkshire、Strix 與 free-for-dev。
010. 這期的關鍵不是五個工具,而是五個工程缺口|從模型能力走向系統能力
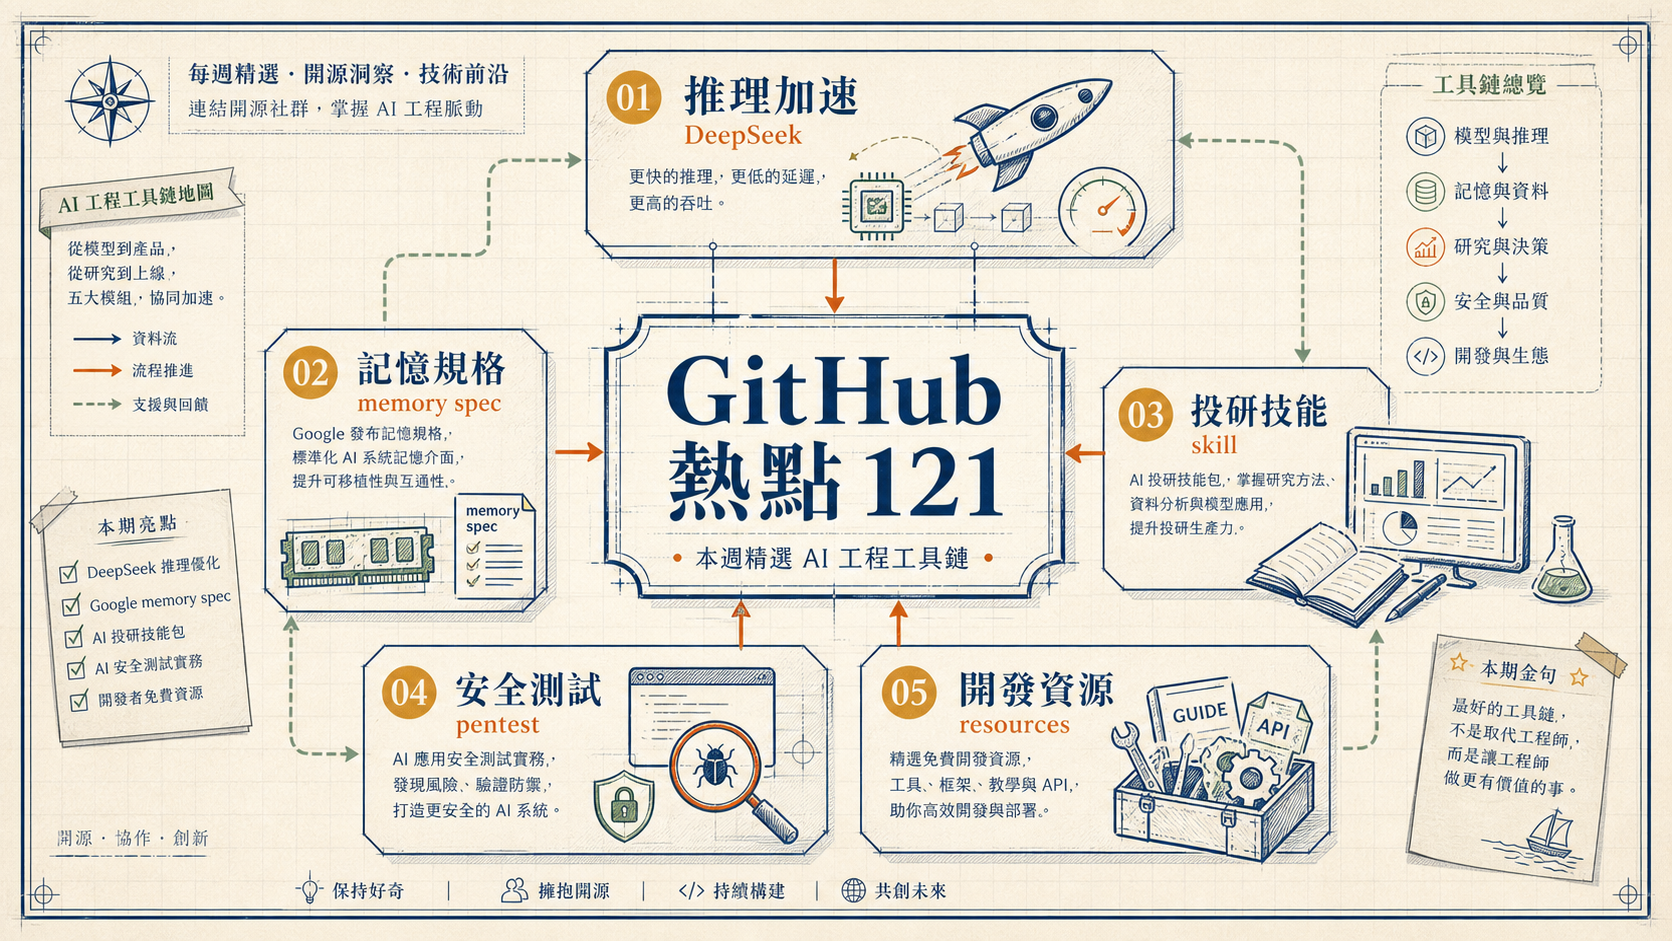
IT咖啡館第 121 期 GitHub 熱點表面上是一份工具清單:DeepSeek 相關的推理加速框架、Google Labs Code 開源的設計記憶格式、AI 投研技能包、AI 滲透測試 agent,以及開發者免費資源清單。它們看起來跨得很大,從模型推理一路到投資、安全、雲服務額度,像是五個彼此不相干的 repo。
但把它們放在一起看,這期其實有一條很清楚的線:AI 工具正在從「模型能不能回答」往「系統能不能長期工作」移動。長期工作需要的不只是更大的模型,還需要更快的推理、更穩定的記憶、更可重用的研究流程、更自動化的安全檢查,以及更低成本的開發資源。
這些需求都很樸素,也因此重要。當 agent 開始真的進入開發、研究、投資分析、安全測試和產品上線流程時,單次 demo 的驚喜會很快退場,剩下的是工程問題:延遲高不高?上下文會不會漂?分析流程能不能重跑?安全測試有沒有授權邊界?免費資源日後能不能遷移?
所以這篇不把第 121 期寫成「五個必收藏神器」。更好的讀法是:這五個專案各自站在 AI 工程化的一個缺口上。它們不一定都會成為長期標準,但每個缺口都是真的。
021. DeepSpec|推理加速正在從體驗問題變成成本問題
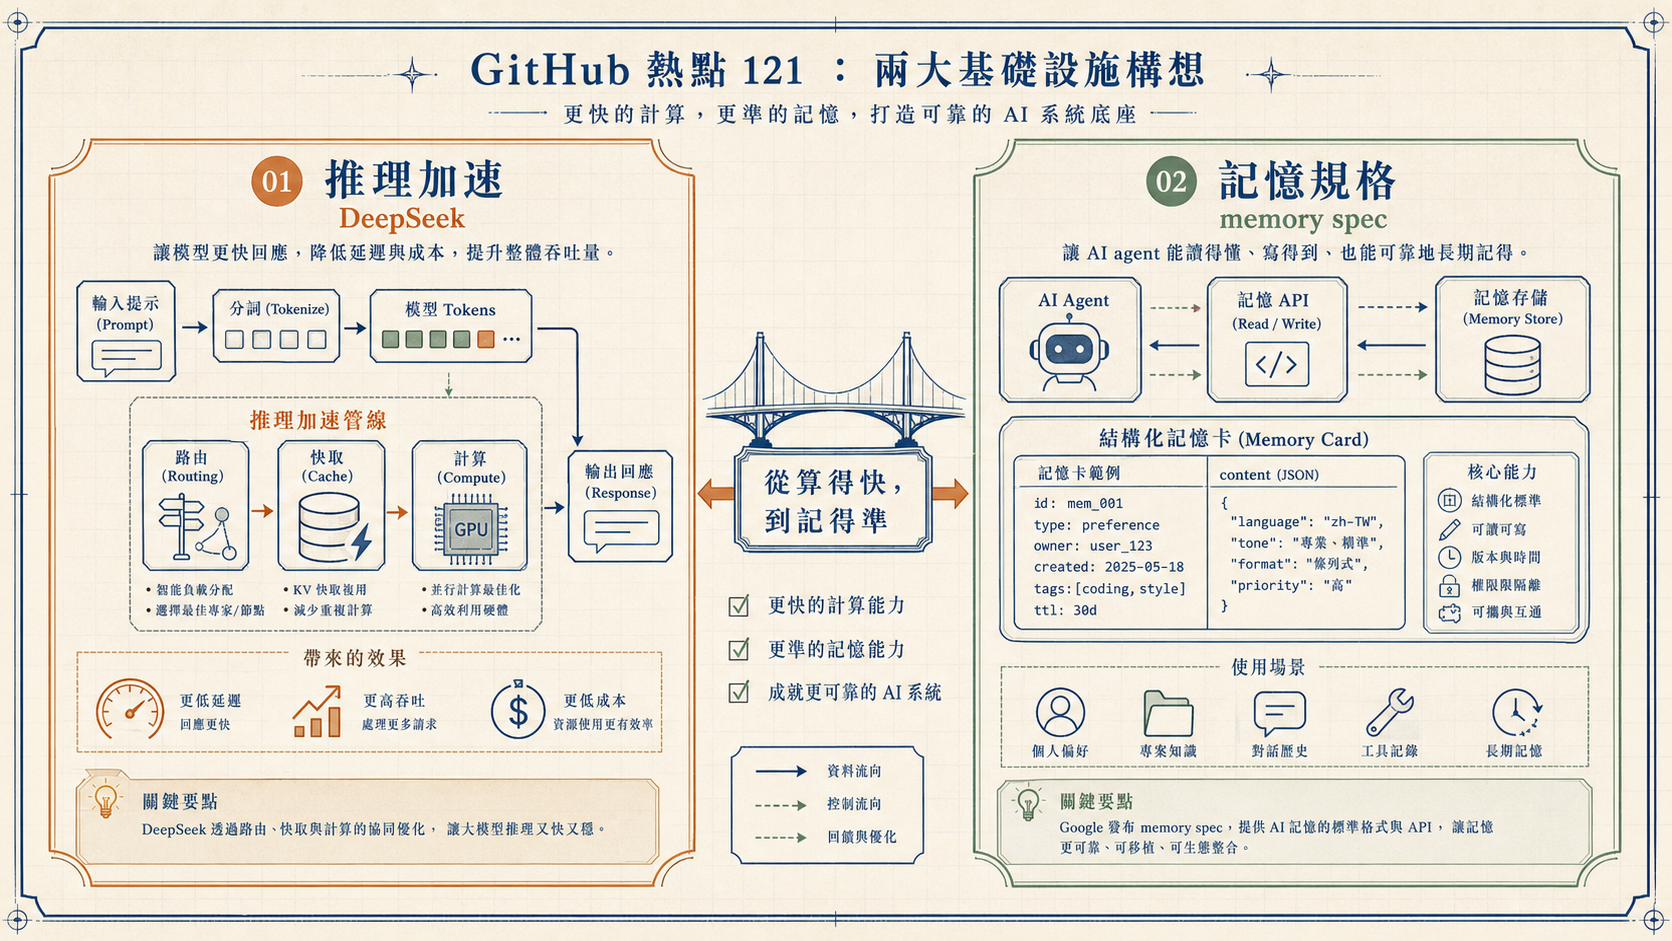
第一個專案是 DeepSeek 團隊相關的 DeepSpec。影片把它介紹成大模型推理加速框架,核心問題很直接:今天很多模型品質已經足夠強,但使用者真正使用時,最先感受到的瓶頸常常不是「答得不夠聰明」,而是「太慢」。
這在 coding agent 和多步驟 agent 裡尤其明顯。一次任務可能不是一問一答,而是連續讀檔、規劃、呼叫工具、修補程式、跑測試、再修一次。每一步如果都卡在 token 生成速度,整個工作流就會變得拖泥帶水。延遲不只是體驗問題,也會變成成本問題,因為更多等待意味著更低吞吐、更差併發、更難商業化。
影片對 DeepSpec 的說明,重點在 speculative decoding 一類的思路:讓較小、較快的 draft model 先猜測一段 token,再由大模型檢查與確認。猜對就省下生成步驟,猜錯再回退修正。這裡真正關鍵的不只是「有一個小模型幫忙」,而是小模型與主模型之間如何配合、如何訓練、如何在真實流量中維持穩定收益。
影片提到,DeepSeek 開放了論文、程式碼、checkpoint 與訓練流程,也提醒預設情況下資料快取或中間資料可能很大,某些設定會到數十 TB 等級。這代表它不是普通玩家隨手 clone 就能完整體驗的玩具,而更像是給模型服務、推理平台或高流量應用團隊研究的基礎設施零件。
影片也引用專案或公開資料中的加速數字,表示在系統總吞吐相同的情況下,部分 DeepSeek 服務的單使用者生成速度可提升約 57% 到 85%。這類數字需要放回測試條件理解,不能直接當成所有場景的保證;但方向很清楚:大模型競爭不會只比 benchmark,也會比誰能把模型跑得更快、更便宜、更穩。
從魚塘角度看,DeepSpec 值得注意的地方不在於一般開發者明天就要安裝它,而在於它提醒我們:AI 應用的下一輪瓶頸,會越來越靠近系統工程。模型能力很重要,但推理層的吞吐、延遲、快取、路由與成本控制,會決定一個 agent 產品能不能從 demo 進入日常工作。
032. DESIGN.md|AI 前端最缺的不是靈感,而是穩定記憶
第二個專案是 Google Labs Code 開源的 DESIGN.md。影片介紹它最近在 GitHub 上很火,已經有超過兩萬 star。它的概念很簡單:給 AI 程式設計 agent 一個描述設計系統的標準 Markdown 檔案。
這個需求非常具體。很多人用 AI 做前端時都遇過類似情況:第一輪做得還不錯,第二輪叫它加一個彈窗,它順手把按鈕樣式、間距、色彩、圓角甚至整個品牌氣質都改了。這不一定是模型不懂設計,而是它沒有穩定、可引用、可更新的設計記憶。
DESIGN.md 想解的就是這個問題。按照影片說法,它把一個產品的視覺身份寫成一個 Markdown 檔案:前半部是 YAML frontmatter,放機器可讀的 design tokens,例如顏色、字型、圓角、間距和元件樣式;後半部用 Markdown 說明這些設計如何使用,例如品牌該偏嚴肅、年輕、工具感,還是更消費化。
這件事看似小,其實是 AI 工程化裡很重要的一層。過去我們習慣把設計系統放在 Figma、Storybook、CSS variables 或元件庫裡;但 AI agent 工作時,最常讀到的是文字。若設計規範能用一個既給人看、也給模型看的格式描述,它就可能成為跨工具的設計記憶。
影片也提到 DESIGN.md 可以配合 Google 的 Stitch 使用,在 Stitch 裡匯入或匯出,讓設計風格跨專案、跨工具流動。這裡仍要保留距離:專案目前還在 alpha,離真正成為行業標準有很長一段路。但它抓到的問題是準的。
AI 前端不是只缺更會畫畫的模型,而是缺讓模型不要失憶、不要亂改、不要每次從零理解品牌的機制。DESIGN.md 代表的不是一個檔名,而是一種趨勢:把審美、品牌和介面規則工程化,讓 agent 可以讀、可以遵守,也可以在修改時被檢查。
043. AI Berkshire|投研技能包把價值投資變成可執行流程
第三個專案是 AI Berkshire。影片把它介紹成一套同時相容 Claude Code 和 Codex 的投資研究 skill 合集,靈感來自巴菲特、芒格、段永平、李錄等價值投資代表人物的方法論。
這類專案最容易被誤讀成「AI 幫你選股」。但影片其實也提醒,它提供的是價值投資研究輔助,不是告訴你某支股票明天會漲還是會跌。這點很重要。真正值得看的,不是它能不能給出神奇標的,而是它如何把研究流程拆成 agent 可以執行的技能。
按照影片介紹,AI Berkshire 把投研方法拆成 18 個研究技能,可以用來做公司深度研究、財報精選、行業篩選或持倉管理。它的工作方式也有多 agent 色彩:不同 agent 從不同角度獨立研究,再由 team lead 綜合。這其實很接近投研團隊本來的工作分工,只是把部分流程交給 AI 執行。
從工程角度看,這比「請 AI 分析某公司」更有價值。好的投研不是一次聊天,而是一套可重複的方法:先理解商業模式,再看財報,再比同業,再檢查風險,再回到估值與安全邊際。若 skill 能把這些步驟明確化,至少可以降低漏看資料、草率下結論或只聽單一敘事的風險。
但投資場景一定要守住邊界。專案作者或影片中提到的收益紀錄,只能視為作者自述與案例,不能當成效果保證。AI 也不會替你承擔風險,更不會讓市場變得簡單。尤其在波動高、資訊雜、敘事強的市場裡,agent 最有價值的角色應該是整理、檢查、反問與保存研究脈絡,而不是替人按下買賣鍵。
所以 AI Berkshire 代表的趨勢是:專家方法論正在被包成可安裝、可呼叫、可重跑的 skill。投研只是其中一個例子。未來法律、醫療、採購、營運、顧問等領域也可能走類似路線,把「一位有經驗的人怎麼做事」拆成一組 agent 可以遵循的程序。
054. Strix|AI 寫碼越快,安全測試也必須變成流程的一部分
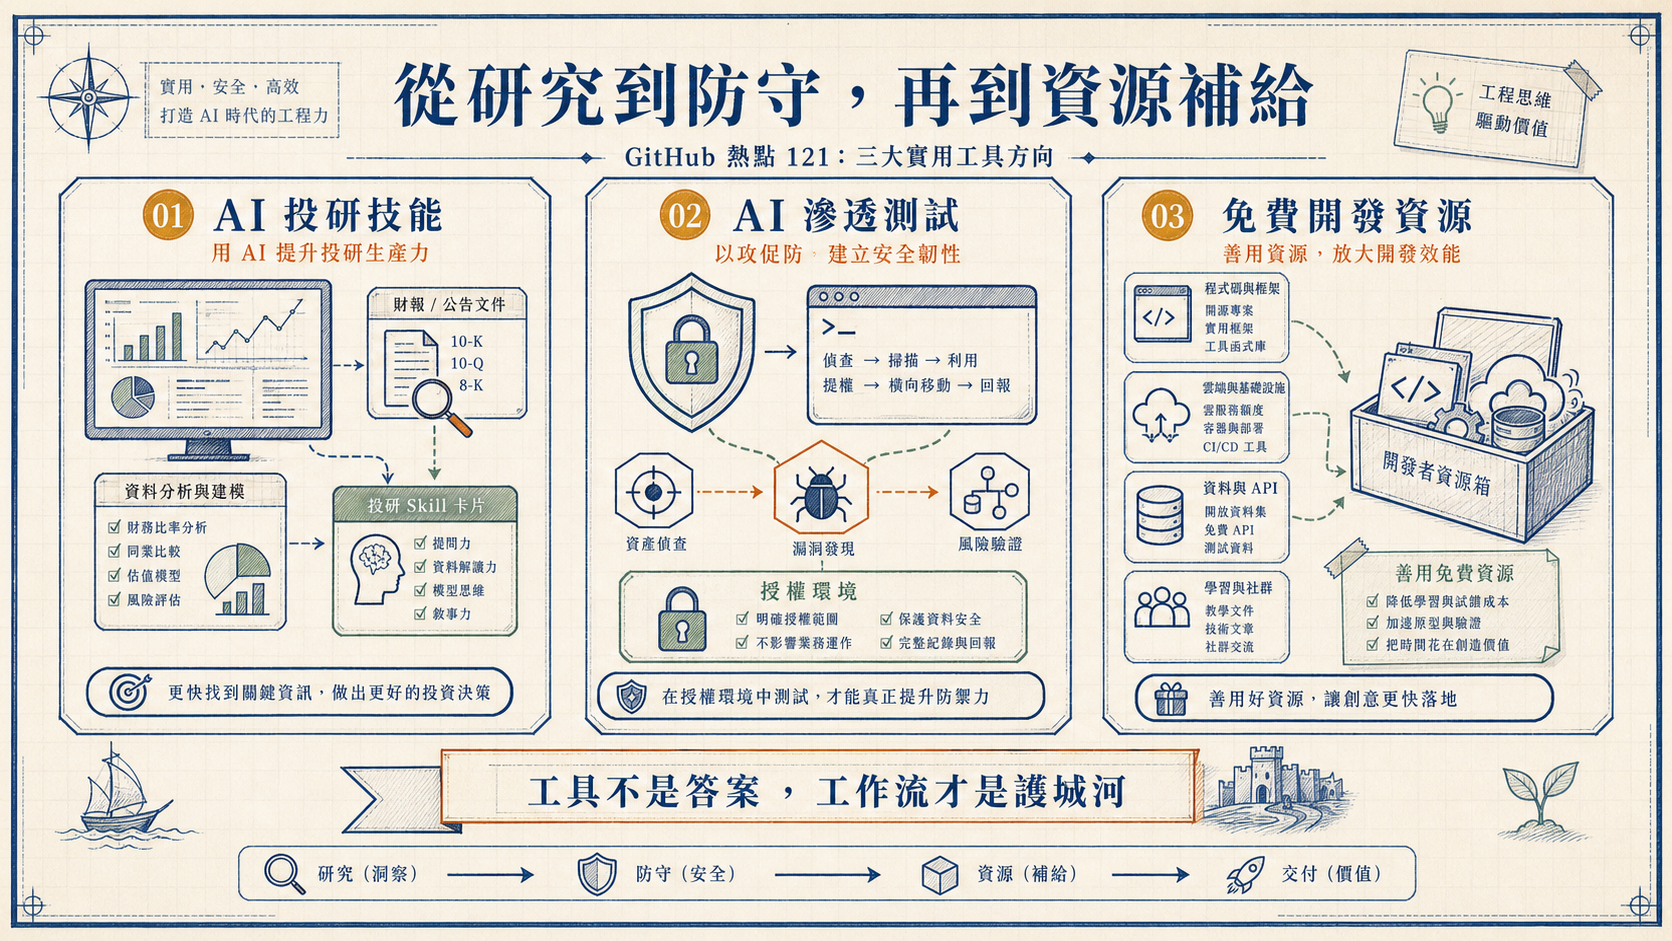
第四個專案是 Strix,影片介紹它是一個開源 AI 滲透測試工具,目標是讓 AI agent 發現、驗證並協助修復應用漏洞。
這裡的背景很現實:AI 讓程式碼生成速度變快,但漏洞產生速度也可能跟著變快。以前一個功能要寫很久,安全審查還有機會跟上;現在一個人可以用 agent 快速產出大量功能,如果安全檢查仍完全靠人工,成本與延遲都會被放大。
影片把 Strix 與傳統掃描器的差異放在「中間地帶」:它不只是掃描和列報告,而是嘗試動態執行、驗證漏洞、產生 proof of concept,甚至協助修復。影片提到它包含偵查、漏洞利用、驗證、瀏覽器自動化、HTTP proxy、shell 命令執行、Python sandbox,以及靜態與動態程式碼分析等能力;也支援掃描本地程式碼庫、GitHub 倉庫或黑盒 Web 應用,並可放進 headless 模式或 GitHub Actions。
這些能力如果成熟,確實很適合進入 DevSecOps 流程。理想情況下,agent 不只在開發時幫你寫 feature,也在 PR、CI、部署前幫你檢查漏洞路徑,並把可驗證的風險交給人類安全工程師判斷。
但安全工具一定要把授權邊界寫在最前面。能自動偵查、利用、驗證漏洞的 agent,不應該被拿去掃描未授權目標。真正合理的使用場景,是自己的程式碼、自己的測試環境、明確授權的靶場,或公司內部規範允許的安全流程。AI 滲透測試的價值,不是讓攻擊更容易,而是讓防守更跟得上開發速度。
Strix 這類工具的長期意義在於:安全不再是產品快完成時才補的一道人工關卡,而是被放進 agentic workflow 裡的持續檢查。當 AI 寫碼加速,安全工具也必須跟著自動化,否則整條交付線會失衡。
065. free-for-dev|免費資源清單其實是在降低創業和學習的啟動摩擦
最後一個專案是 free-for-dev。它是非常老牌的開發者免費服務清單,影片提到目前已接近 13 萬 star,整理各種對開發者有免費額度的 SaaS、PaaS、IaaS 和開發工具,包含雲伺服器、物件儲存、資料庫、CI/CD、日誌、郵件、身份認證等。
這類清單看起來不像 AI 專案,卻很適合放在這期最後。因為 AI 工具再強,產品要落地仍然需要一堆外部服務。你要部署、要資料庫、要寄信、要監控、要登入、要排程、要儲存檔案。對獨立開發者、學生、開源作者或早期團隊來說,找到合適的免費額度,往往就是能不能低成本試錯的差別。
free-for-dev 的價值不只是「免費」兩個字,而是降低篩選成本。今天很多服務都有免費層,但規則五花八門:有的按請求數,有的按流量,有的按儲存量,有的只免費一年,有的需要信用卡,有的地區限制明顯。若每次都逐一查官網,時間成本會很高。
不過,免費資源不能被當成永久地基。影片也提醒,免費服務的額度、地區、穩定性和風控規則都可能變動。對真正要上線的產品來說,早期用免費額度很合理,但架構上要保留遷移空間:資料能匯出,服務能替換,帳號風險能隔離,成本模型能提前估算。
從 AI 工程角度看,free-for-dev 其實補的是「資源補給」這一層。agent 可以幫你寫程式、查文件、跑測試,但產品終究要上線。免費資源清單讓小團隊更快把 demo 變成可訪問的服務,也讓學習者能在沒有大預算的情況下接觸真實開發環境。
076. 兩份報告把工具拉回商業現實|AI 價值鴻溝與物理 AI
影片最後還分享兩份報告:一份是 Roland Berger 關於「跨越 AI 價值鴻溝」的報告,另一份是 Deloitte 關於物理 AI 的報告。雖然影片說明欄沒有附報告連結,但這兩個主題剛好把前面的工具清單拉回更大的商業背景。
第一個關鍵詞是 AI 價值鴻溝。影片提到,許多企業 AI 部署速度很快,預算也在增加,但真正賺到錢、提升利潤的速度沒有跟上。這個現象很值得放在第 121 期一起看:DeepSpec 關心推理成本,DESIGN.md 關心一致性,AI Berkshire 關心研究流程,Strix 關心安全,free-for-dev 關心資源成本。它們共同回答的其實都是同一個問題:AI 怎麼從「看起來很強」變成「真的能產生可持續價值」。
第二個關鍵詞是物理 AI。影片提到物理 AI、機器人與具身智慧仍處在企業採用比例不高、但未來幾年預期提升的階段。這與前面的 GitHub 工具也有呼應:當 AI 從螢幕走向實體世界,工程化要求只會更高。延遲、記憶、安全、資源與工作流,不再只是軟體體驗問題,而會影響真實世界的可靠性。
所以第 121 期最值得帶走的,不是馬上安裝五個 repo,而是用它們檢查自己的 AI 工作流缺哪一層:
- 缺推理效率,就關注 DeepSpec 這類推理加速與系統吞吐工具。
- 缺設計一致性,就關注 DESIGN.md 這類可讀、可版本化的設計記憶。
- 缺專家流程,就關注 AI Berkshire 這類把方法論拆成 skill 的做法。
- 缺安全閉環,就關注 Strix 這類能進 CI/CD 的授權安全測試 agent。
- 缺低成本資源,就關注 free-for-dev 這類能降低啟動摩擦的清單。
AI 工程化的成熟,不會只表現在某個模型突然更會回答,而會表現在這些周邊零件越來越可組裝、可檢查、可替換。第 121 期的五個專案剛好湊成一張地圖:模型要跑得快,agent 要記得準,研究要有流程,安全要跟上交付,資源要支撐上線。工具不是答案,工作流才是護城河。