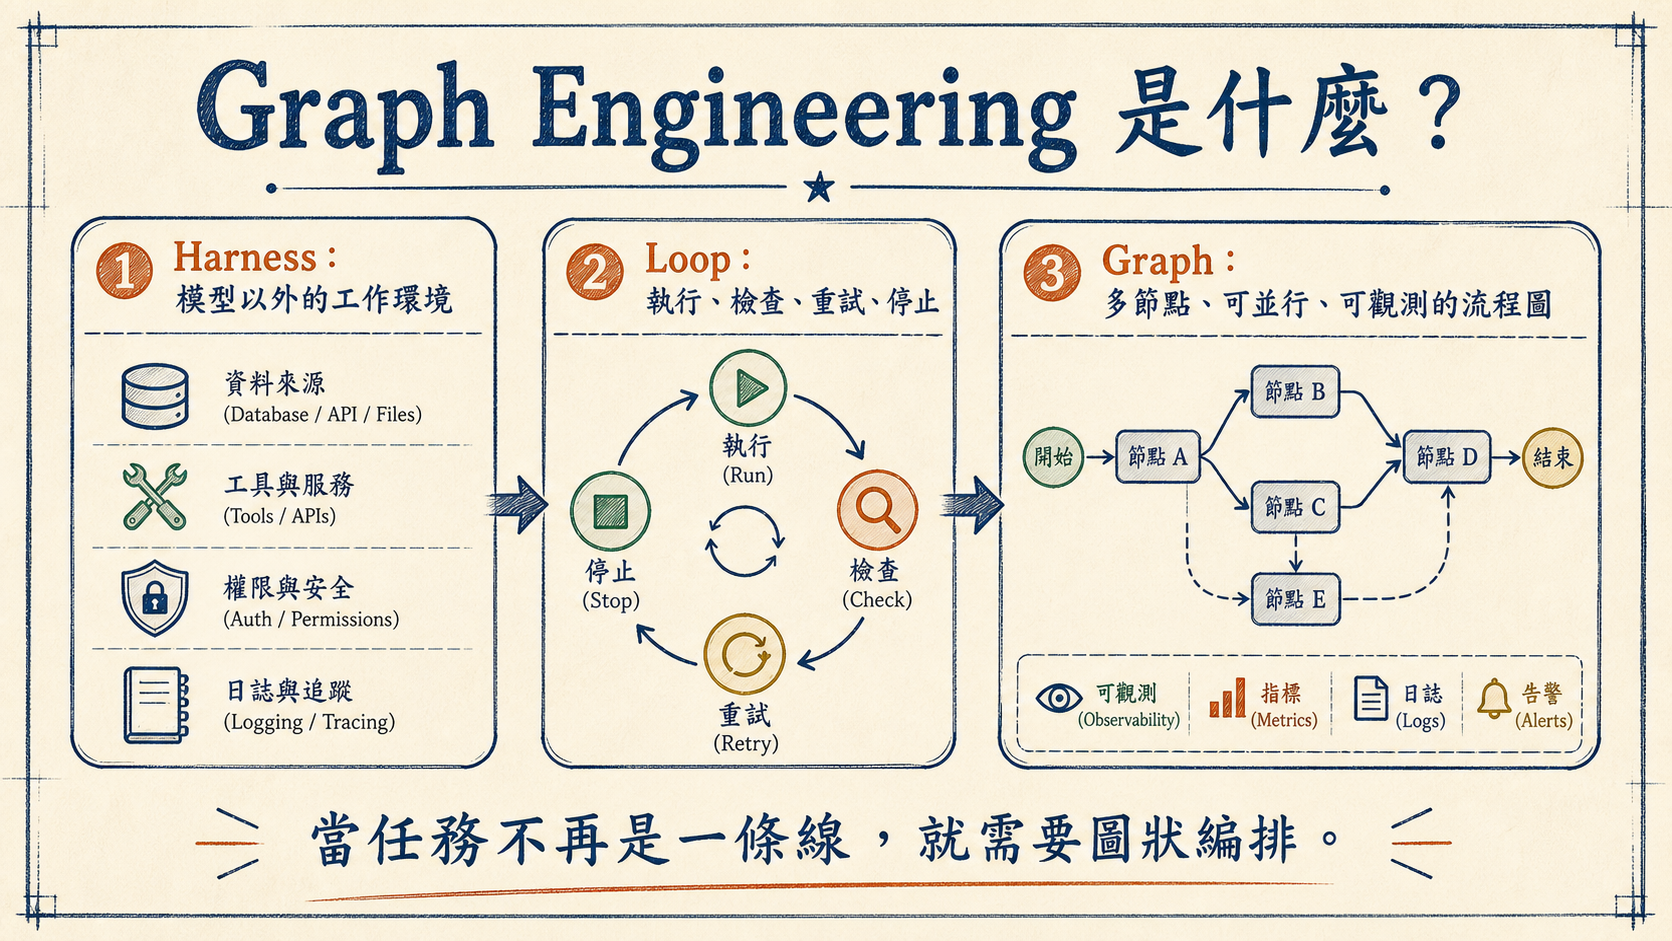
1. 從 Harness 到 Loop,再到 Graph|AI 圈造詞快,但概念有層次
Serena 心心加州這支影片的切入點很直接:Prompt、Context、Harness、Loop 還沒完全搞懂,AI 圈又冒出一個 Graph Engineering。這種新名詞確實容易讓人疲乏,但影片真正有用的地方,不是替新詞背書,而是把幾個工程層次重新排了一遍。
講者先用一句話定義 Harness:一個完整 Agent 裡,扣掉 model 之後,剩下的工作環境都是 Harness。也就是資料來源、工具、API、檔案、權限、紀錄、評分表、輸出格式,這些讓模型可以真的做事的外圍系統。Harness Engineering 關心的是:你給 AI 的工作場地是不是可用、可控、可追蹤。
Loop Engineering 則往前一步。它不只提供環境,還設計一個循環:讓 AI 執行、檢查、重試,最後在達到條件或跑滿輪次時停止。這很像把「請幫我做一件事」改成「照這個流程做,失敗就按規則修,成功就輸出」。
Graph Engineering 再往前推。當任務不再是一條線,也不是單一循環,而是有多個節點、分支、合併、人工 review、並行工作與不同責任邊界時,Graph 就比 Loop 更貼近實際流程。它把工作拆成節點,把資料流和依賴畫成邊,讓整個 Agent 系統更像一張可觀測的流程圖。
所以這裡的重點不是「Graph 比 Loop 新,所以比較高級」。更準確的說法是:Harness 是工作環境,Loop 是循環控制,Graph 是多節點編排。三者不是互斥關係,而是複雜度逐層上升時會遇到的不同問題。
2. YouTube 選題 Loop 的清楚與侷限|四個文件就能跑起來
影片用 YouTube AI 熱點選題系統當例子,這個例子很適合說明 Loop 為什麼有用。講者表示,當時的系統靠四個文件運作。
第一個是 sources.md,用來告訴 AI 從哪裡抓素材,例如 X、Reddit、競品 YouTube 爆款與新聞熱點。第二個是 rubric.md,也就是講者自己的評分表,滿分 100 分,從新鮮度、匹配度、觀看量、權威度等維度打分。
第三個是 LOOP.md,它是整個循環主控:抓素材、生成選題、按 rubric 打分,低於 80 分就打回重寫,一直湊夠 3 個 80 分以上的選題,或跑滿 3 輪才停止。第四個是 output 文件,最後選出的題目會寫進去,並附上理由、參考來源和開頭 hook。
這套設計的優點很清楚:它不需要大型平台,也不需要把整套 workflow 產品化,就能讓 AI 在可定義的範圍裡反覆改善輸出。對個人創作者、研究助理、內容企劃來說,這種 Loop 往往已經夠用。
但影片也指出 Loop 的問題:當流程開始需要分工時,單一循環會變得笨重。舉例來說,抓素材、初步聚合、評分、人工審查、改寫、最終輸出,這些步驟不一定都適合同一個 Agent 從頭跑到尾。有些可以並行,有些必須等待前一步,有些需要人工 review,有些只是格式轉換。
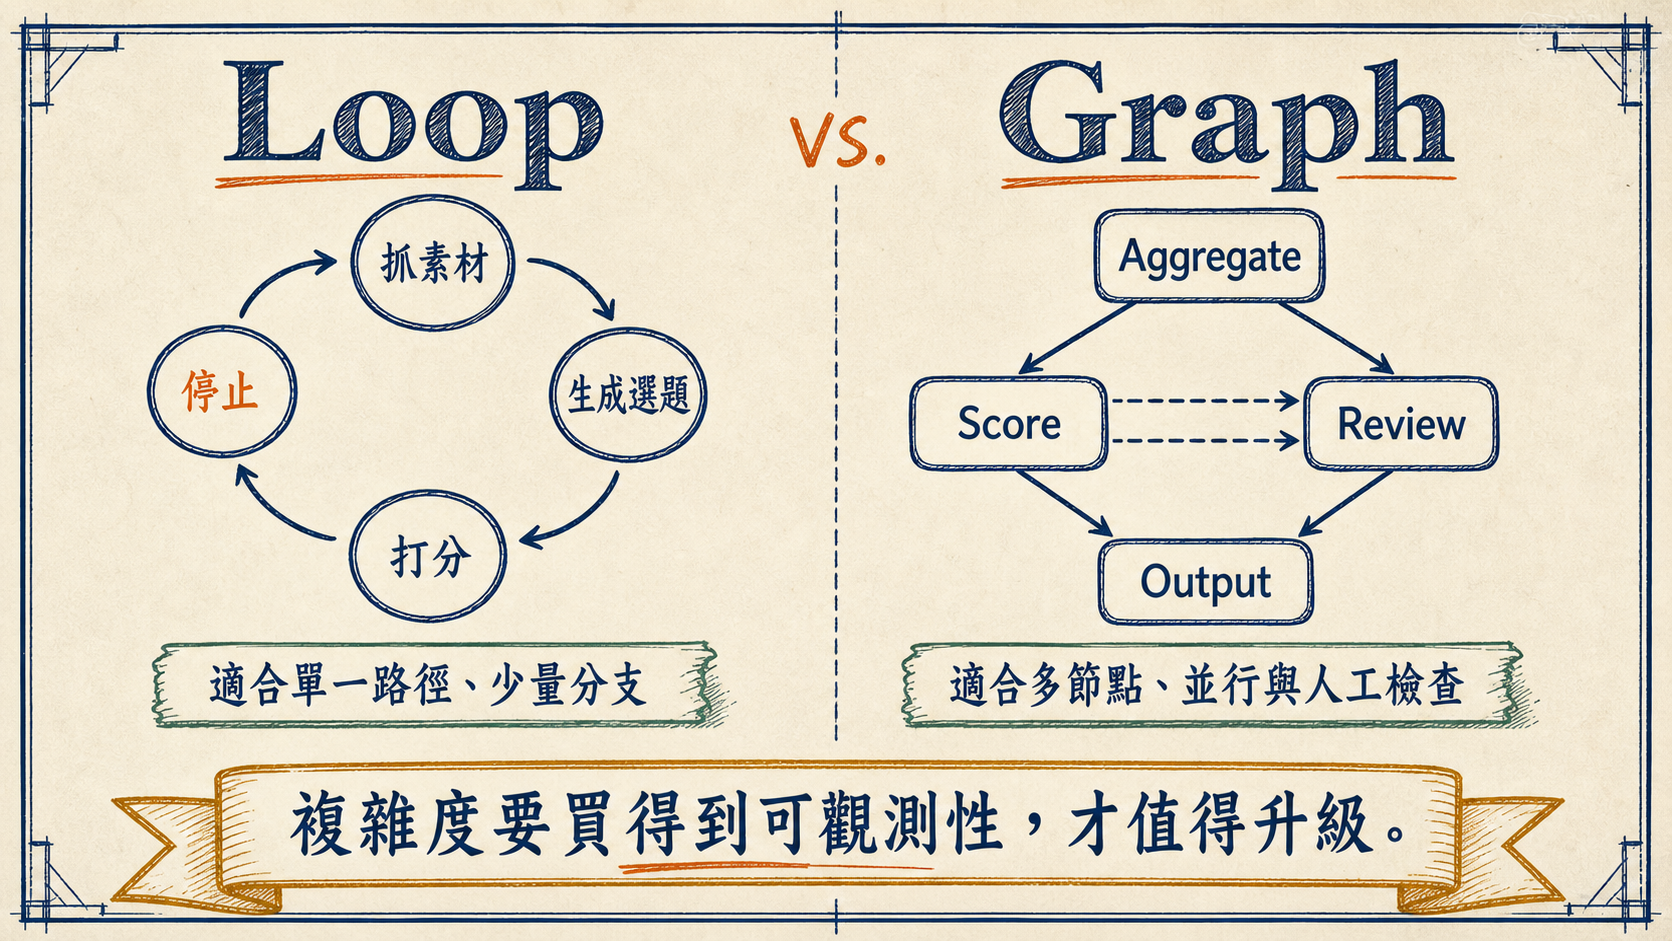
當你把所有事情都塞進同一個 Loop,系統會變得難除錯。你知道結果不好,卻不一定知道是 sources 抓錯、rubric 不準、score 太鬆、review 沒抓到問題,還是 output 格式壞掉。Loop 可以讓 AI 重試,但不一定能讓人看清每個環節怎麼壞。
3. Graph 的價值不是新名詞,而是可觀測分工|Aggregate、Score、Review 各自負責
Graph Engineering 的價值,正在於把這些職責拆開。影片用 Aggregate、Score、Review 三類節點示範:Aggregate 負責聚合候選題,Score 負責依 rubric 評分,Review 負責人工或模型審查。不同節點可以用不同提示、不同工具、不同模型,甚至不同執行節奏。
這比單一 Loop 更像工程系統,因為它要求你回答三個問題。
第一,每個節點的責任是什麼?如果 Aggregate 的任務是收集與去重,就不應順手決定最終題目。若 Score 的任務是量化評分,就要明確知道它看哪些欄位、輸出什麼 schema。Review 則應該檢查理由、來源可信度與是否符合頻道定位,而不是重做前面全部工作。
第二,節點之間交換什麼資料?Graph 不是把幾個 Agent 名字排在一起而已。每條邊都應該有資料契約:候選題清單長什麼樣、分數怎麼表示、拒絕理由怎麼寫、是否允許缺欄位、失敗時能不能局部重跑。
第三,系統怎麼觀測?Graph 值得做的前提,是你能看到每個節點的輸入、輸出、耗時、錯誤與採用結果。否則只是把原本一個黑箱拆成三個黑箱,複雜度上去了,可維護性沒有跟上。
在這個意義上,Graph Engineering 不是一個更潮的 Prompt 技巧,而是 Agent workflow 的系統設計問題。它把「模型要怎麼想」移到次要位置,把「工作如何被拆解、驗證與追蹤」放到主位。
4. 什麼時候值得升級成 Graph|不要為了名詞而複雜化
影片最後一段其實很重要:如果一個 Loop 已經夠用,就沒有必要為了新名詞把系統做複雜。這是最值得保留的工程判準。
值得使用 Graph 的情況通常有三種。第一,任務天然有多節點並行,例如同時抓多個來源、分別摘要,再合併排序。第二,流程中需要人工或模型 review,且 review 不是單純重跑,而是具有獨立責任。第三,輸出需要可追蹤,團隊必須知道每個結論來自哪個節點、哪份資料、哪一次評分。
反過來,如果只是「抓資料、生成草稿、檢查、重寫」這種單一路徑,Loop 可能更乾淨。尤其在早期探索階段,過度拆節點會增加維護成本:每個節點都要 prompt、schema、錯誤處理與日誌;每條邊都要處理格式相容;每一次升級都可能牽動整張圖。
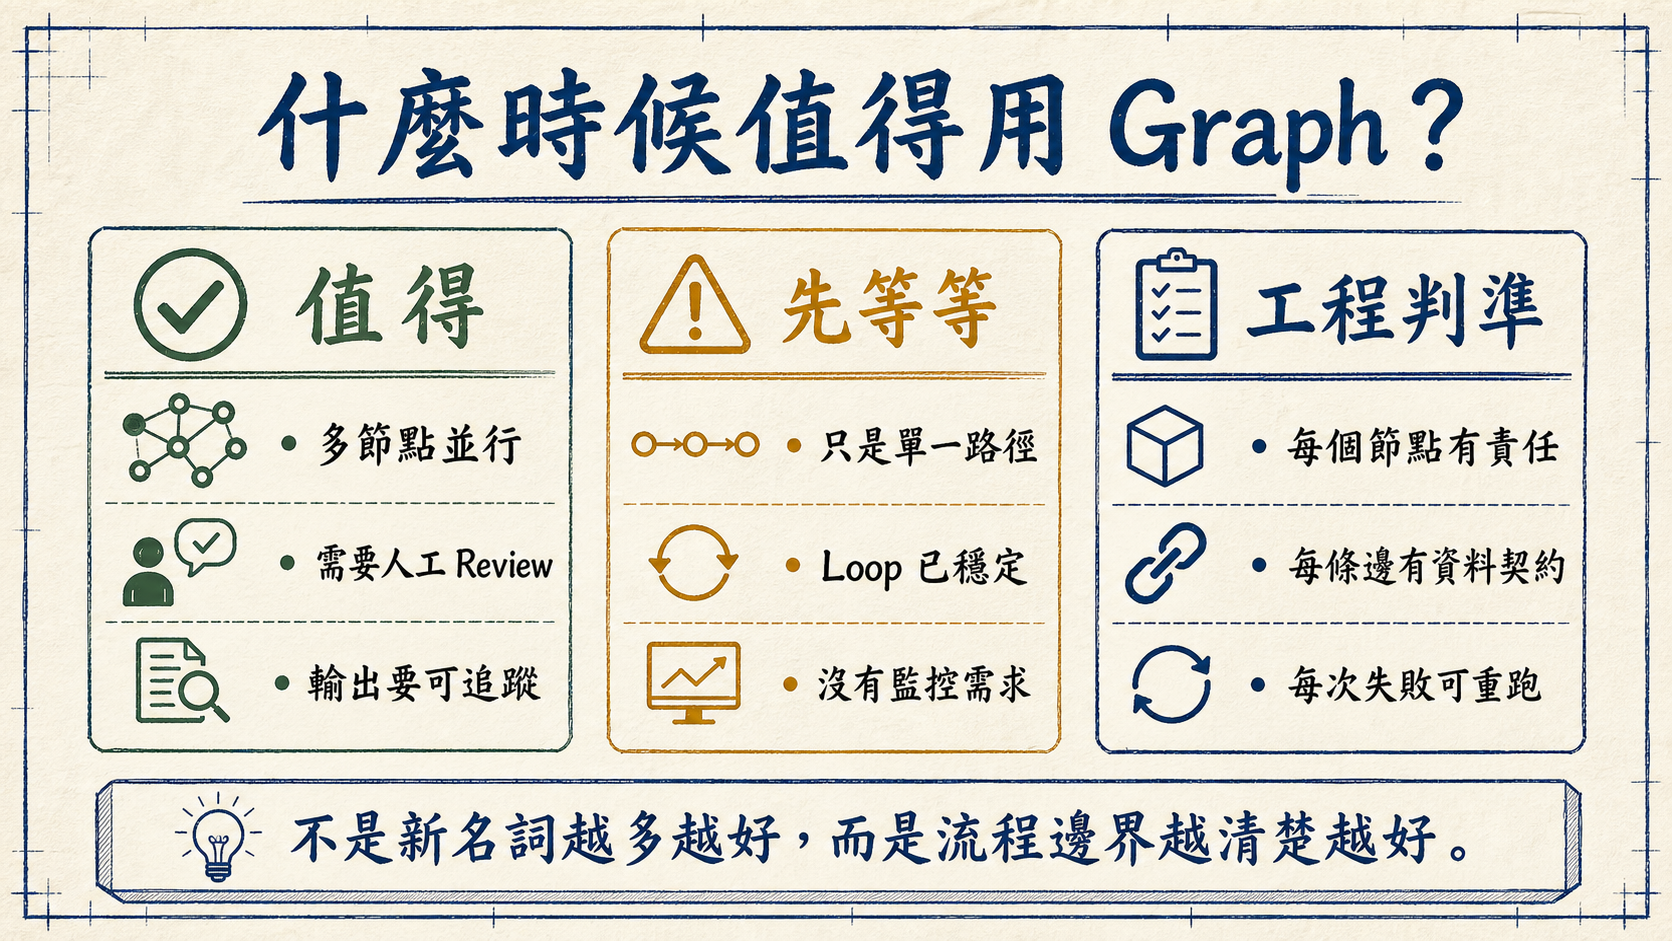
比較健康的採用順序,是先把 Harness 做穩,再用 Loop 把重試和停止條件定義清楚,最後才在複雜度真的上升時拆成 Graph。換句話說,Graph 不是起點,而是 Loop 被實務需求推到邊界之後的下一步。
這也讓「AI 圈又造詞」這件事變得比較不煩。名詞本身可以很吵,但如果把它還原成工程問題,Graph Engineering 問的是:當 Agent workflow 開始分叉、並行、合併與審查時,我們怎麼讓它不變成一團聊天紀錄?
5. 編輯結論|流程邊界越清楚,Agent 才越可靠
這支影片的價值,不在於宣布 Harness 或 Loop 已經過時。相反地,它提醒我們:Graph 是建立在 Harness 和 Loop 之上的。沒有穩定環境,Graph 只是漂亮圖;沒有清楚迴圈,Graph 也只是把混亂拆成更多節點。
對開發者與內容團隊來說,最實用的檢查表是:
- 如果模型常因工具、資料、權限、輸出格式而失敗,先補 Harness。
- 如果任務需要反覆改善,但路徑很單純,先做 Loop。
- 如果任務已經有多角色、多節點、並行、人工 review 或局部重跑需求,再考慮 Graph。
Graph Engineering 的好版本,不是把每件事都畫成複雜流程圖,而是讓每個節點都有責任、每條邊都有資料契約、每次失敗都知道該從哪裡重跑。
所以,真正的問題不是「下一個新詞是什麼」,而是:你的 Agent 系統現在卡住的地方,到底是環境不完整、循環不清楚,還是流程已經複雜到需要一張圖?