0. Fishpond 現在是什麼|它不再只是 Phase 1 骨架,而是一條正在運作的內容工廠
Fishpond 一開始只是很清楚的一句產品假設:把值得看的影片、podcast 或技術素材丟進來,讓 AI 自動醃成團隊可以回頭查、可以分享、可以累積的深度導讀文章。早期的 hello-fishpond 是 Phase 1 完工記,重點放在 Vite、React、Vike、MDX、frontmatter schema 和 E2E baseline;那時候它更像一座剛打好地基的靜態站。
現在的 Fishpond 已經不是那個狀態。它的核心已經長成一個 Git-backed 的 AI 導讀工廠:文章存在 content/articles/文章-slug/index.md,逐字稿存在同一個資料夾,圖片放在 images/,網站用 Vike 預渲染成靜態 HTML,最後由 Cloudflare Workers static assets 對外 serve。內容產生端則由 media-to-editorial 管線與技能文件支撐,負責下載影音、轉音訊、轉錄、結構化、產文、驗證與入庫。
這篇新版不是「Phase 1 回顧」,而是 Fishpond 目前架構與實際運作方式的導讀。它描述的是現在這座魚塘怎麼接收素材、怎麼產文章、怎麼驗證、怎麼上站。
最重要的變化,是 Fishpond 已經從「做一個能放文章的站」前進到「讓文章生產有穩定路徑」。這條路徑不只包含網站,也包含內容資料契約、產文流程、配圖風格、QA gate、部署方式,以及實際營運時的人工補強。它還沒完全抵達最終想像中的 zero-touch publishing,但已經有足夠穩定的主幹,可以持續把素材變成文章。
1. 最新架構|四種入口可以不同,但終點必須回到同一條內容路徑
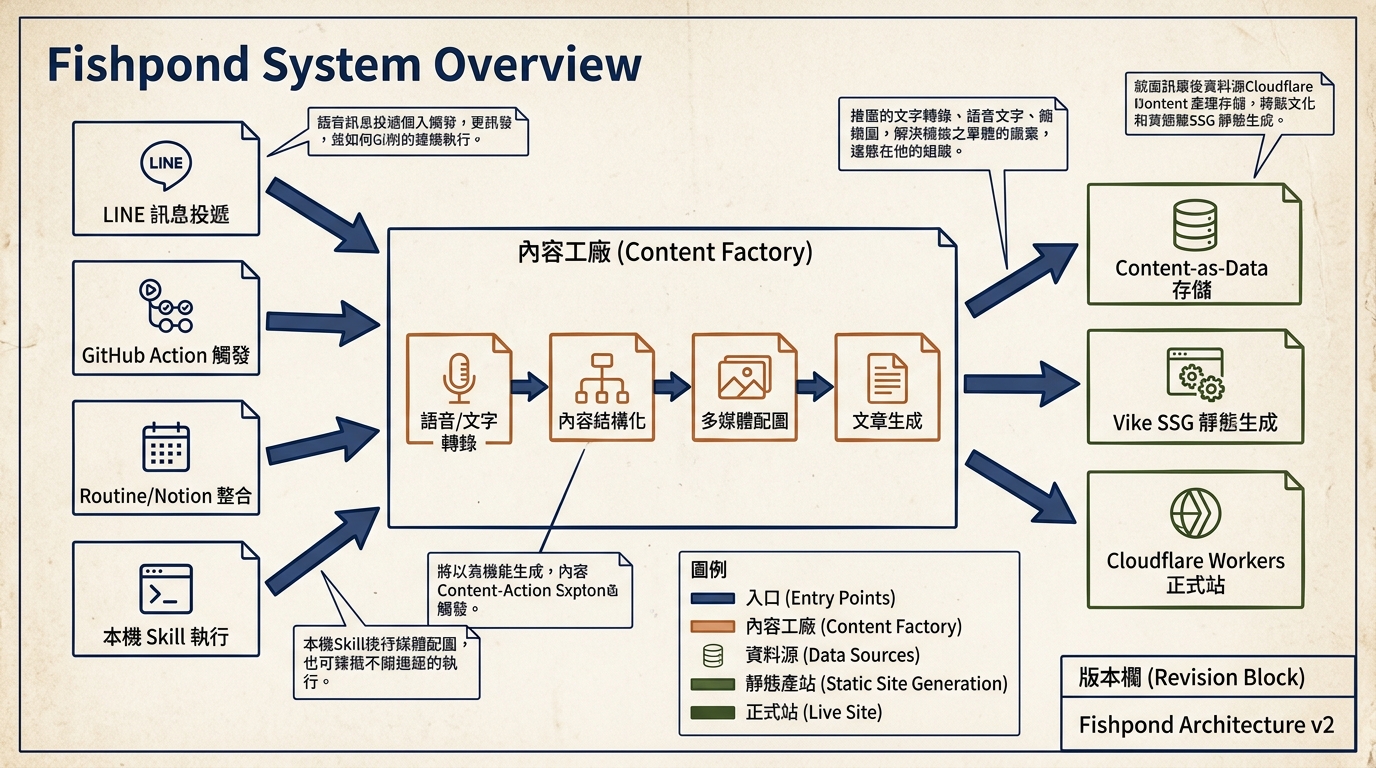
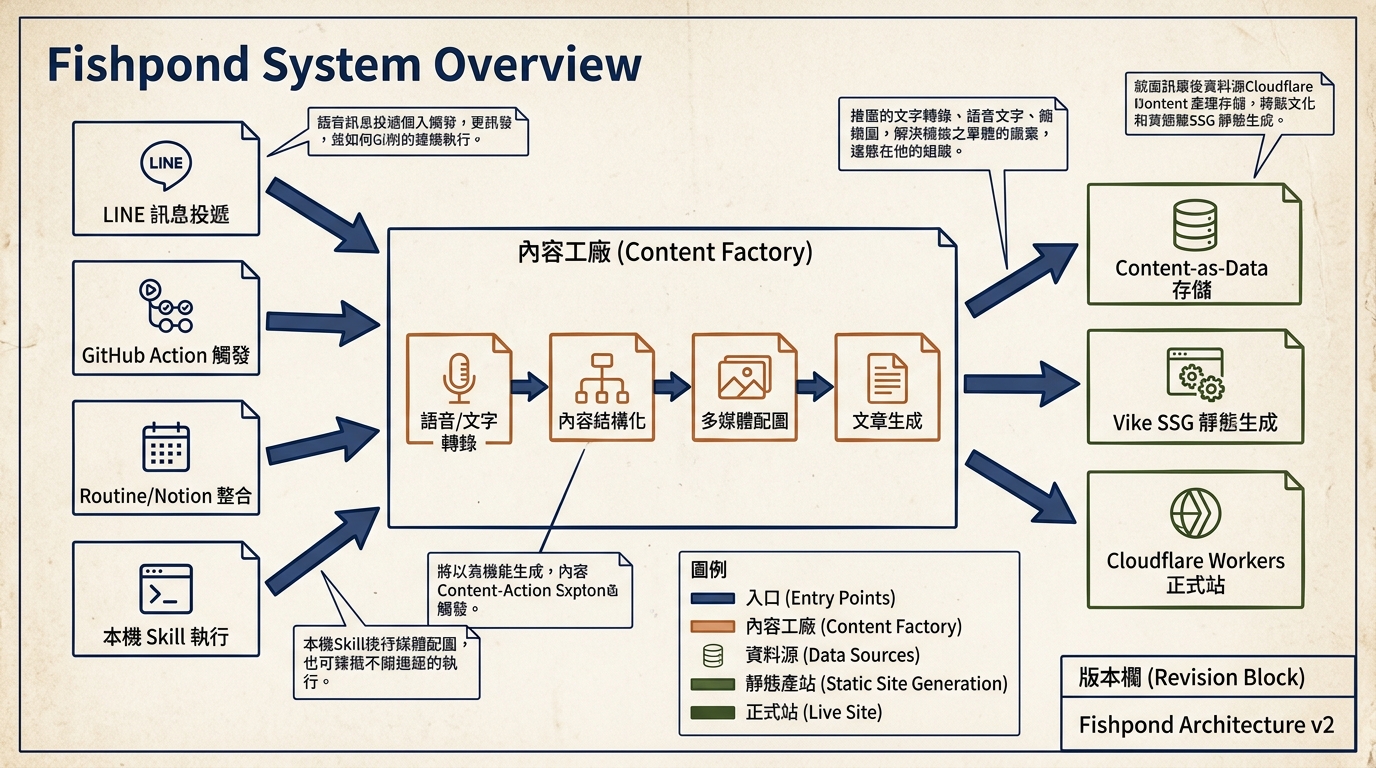
Fishpond 的架構可以拆成三層:入口層、內容工廠層、網站發布層。
入口層負責把素材丟進來。設計上支援四種入口:GitHub Action 手動觸發、LINE 轉 repository dispatch、Claude Routine 搭配 Notion queue,以及本機或 OpenClaw 裡直接跑 skill。這些入口的使用情境不同:GitHub Action 最適合穩定重跑與 debug;LINE 最適合手機上直接丟連結;Routine/Notion 適合批次排程;本機或助理直跑適合需要即時修文、重生配圖、手動 polish 的情境。
但入口不同,不代表內容邏輯可以分叉。Fishpond 的設計原則是 Four Entries, One Pipeline:任何入口最後都要收斂到同一種文章資料結構、同一套 frontmatter schema、同一個 content directory、同一個 build gate。這樣才不會出現「LINE 產的文章一種格式、GitHub Action 產的文章另一種格式」的維護災難。
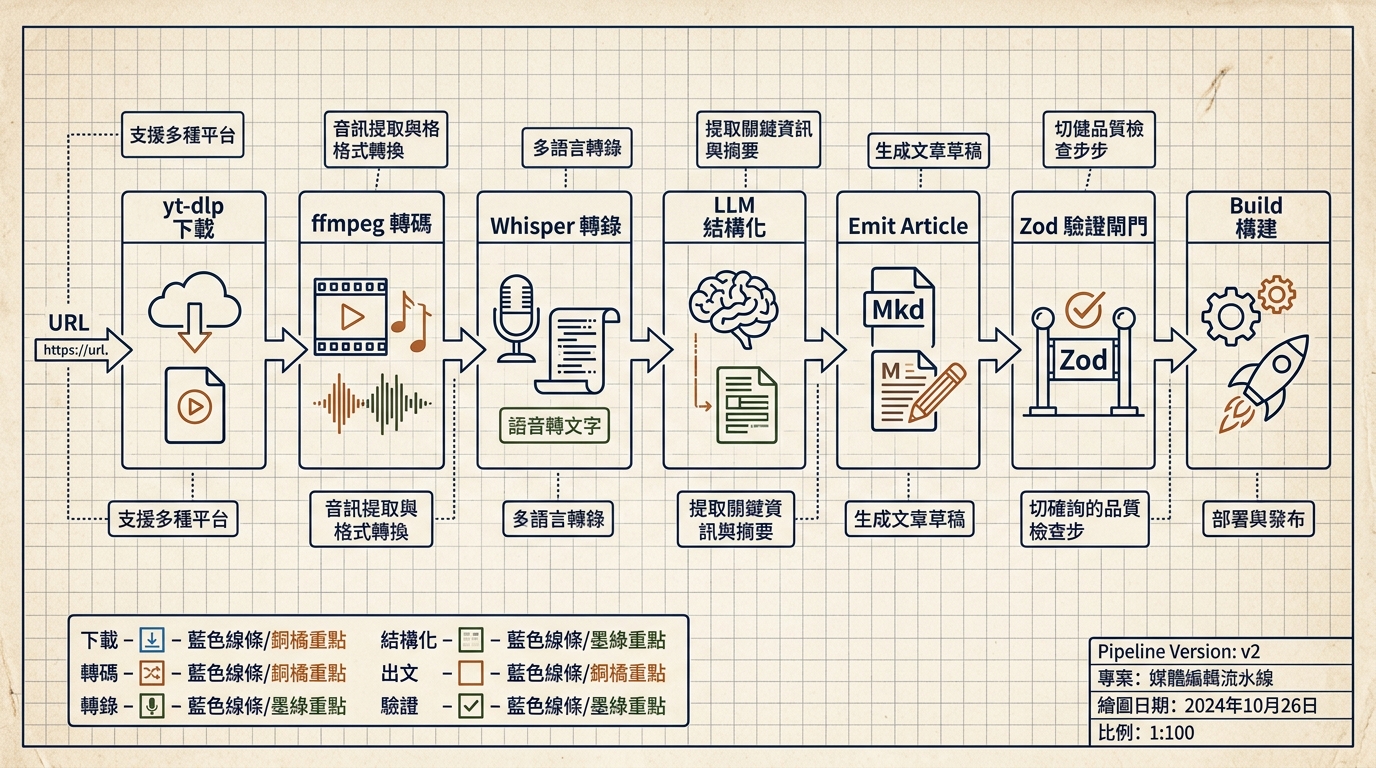
中間的內容工廠層,是 media-to-editorial。repo 裡保留一條可執行的 TypeScript runner:yt-dlp 下載、ffmpeg 轉 WAV、Whisper 轉錄、LLM 結構化素材、emit article、validate frontmatter。技能文件 .claude/skills/media-to-editorial/ 則是把魚塘特化的內容策略、bridge 規則、infographic 系列風格與 slug 規則收斂成操作指引。
發布層則非常保守:Git 是內容來源,Vike 是靜態產站器,Cloudflare Workers serve build 出來的 static assets。這個選擇讓 Fishpond 在 MVP 階段維持簡單、可追蹤、可 rollback。每一篇文章都是一個明確的 content commit;每一次上站都是 build 後的靜態輸出。
2. 內容管線怎麼跑|從一個 URL 到一篇可上站文章,中間不是只有「叫 AI 寫」
Fishpond 的內容管線不是把 YouTube 連結丟給模型,叫它自由發揮。比較準確的說法是:它把影音素材拆成幾個可驗證的階段,讓每一段都留下明確輸出。
第一段是素材處理。yt-dlp 負責抓音訊,ffmpeg 把來源轉成適合轉錄的 WAV,Whisper 產出逐字稿。這一段是機械性的,重點是穩定、可重跑、可 cache。YouTube cookies、player client fallback、Whisper model path 這些細節,看起來瑣碎,但它們決定 pipeline 能不能真的在 runner 或本機環境裡跑完。
第二段是內容結構化。這裡模型不只是摘要,而是把 transcript 轉成 Fishpond 文章需要的 material:主題、段落、重點、來源資訊、tag、KPI、可能的資訊圖方向。FP-026 的內容品質提升讓 pipeline 更重視長文深度、例子保留、KPI extraction 與編輯語氣,而不是只產一篇短摘要。
第三段是出文與驗證。emit-article 把 material 寫成 content/articles/文章-slug/index.md,同時保留 transcript.md。接著 validate-frontmatter 用 Zod schema 檢查契約是否成立:slug、date、category、tags、source、summary、status、qa flags、layout、theme、kpis、sections、meta 都必須符合規格。這是 Fishpond 很重要的保險:AI 可以寫文章,但不能繞過資料契約。
現在實務上還多了一個「人工編輯助理」層。像最近幾篇文章重生,流程不是重新跑整條影音 pipeline,而是在既有文章上更新長文、替換配圖、檢查 build、commit、push、等正式站同步。這不是違反自動化,而是很務實地承認:內容產品在早期最重要的是把品質標準養出來,等標準穩定後再把人工步驟收進 runner。
3. 網站層怎麼運作|Markdown 是資料,不是散落的頁面
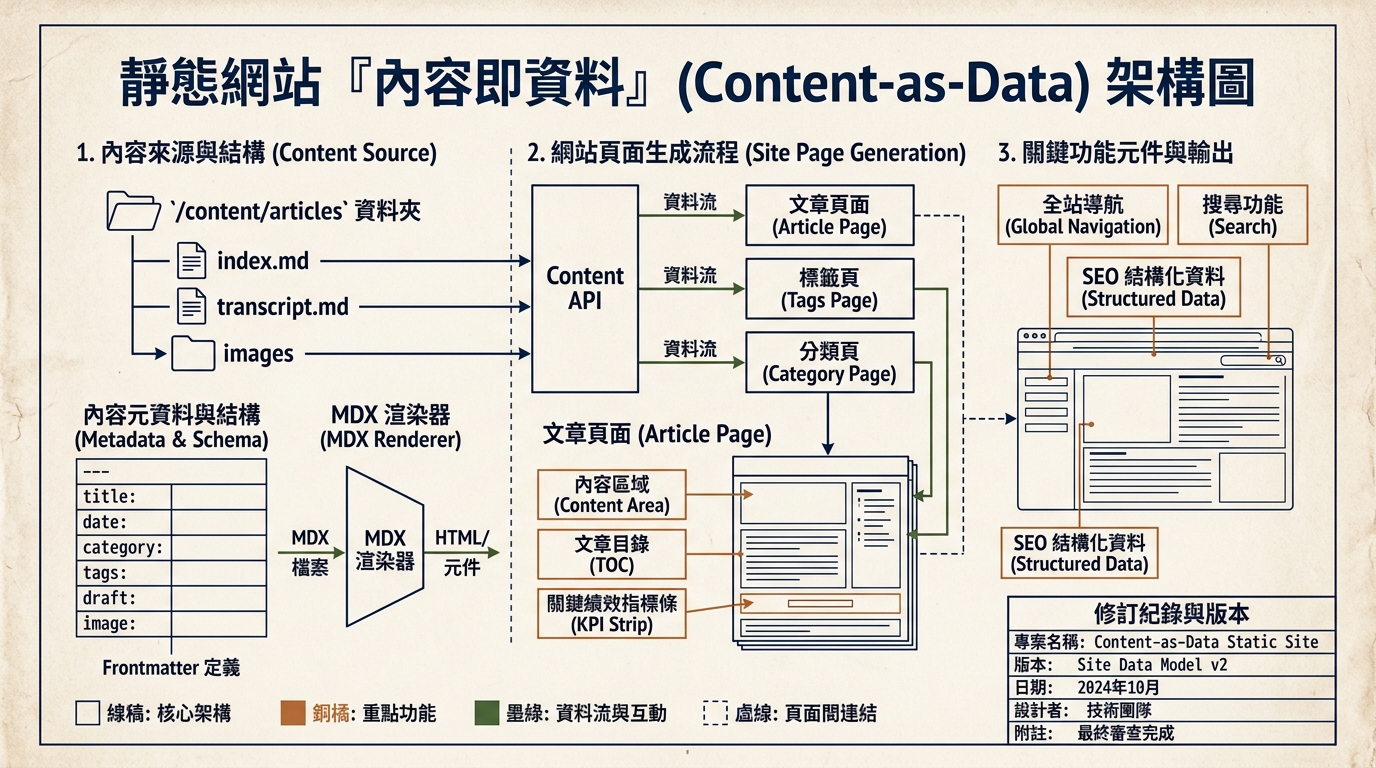
Fishpond 的網站層最核心的決策,是 Content-as-Data。文章不是散落在頁面元件裡,也不是硬寫在 React route 裡;每篇文章都是一個資料夾:index.md 是 frontmatter 加文章本文,transcript.md 是來源逐字稿或整理稿,images/ 則放 hero 與內文資訊圖。
Vike 負責把這些內容轉成靜態路由。content-loader.ts 讀取文章 index,frontmatter-schema.ts 是資料契約的唯一真相,MDX renderer 負責把本文變成可渲染內容。Editorial layout 再把 frontmatter 裡的 kpis、sections、meta 接到 KPI strip、TOC sidebar、hero 區和文章版型。
這樣做有幾個好處。第一,文章可以被 Git diff 清楚追蹤:標題、摘要、圖片引用、章節調整都看得見。第二,build gate 很早就能抓到壞資料,不會等到部署後才發現頁面爆掉。第三,未來如果要換 renderer 或搬到其他 CMS,內容本體至少已經是結構化資料,而不是混在 UI 裡的字串。
圖片處理也是網站層的一個關鍵細節。文章圖片放在 content/articles/文章-slug/images/,但 Vike build 不會自動複製這些檔案。因此 Fishpond 有 copy-content-images build plugin,在 build closeBundle 時把圖片複製到兩個位置:一個給 hero 絕對路徑 /content/articles/文章-slug/images/,一個給內文相對路徑 /articles/文章-slug/images/。這個小機制讓本地 build 和正式站的圖片引用都能穩定運作。
4. QA 與發布閘門|Fishpond 的信任邊界不在「AI 會寫」,而在「上站前要過契約」
Fishpond 的 QA 不是裝飾。從資料契約看,frontmatter 裡有一組 qa flags:schema_ok、fact_ok、length_ok、image_ok、style_ok、review_needed。這組欄位讓文章的發布狀態不是單純靠人腦記憶,而是寫進文章 metadata。
目前最硬的 gate 是 schema 和 build。只要 frontmatter 不符合 Zod schema,文章就不能穩定進站;只要 build 過不了,正式站就不應該更新。這也是為什麼每次重生文章後,都要至少跑 pnpm typecheck、pnpm build、必要時再跑 pnpm -F site validate:frontmatter。它們不是形式,而是在確保 AI 產出的內容仍然服從站台契約。
更完整的目標,寫在 Fishpond 的 ADR 裡:QA all-pass 後自動 publish;任一 fail 則保留 draft、標 review_needed,讓人決定修正、重跑或放棄。這個方向很清楚,但不能把「未來想要」講成「現在已全部完成」。現況是:pipeline、schema、build gate 與手動驗證已經在跑;完整 5-agent QA 與 zero-touch auto-merge 還是下一階段要補齊的信任基礎。
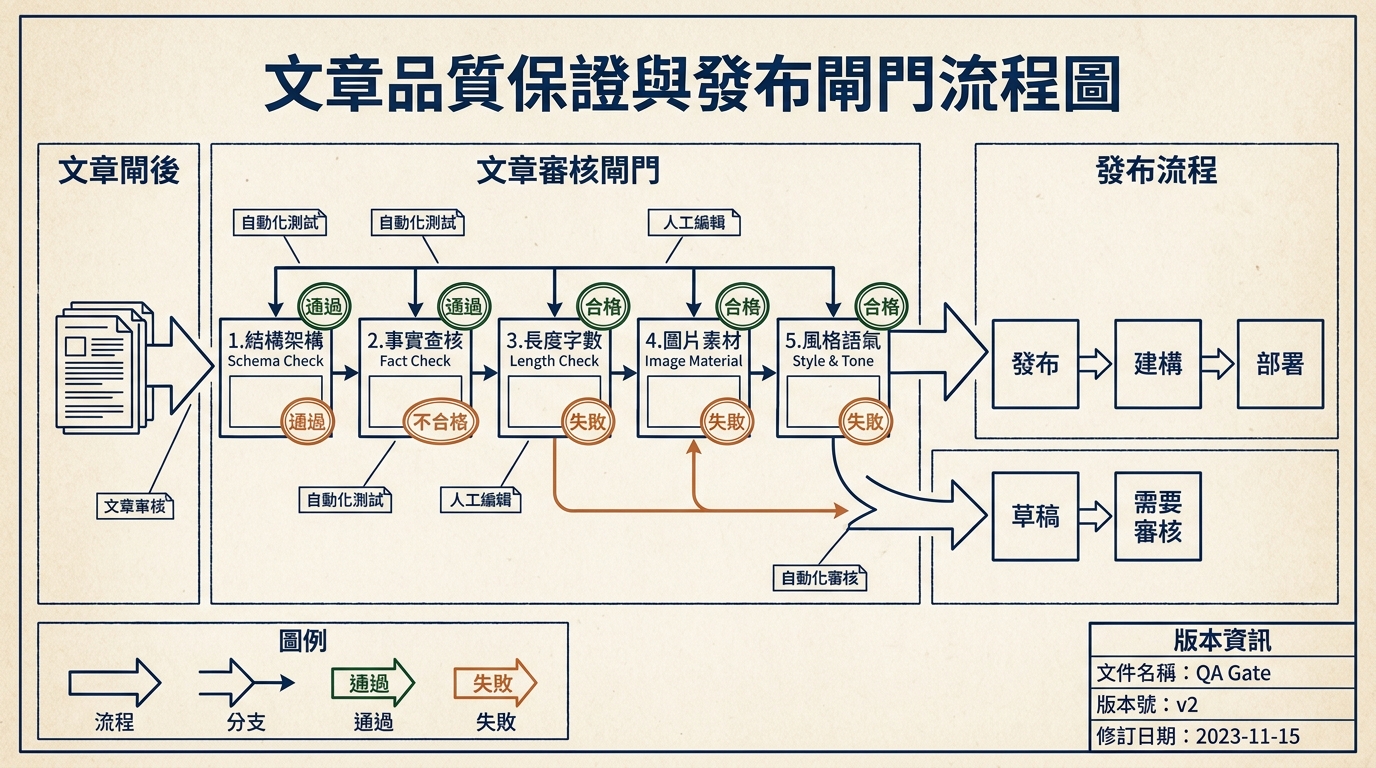
這裡的工程判斷很重要。Fishpond 不是追求「完全沒有人碰」這種漂亮口號,而是把人應該碰的地方縮小:人負責定義品質、檢查高風險內容、重生不滿意的文章;機器負責重複性的轉錄、結構化、契約驗證、build 和部署。等 QA agent 的 eval 真的可靠,才適合把更多發布決策交給自動化。
5. 實際營運模式|現在最常見的工作流,是點名、重生、驗證、push、等同步
從最近的使用方式看,Fishpond 已經進入很實際的營運期。老闆在 LINE 群組丟一篇正式站文章,點名「蝦餃這篇也重生」,工作就會變成一個可重複流程:
- 讀正式站與 repo 內原文,確認這次是只換配圖,還是文章也要更新。
- 對照 repo 最新架構、文件與實際 pipeline,避免沿用過期敘述。
- 產生或重產 paper-blueprint 風格的資訊圖。
- 更新 index.md 的 frontmatter、章節、圖片引用與內文。
- 跑 typecheck、build、frontmatter validation。
- 只 stage 本次文章相關檔案,避開工作樹中不屬於本任務的既有變更。
- commit、push,等待 Cloudflare Builds 同步正式站。
- 回報正式 URL 與 commit。
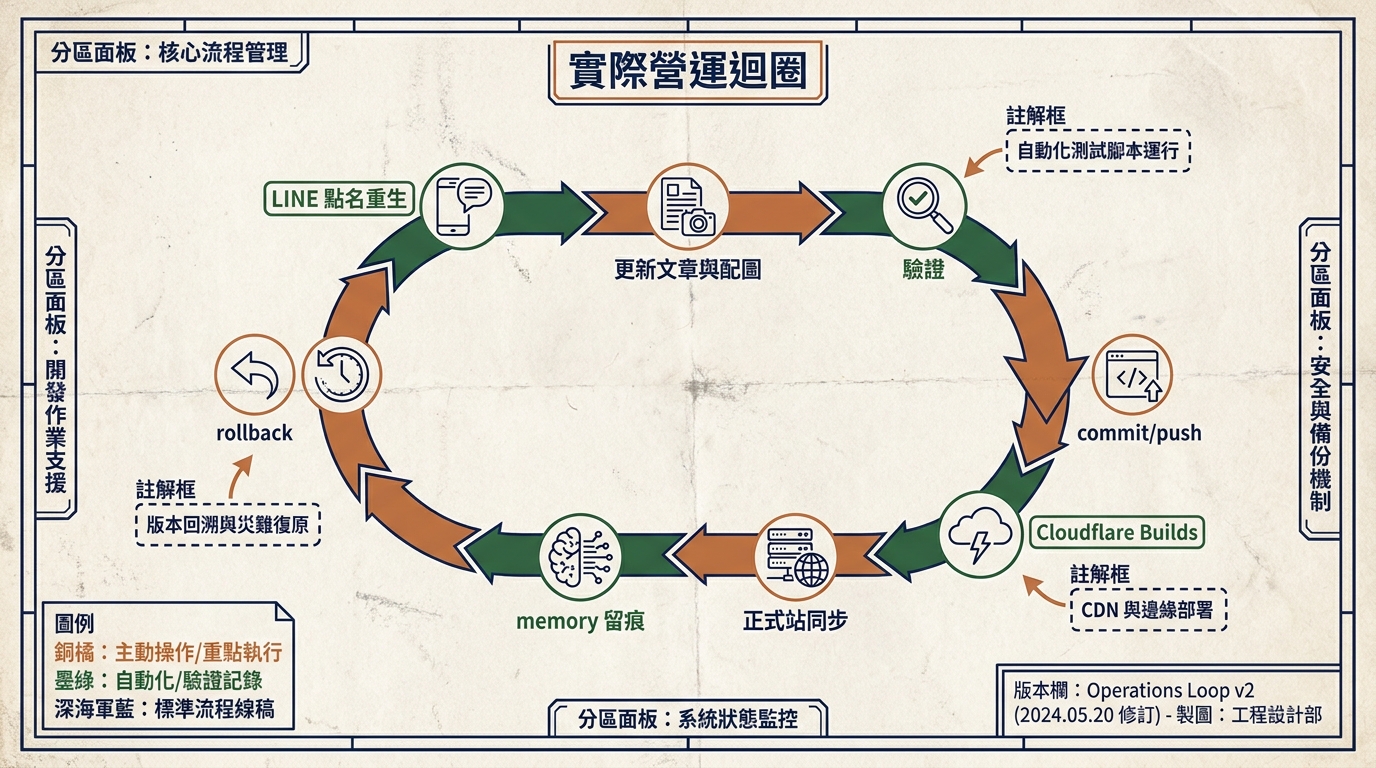
這個模式看起來半自動,但它很符合 Fishpond 現階段的成熟度。文章品質與視覺標準還在被拉高:配圖從早期簡單 SVG,逐步換成復古紙張技術資訊圖;文章從短摘要,逐步改成有架構、有判斷、有來源脈絡的長文。這些標準先被手動跑穩,再沉澱回 skill、prompt、reference 與 QA 規則,才會變成真正可靠的自動化。
目前正式站部署也很明確:repo push 後 Cloudflare Builds 會跑 build command,把 site/dist/client/ 用 wrangler.jsonc 指定的 assets directory 發到 fishpond.fishinwaters-cjp.workers.dev。如果本機想手動 deploy,需要 CLOUDFLARE_API_TOKEN;沒有 token 時,推 GitHub 讓 Cloudflare Builds 自動同步,是目前比較穩的路徑。
6. 下一步該補哪裡|真正的目標不是更多入口,而是更可靠的內容信任鏈
Fishpond 下一階段不該急著加更多入口。入口已經夠多,真正值得補的是信任鏈與自動化收斂。
第一個是 QA agents 的 eval。schema 可以靠程式檢查,但 fact、style、image、length 都需要明確 fixture 與 regression baseline。沒有 eval 的 QA agent 不應該拿來 auto-merge,否則只是把人工風險換成自動風險。
第二個是 skill-native runner。ADR-003 的方向是讓 GitHub Actions runner 裡真的跑 Claude Code session,讓 Claude 讀 .claude/skills/media-to-editorial/SKILL.md 執行,而不是把 production prompt 全塞在 TypeScript template literal 裡。這會讓「skill 是生產管線」這件事更真實,也讓魚塘特化知識更容易維護。
第三個是 rollback 與 demote 工具。內容自動發布之後,一定要有同等清楚的撤回路徑。Git-backed content 的好處是每篇文章都可追蹤,但如果撤回還需要人手改 frontmatter、commit、push,那在規模化後仍然會卡住。
第四個是把人工重生流程沉澱回文件。最近幾篇文章的重生,已經形成一套穩定偏好:米白舊紙、深海軍藍線稿、銅橘/墨綠重點、繁體中文短標籤、流程箭頭、圖例、註解框、具體介面與局部細節。這些不該只存在某次聊天裡,而要回到 skill reference 與 TOOLS 筆記,讓下一次生圖不用重新摸索。
Fishpond 的方向其實很務實:不是做一個炫技的 AI demo,而是把團隊值得讀的東西變成可累積、可搜尋、可回頭引用的知識資產。網站只是表面;真正的產品是背後那條內容供應鏈。當供應鏈越穩,魚塘裡留下來的就不只是文章,而是一套團隊如何消化外部資訊的作業系統。