010. 導言|這不是一場產品訪談,而是一張 NVIDIA 世界模型
當一家公司開始把晶片、機櫃、資料中心、供應鏈、組織與人類工作放進同一套推理裡,它談的已經不只是產品,而是它希望世界如何運作。
這場長達 2 小時 24 分的訪談,表面上是 Lex Fridman 與 NVIDIA 執行長黃仁勳談 AI、CUDA、台積電、能源、工作和死亡;真正貫穿全場的,卻是一套高度一致的世界模型:問題會不斷擴大,直到單一元件無法獨立解決;於是競爭的單位會從晶片變成系統,從系統變成供應鏈,再從供應鏈延伸到組織與社會。
使用者提供的是 New SciTech 新科技的中英對照版本。為避免只依賴二手意譯,本文同時對照 Lex Fridman 原始訪談與官方人工逐字稿。文章不採逐題摘要,而是把全場重組成 12 個問題:NVIDIA 究竟把自己看成什麼公司?agent 為何會增加而不是減少算力需求?供應鏈與電力要如何跟上?工作真的會消失嗎?以及,當智慧逐漸商品化,人還剩下什麼不可替代?
這裡必須先放上一層編輯距離。黃仁勳不是站在產業外部描述未來,他正領導全球 AI 基礎設施最重要的供應者之一。當他說推論會極度吃算力、agent 會倍增、token 工廠將成為新經濟核心,這些判斷既可能是深刻洞察,也同時服務 NVIDIA 的市場敘事。最好的讀法不是全盤相信或全盤否定,而是拆開其中的機制、假設與可驗證指標。
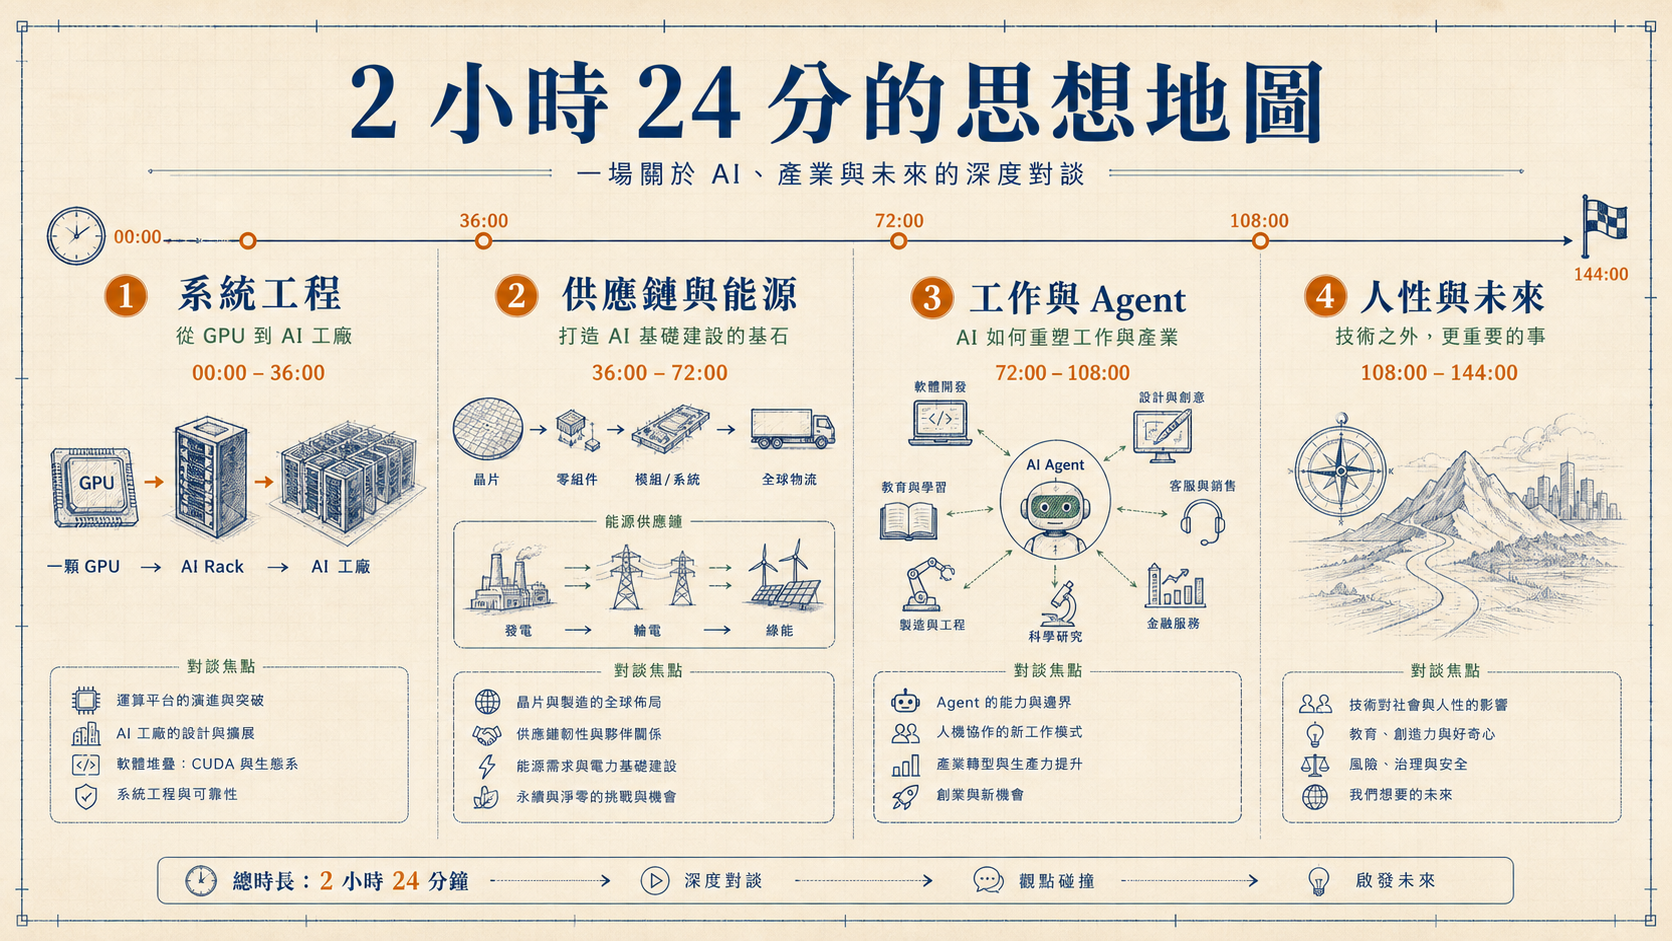
本文因此分成三層。第一層是工程:AI 的瓶頸如何從 GPU 外溢到網路、記憶體、電力與軟體。第二層是制度:NVIDIA 如何把公司、供應鏈與開發者生態設計成同一套系統。第三層是人:當 agent 可以讀檔、用工具、寫程式與管理流程,工作的目的和人的價值是否仍然成立。
魚塘觀察
- 這不是「黃仁勳預測了什麼」的預言整理,而是「他用什麼模型推導未來」的系統分析。
- 文中所有市場規模、AGI、能源與就業判斷,都保留來源歸屬,不視為已證實事實。
- 真正值得追蹤的是系統指標:每瓦 token、推論成本、機櫃交付、供應鏈資本支出、agent 真實使用量與工作流程變化。
021. 從 GPU 到 AI 工廠|當所有零件都成為瓶頸
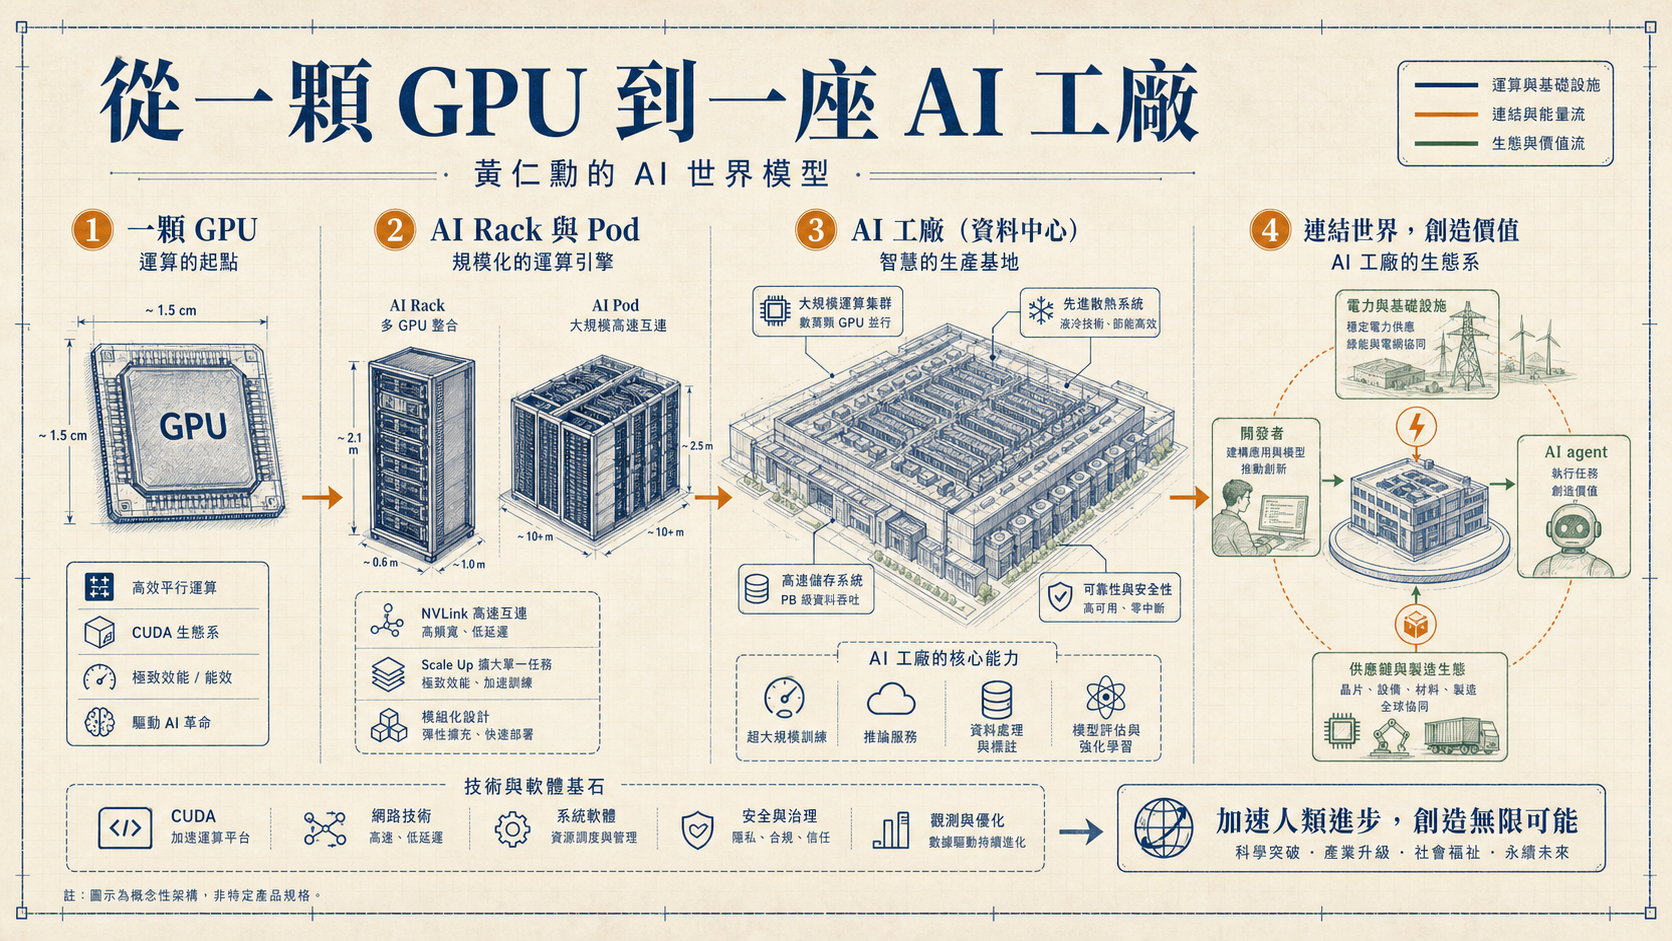
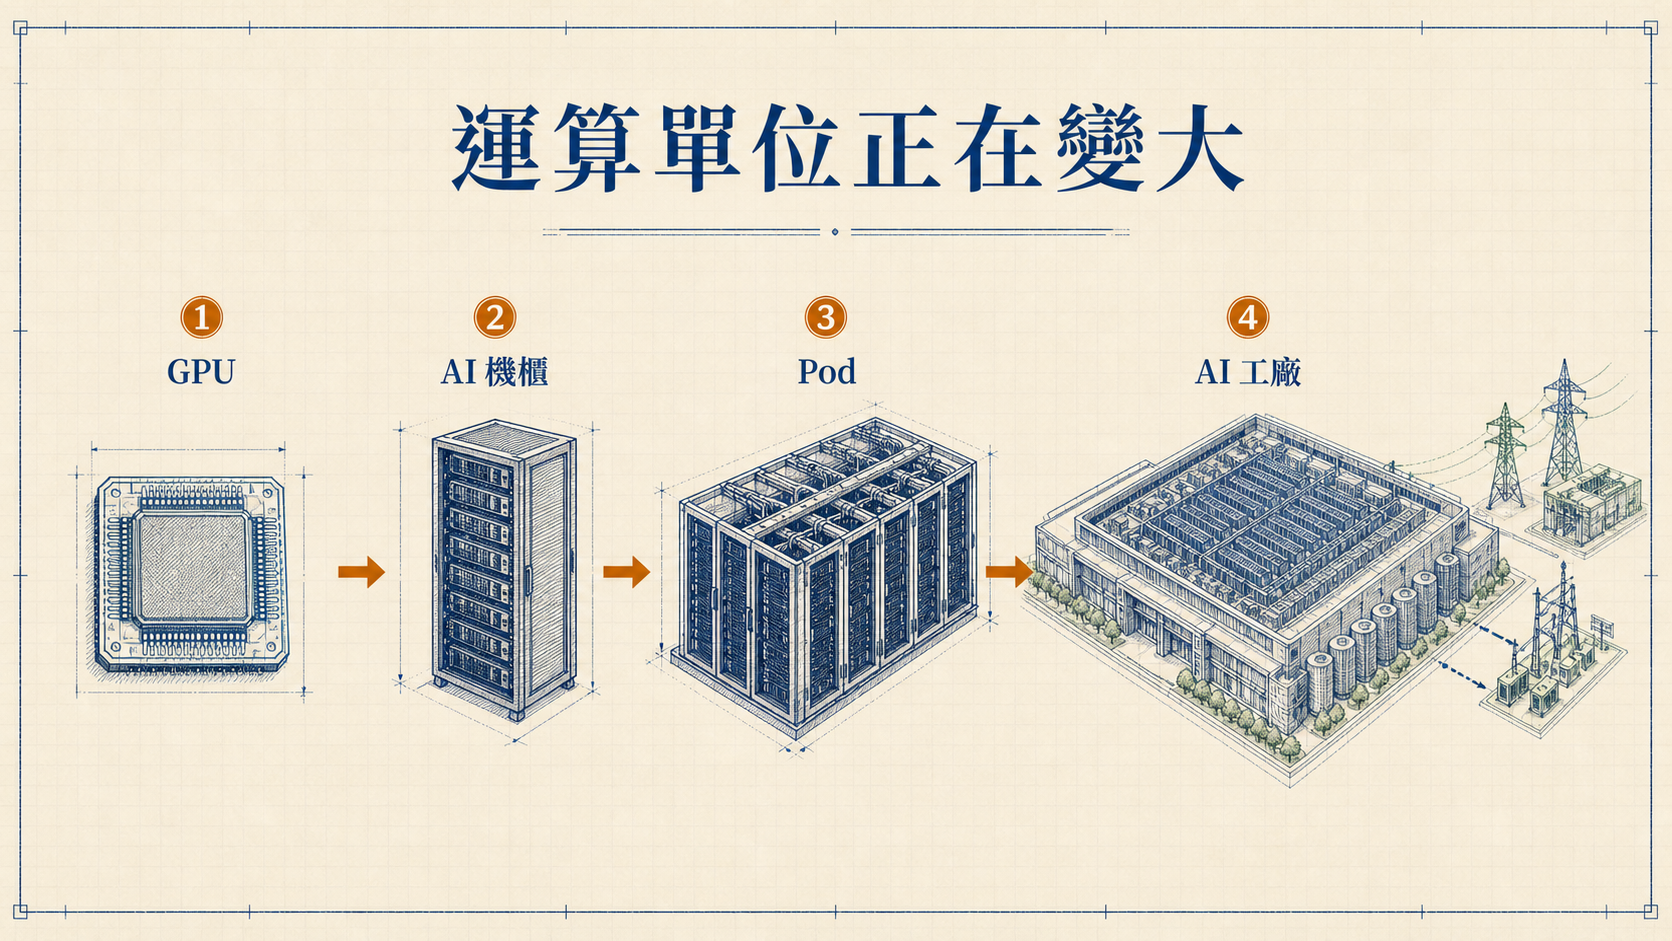
訪談一開始,黃仁勳便把 NVIDIA 的工作尺度從 chip-scale 拉到 rack-scale。過去外界理解 NVIDIA,往往從「誰能做出最快的 GPU」開始;如今他描述的競爭單位,卻包含 GPU、CPU、HBM、NVLink、交換器、儲存、供電、散熱、系統軟體、模型與資料中心。單顆晶片仍然重要,但它已經無法單獨代表一套 AI 系統的效能。
原因可以用 Amdahl's Law 理解。假設運算只占整體工作的一半,即使把那一半加速到近乎無限,總工作最多也只快約兩倍。當模型被切到成千上萬顆加速器上,資料分片、模型分片、pipeline、同步、交換、記憶體搬移與故障復原都會進入關鍵路徑。此時,任何一個原本被視為配角的元件,都可能變成昂貴 GPU 的等待時間。
黃仁勳以「增加 10,000 台電腦,卻希望得到遠高於 10,000 倍的整體提升」說明極限協同設計的必要性。這個例子不是承諾某個固定倍率,而是在說:如果擴充只等於把同樣的電腦堆得更多,成本、電力與通訊開銷很快就會吃掉收益。系統必須同時重構演算法、硬體、網路與軟體,才可能讓新增資源接近有效工作。
這也改變了產品發布的意義。當 NVIDIA 發布一顆新 GPU 時,真正交付的往往是一條完整升級路徑:新的記憶體規格、新的互連、新的機櫃供電、新的散熱方式、新的函式庫與新的模型最佳化。客戶購買的不是一顆孤立元件,而是希望整個 stack 在未來幾年持續被維護。
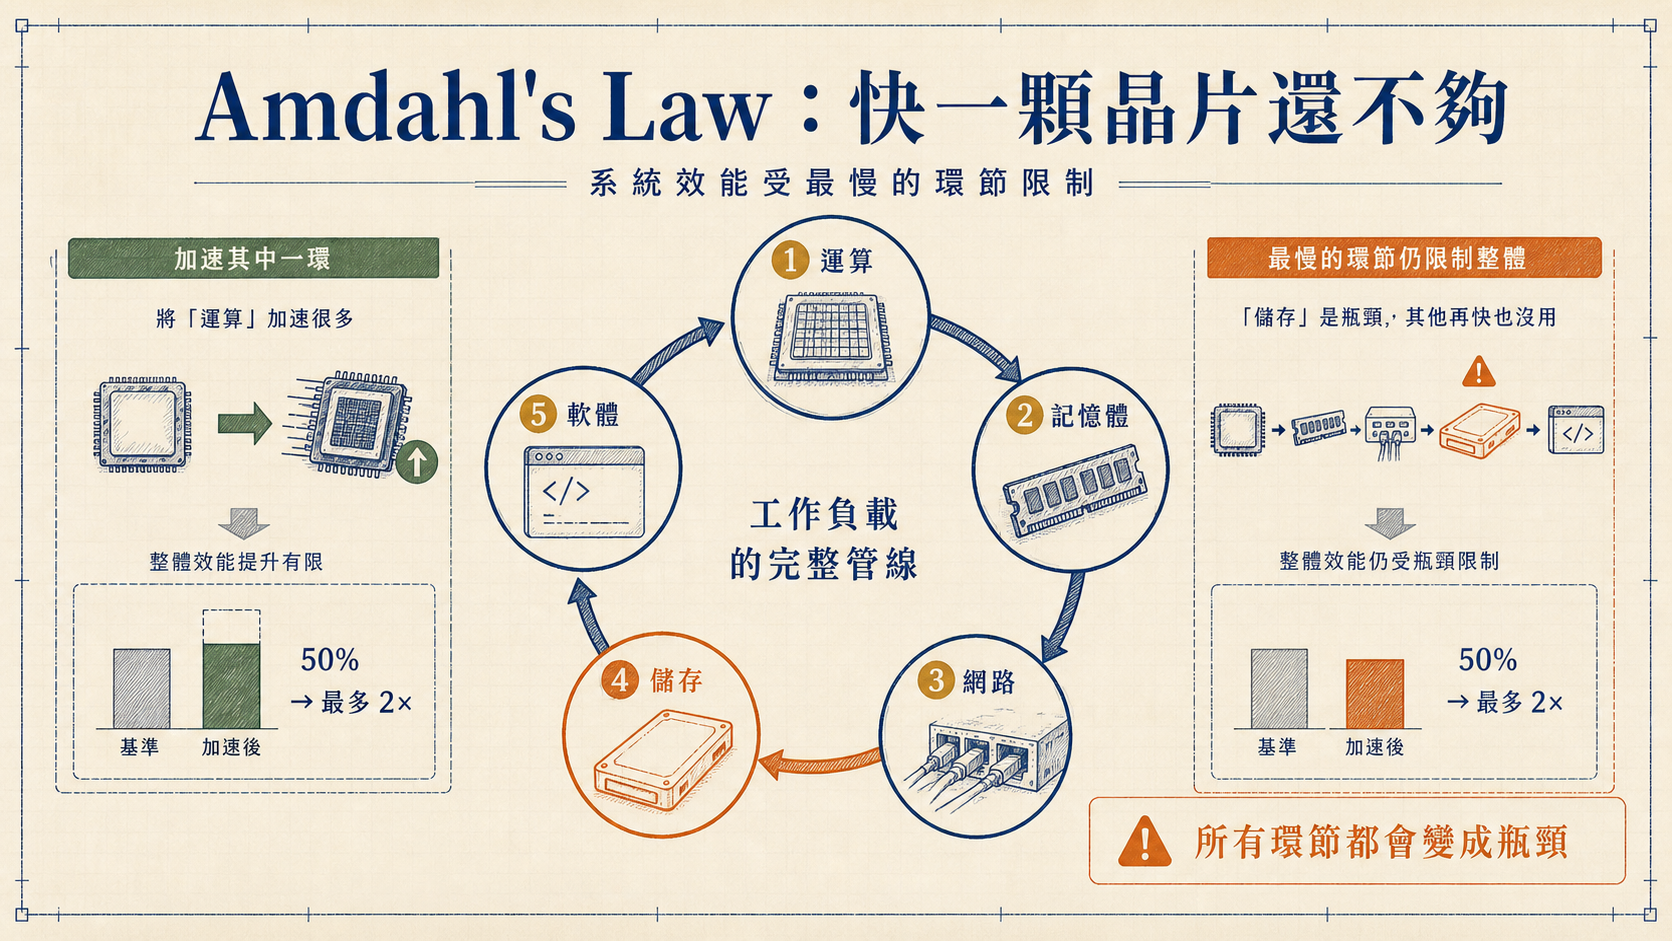
這套敘事也有需要檢查的地方。垂直協同設計可以帶來效率,但也可能增加供應商鎖定、資本密度與系統複雜度。客戶若接受整套平台,遷移成本自然提高;而 NVIDIA 若把更新週期推得太快,資料中心也可能面臨設備折舊、電力規格重做與供應鏈追趕壓力。系統愈完整,單點故障未必更少,只是故障的邊界變得更大。
魚塘觀察
- AI 效能不能只看 GPU benchmark,還要看整體吞吐、網路等待、記憶體利用率、能源與可用率。
- rack-scale 是工程選擇,也是商業綁定;效率提升與平台依賴會同時增加。
- 下一輪競爭未必是「誰有更快晶片」,而是誰能更快把整個資料中心點亮並穩定運作。
032. 公司也是一台電腦|組織設計如何服務產品
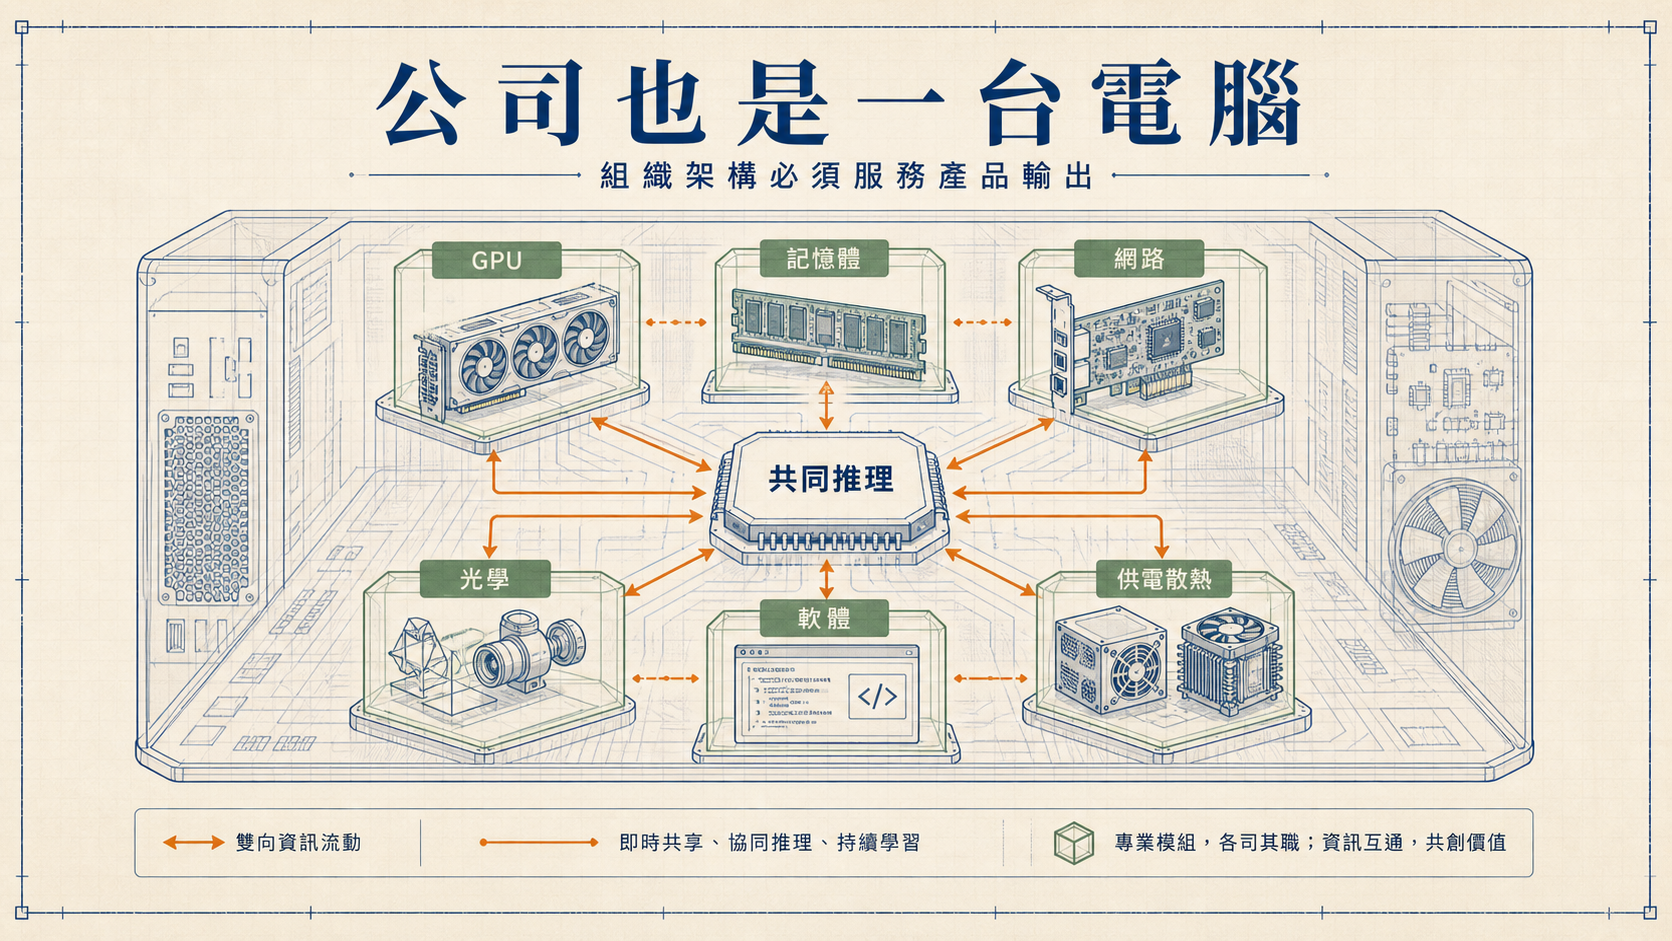
黃仁勳談極限協同設計時,很快把問題由硬體轉向組織。他的核心比喻是:設計電腦需要一套讓元件共同工作的 operating system;設計公司也一樣,組織架構應該反映公司希望產出的產品,而不是套用一張所有產業都長得差不多的標準組織圖。
他自述擁有超過 60 位直屬主管,而且幾乎不做傳統一對一會議。記憶體、CPU、GPU、網路、光學、系統與演算法專家一起面對問題,任何討論都可能被其他專業即時打斷與修正。這種做法的優點,是避免部門各自最佳化後才在整合階段發現衝突;缺點也很明顯:資訊密度極高、決策高度集中,而且非常依賴主持者能否辨認真正重要的聲音。
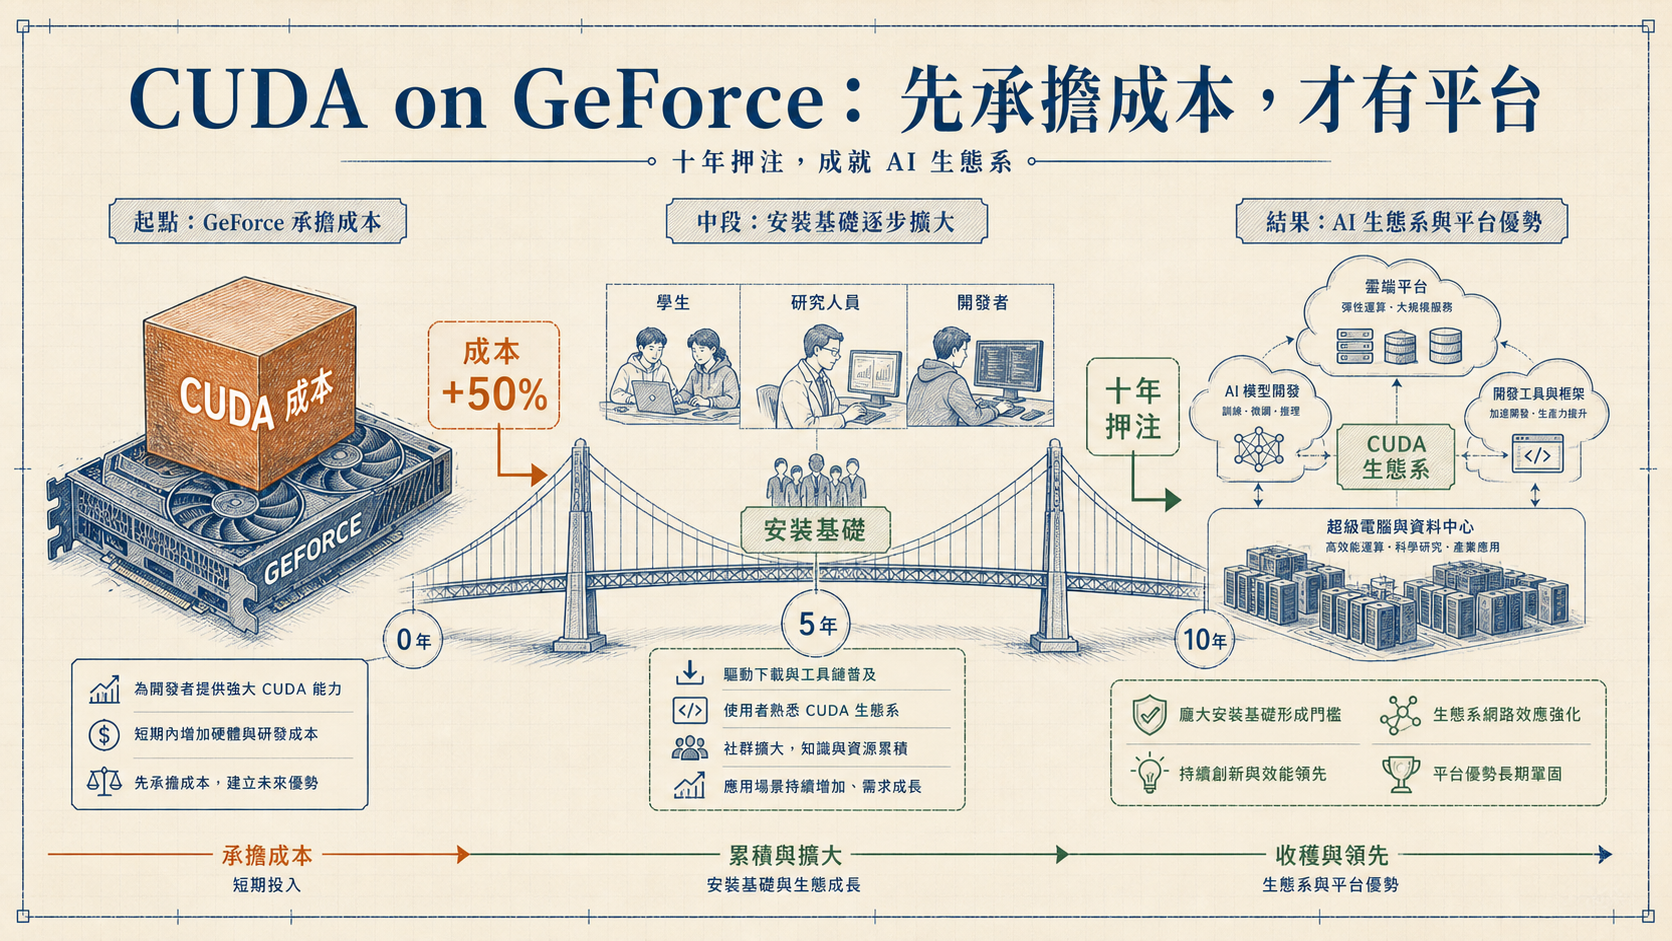
CUDA 的故事則顯示這種組織如何承擔長期押注。黃仁勳表示,把 CUDA 放進 GeForce 時,成本增加約 50%,而公司當時毛利率約 35%;玩家不會因為未來的通用運算可能性而多付錢,GeForce 卻必須先承擔平台建設成本。這個決策讓大量研究者與學生可以在既有 PC 安裝基礎上接觸 CUDA,最終形成開發者、教材、函式庫與應用的循環。
關鍵不只是「技術押對了」,而是 NVIDIA 願意讓消費產品補貼一個十年後才可能成熟的平台。黃仁勳也反覆強調 installed base:開發者選擇平台,不只看架構是否優雅,還看軟體能觸及多少使用者、公司是否會持續維護,以及今天投入的程式碼明天是否仍有價值。
他的領導方法同樣圍繞「讓推理過程公開」。不是在年底突然端出新使命,而是在日常會議、GTC、合作夥伴溝通中不斷鋪陳前提,直到收購 Mellanox、押注 deep learning 或推出新平台時,多數人已理解那條路徑。這比一次性的願景宣告更接近長期的 belief shaping。
但公開推理不等於權力自然分散。當一位高度成功的 CEO 持續塑造全體信念,團隊可能更容易形成共同方向,也可能更難區分「因為推理成立而認同」與「因為權威太強而認同」。可持續的制度必須允許成員在推理鏈中指出錯誤,而不只是等待領導者完成說服。
魚塘觀察
- 組織設計要對準產品依賴關係;跨部門整合愈早,後期返工通常愈少。
- 平台押注需要可承受的補貼來源與長期承諾,不是加一個 SDK 就能形成生態。
- 公開推理真正的驗收標準,是反對意見能否改變決策,而不是大家是否聽過完整論述。
043. 四條 Scaling Laws|算力需求為何沒有在推論時結束
黃仁勳把 AI 的擴充拆成四條 scaling laws。第一條是 pre-training:模型、資料與訓練算力增加後,能力隨之提升。第二條是 post-training:透過人類回饋、合成資料、蒸餾、微調與其他方法,把模型調整成更可用的系統。第三條是 test-time scaling:模型在回答時投入更多搜尋、推理、驗證與取樣。第四條則是 agentic scaling:一個 agent 不只自己工作,還會使用工具、建立子任務,甚至派生多個 sub-agents。
這四條不是彼此獨立的直線,而是一個回饋迴圈。agent 執行任務時產生經驗;其中有效的軌跡可以被整理成資料,回到訓練或後訓練;更新後的模型再用更多 test-time compute 完成更複雜工作。黃仁勳因此推導,資料瓶頸不會簡單終止 AI 擴充,因為模型與人類會持續生成新的訓練材料。
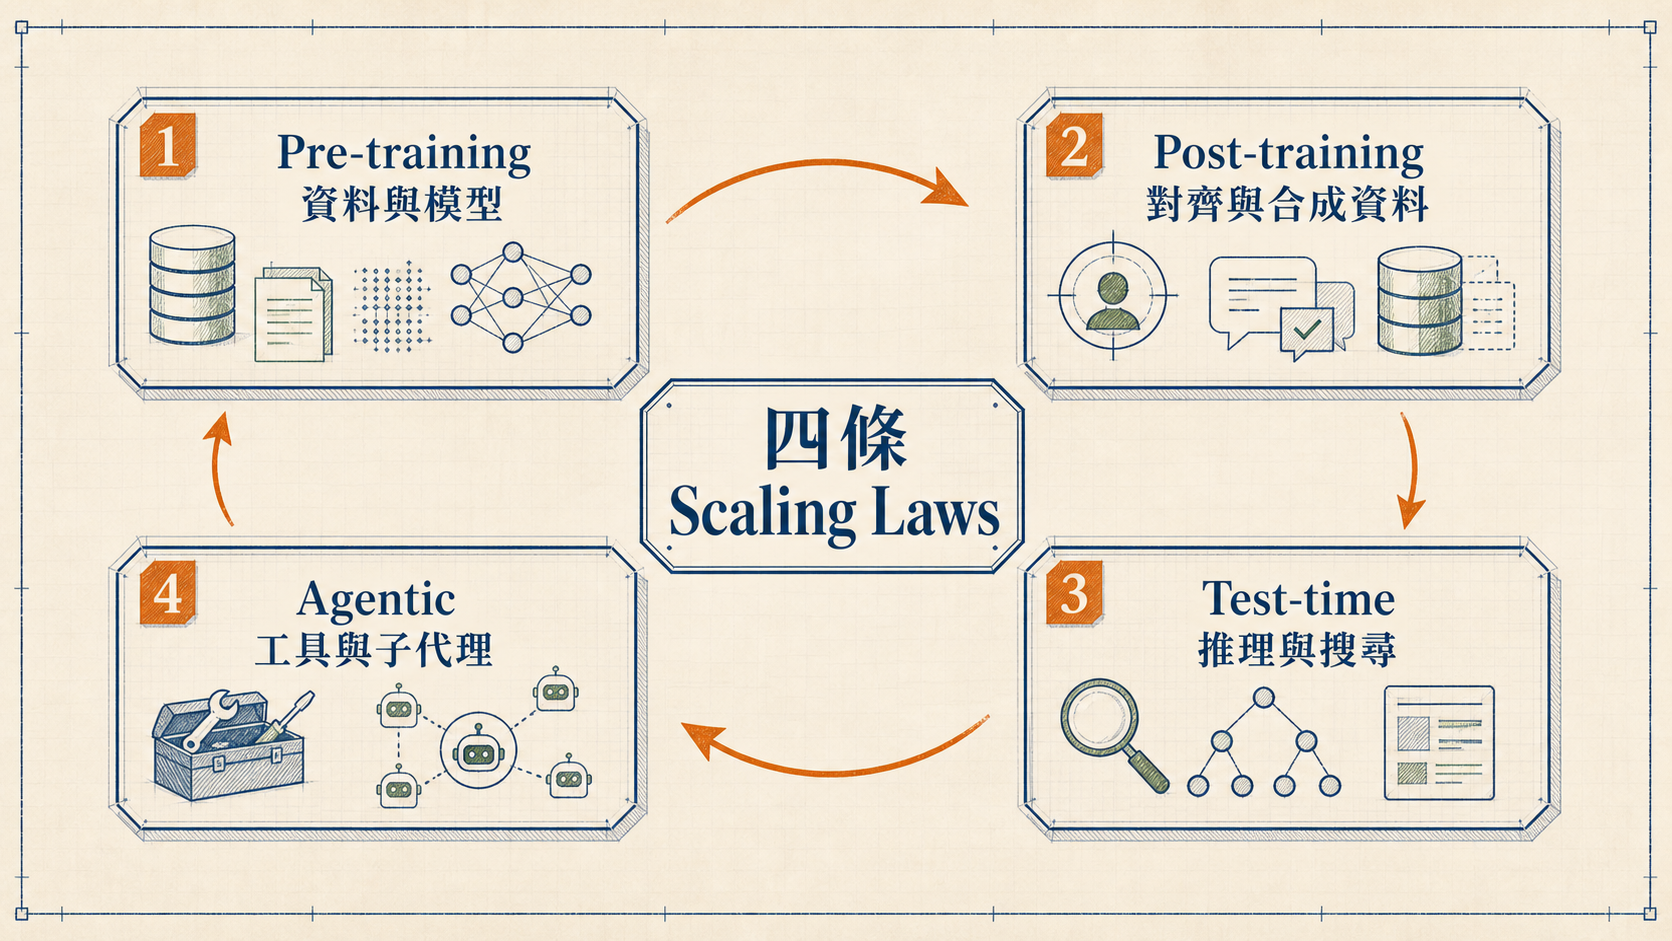
這套論證對 NVIDIA 極為有利,因為它把每一次軟體進步都轉化成更多硬體需求。推論不是一次矩陣運算,而是思考、規劃、搜尋、工具呼叫與反覆修正;agent 也不是一個模型實例,而可能是一整隊工作者。若每個工作流程都能使用更多計算換取更高成功率,算力市場就不會因訓練成熟而萎縮。
然而,「可以投入更多算力」不等於「經濟上值得投入更多算力」。test-time scaling 必須通過延遲、成本、可靠性與邊際收益檢驗。若 agent 花十倍 token 只讓成功率增加一點,企業可能改用更小模型、更好的工具接口、快取、規則系統或人類覆核。算力需求不是純技術函數,也是價格與商業價值的函數。
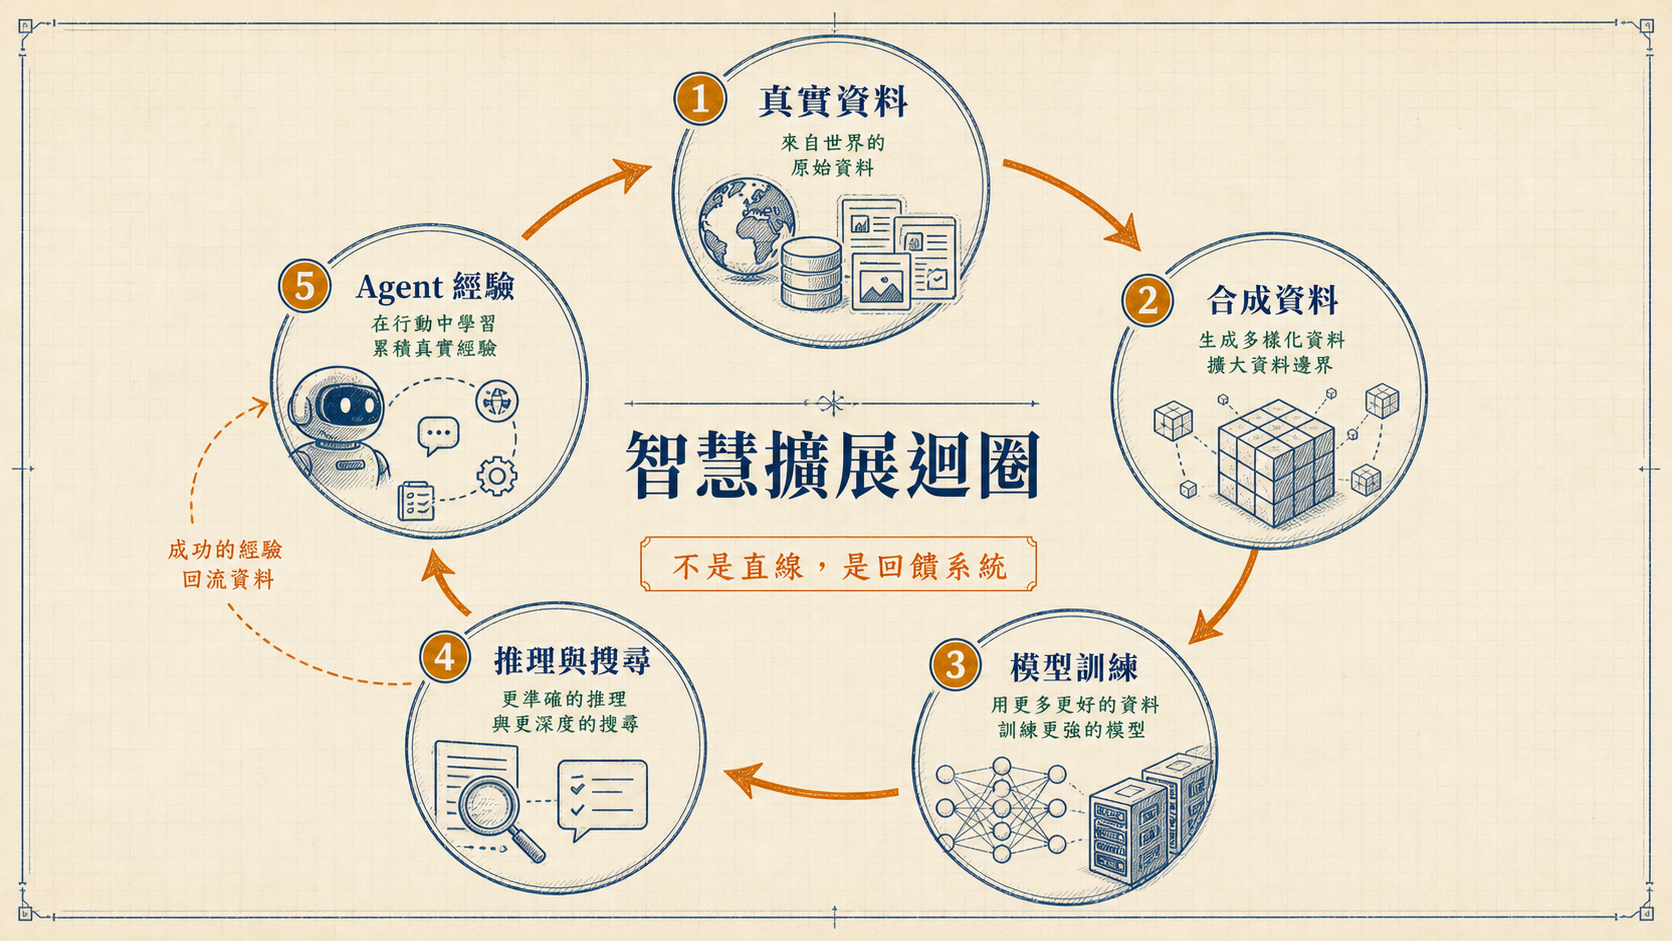
另一個困難是週期錯配。模型架構可能每幾個月改變,資料中心硬體卻需要兩到三年設計、採購與部署。黃仁勳認為 NVIDIA 必須靠自研模型、接觸整個產業與 CUDA 的彈性提前推理未來需求。這說明為何 NVIDIA 不只做晶片,也投資模型、框架與應用:它需要第一手理解 workload,才能在硬體還來不及修改之前下注。
這也可能形成自我實現。當最大硬體平台提前針對某種模型架構最佳化,開發者自然更容易採用那種路徑;平台不是被動追隨軟體,也在塑造哪些軟體更容易成功。
魚塘觀察
- 四條 scaling laws 是有用框架,但不是自然定律;每一條都受成本、資料品質與收益遞減約束。
- agent 是否推高算力,應觀察每項成功任務的總 token、工具呼叫次數與完成成本,而非只看活躍使用者。
- 軟硬體共同演化會提高效率,也會讓主流平台更有能力定義「值得最佳化的未來」。
054. Agent 不是新介面|它會讀檔、用工具、派生團隊
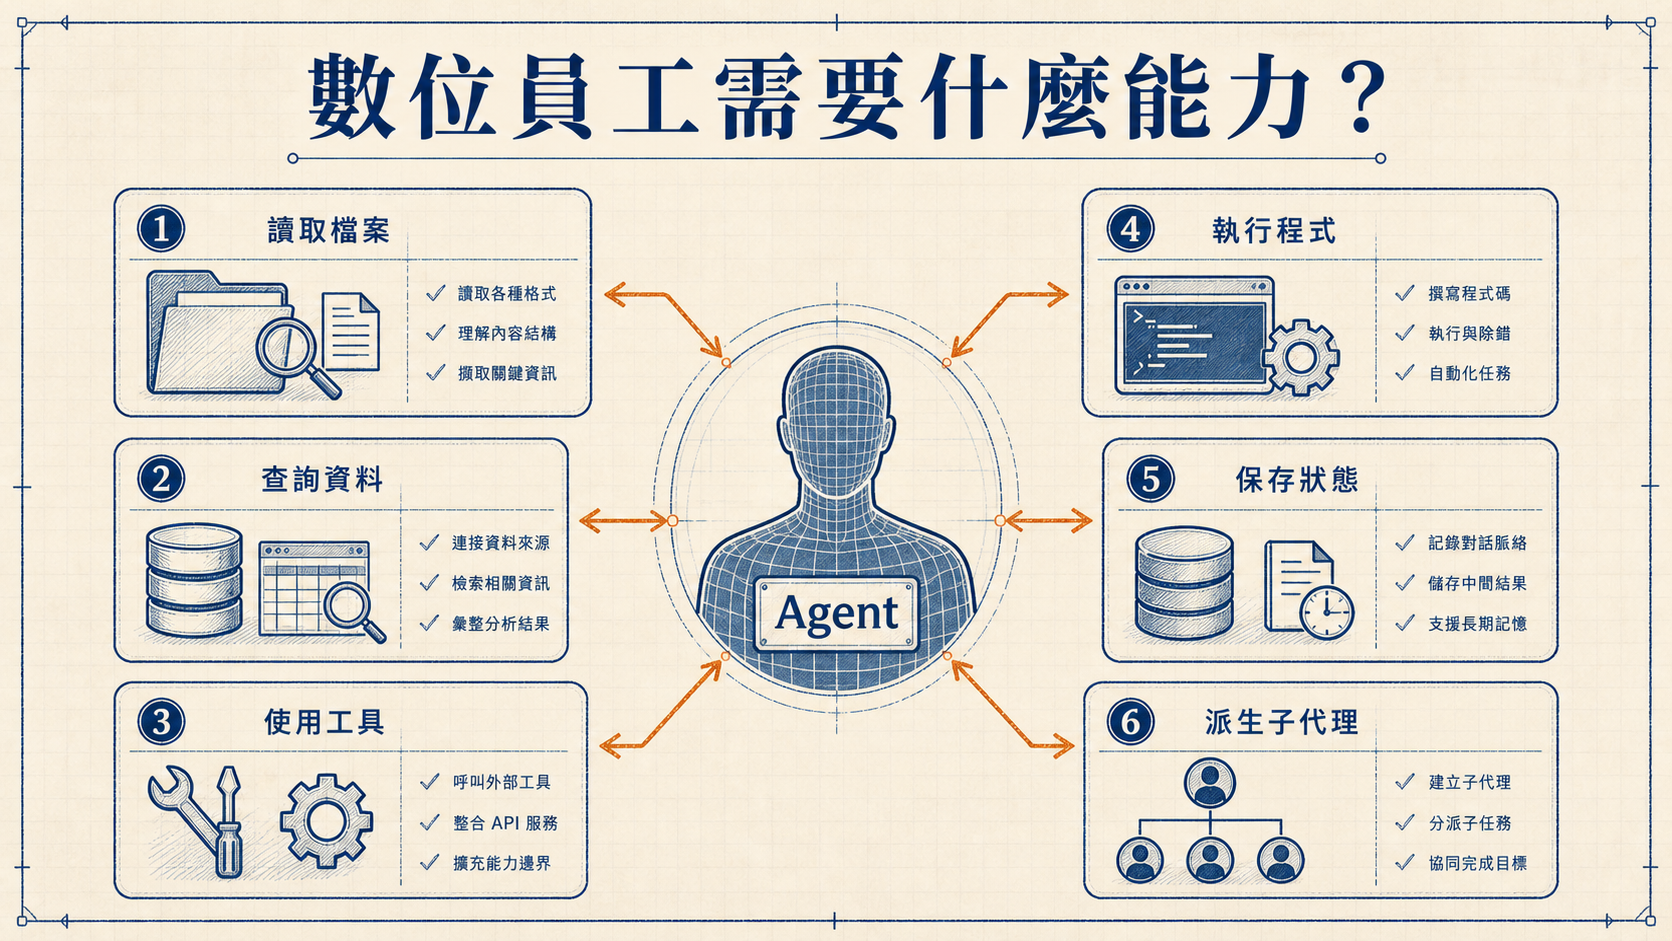
訪談中最接近當下工作現場的一段,是黃仁勳對「數位員工」的拆解。他不把 agent 理解成更會聊天的模型,而是從一個員工需要做什麼開始推理:它必須讀取 ground truth,例如檔案與資料庫;必須在不知道答案時自己研究;必須使用人類已存在的工具;必須能執行程式、保存狀態、接受權限控制,必要時還要把任務分給其他 agent。
他用人形機器人做思想實驗:未來的機器人更可能學會使用微波爐、鐵鎚與手術工具,而不是讓手臂隨時變形成所有工具。軟體 agent 也是同樣道理。工具不會因 AI 出現而消失,反而需要更清楚的接口、說明與權限,才能讓機器可靠使用。
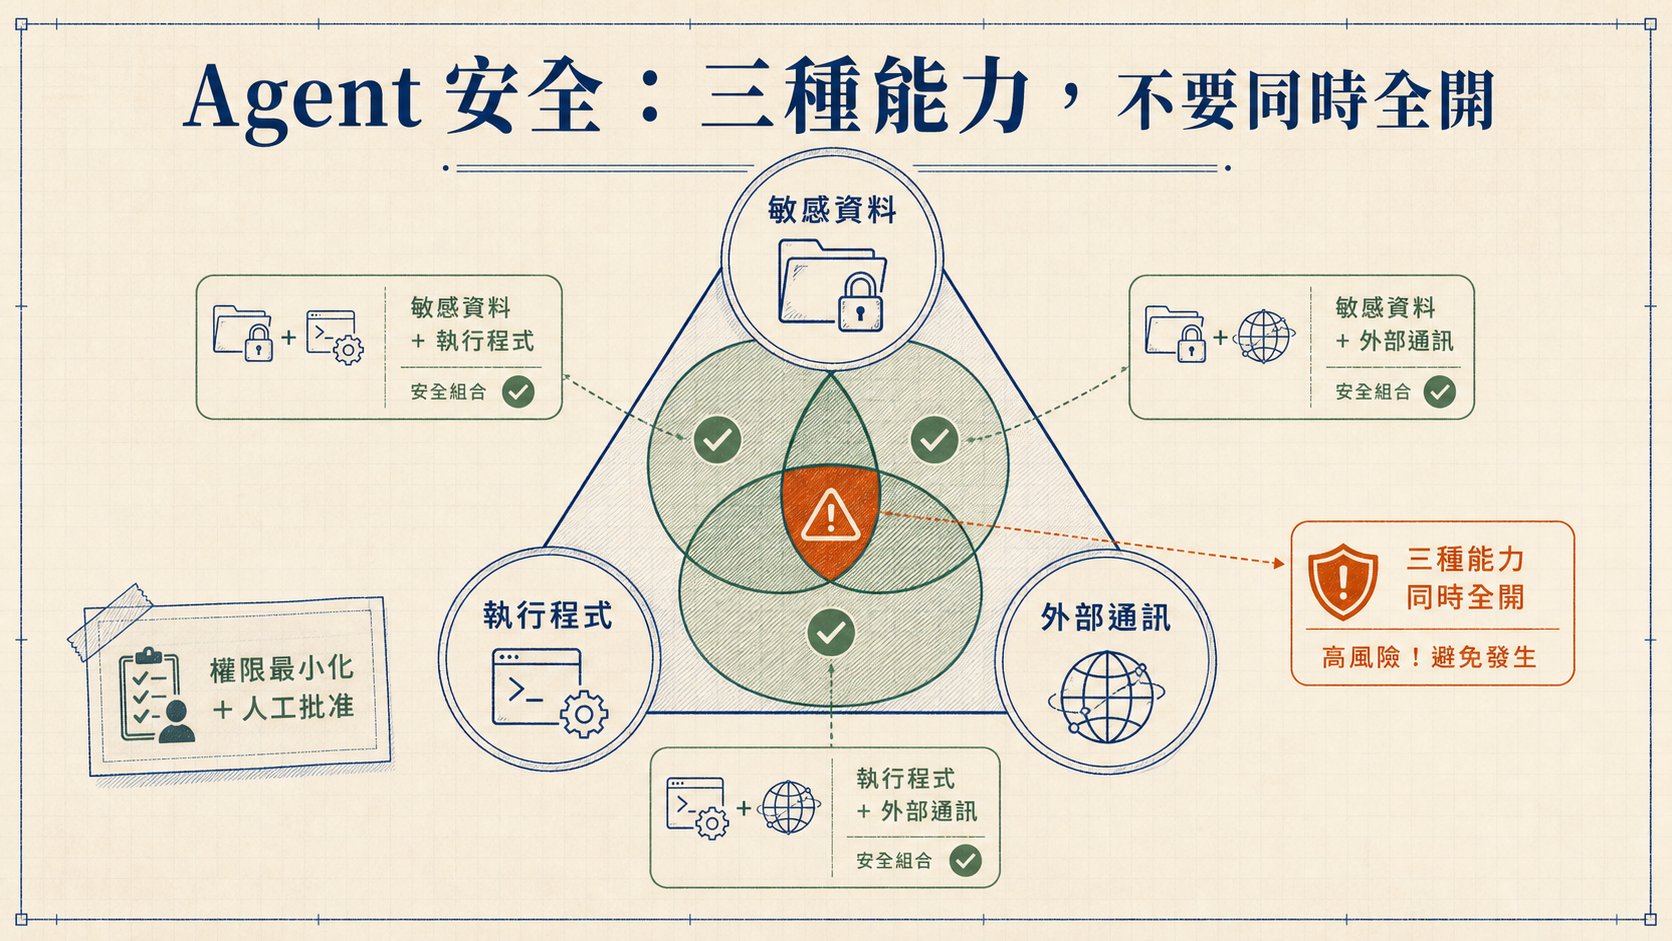
這正是 OpenClaw 類系統令人著迷、也令人不安的地方。模型一旦能讀取私人資料、執行程式並連上外部網路,就同時具備取得資訊、改變系統與把資料送出去的能力。黃仁勳提到一種「三選二」安全概念:敏感資訊、程式執行、外部通訊三種能力,不應在沒有控制的情況下同時開放。
這個框架不是完整安全答案,卻抓到 agent 風險的核心:危險通常不是來自單一能力,而是能力組合。例如,能讀秘密但不能外傳,風險較小;能執行程式但沒有敏感資料,也較容易隔離;三者同時存在時,prompt injection、依賴套件、瀏覽內容與錯誤指令都可能串成資料外洩或系統破壞。
黃仁勳將 OpenClaw 比作 agentic system 的 ChatGPT 時刻,反映的不是單一產品勝負,而是介面門檻的下降:一般人第一次可以直接感受到「一個會持續做事的 AI」與「一個只回答問題的 AI」有何不同。它會主動回報、要求下一步、在背景處理任務,甚至比人更頻繁地發訊息。
但 agent 的流暢感很容易掩蓋可靠性問題。真正的數位員工需要知道任務是否完成、證據在哪裡、哪些動作需要批准、失敗後如何復原、成本是否超標。能夠開很多 session,不等於能夠管理很多可靠工作者;若缺少驗收與狀態治理,只是把錯誤與噪音平行化。
魚塘觀察
- agent 的產品單位應該是「可驗收任務」,不是聊天輪數或啟動 session 數。
- 工具介面、權限、日誌、回滾與人工 checkpoint,會比模型語氣更決定企業能否部署。
- 讀資料、跑程式、連外三種能力的組合必須明確設計,不能只靠模型自律。
065. 供應鏈也要被共同設計|HBM、整櫃製造與信任資本
AI 基礎設施無法只靠 NVIDIA 自己擴張。黃仁勳描述,他長期向記憶體、晶圓、設備、系統與下游企業的 CEO 解釋未來 workload,試圖讓合作夥伴提前投資 HBM、LPDDR、先進封裝、電力與製造能力。這種工作不只是採購,更像把整條供應鏈納入產品 roadmap。
他舉例,幾年前資料中心主流仍是 CPU 搭配 DDR,而 NVIDIA 已要求合作夥伴擴大 HBM,並把手機常見的低功耗記憶體調整到超級電腦需求。若供應商相信需求,便必須在訂單完全落地前投入數十億美元;若判斷錯誤,折舊與產能閒置也由供應鏈共同承擔。
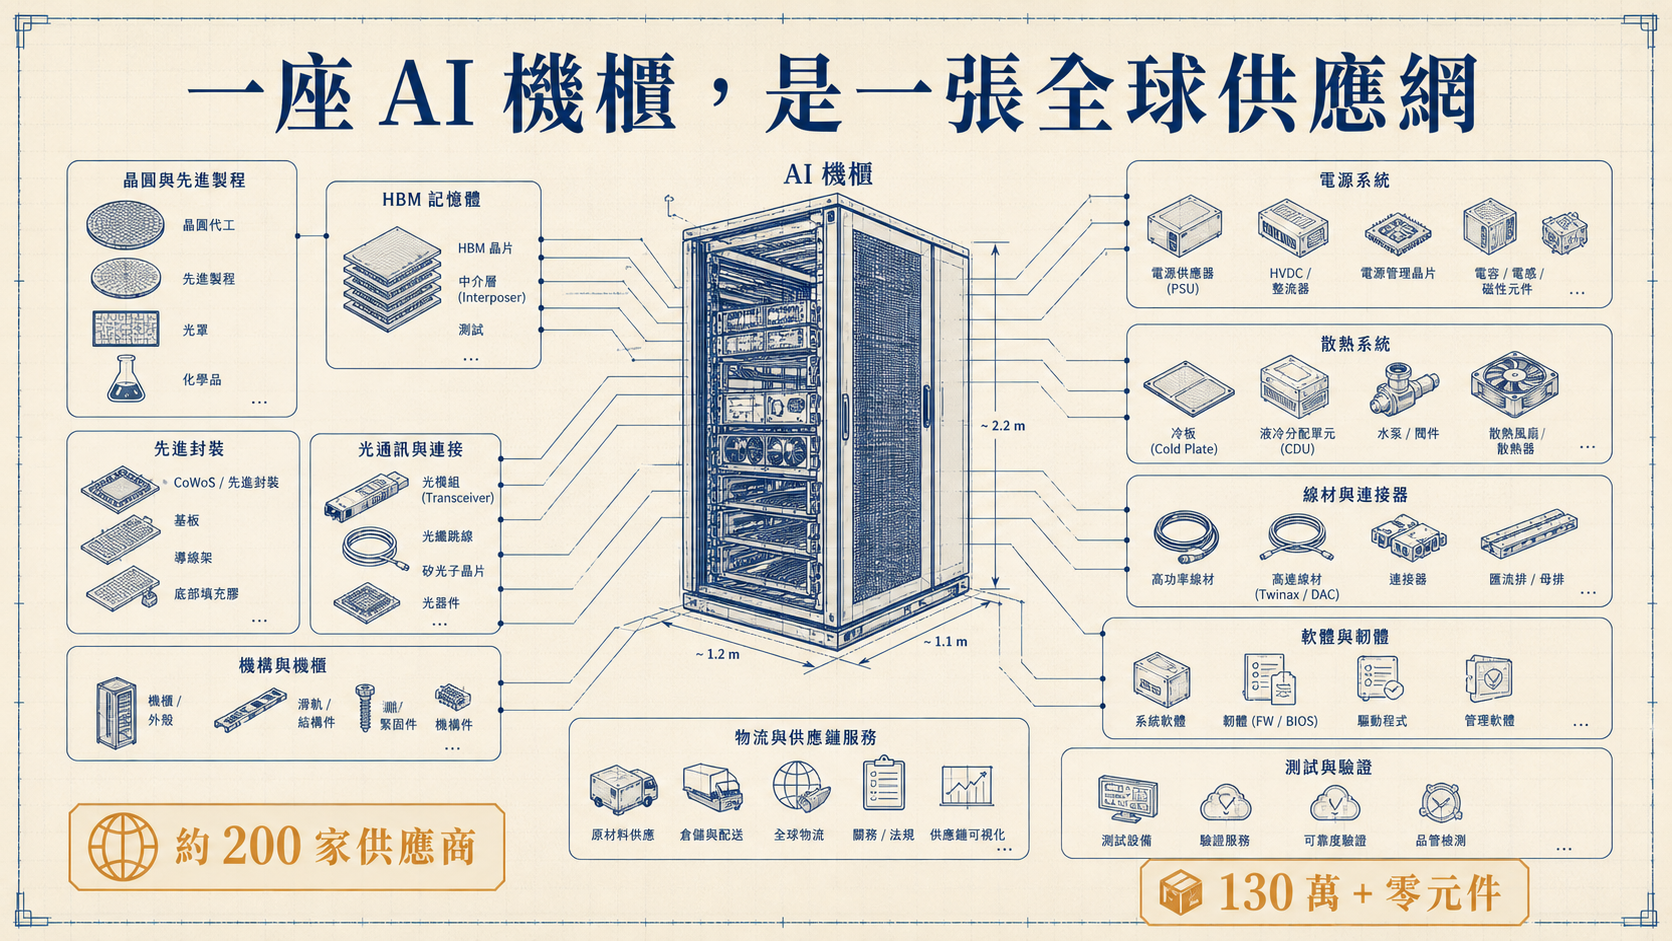
黃仁勳表示,單一 Vera Rubin 機櫃涉及約 200 家供應商與 130 萬至 150 萬個零元件。這些數字屬講者說法,但它們傳達的尺度很清楚:AI 系統已不再適合把零件送到資料中心後才慢慢組裝。高密度 NVLink 機櫃需要在供應鏈端完成整合、測試與驗證,再以數噸重量整櫃運送。
製造邊界的移動會改變電力與資本需求。若資料中心未來每週新增大量運算容量,代工與系統製造端也必須先取得足夠電力,把機櫃完成並燒機。瓶頸不只存在於最終機房,也可能前移到工廠測試、變壓設備、物流、冷卻液與現場施工。
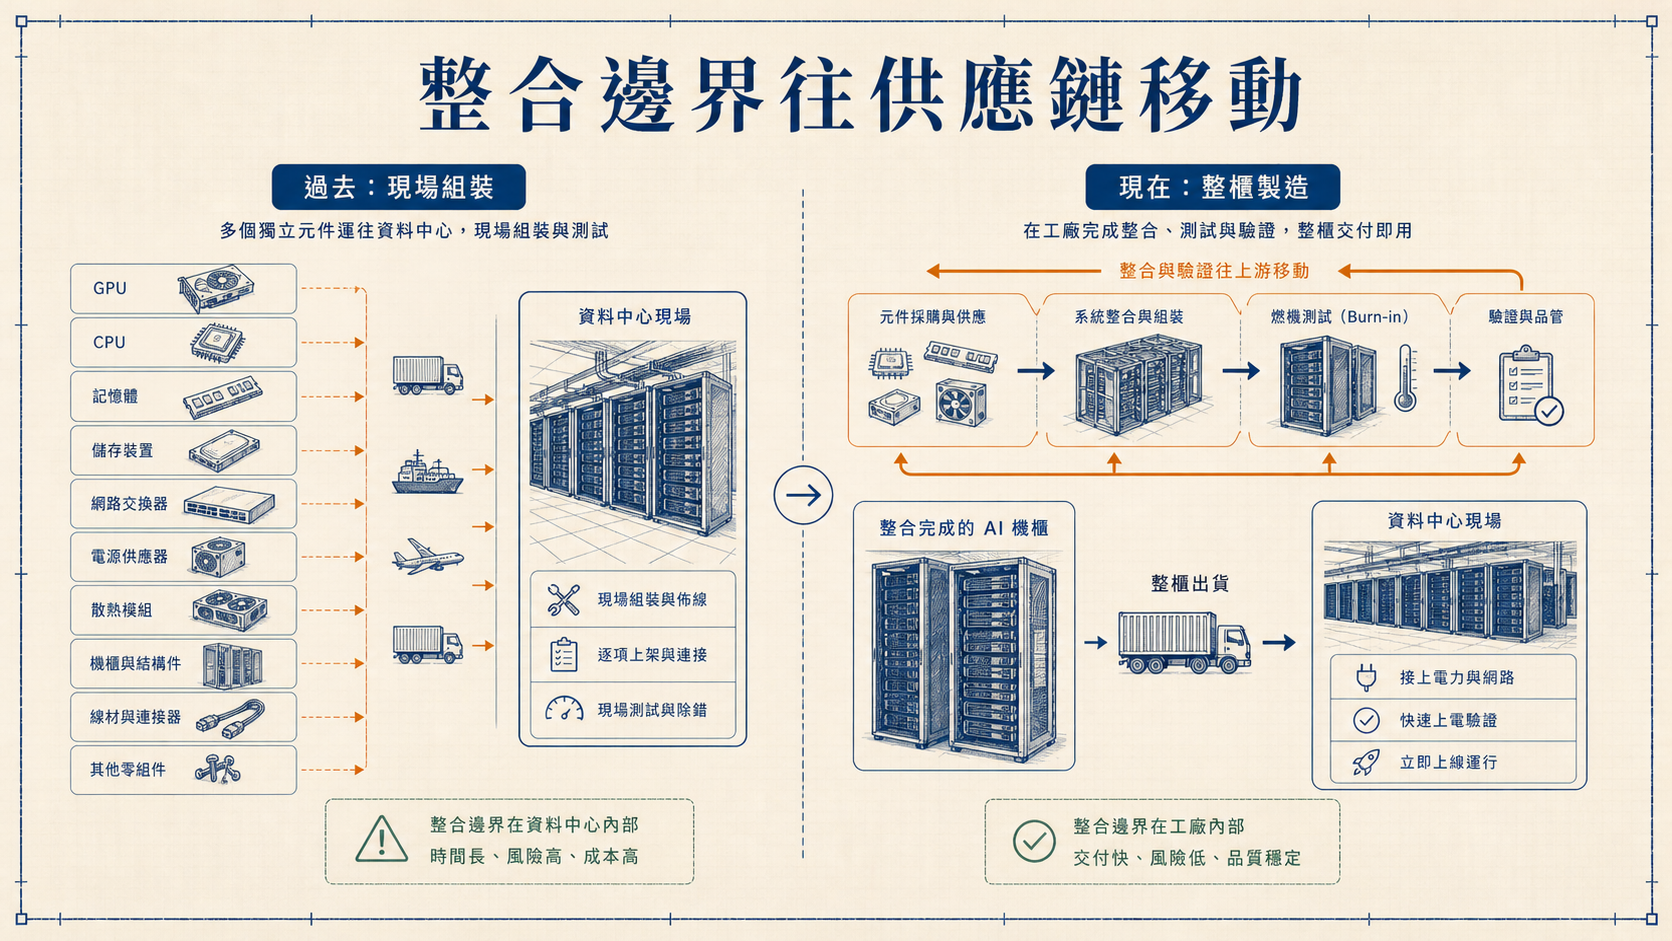
這裡最值得注意的資產不是某一項零件,而是信任。供應商願意提前擴產,是因為相信 NVIDIA 的需求判斷與執行能力;NVIDIA 能承諾交付,也因為相信台積電、記憶體廠與系統商會完成投資。黃仁勳把與台積電長達 30 年的合作,描述成技術、服務與承諾共同累積的結果。
但供應鏈信任不是零風險。當單一客戶或單一平台的需求占比快速提高,合作夥伴也會承擔集中度風險。資本支出一旦依照極樂觀成長曲線安排,需求放緩便可能沿著整條鏈條放大。共同設計未來,也代表共同承擔預測錯誤。
魚塘觀察
- AI 供應鏈的核心能力不只是產能,而是提前數年協調規格、資本支出與測試方式。
- 整櫃製造把資料中心整合問題前移,會創造新效率,也會創造新的工廠電力與物流瓶頸。
- 判斷供應鏈健康時,要同時看需求可見度、客戶集中、預付款、折舊與產能利用率。
076. 電力不是只有發更多電|資料中心能否學會優雅降級
談到 AI 能源問題時,黃仁勳沒有只回答「蓋更多電廠」。他的第一個方向是提高每瓦每秒生成的 token,也就是讓系統在相同能源下完成更多有效工作。第二個方向,則是重新檢查資料中心與電網之間的合約:是否每一項 AI 工作都真的需要接近零中斷、最高等級的供電保證?
他指出,電網通常要為極端天氣與尖峰需求保留安全餘裕,多數時間並未跑在峰值。若資料中心可以在少數緊張時段降低功率、延後非關鍵推論、轉移工作負載或使用備援能源,就可能利用原本因可靠性要求而閒置的容量。
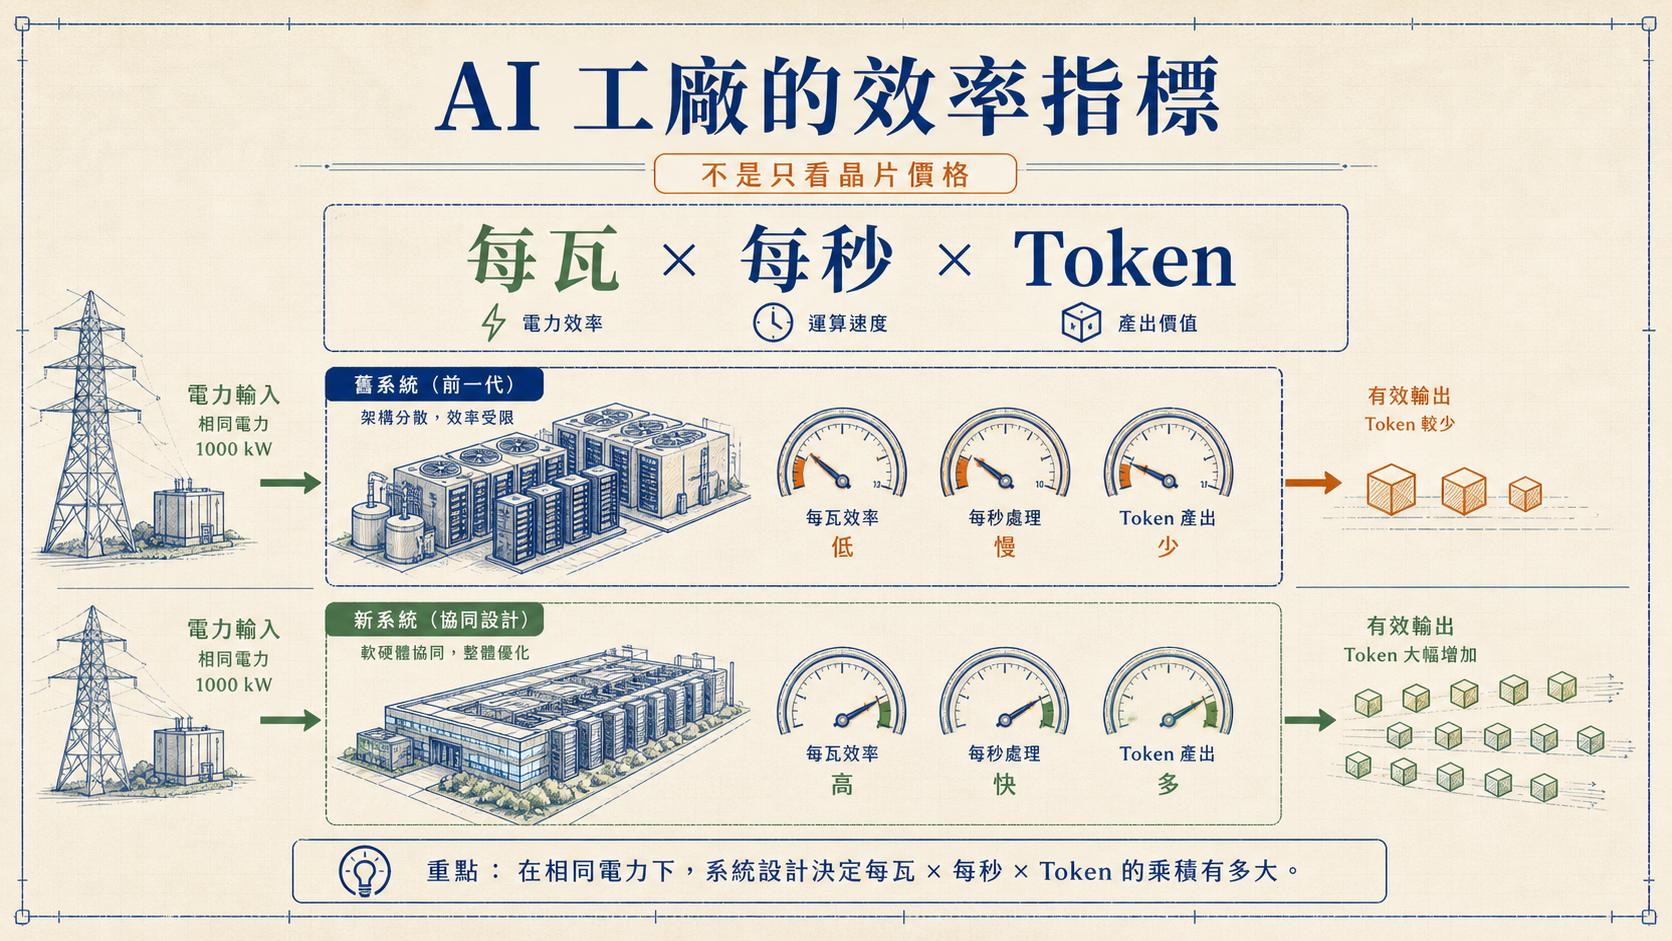
這個想法把資料中心從固定負載改成可調度負載。過去雲端服務常把 100% uptime 當成理想,合約再把近乎完美的可靠性要求一路傳給電力公司,迫使電網為極少數情況過度建設。若客戶願意購買分級服務,低優先工作可以接受延遲,高優先工作才保留最高可靠性,整體電力配置會更接近航空或網路系統中的分級資源管理。
工程上,這需要真正的 graceful degradation。系統不能一降電就遺失資料或讓所有服務同時崩潰,而要知道哪些模型可以降頻、哪些 batch 可以延後、哪些請求可以換到其他區域,以及哪些工作必須維持。電力調度會進入 scheduler、模型路由、SLA 與計費系統,而不只是機房設備問題。
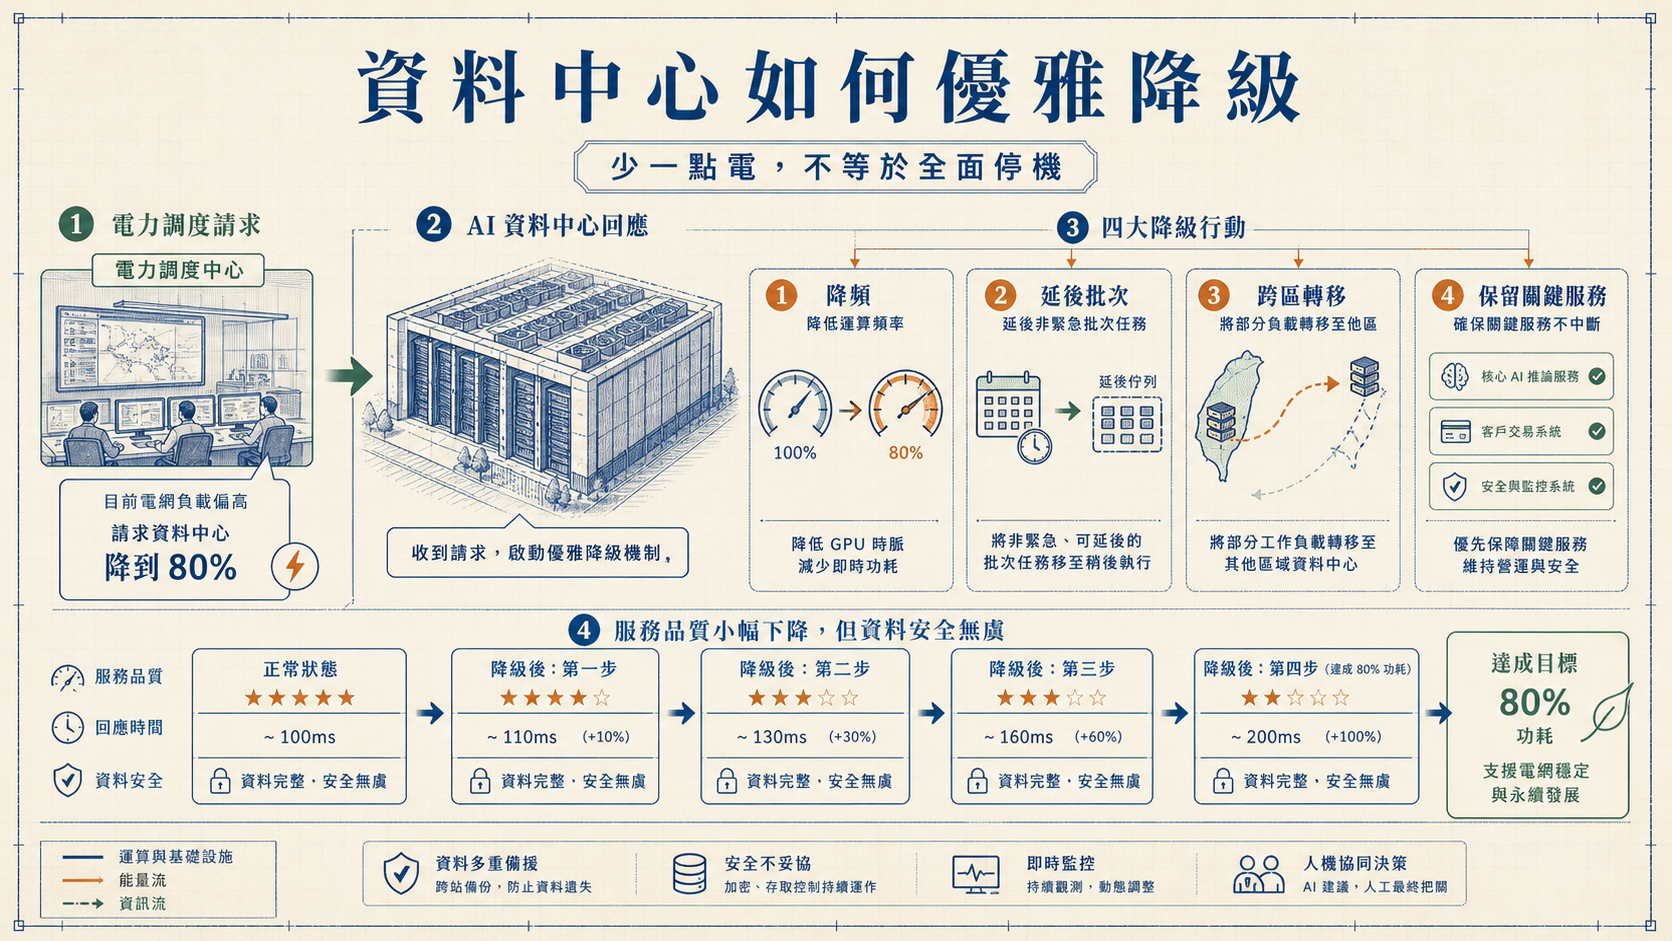
這個方向值得重視,卻不能被當成能源問題已解。電網剩餘容量具有地區、時段與輸電限制;資料中心也需要土地、水、變電設備與長期許可。備援發電可能帶來排放與地方空污,跨區轉移則需要網路、資料治理與多地容量。更重要的是,效率提升有時會降低單位成本,反而刺激更多使用,形成 rebound effect。
因此,token per watt 不能單獨代表永續。更完整的指標還要包括總用電、碳強度、用水、硬體壽命、尖峰負載與每項成功任務的能源。AI 工廠若真的成為經濟基礎設施,就必須像其他工廠一樣接受外部成本檢驗。
魚塘觀察
- 電力問題同時是效率、合約、排程、電網與環境問題,不能只用新增發電量回答。
- graceful degradation 可能是 AI 基礎設施的重要軟體能力。
- 「單位 token 更省電」不保證總能源下降,還要觀察需求成長是否吃掉效率收益。
087. CUDA 的護城河|安裝基礎、速度與開發者信任
當 Lex 問 NVIDIA 的護城河時,黃仁勳沒有先回答電晶體、GPU 架構或單一函式庫,而是回答 installed base。這和他前面回顧 CUDA on GeForce 的故事一致:平台的力量來自有多少裝置可用、有多少開發者已投入、有多少軟體依賴它,以及市場是否相信平台明天仍會存在。
CUDA 的第一層護城河是相容範圍。開發者可以從個人 GeForce、工作站、企業伺服器一路到大型雲端使用相近架構。第二層是軟體堆疊:函式庫、編譯器、工具、模型最佳化與領域套件把硬體能力轉成可用生產力。第三層是更新速度:若每一代平台都能讓既有程式得到顯著提升,留在生態中的價值便持續增加。
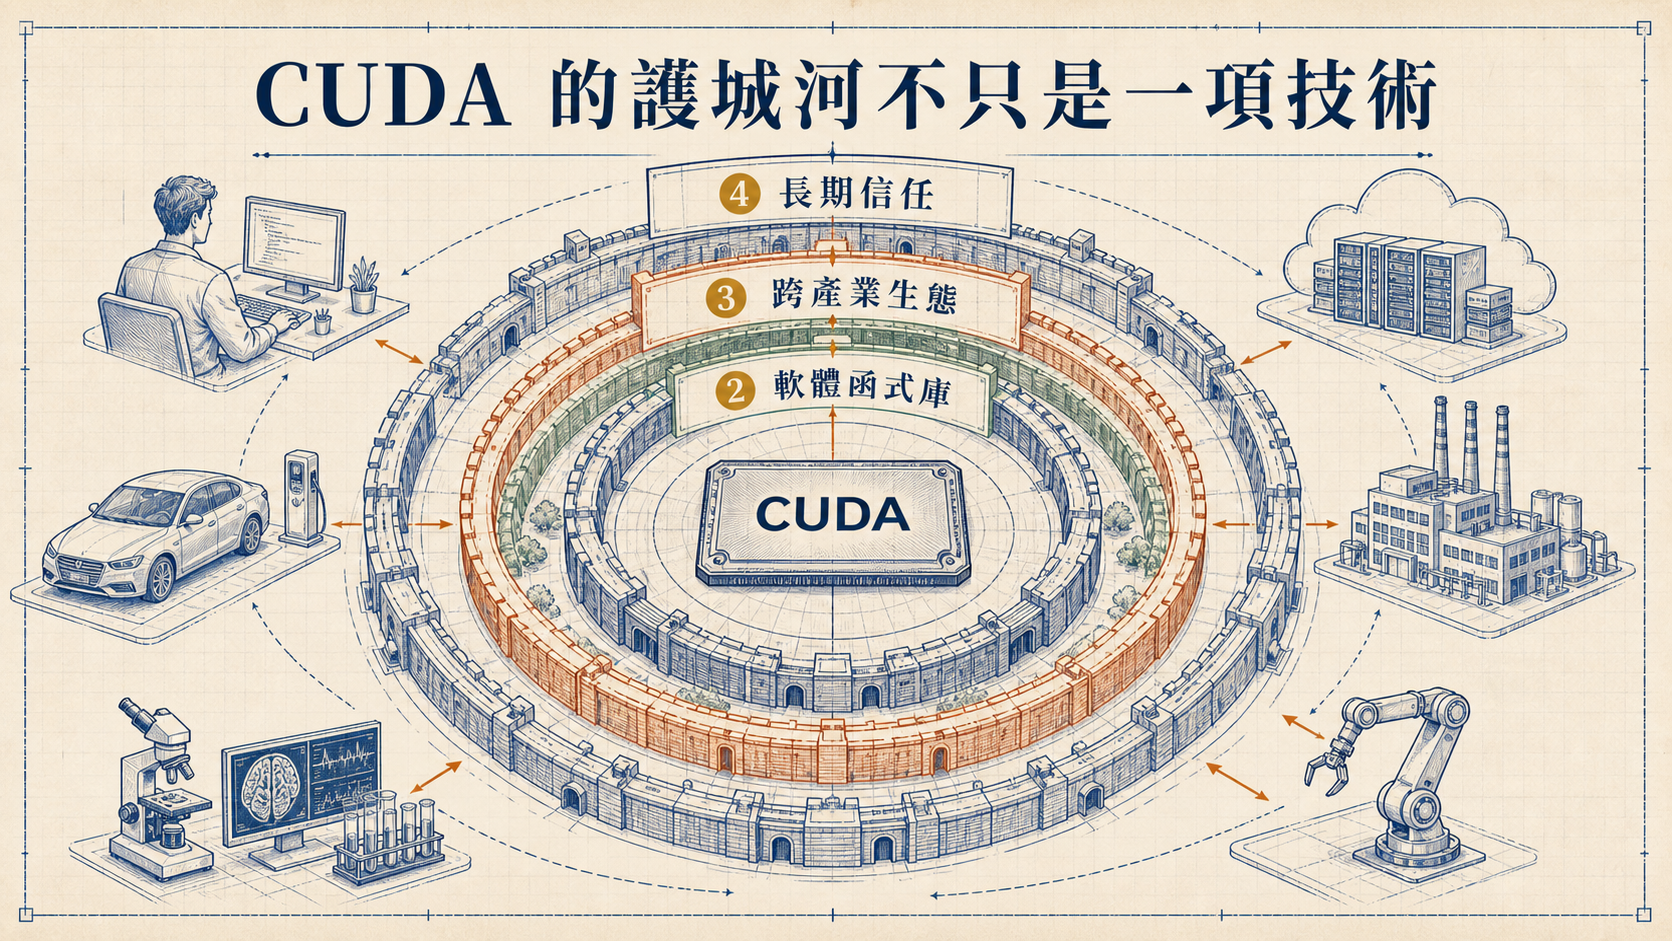
第四層則是信任。開發者押注的不只是今天效能,而是相信 NVIDIA 會維護相容性、持續投資並讓軟體到達更多市場。這類信任一旦形成,競爭者即使做出更快或更便宜的晶片,也必須回答遷移成本、工具完整度、供貨、雲端可得性與長期 roadmap。
台積電的例子提供另一種護城河。黃仁勳認為外界常把台積電優勢縮減成製程技術,忽略它同時管理數百客戶的需求變動、晶圓排程與交付承諾。技術領先、客戶服務與長期信任三者共同存在,才讓客戶願意把公司命運壓在其製造能力上。
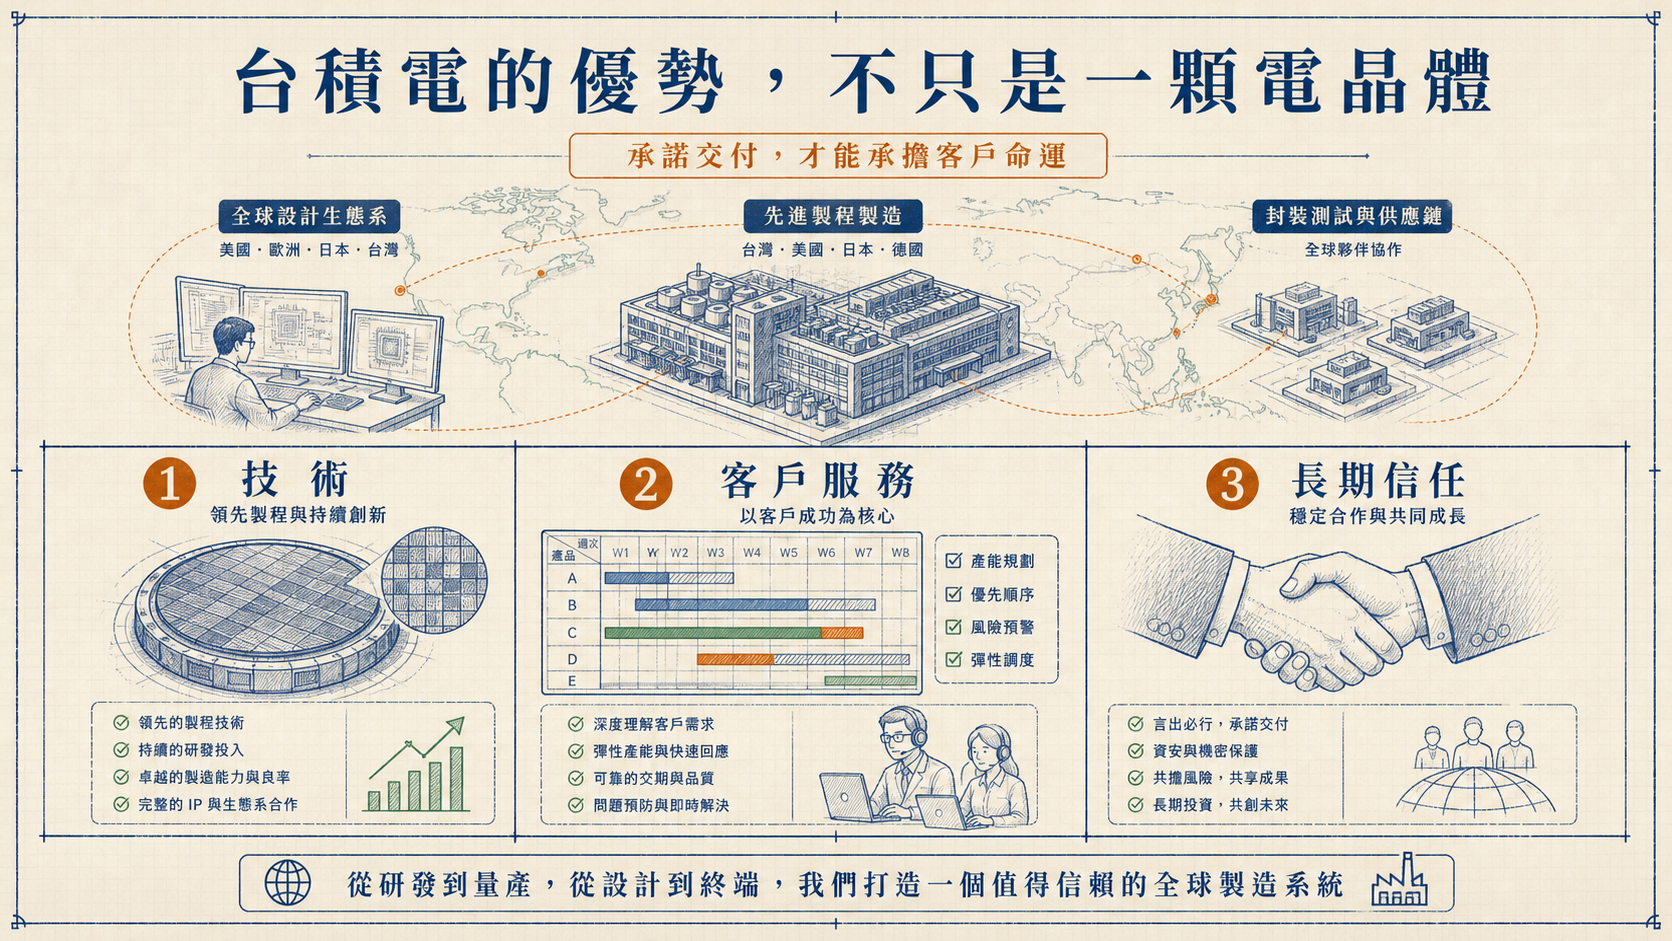
不過,信任與鎖定往往是一體兩面。平台愈可靠,客戶愈願意集中;集中愈高,替代方案就愈難成熟。監管者、雲端公司與大型模型實驗室因此會持續培養自研晶片、開放標準與第二供應來源。NVIDIA 的護城河很深,不代表競爭只會發生在 GPU 規格表上。
另一個問題是開放。NVIDIA 一方面主張 open source 模型有助於所有產業加入 AI,另一方面 CUDA 仍是強力控制的平台。這並非簡單矛盾:開放模型可以擴大整體 workload,而 NVIDIA 仍可在運算層捕捉價值。理解其開源策略,需要同時看技術貢獻與商業位置。
魚塘觀察
- 平台護城河的核心不是某一版產品,而是遷移成本、開發者預期與跨代承諾。
- 信任可降低協調成本,但也可能放大集中風險。
- 評估替代方案時,不能只比晶片價格;要比較完整軟體、雲端供應、人才與部署成本。
098. 從倉庫到工廠|NVIDIA 如何論證下一個巨大市場
黃仁勳對 NVIDIA 未來規模的論證,建立在兩個比喻上。第一,傳統電腦像檔案倉庫:人先寫好文字、錄好影音、存進系統,再由搜尋與推薦取回。生成式 AI 則在當下依照情境產生內容,因此需要持續運算。第二,倉庫主要保存價值,工廠則生產可出售的產品;如果 token 能直接創造收入,資料中心便由成本中心變成生產設備。
這套「AI factory」敘事非常有力量。企業若相信每瓦電力可以轉成有價值的 token,就會用產出、良率、成本與收入來衡量資料中心,而不再只把伺服器視為 IT 預算。高階推理、藥物發現、程式設計、客服與工業控制,可以有不同 token 價格,形成類似產品分級。
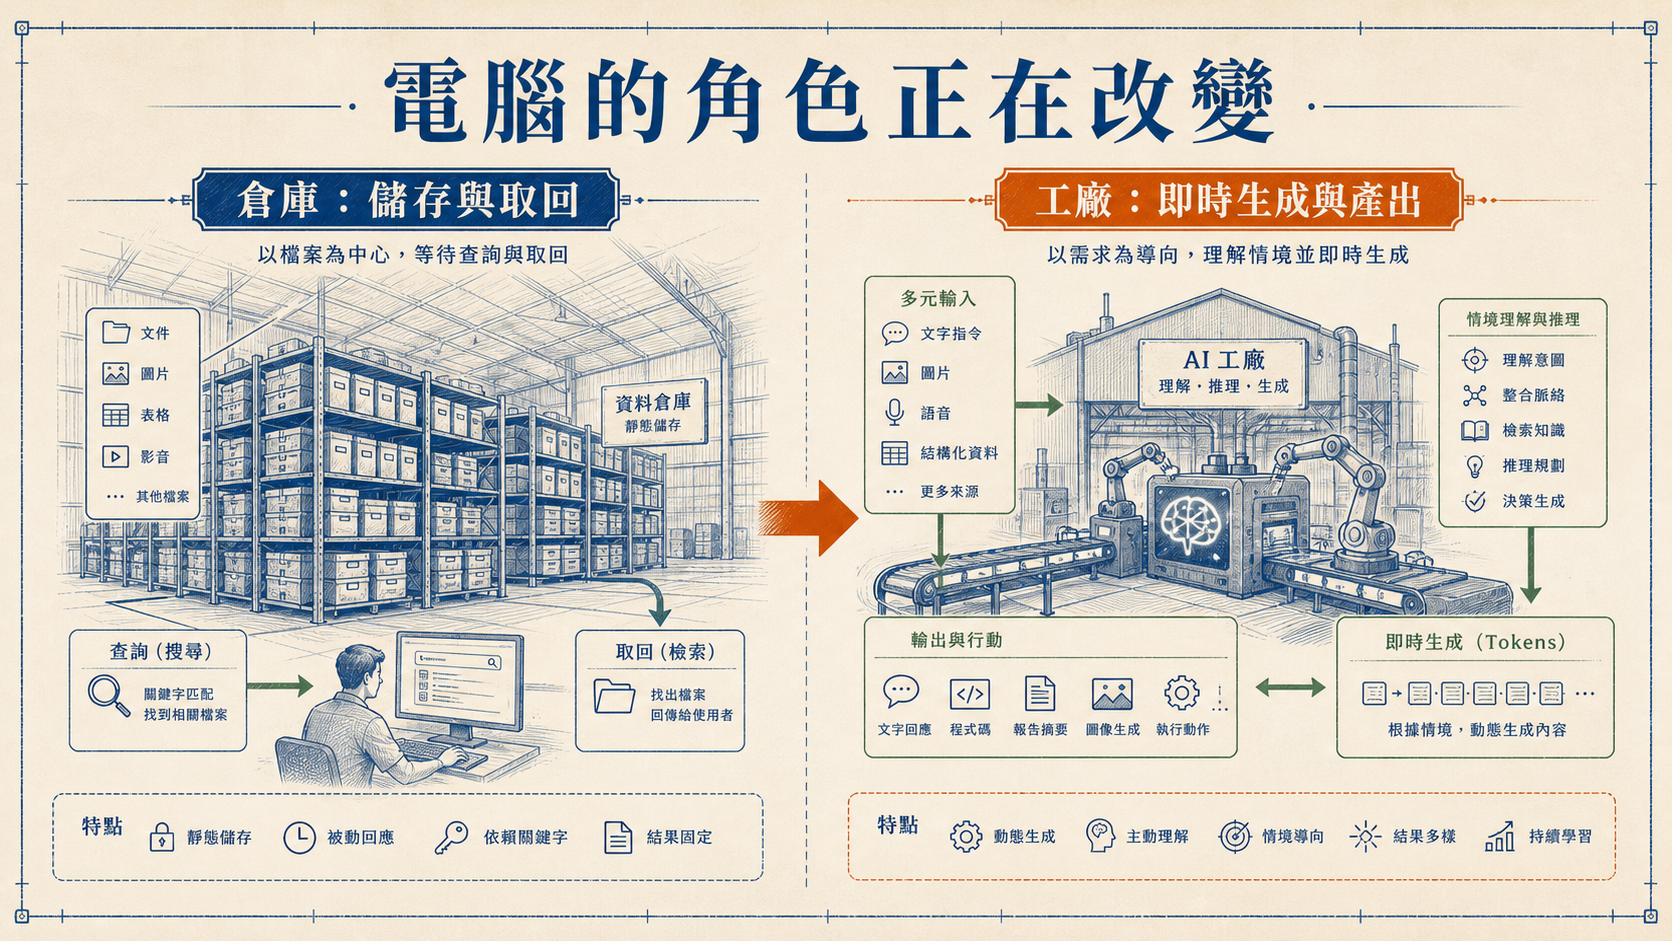
但「token 有價值」不能跳過需求驗證。不是每一個生成 token 都是商品,很多是重試、錯誤、冗長推理或無人使用的輸出。AI 工廠的真正產量應該是成功完成的任務、節省的時間、增加的收入或創造的新能力,而不是總 token 數。否則,增加運算可能只是在增加內部耗損。
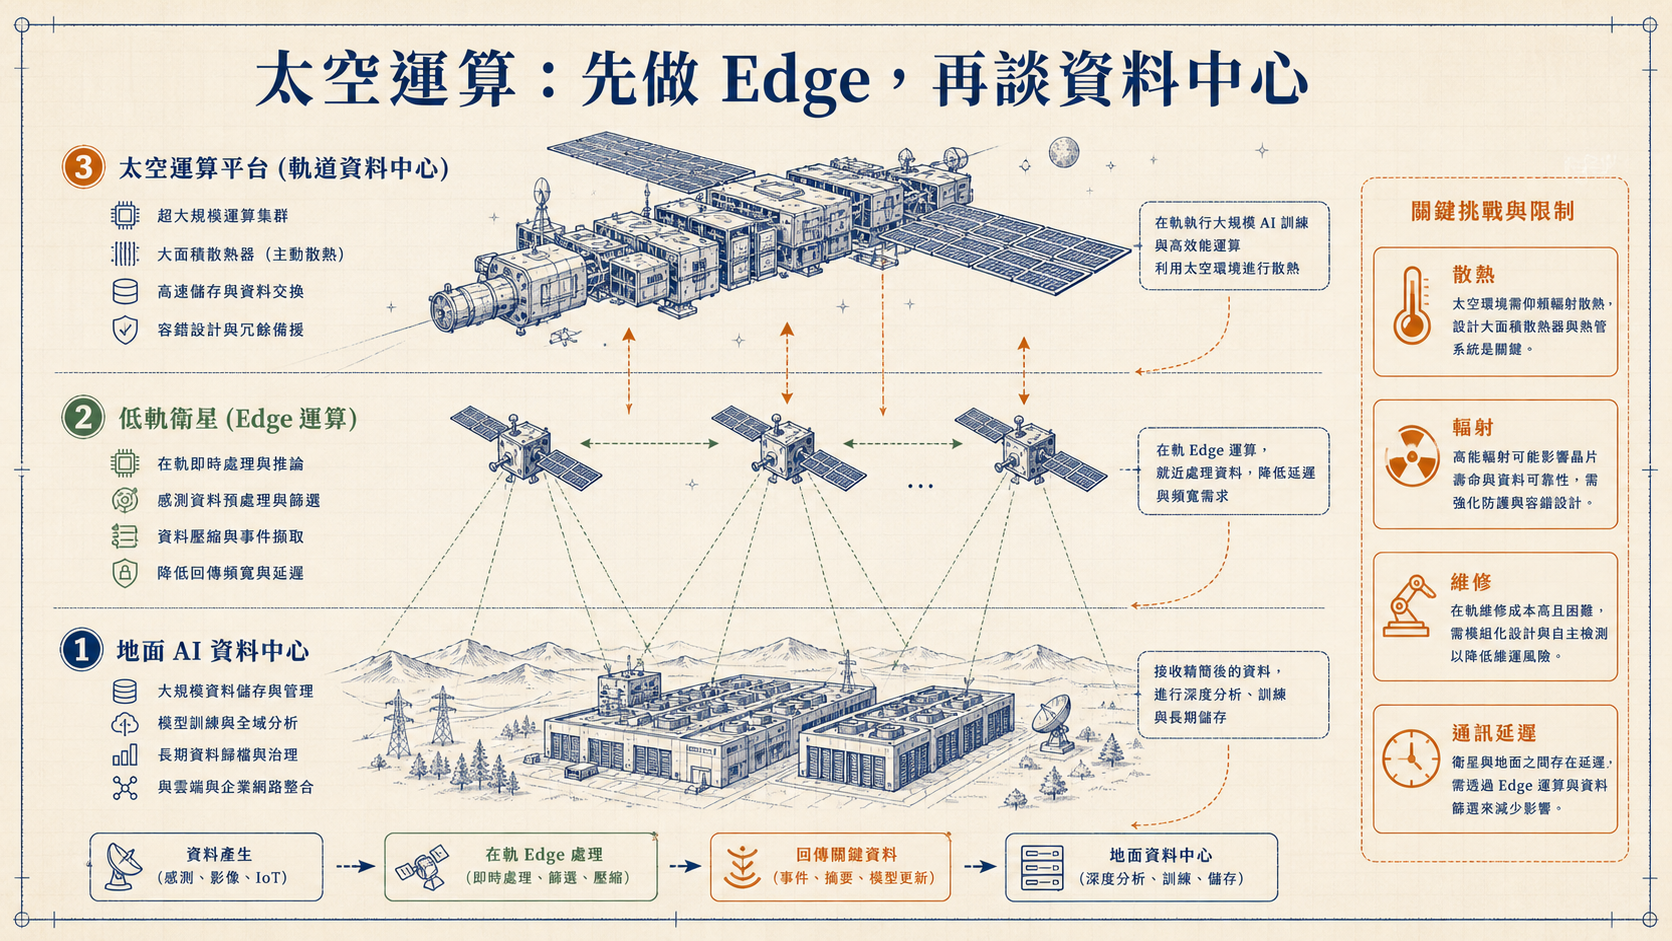
黃仁勳進一步談到太空運算。衛星本來就需要在 edge 端處理大量影像,避免把所有原始資料傳回地球;若未來軌道太陽能與發射成本改善,太空也可能承擔更多 AI 工作。但散熱、輻射、維修、冗餘與通訊延遲仍是巨大限制。他自己的優先順序也相對務實:先消除地球上的浪費,同時提前研究太空環境。
至於 NVIDIA 是否可能成為十兆美元公司,黃仁勳的回答本質上是可能性論證:生成式運算會提高全球 compute 占比,AI 工廠會產生收入,供應鏈可以共同承擔擴張,能源也終將增加。這些前提若成立,現有市場規模便不是上限。
但市值不是只由物理可行性決定。競爭、價格、毛利、資本支出、折舊、監管、地緣政治與客戶議價都會影響最終價值。把「沒有物理定律禁止」當成「商業上接近必然」,中間仍有很長距離。這正是閱讀企業領袖未來敘事時最需要保留的空白。
魚塘觀察
- AI factory 的好指標不是 token 總量,而是每項成功任務的成本與商業價值。
- 太空運算短期更合理的場景是衛星 edge processing,不是立刻把大型資料中心搬離地球。
- 市場規模推演應同時納入競爭、價格下降、資本效率與監管,而不是只看需求曲線。
109. 光速思維與領導壓力|先問物理極限,再談流程改進
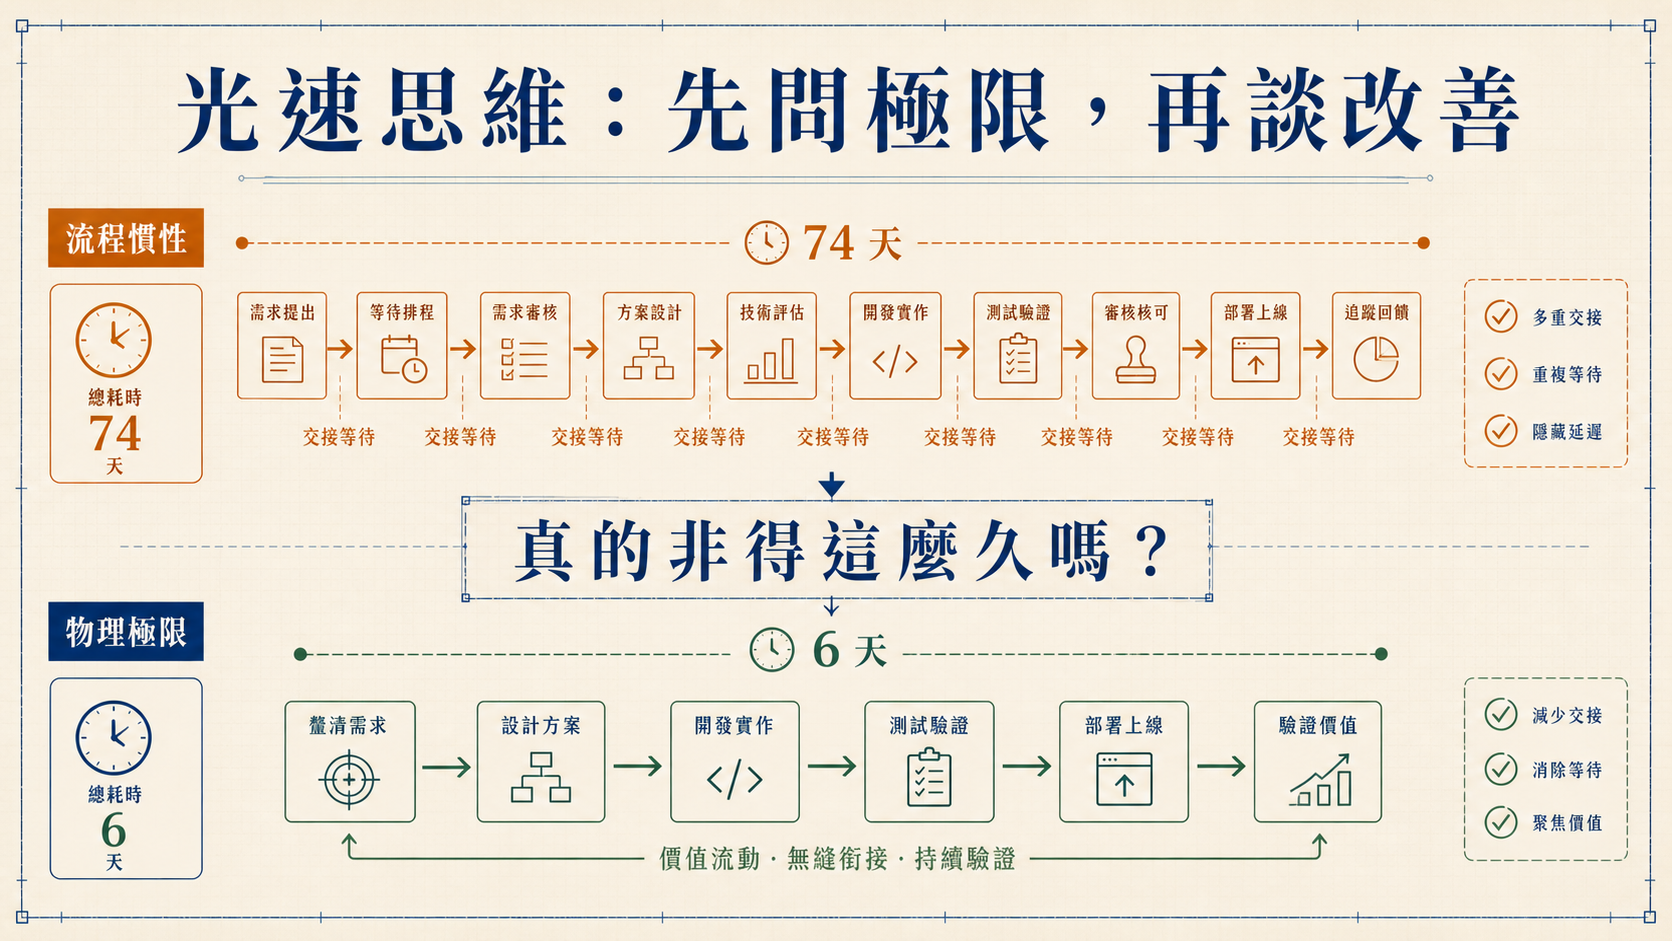
談到 xAI 在孟菲斯快速建成 Colossus 時,黃仁勳稱讚 Elon Musk 會持續追問:這件事真的必要嗎?它真的非得花這麼久嗎?他把這種方法連回 NVIDIA 長期使用的「光速」思維,也就是先問物理與第一性原理允許的極限,再判斷現有流程離極限多遠。
這和一般持續改善不同。如果某流程現在需要 74 天,傳統改善可能把它縮成 72 天;光速思維會先拆掉既有假設,問從零設計是否可能只要 6 天。之後再把安全、成本、品質與組織限制逐一加回去,理解 6 天如何變成 74 天。重點不是所有事情都要極端加速,而是讓每一段延遲都有可說明的理由。
這種方法適合高度工程化問題,因為輸入、限制與輸出相對可描述;套到人與制度時則需要更小心。法規、社區協商、勞動安全與風險審查,看似是延遲,有時卻是在替外部承擔成本。把所有阻力都當成應被移除的浪費,可能讓速度由最有權力的人獲利,而風險由其他人承擔。
黃仁勳處理壓力的方法也延續同一框架:先把龐大焦慮拆成可推理的問題,辨認誰能採取行動,然後交辦或親自處理。做完可做的部分後,必須學會遺忘與放下,把注意力移到下一分、下一個問題。這是一種把情緒轉成任務管理的領導技術。
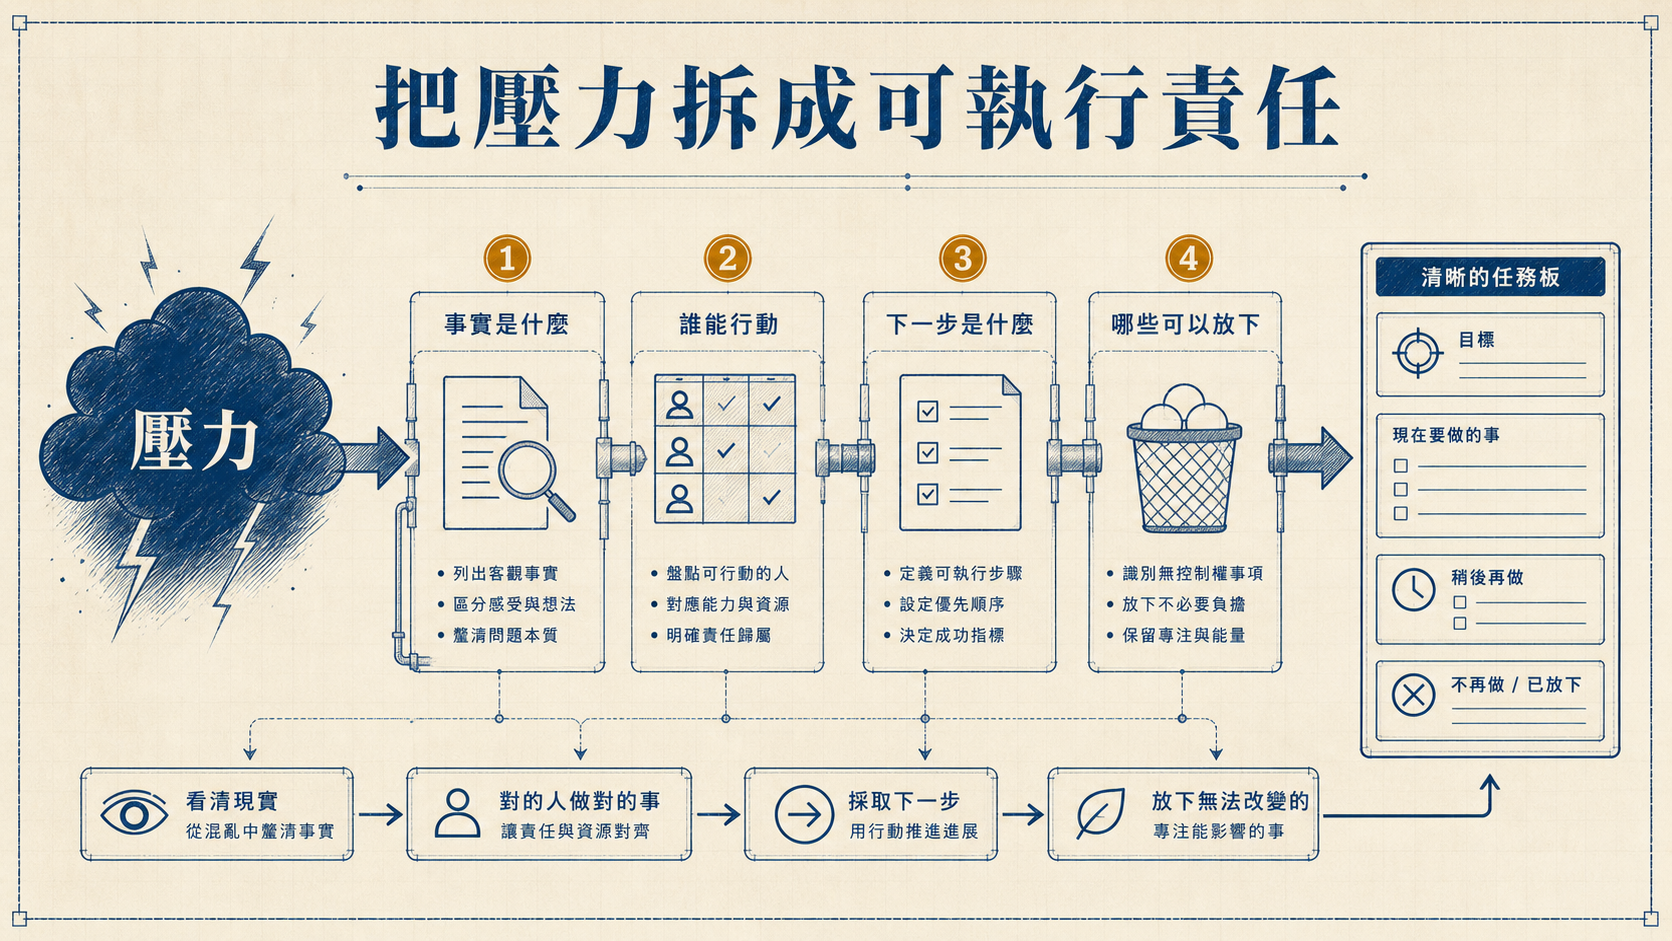
他也強調「在別人面前推理」。領導者不只宣布結論,而是展示自己如何從前提走到結論,讓其他人可以在某一步介入。這比要求成員直接挑戰最終方向更具體,也更可能找到分歧來源。當錯誤公開發生,領導者仍必須承認並繼續工作。
不過,將所有壓力轉為待辦清單也有邊界。有些痛苦不能靠分解立即解決,有些責任需要制度而不是個人意志。NVIDIA 的執行文化高度依賴黃仁勳本人,訪談最後談到接班時,他的答案仍是持續傳遞知識與推理方式。這能降低資訊集中,卻不必然解決權威、關係與最終決策權的傳承。
魚塘觀察
- 第一性原理可以打破流程慣性,但必須把安全、環境與弱勢者成本列入限制。
- 公開推理比公開結論更有助於團隊修正,但前提是反對不會受到懲罰。
- 能被個人拆解的壓力,不代表能取代制度化治理與接班設計。
1110. Coding 變成 Specification|工作會消失,還是被重新定義
黃仁勳對工作的核心區分,是 purpose、task 與 tool。放射科醫師的工作目的不是「看影像」,而是診斷疾病、協助病人與其他醫師。即使電腦視覺在部分影像判讀上達到很高能力,醫療需求、檢查量與服務範圍仍可能擴大,讓職業沒有按照早期預言消失。
他用同樣框架看軟體工程。工程師工作的目的不是生產最多程式碼,而是解決問題、設計系統、診斷失敗、評估結果、與團隊合作並找到下一個值得解的問題。寫語法只是其中一項 task;當 agent 可以完成更多實作,人的工作可能向問題定義、架構、驗收與取捨移動。
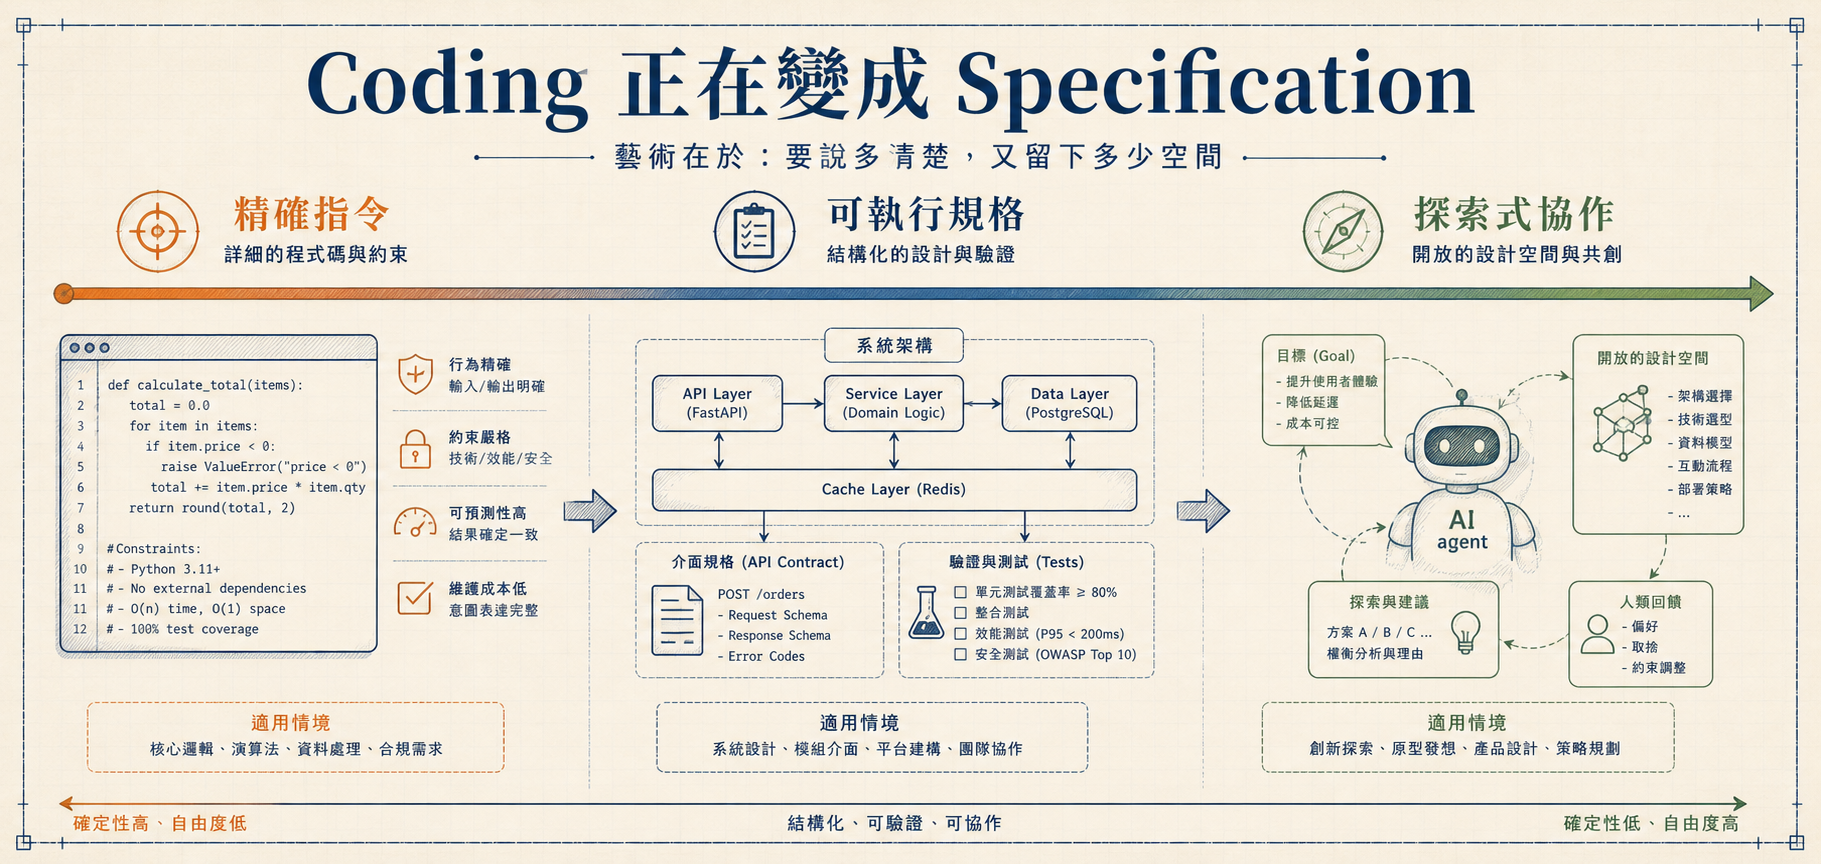
在這個意義下,coding 逐漸接近 specification。使用者要描述想建造什麼、限制是什麼、成功條件是什麼,以及允許 agent 自由探索多少。規格太鬆,系統可能漂移;規格太緊,人又可能把所有實作細節重新手寫一遍。未來的技術能力,不只是會不會語法,而是能否在不同任務中選擇合適的具體程度。
黃仁勳進一步推演,當自然語言也能成為程式接口,能「寫程式」的人數可能從數千萬擴大到更多職業。木匠可以把估價、設計與排程自動化,會計可以更快完成分析,農夫與藥師也能建立自己的工具。這不是每個人都變成傳統軟體工程師,而是更多人能把領域知識轉成可執行流程。
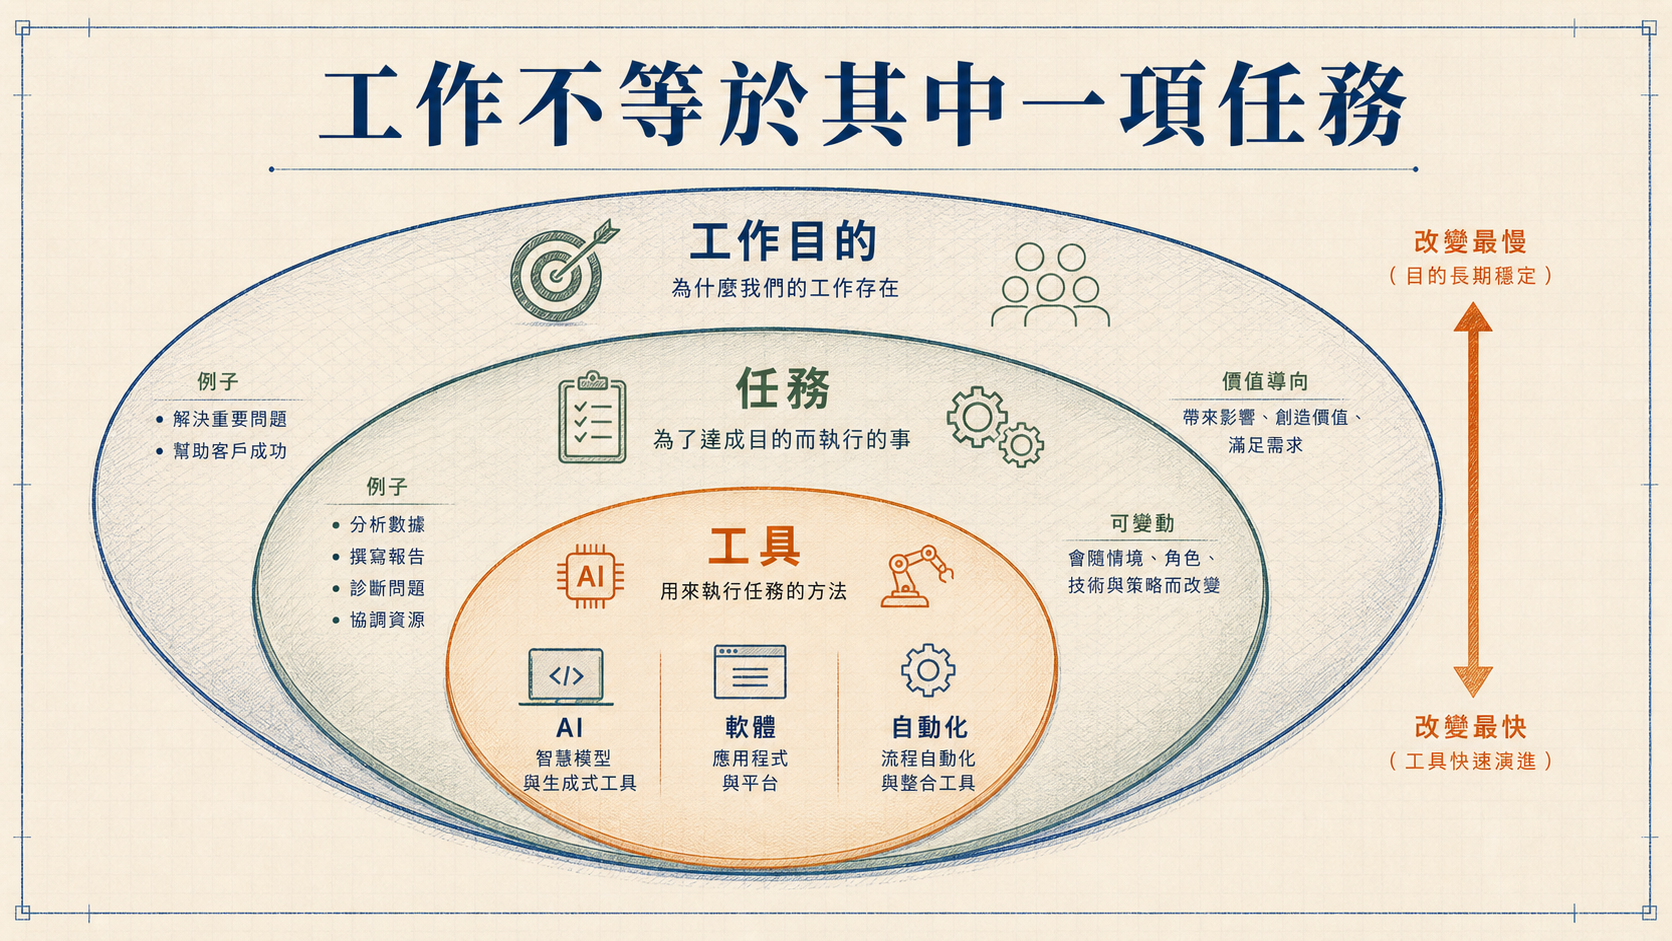
然而,目的與任務的區分不能消除失業風險。如果某個職位在現實組織裡就是由少數高度標準化任務組成,那些人確實可能被直接衝擊。即使整體產業長期創造新工作,轉換過程也會有地區、年齡、教育與收入差異。黃仁勳在訪談中承認這種痛苦,也表示自己沒有完整答案。
「大家都應該學 AI」是合理建議,但不是完整政策。個人訓練無法獨自解決企業重新分配收益、教育資源不均、職涯中斷與社會安全網問題。若 AI 把生產力收益集中在資本與少數平台,工具再容易使用,也不保證所有人都能向上移動。
魚塘觀察
- 評估職業風險時,要把工作拆成目的與任務,並觀察哪些任務可自動化、哪些責任仍需人承擔。
- specification、驗收、領域知識與系統思考會變得更重要,但基礎程式能力仍有助於理解失敗。
- AI literacy 是必要條件,不是就業轉型的充分條件;企業制度與公共政策仍然重要。
1211. AGI 之後仍然是人|智慧商品化,人性不能被壓縮
Lex 用一個特殊定義詢問 AGI:如果 AI 能創辦並經營一家市值超過十億美元的公司,還要多久?黃仁勳回答「現在」,並以一個 agent 做出爆紅服務、短期吸引大量付費使用者為例。這個回答很有傳播力,但它其實降低了題目的持續性要求:一次爆紅不等於長期經營,收入也不等於治理、責任與韌性。
他自己也補上限制:就算十萬個 agents 能做出短命的網路產品,也幾乎不代表它們能建立下一個 NVIDIA。AGI 是否已到來,仍取決於定義;若標準是跨領域完成部分經濟任務,今天的系統已非常接近;若標準是長期自主經營複雜組織、承擔法律與人際責任,證據仍不足。
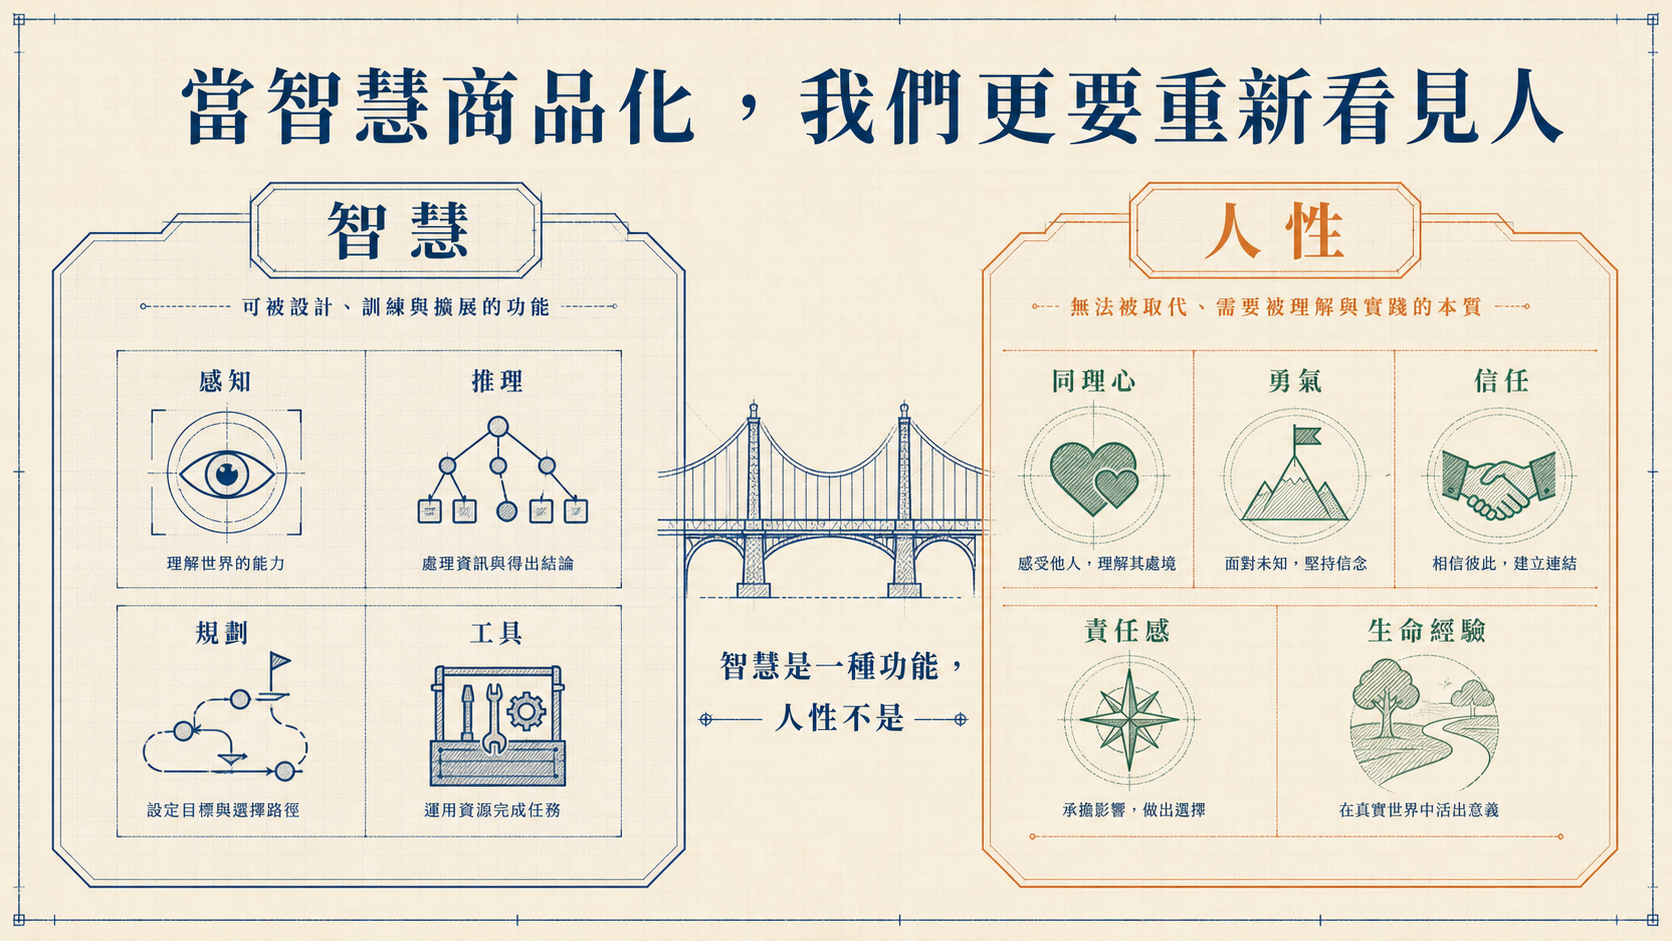
訪談最後最值得保留的,不是 AGI 日期,而是黃仁勳把 intelligence 與 humanity 分開。他將智慧描述成感知、理解、推理與規劃的功能迴圈;人性則包含主觀感受、愛、恐懼、痛苦、同情、慷慨、決心與品格。即使 AI 在功能性智慧上超越多數人,也不代表人的價值應按智力排名。
這個觀點對 AI 時代很重要。現代社會長期把教育、能力與收入綁在「誰更聰明」上;當智慧工具變得便宜,焦慮自然出現。但一個組織本來就不只需要最聰明的人,也需要能定義方向、承擔後果、建立信任、照顧他人與在不確定中作出判斷的人。
黃仁勳談死亡時,希望自己的知識、資訊與推理能持續傳給團隊,最終最好在工作中突然離世,而不是經歷漫長衰退。這段話既透露他對工作的投入,也暴露 NVIDIA 仍高度圍繞創辦人運作的現實。知識可以文件化、推理可以示範,但一位領導者的關係網路、象徵權威與歷史信用,不能完整上傳成模型。
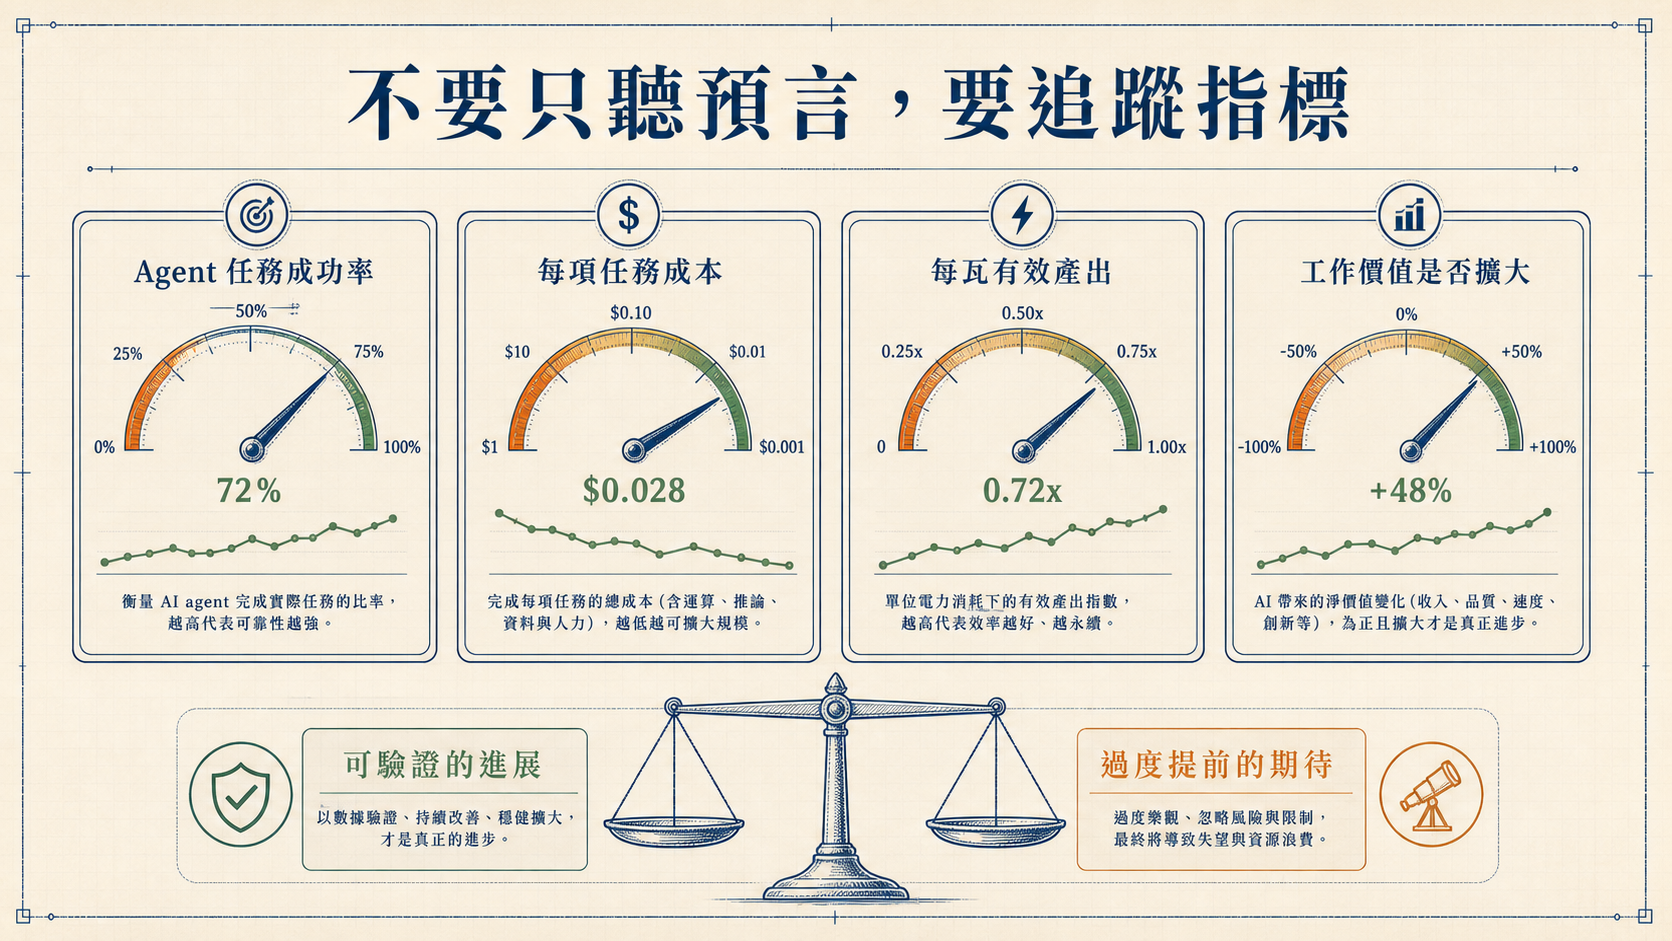
回頭看整場訪談,最強的不是任何單一預測,而是一種持續擴大問題邊界的能力。晶片不夠,就看機櫃;機櫃不夠,就看資料中心;資料中心不夠,就看供應鏈與電網;工具自動化之後,再問工作的目的;智慧商品化之後,再問人性。
這套方法值得學,結論則必須持續驗證。未來幾年,我們可以觀察四件事:agent 是否真的以可接受成本完成長任務;每瓦 token 的改善是否快過總需求;供應鏈是否能在高資本支出下維持合理利用率;AI 是否讓更多人擴大工作價值,而不是只讓少數平台擴大收入。
若這些指標成立,AI 工廠可能成為新的經濟基礎設施;若不成立,市場會重新定價那些過度提前的期待。但無論哪一種結果,這場訪談已經把一個事實講得很清楚:AI 的競爭不再只發生在模型或晶片裡,而是發生在完整系統如何被設計、協調、供電、信任與使用。
魚塘觀察
- 「AGI 已到來」在這裡是特定定義下的講者主張,不是學界共識。
- 智慧商品化可能降低能力門檻,但責任、品格與制度不會因此自動生成。
- 最值得帶走的不是十兆美元或五年預測,而是把龐大未來拆成可驗證假設的思考方式。