0. 這不是不用學工程了|門檻下降,責任上升
這支影片整理的是 Gary Chen 對 Andrej Karpathy 紅杉資本訪談的解析。表面上,它在講 Software 3.0、Jagged Intelligence、Vibe Coding 與 Agentic Engineering;但真正值得留下來的,其實是一個更務實的問題:當 AI 已經能寫出大量可執行的程式碼,工程師還要把時間花在哪裡?
原影片:AI 時代工程師怎麼重新定位自己:Andrej Karpathy 訪談解析
Karpathy 的答案不是「不用學了」。剛好相反。AI 讓寫出第一版變得便宜,但也讓錯誤被放大的速度變快。過去你慢慢寫,錯誤也慢慢累積;現在 agent 可以在短時間內替你產出一堆程式、測試、文件、設定與實驗結果。如果你沒有設計邊界、沒有驗證機制、沒有回滾策略,速度本身就會變成風險。
影片最值得注意的地方,是它沒有把 AI coding 浪漫化成「自然語言取代工程」。它反而一直回到工程的老問題:這個東西該不該存在?輸出怎麼驗證?錯了怎麼回滾?身份、支付、資金歸屬這類系統設計問題,模型能不能真正理解?這些問題不會因為 prompt 變漂亮就消失。
所以這篇導讀的核心判斷很簡單:Vibe Coding 拉高了所有人的下限,但 Agentic Engineering 才決定專業者的上限。前者讓更多人能做出小工具;後者要求工程師把模糊任務變成可驗證、可迭代、可收斂的環境。
1. Software 3.0 的真正問題|不是寫得更快,而是哪些東西不該再做
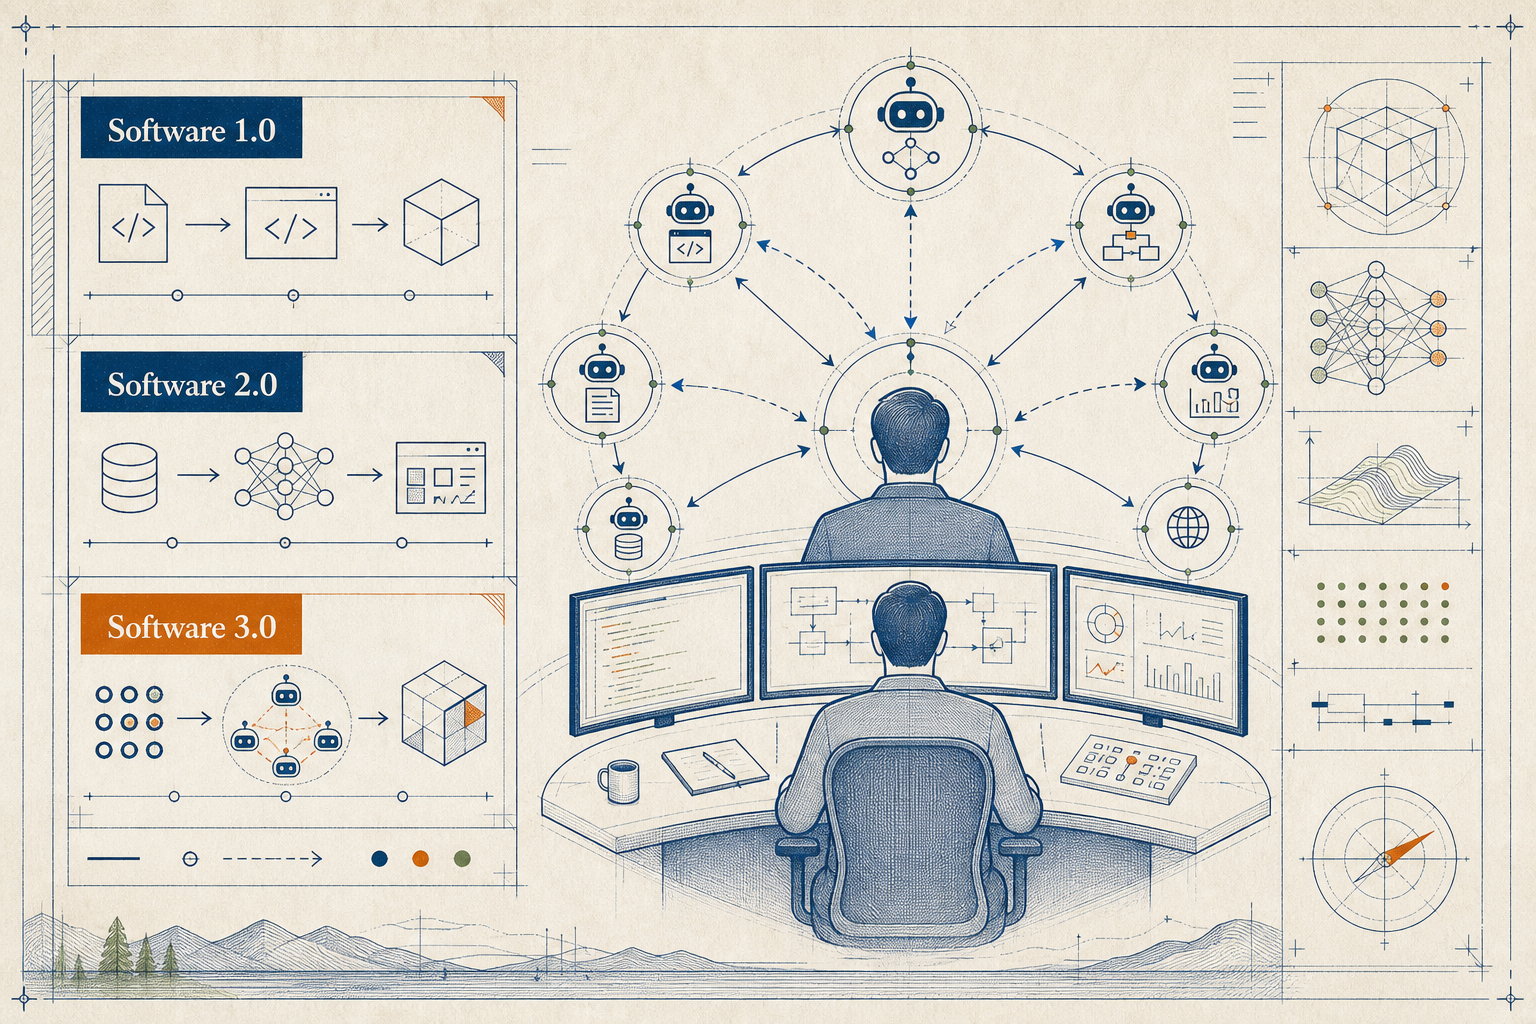
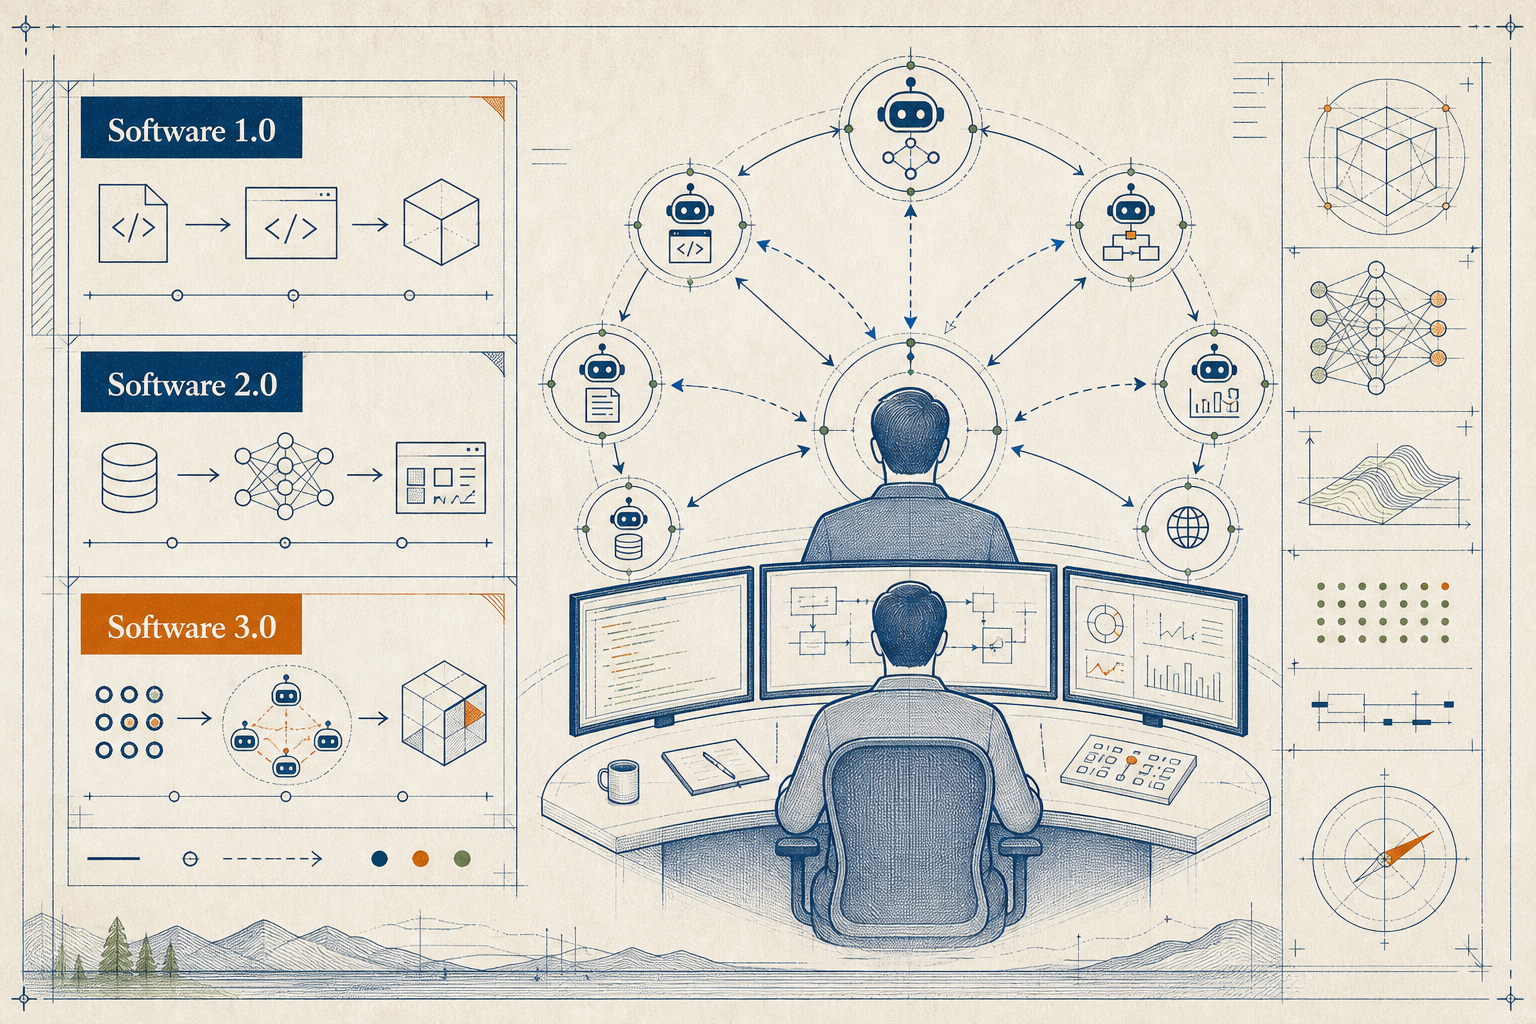
Karpathy 把軟體分成三個版本。Software 1.0 是傳統程式:人寫 code,電腦照規則執行。Software 2.0 是神經網路:人不再手寫所有規則,而是設計資料集、目標函數與訓練流程,讓模型學出行為。Software 3.0 則是 LLM 時代:你不只是寫 function,而是在寫 prompt、管理 context window、指揮 AI 助理。
影片引用 Karpathy 的話:「Your programming now turns to prompting」。這句話容易被誤解成「提示詞就是新的程式語言」。比較準確的理解是:軟體的控制面正在上移。你仍然需要工程理解,但日常工作裡越來越多時間不是在逐行輸入實作,而是在描述目標、整理上下文、切任務、檢查結果、修正方向。
MenuGen 的例子很好。Karpathy 做了一個菜單 app:使用者拍下菜單,app 辨識菜名、生成圖片,再重新排版給使用者看。用傳統產品思維看,這是一個合理的工具;但做完後他發現,在 Software 3.0 的範式裡,使用者其實可以直接把照片丟給 Gemini。原本需要 app 串接的流程,前沿模型已經能直接 cover。
這裡的重點不是「app 都不該做」,而是產品判斷的基準變了。如果使用者能把原始輸入丟給通用模型,三句話內拿到你 app 的核心輸出,那你的產品就很可能缺少存在理由。AI 不是只把舊流程變快,它也會讓一批原本合理的中介產品失去必要性。
對工程師和創業者來說,這是一個殘酷但有用的測試。以前 side project 的價值常常來自「我能不能把功能做出來」;現在要多問一步:「模型本身是不是已經能直接做掉這件事?」如果答案是肯定的,產品價值就不能只靠包一層 UI 或串幾個 API,而要來自工作流、信任、資料、分發、協作、驗證或特定場景裡的完整解法。
也因此,Software 3.0 不是叫人停止寫軟體,而是逼大家更早面對產品存在性。寫 code 變便宜後,真正昂貴的是判斷:什麼值得做,什麼只是模型能力還沒被使用者習慣之前的暫時縫隙。
2. 鋸齒狀能力與驗證|AI 強不強,取決於你能不能驗
Karpathy 用 Jagged Intelligence 描述 AI 的能力分佈:它不是一條平滑上升的曲線,而是有高峰、有斷崖。模型可以在數學與程式上強得驚人,也可能在某些常識題上犯很荒謬的錯。影片提到一個例子:你問模型要去五十公尺外的洗車場,該開車還是走路?模型可能回答「走路」,卻忘了要被洗的是車。
這種忽強忽弱不是隨機玄學。影片整理 Karpathy 的解釋:模型能力飆升,通常需要兩個條件。一是任務可驗證,能清楚知道答案對不對;二是實驗室真的把該領域放進訓練或後訓練分佈裡。數學可以對答案,code 可以跑測試,所以很適合丟進大量循環;常識題雖然也有對錯,但情境太碎、資料與評估不一定被認真覆蓋,能力就容易出現斷層。
這個觀點對使用 AI 很關鍵。你不該問「AI 能不能做這件事」,而要先問「我能不能驗證它做對了」。能驗證,AI 就可以多跑幾次、比較結果、用測試或指標篩選,最後把成功率往上堆。不能驗證,你就只是把責任交給一個有時很強、有時很弱的黑箱。
這也是為什麼程式碼生成看起來進展特別快。程式本身有編譯器、測試、型別、lint、runtime error、benchmark 和 production signal,這些都是可驗證的回饋。模型可以寫錯,但你能設計一個環境讓它反覆試錯。反過來,產品策略、品牌語氣、使用者信任、系統設計邊界,很多時候沒有單一正解,驗證就需要人類先定義標準。
所以,AI 時代的工程能力會從「能不能把規則寫清楚」逐步轉向「能不能把驗證設計清楚」。傳統自動化偏向處理你能 specify 的東西;LLM 自動化更擅長處理你能 verify 的東西。這個差異很小,但影響很大。
如果你把 AI 用在可驗證任務上,它是槓桿。如果你把 AI 用在不可驗證任務上,而且自己又沒有足夠理解去審稿,它就只是流暢地替你產生風險。
3. Agentic Engineering 的上限|把 agent 關進可試錯的小盒子
影片把 Vibe Coding 和 Agentic Engineering 分得很清楚。Vibe Coding 提高所有人的下限:不會寫程式的人也能用自然語言做出小工具,會寫程式的人可以更快做 side project。它讓軟體創造入口變寬,是很大的變化。
但 Agentic Engineering 代表上限。專業軟體該有的品質、安全、可維護性,不會因為用了 AI 就能降低。模型寫得快,不代表系統可以少設計;code 是 agent 寫的,也不代表沒有人要負責。Vibe Coding 是「我有個想法,AI 幫我做出來」;Agentic Engineering 是「我設計好邊界、驗證機制、回滾策略,讓很多 agent 在安全範圍內替我跑」。
Karpathy 的 Auto Research 例子是這個觀念的最好展示。他把自己的 LLM training code 丟給 agent,給它一個 metric,讓它自己改 code、跑訓練、看 metric;變好就留下,變差就回滾。兩天內 agent 跑了約 700 個實驗,找到 20 個有用改動,整體訓練時間縮短 11%,還抓到他自己漏掉的 bug。
這個 loop 強的地方,不是 agent 突然變成天才,而是約束設計得夠乾淨。影片整理成三個 constraint:one file、one metric、one time budget。只能改一個檔案,避免亂動系統;只有一個可比較指標,避免目標模糊;每次實驗有時間限制,避免浪費 compute。agent 被放進一個小盒子裡,不能亂跑,但可以瘋狂試錯。
這是很多 AI coding 討論漏掉的部分。大家常討論模型多聰明、prompt 怎麼寫,卻比較少討論「環境怎麼設計」。但真正能放大產能的,往往不是一次叫模型寫對,而是把任務切成可以失敗、可以評分、可以回滾、可以重跑的結構。agent 不需要永遠正確;它需要在被設計好的邊界裡大量嘗試,並且讓錯誤不會傷到系統。
這也是「十倍工程師」說法開始不夠用的原因。當一個人能指揮一群 agent 同時跑實驗,一晚上的探索量可能接近過去幾個月。影片還提到 SkyPilot 把類似 loop 跑到 16 顆 GPU 的 cluster 上,8 小時跑了 910 個實驗,總成本不到 300 美金;Shopify 的 Tobi Lütke 也用相同 pattern 在內部資料上跑出 19% 改善。這些數字都不是魔法,它們共同指向同一件事:可驗證環境會把 agent 的試錯能力轉成工程成果。
對一般團隊來說,這不一定代表每個人都要立刻跑上百個 agent。比較實際的起點,是每次交給 AI 任務前先寫三件事:要做到什麼、怎麼知道它做對、出包時回滾到哪裡。第二題答不出來,任務就還不夠適合交給 agent 自動跑。
4. 世界還不是 agent-first|所以工程師要補上介面與規格
Karpathy 也指出一個現實阻力:世界的基礎建設大多還是設計給人用,不是給 agent 用。寫 code 可能不是最痛苦的地方,部署、設定、串服務、配 DNS、進後台點來點去,反而常常卡住。很多工具仍然假設操作者是人,會看頁面、點按鈕、複製欄位、理解隱含流程。
這就是為什麼 MCP、API-first、agent-friendly interface 和 computer use 會變重要。當工具沒有為 agent 開好正式接口,AI 公司就讓 agent 像人一樣操作滑鼠鍵盤,先繞過人類介面的限制。這不是最終型態,但它說明了需求:如果未來是「我的 agent 跟你的 agent 談細節」,那現有軟體的操作面就需要重新設計。
工程師在這裡的角色,也會從單純實作轉成規格與介面設計。你不只是寫一段功能給人用,也要思考:這個功能能不能被 agent 安全呼叫?權限怎麼切?操作結果怎麼回報?錯誤狀態怎麼描述?有沒有 dry-run?有沒有 audit log?有沒有可以機器讀取的 contract?
如果說 Software 3.0 把人從 function 轉向 prompt,那 agent-first infrastructure 會把團隊從 UI 操作轉向可組合接口。這不是 UI 不重要,而是更多工作會被拆成 agent 可理解、可驗證、可追蹤的 action。誰能把混亂流程變成清楚 contract,誰就能讓 AI 更可靠地接手重複工作。
這也回到魚塘自己正在做的事情:丟一個影音連結,最後變成一篇有 frontmatter、逐字稿、配圖、schema gate、build gate 的文章。真正讓這件事可持續的,不是「AI 會寫文章」,而是每一步都有明確產物與驗收點:字幕、摘要、圖片、文章、schema、build。這些 gate 就是 agentic workflow 的骨架。
5. 理解不能外包|細節可以交給 agent,判斷力要留在自己手上
影片最後收束到一句話:「You can outsource your thinking, but you cannot outsource your understanding。」你可以外包思考,但不能外包理解。這句話把前面三個觀念串在一起。
Software 3.0 告訴你,世界的遊戲規則變了。你不是只在寫 function,而是在寫 prompt、管 context、指揮 AI;做出軟體的入口變寬,光是能做出來不再是門檻。
Jagged Intelligence 告訴你,AI 的能力不均勻。它能在某些可驗證領域強得驚人,也會在看似簡單的常識或系統邊界上犯錯。如果你不理解它強在哪、弱在哪,就會在錯的地方相信它。
Agentic Engineering 告訴你,真正的工程師不是只負責打字寫 code,而是能組織一群會犯錯但很強的 agent。要做到這件事,你得先理解任務、驗證、回滾、風險與責任。
Karpathy 舉的 email 與 user ID 例子很值得記住。他的菜單 app 用 Google 登入、Stripe 購買 credits。agent 提出用 email 把兩邊配對:Google email 和 Stripe email 一樣就是同一人,不一樣就是不同帳號。這個邏輯可能跑得動,測試也可能通過,但系統設計是錯的。因為一個人可以用不同 email 登入與付款;如果資金歸屬綁在 email,而不是 persistent user ID,購買紀錄就可能對不上,資金也可能跑到錯誤帳戶。
這類錯誤最危險,因為它不是語法錯,不一定會在單元測試裡爆炸。它發生在系統模型本身。agent 沒有真正理解身份、支付與資金歸屬的風險,只是給出一個看似合理的映射。這就是為什麼「理解不能外包」不是漂亮口號,而是工程安全邊界。
API 細節可以交給 agent。PyTorch 或 pandas 的函式名稱、boilerplate、串接樣板,模型記得比人好。但 tensor 是什麼、view 和 storage 的關係、什麼時候只是換視角、什麼時候會 copy memory,這些概念不能丟掉。付款 API 可以讓 agent 查文件,身份與資金歸屬模型不能讓它隨便猜。
所以 AI 時代的時間分配應該變。你不需要把所有時間花在背 API,也不需要堅持每一行都自己敲;但你要把更多時間花在判斷這件事值不值得做、spec 是否清楚、trace 是否合理、agent 是否在 system level 犯錯。你用 AI 不是要變成更會打字的人,而是要變成更會做頂層決策的人。
最後的結論可以很短:不要把 AI 當成讓你少想一點的工具,要把它當成讓你想得更深的槓桿。Vibe Coding 給了大家更高的下限;真正的差距,會出現在誰還願意理解底層、設計驗證、承擔判斷。