010. 不是神奇咒語|而是把頻寬打開
好結果有時不是來自更精準的 prompt,而是來自更完整的脈絡。
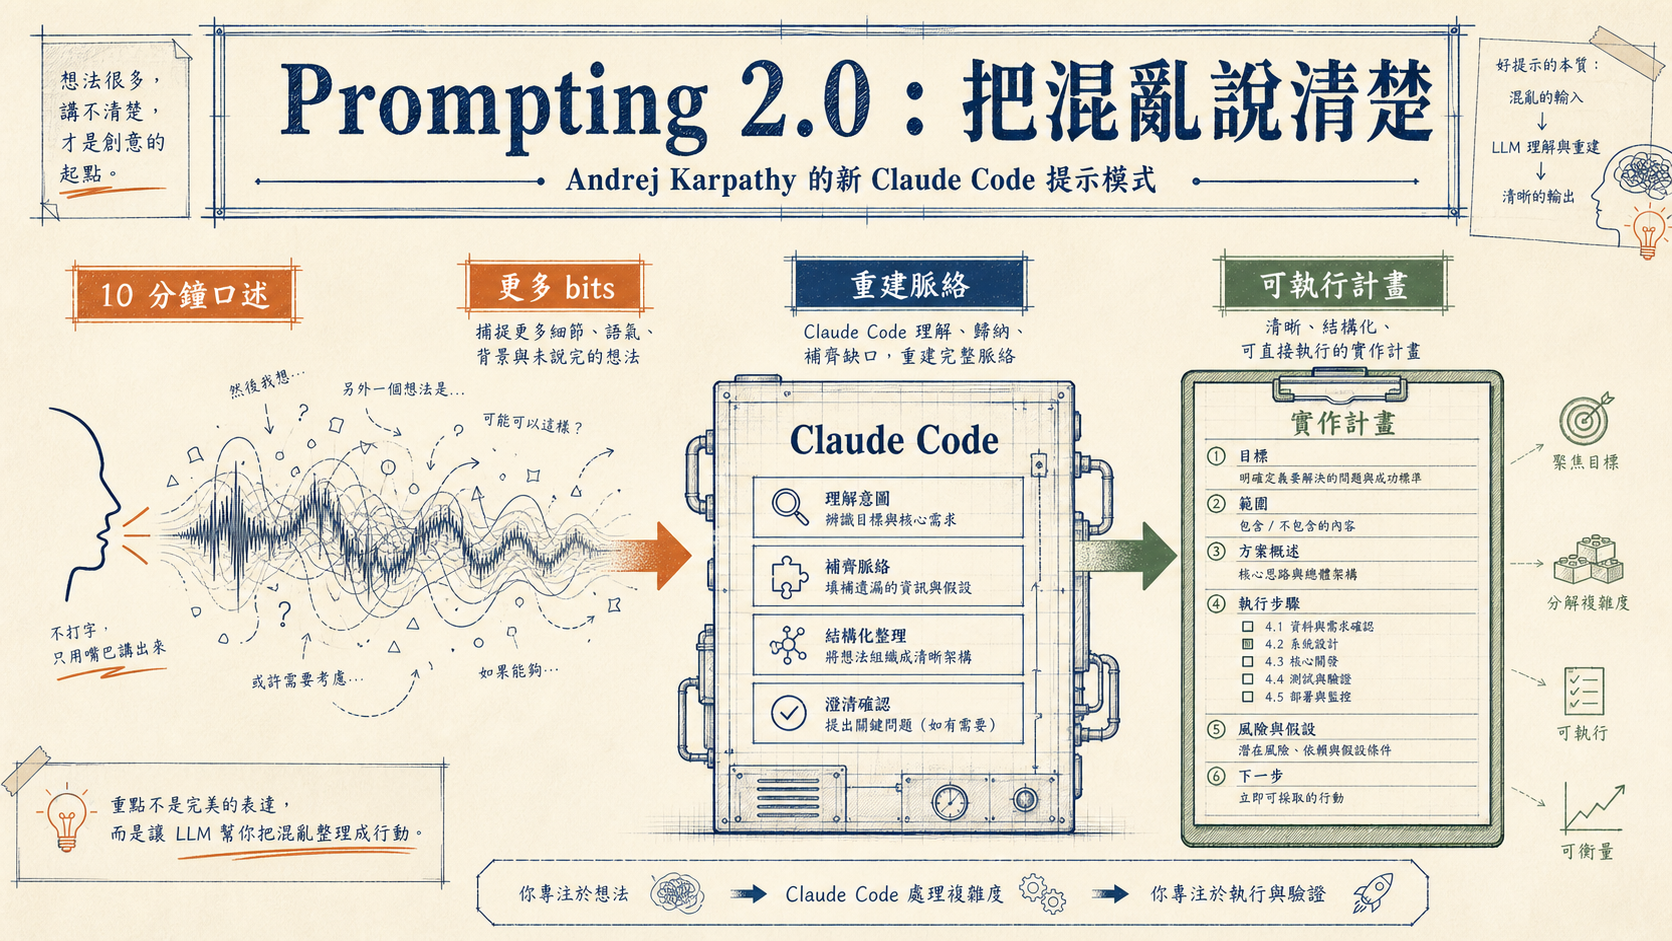
這支原始影片討論的是 Andrej Karpathy 最近分享的一種 Claude Code 提示習慣:在開新 session 或新專案時,不急著把需求壓縮成一段漂亮指令,而是切到語音模式,靠回椅背,連續講一段接近 10 分鐘的 stream of consciousness。
這個做法聽起來幾乎違反過去的 prompt engineering 教條。以前我們常被提醒:prompt 要清楚、要短、要有格式、要列條件、要降低模型自由發揮。但 Karpathy 的觀察是,現在的 LLM 已經足夠擅長從不完整、混亂、口語化的材料裡重建脈絡;有些時候,你該做的不是把想法先整理成完美需求書,而是把更多 bits 交給模型。
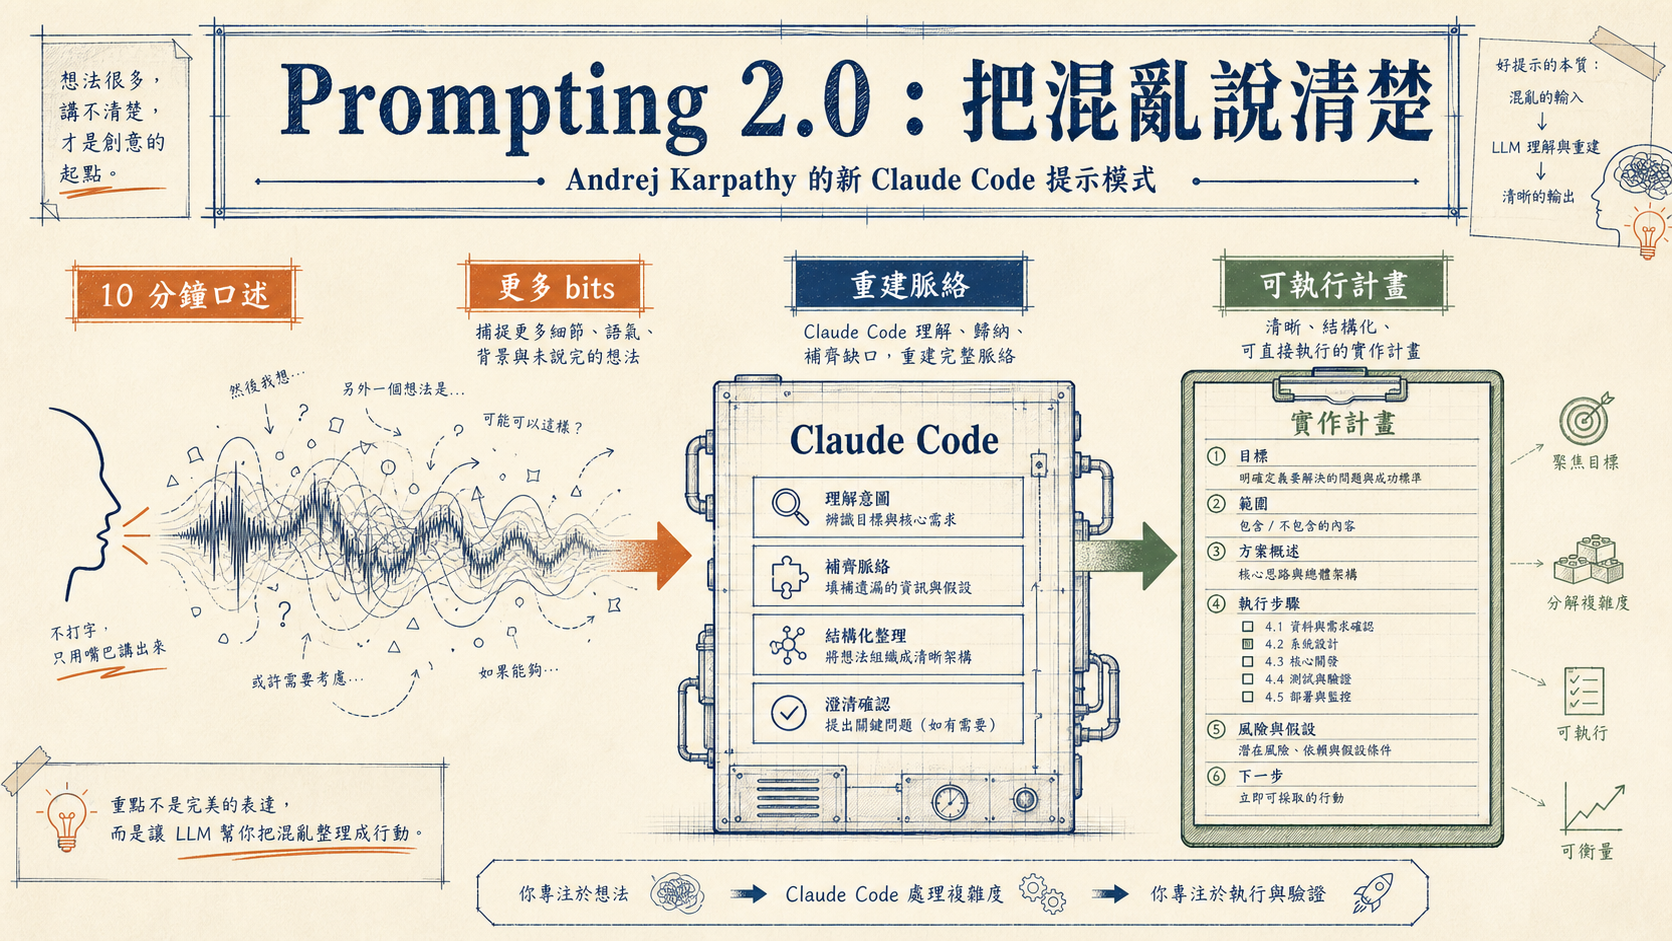
影片講者 Dream Labs AI 把這招稱為 prompting 2.0,並拿自己的 Claude Code 專案做對照測試。他要做的東西不是玩具範例,而是一個成長分析 dashboard:比較自己的 Dream Labs AI 頻道與 Nick Sareb 頻道在早期的訂閱、觀看、發片節奏、社群與付費產品成長。
同一個需求,他開了兩個 Claude Code session。一個用平常的一分鐘短 prompt;另一個用 Karpathy 風格的 10 分鐘口述,把背景、焦慮、期待、資料來源、比較對象、設計偏好、甚至後面有點不知道要講什麼的碎念,全都說進去。最後講者的結論是:短 prompt 版可以用,但偏硬、偏技術、還要更多修;長口述版更接近他真正想要的 dashboard。
這裡最值得留下來的不是「請所有人都講滿 10 分鐘」。真正的重點是:當任務本身還帶有模糊性,模型缺的往往不是格式,而是背景密度。
給讀者的 Takeaway
- Prompting 2.0 不是更會寫 prompt,而是更願意提供上下文。
- 它特別適合新專案、新 session、探索型需求。
- 對 coding agent 來說,早期脈絡不足會變成後期反覆修正。
021. Karpathy 的長口述|讓模型重建你的意圖
「混亂」本身不是問題;沒有足夠材料,才是問題。
影片引用 Karpathy 貼文中的核心說法:有時候 Claude 這類 LLM 需要更多 bits,才能理解你到底想達成什麼;但人懶得打字,所以他會切到 voice mode,宣告自己正在用語音辨識,可能有錯字,然後直接講一大段。
Karpathy 的描述很刻意地放鬆:total mess、anything goes、literally no rules、full stream of consciousness。這不是要模型欣賞你的口才,而是承認人的需求在前期常常還沒成形。你以為自己只是在碎念,其實裡面混著需求優先序、隱含限制、對結果的審美、過去踩過的雷,以及你自己還沒明確說出口的判準。
LLM 擅長的地方,正是把這些不連貫訊號整理成結構。Karpathy 說,他常看到自己糾結的想法被模型回聲回來後,變得比原本更清楚。這句話對開發工作很重要,因為 coding agent 的失敗常不是「不會寫程式」,而是「太早開始寫程式」。
一分鐘 prompt 通常只會給任務表層:做一個 dashboard、支援兩個資料源、不要讀本機其他資料、請輸出漂亮 UI。十分鐘口述會多出很多「不是規格但會影響結果」的東西:為什麼做這個、想比較什麼、哪種圖看不懂、哪些資料可能有洞、哪些設計讓人覺得像舊 AI、最後想拿它做什麼決策。
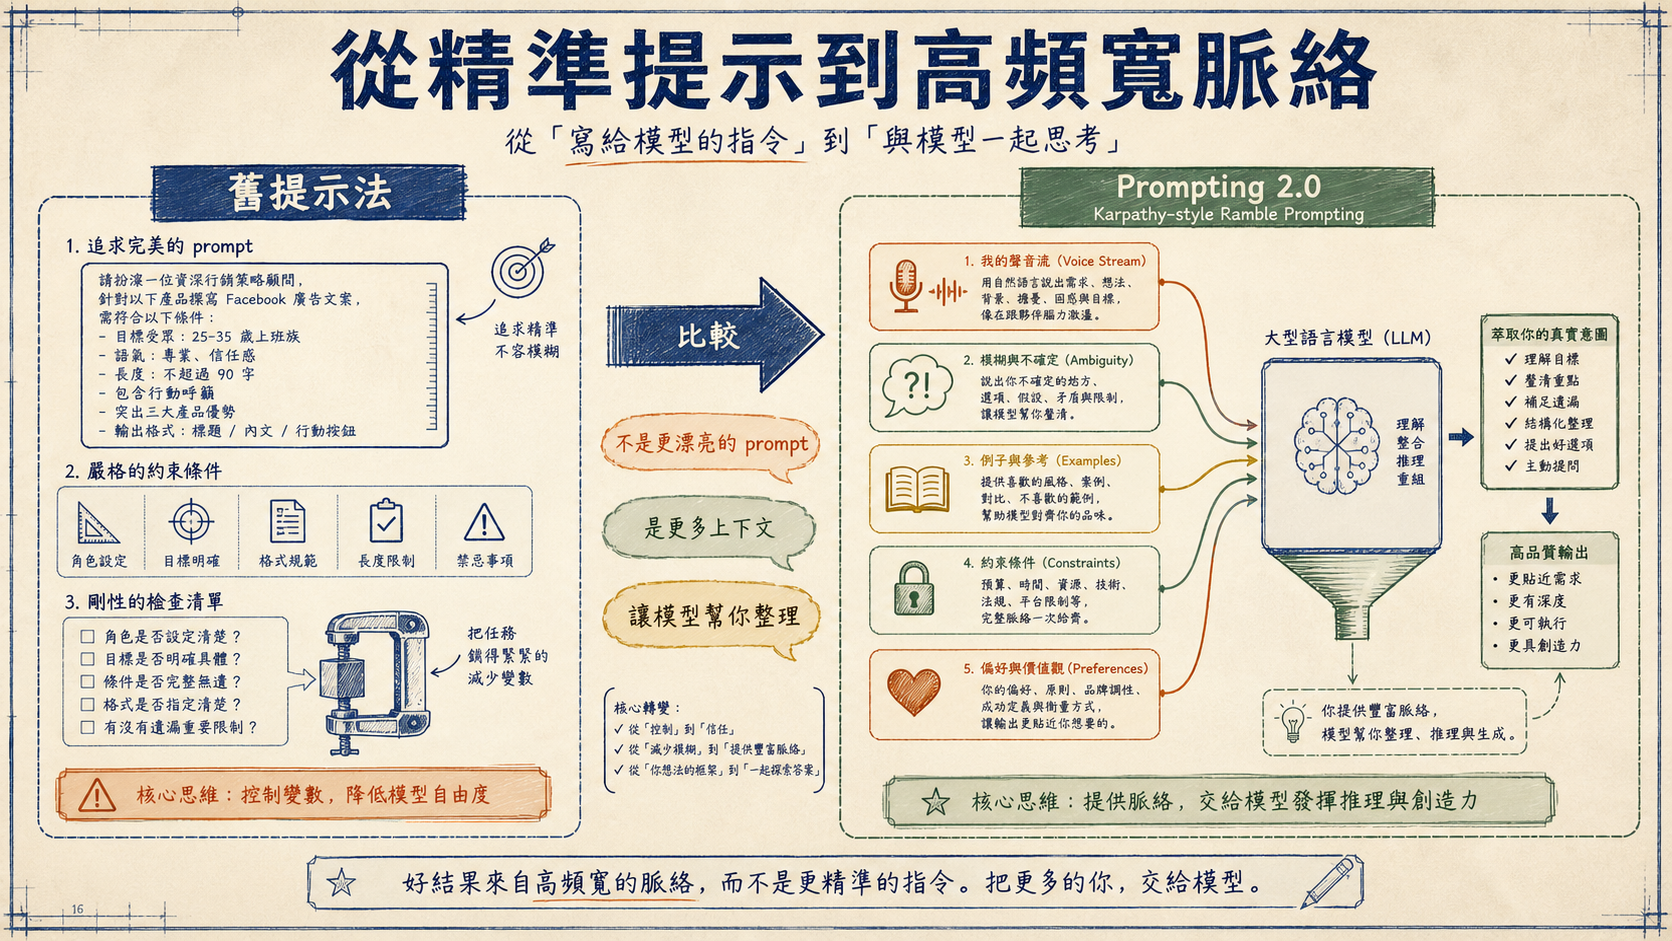
這也解釋了為什麼長口述不一定適合每次互動。若任務是改一個按鈕顏色、修一個明確 TypeScript error、查一個已知 API,用 10 分鐘 prompt 只會浪費時間。但如果任務是「幫我設計一套 agent team runner」、「把這個 repo 接進 SDD 流程」、「建立一個長期可用的 dashboard」,前期的模糊性本來就高。這時候,多給上下文比把第一句 prompt 修得像法律條文更有價值。
給讀者的 Takeaway
- 長口述把背景、偏好、限制和模糊直覺一起交給模型。
- 模型的任務不是照抄口述,而是重建意圖。
- 越是開場、規劃、探索型任務,越值得提高輸入頻寬。
032. 四個動作|宣告、語音、放鬆、講夠久
這個技巧的難點不是工具,而是不要太早自我審查。
影片把 Karpathy 的方法整理成四個動作。第一,先宣告輸入模式。你可以告訴 Claude:「我接下來會用語音辨識講一段 stream of consciousness,裡面可能有錯字、重複、跳躍,請你先理解意圖,不要急著逐字照單全收。」這句話很小,但它替模型設定了解讀角度。
第二,切到 voice mode。影片提到可以用 Claude 介面裡的麥克風,也可以用 WhisperFlow 或其他語音轉文字工具。重點不是哪個工具,而是讓輸入速度接近思考速度。人打字時會自然刪減,語音則比較容易把尚未整理的聯想留住。
第三,lean back。這不是玄學,而是降低輸入時的編輯壓力。很多需求在心裡其實很清楚,但一坐正要「寫 prompt」,人就會開始過度整理,最後只留下很貧瘠的任務描述。放鬆一點講,反而能把真正的判準說出來。
第四,講夠久。講者特別提醒,很多人以為自己已經在用語音提示,其實只講兩三分鐘。Karpathy 指的不是短語音,而是一段長到你會開始重複、補充、跑題、再拉回來的口述。這些看似低品質的片段,可能正是模型需要的脈絡。
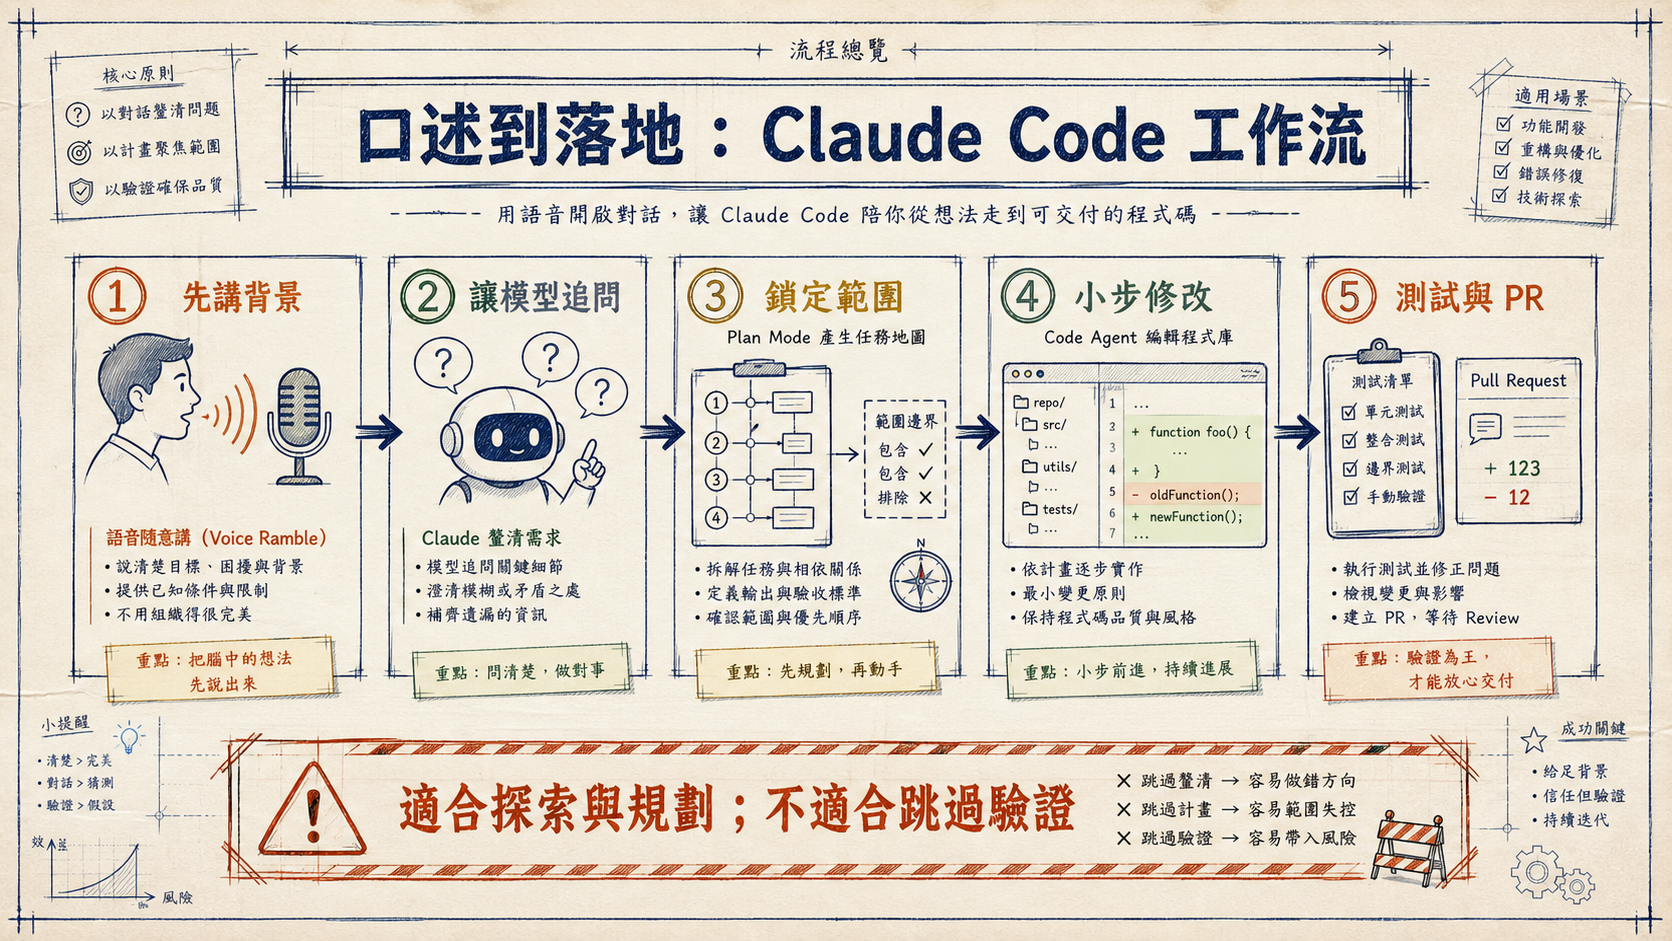
套到 Claude Code 工作流時,我會把這四步稍微工程化:
第一段先講背景:這個 repo 是什麼、現在卡在哪、誰會用、為什麼重要。第二段講目標:完成後應該看起來如何、哪些算成功、哪些只是 nice-to-have。第三段講限制:不要碰哪些檔、不要破壞哪些 API、測試和部署怎麼跑。第四段講偏好:你喜歡的 UI 風格、命名習慣、架構傾向、過去踩雷。最後要求模型回問問題,或先整理成 plan,等確認後再開始改。
這樣做的價值是把「人腦中的上下文」先外部化。Claude Code 不必猜你的偏好,也不必在做錯後靠一輪輪修正慢慢逼近。
給讀者的 Takeaway
- 開頭宣告「這是混亂口述」,能幫模型正確解讀輸入。
- 語音工具的價值在於提高輸入頻寬。
- 長口述後應先讓模型整理與追問,再進入實作。
043. 影片測試|一分鐘 prompt 可以用,十分鐘 prompt 比較接近需求
對照測試的亮點不是分數,而是兩個結果差在哪裡。
講者的實驗任務是建立一個 Dream Labs AI vs Nick Sareb 的成長 dashboard。Nick 的頻道接近 50 萬訂閱、323 支影片,講者則想看自己這個約 100 多天的新頻道,是否走在合理軌道上。他希望 Claude Code 抓 YouTube、Social Blade、School community、Wayback Machine、影片 transcripts 等資料,整理出早期成長曲線、發片節奏、訂閱速度、觀看數、社群與付費產品線索。
短 prompt 版產出的 dashboard 有抓到一些重點。影片中提到,在 day 117 的比較裡,講者的訂閱節奏接近 Nick 當時的 96%;但 Nick 已經發了 56 支影片,講者只有 21 支,約 38% 的產出量;累積觀看也有差距,大約是 60 萬對 150 萬。這些資料有用,甚至給出了「提高發片節奏」「不要有停更週」「參考標題公式」等建議。
但講者對短 prompt 版的感受是:設計偏深色、偏舊式 AI dashboard,資訊有點難讀,局部標示過度技術化。他給了大約 7/10。這不是失敗,反而是很典型的一分鐘 prompt 結果:模型完成了字面任務,但沒有完全理解使用者想要的感受、決策場景和資訊優先順序。
長口述版則產出一個更輕、更互動、更接近講者需求的 dashboard。它不只是排出數字,而是把 Nick 的 transcript、早期 milestone、社群策略、課程節點和 growth lesson 整合進 evidence file。講者認為這版更容易被修成理想產品,後續需要的 reshape 比較少。
這裡要保持一點編輯距離。影片展示的是講者自己的測試,不是嚴格控制的 benchmark;Claude 工作時間、資料可得性、session 狀態、模型版本都可能影響結果。長 prompt 的優勢也不表示「越長越好」。真正合理的結論是:當任務成功高度依賴隱含脈絡,短 prompt 容易讓模型只滿足表層需求;長口述則更可能讓模型看見需求背後的決策情境。
給讀者的 Takeaway
- 短 prompt 版完成任務,但更像「照規格做」。
- 長口述版更容易抓到使用者真正想比較與決策的東西。
- 這是案例觀察,不是嚴格 benchmark;應把它當工作法參考。
054. 對 agent team 的啟發|OpenClaw 應該收長脈絡,Runner 負責執行
團隊代理人的入口,不應該只是一行 issue title。
這支影片剛好呼應我們前面討論的 OpenClaw、agent team、GitHub repo、Harness、SDD 和第二大腦。若你要把 OpenClaw 當混水摸魚團隊的助手,只靠「幫我改這個 repo」這種短命令,很容易讓開發 agent team 從錯的方向開始跑。Karpathy 的 ramble prompting 提醒我們:總控 agent 最有價值的地方,是把需求前期的混亂吸進來,轉成可執行任務。
合理架構會是:OpenClaw 接收 LINE 裡的自然語言與長口述,先整理成任務摘要、背景、限制、成功條件與風險。接著查第二大腦,例如 XTrace 或 repo 內 SDD,補上專案記憶和過去決策。最後才把清楚的 job payload 送給 agent team runner,讓 runner 在隔離環境裡 clone repo、讀 AGENTS.md、跑專案 Harness、修改程式、測試、開 PR。
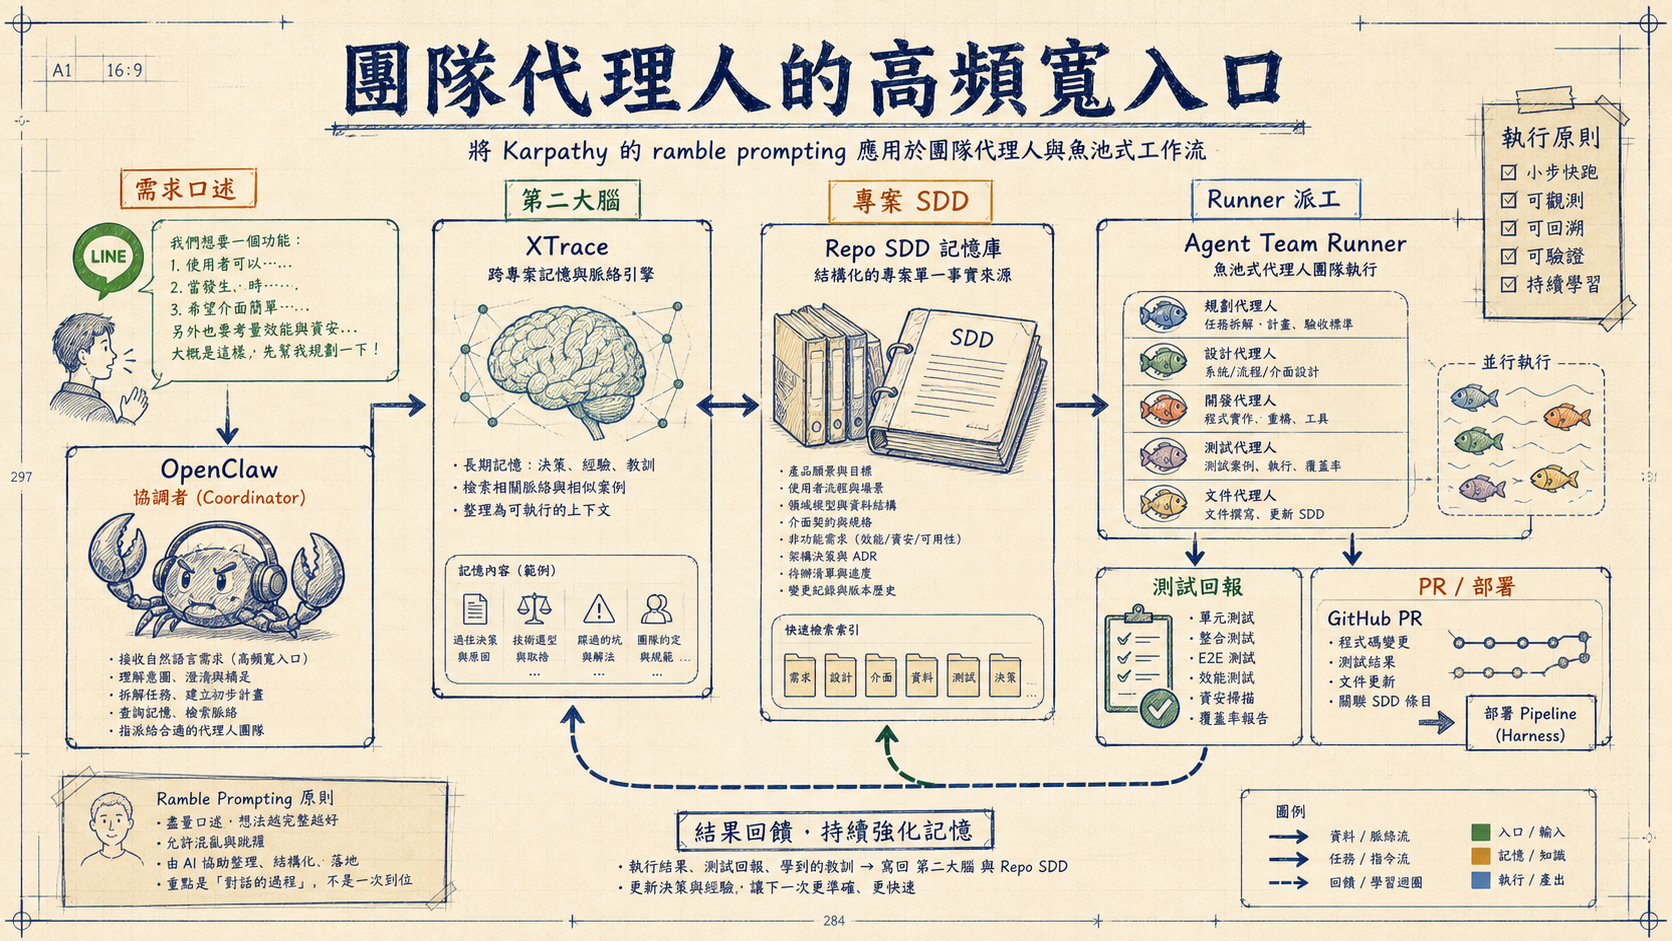
這樣切分有兩個好處。第一,OpenClaw 不需要直接控制每個開發 harness 的內部細節;它像 PM/dispatcher,負責把人類語意轉成工作單。第二,runner 不需要猜需求;它拿到的是已經整理過的 spec,加上 repo 自己的 SDD 和測試入口。
如果要把 prompting 2.0 做進這套系統,我會設計一個「高頻寬 intake」流程:
收到一段長需求後,OpenClaw 先不派工,而是輸出五塊內容:任務目標、背景脈絡、限制與不可碰範圍、驗收條件、未知問題。若未知問題太關鍵,先回問;若可合理假設,就把假設寫進 job。runner 完成後,再把 PR、測試結果、踩坑和決策摘要寫回第二大腦,讓下一次任務不用重新建立脈絡。
這比單純追求「更強 agent」更實際。多 agent 系統最常壞在交接:人把模糊需求丟給總控,總控又把更短的摘要丟給 runner,runner 再把任務拆給 code agent。每一層都丟失脈絡,最後當然要靠很多輪修正救回來。Prompting 2.0 的價值,就是在第一層把脈絡留住。
給讀者的 Takeaway
- OpenClaw 適合做高頻寬 intake 與任務整理。
- Runner 適合做隔離執行、測試、PR 與回報。
- 第二大腦應保存任務結果與決策,讓下一次少講一點。
065. 什麼時候不要用|長口述不能取代驗證
說得越多,不代表做得越對。
Prompting 2.0 很容易被誤用成「我講很多,所以模型應該懂」。但工程上,長口述只是讓模型更了解你,不是讓它免於犯錯。尤其是 Claude Code 這類能改 repo、跑 command、開 PR 的 agent,輸入變長後,錯誤方向也可能變得更有說服力。
因此,長口述後應該加一道 plan gate。讓模型先整理它聽到的內容:目標是什麼、範圍是什麼、它準備怎麼做、哪些檔案可能被碰、測試怎麼跑、哪些地方需要你確認。只有當 plan 對了,才進實作。這就是為什麼我會把 voice ramble 和 SDD / Harness 放在一起看,而不是把它當單純的 prompt 技巧。
對魚塘文章也是同樣道理。影音來源常有講者立場、業配語氣或個人測試限制。本文裡提到的數字,例如 Karpathy 貼文 4M+ views、Nick 56 支影片對講者 21 支、短 prompt 版 7/10,都是影片講者展示或陳述的內容;它們適合用來理解案例,不適合被寫成普遍定律。
真正穩的流程,是把長口述當成規格素材,而不是最後規格。它應該被整理、回問、寫進 SDD、變成 runner job、跑測試、接受 review。人類不需要把第一句話說得完美,但系統要負責把混亂輸入變成可驗證的工程行動。
給讀者的 Takeaway
- 長口述提高脈絡密度,但不提高事實正確率。
- coding agent 應先 plan,再改 code。
- 所有口述需求最後都應落到 SDD、測試和 PR review。
076. 結論|未來的提示法,是讓模型參與整理需求
Prompting 2.0 的核心,不是「更會命令 AI」,而是「更會把還沒成形的想法交給 AI 整理」。
Karpathy 這個方法之所以值得注意,是因為它反映了模型能力的轉折。早期模型脆弱,人必須把 prompt 修得很乾淨,降低誤解空間。現在的模型更能處理雜訊、補全脈絡、重建意圖,於是 prompt 的瓶頸從「格式是否完美」轉向「材料是否足夠」。
對個人使用者,這代表你可以少花一點力氣裝成產品經理,多把真實想法說出來。對開發團隊,這代表需求 intake 可以更自然,但後段必須更工程化:有第二大腦、有 SDD、有 runner、有測試、有 PR、有回寫記憶。
換句話說,未來的 agent 工作流不該要求人類一開始就給完美指令。它應該允許人類先混亂地說,然後由系統把混亂整理成計畫,再由工具把計畫變成可驗證的變更。
這才是 prompting 2.0 對混水摸魚團隊真正有用的地方:不是學會一種新的 prompt 花招,而是把 OpenClaw、第二大腦、專案 SDD 和 agent team runner 接成一條能吃長脈絡、能落地、能回饋記憶的工作流。
給讀者的 Takeaway
- Prompt 的未來不是更短,而是更會承載上下文。
- AI agent team 的入口應該接受模糊需求,但輸出必須可驗證。
- 最好的長口述,最後會變成更清楚的 plan、PR 和團隊記憶。