0. 先把神祕感拿掉|LLM 不是魔法,是一個被訓練到極致的預測器
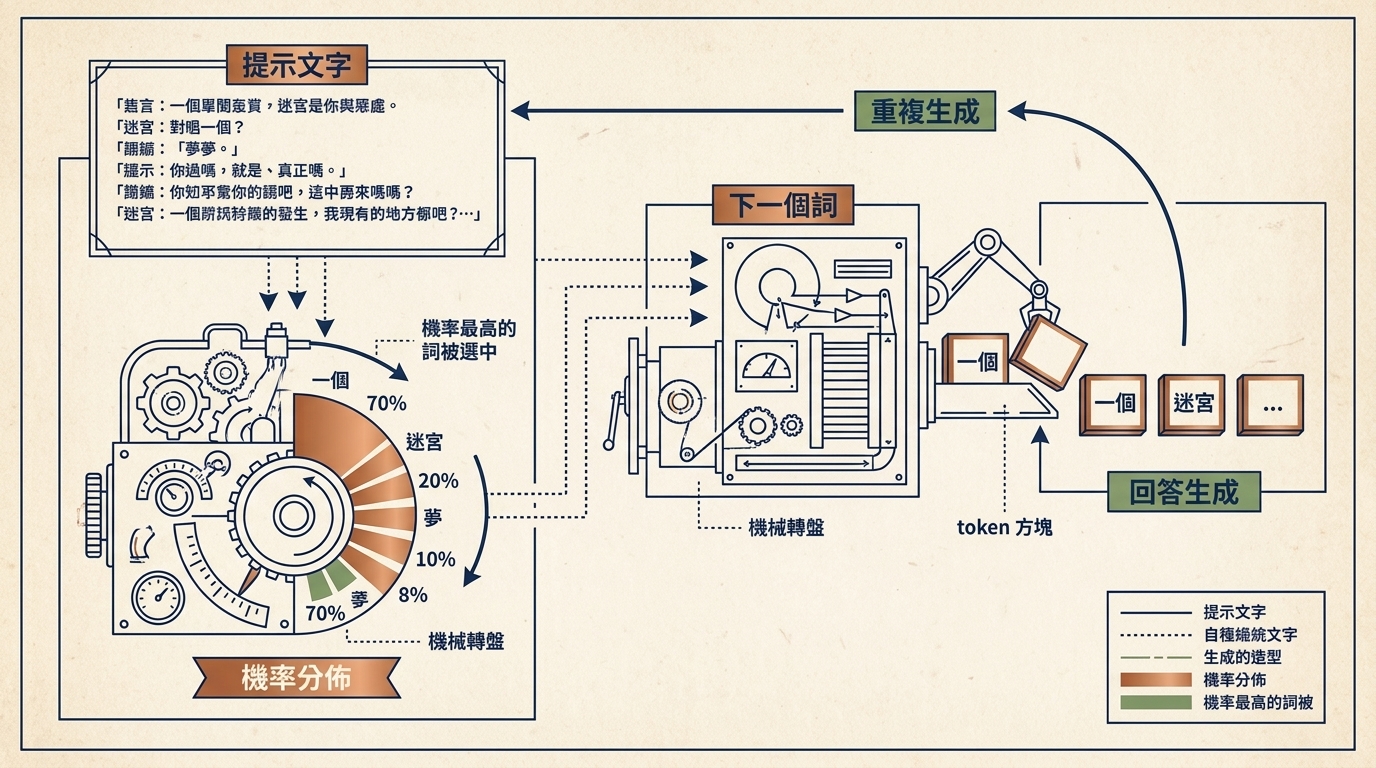
3Blue1Brown 這支短片很適合當大型語言模型的第一層心智模型。它沒有急著把 attention、embedding、反向傳播全部攤開成公式,而是先用一個很好的比喻:你拿到一段電影劇本,劇本裡有人問 AI 一個問題,但 AI 的回答被撕掉了。如果你手上有一臺機器,可以根據目前文本預測「下一個詞」最可能是什麼,那你就可以讓它先補第一個詞,再把這個詞接回劇本裡,繼續預測下一個詞。重複很多次,回答就長出來了。
原影片:Large Language Models explained briefly
這就是聊天機器人的核心骨架。大型語言模型不是先在腦中形成一個完整答案,再把答案吐出來;它比較像是在一段越來越長的文本後面,一步一步預測下一個 token。這件事聽起來很簡單,但規模放大後就會變得很不直覺:當模型在海量文本上學會預測下一個詞,它也會順便學到語法、語意、風格、常識、推理模式與許多世界知識的統計結構。
這篇導讀的重點不是把短片逐句翻譯,而是把它整理成工程上能用的理解:LLM 的能力從哪裡來?為什麼同一個 prompt 每次可能不同?為什麼預訓練和「成為好助手」是兩件事?Transformer 和 attention 到底在直覺上做了什麼?
1. LLM 是下一個詞的機率機器|它輸出的不是答案,而是分佈
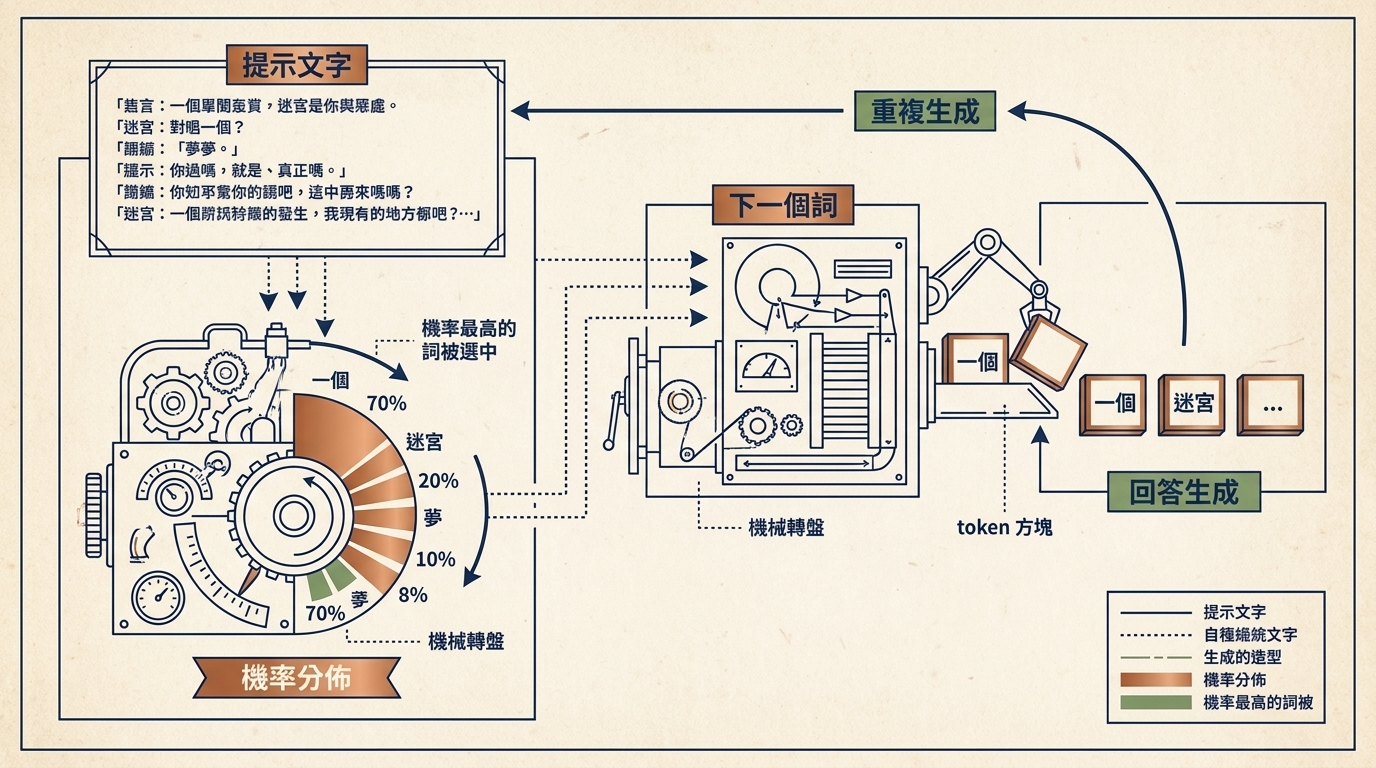
影片一開始就把 LLM 定義得很乾淨:大型語言模型是一個複雜的數學函式,給它一段文本,它會預測下一個詞。更精確一點說,它不是只選出一個詞,而是替所有可能的下一個詞分配機率。
這個差異很重要。模型不是在做「唯一正解」查詢,而是在做機率分佈。當你問它一個問題,系統會把你的輸入包裝成一段使用者與假想 AI 助手的對話,然後讓模型預測「這個助手接下來最可能說什麼」。第一個 token 出來後,它會被加回上下文;接著模型再預測下一個 token。這個 loop 一直跑,直到回答完成。
為什麼同一個問題每次可能得到不同答案?因為生成時通常不會永遠選機率最高的詞。影片提到,如果沿途允許模型隨機選一些機率較低但仍合理的詞,輸出會更自然。這也表示,即使模型本身在同樣參數與同樣輸入下是 deterministic,實際聊天介面常常會透過 sampling 讓答案有變化。
這個心智模型能幫我們避免兩種誤解。第一,不要把 LLM 當資料庫。它的基本動作不是查表,而是根據上下文補出最合理的延續。第二,也不要把它看得太低。下一個詞預測看似狹窄,但如果訓練資料夠大、模型夠大、結構夠好,很多高階能力會在這個目標下被間接學出來。
換句話說,LLM 的神奇不是因為任務定義很複雜,而是因為一個極簡任務被推到極端規模後,產生了超出直覺的行為。
2. 預訓練是在調一臺超大機器|參數、文本與反向傳播
LLM 如何學會預測下一個詞?影片用「調一臺大機器的旋鈕」來解釋。模型的行為由大量連續數值決定,這些數值通常叫 parameters 或 weights。改變這些數值,就會改變模型對下一個詞的機率判斷。
大型語言模型的「large」就在這裡:它可以有數千億個參數。沒有人手動設定這些參數。一開始它們接近隨機,所以模型只會輸出亂七八糟的東西;接著訓練流程會拿大量文本當例子,把每段文本的最後一個詞先藏起來,讓模型根據前面的內容猜最後一個詞。猜完後,系統把模型預測與真實最後一個詞比較,再用 backpropagation 調整所有參數,讓模型下一次更可能猜到真實詞,並降低其他錯誤詞的機率。
這件事不是跑幾次就好,而是對 trillions of examples 不斷重複。結果是,模型不只在訓練資料上變準,也開始能對沒看過的文本做出合理預測。這就是預訓練的核心:不是教模型背答案,而是在海量語言環境裡把參數調成能泛化的狀態。
影片給了兩個規模感很強的數字。以 GPT-3 的訓練文本量為例,如果一個人 24 小時不停閱讀,要讀完同等文本量需要超過 2600 年。而如果假設你每秒可以做 10 億次加法與乘法,要手動完成最大語言模型訓練涉及的運算,時間會遠超過 1 億年。
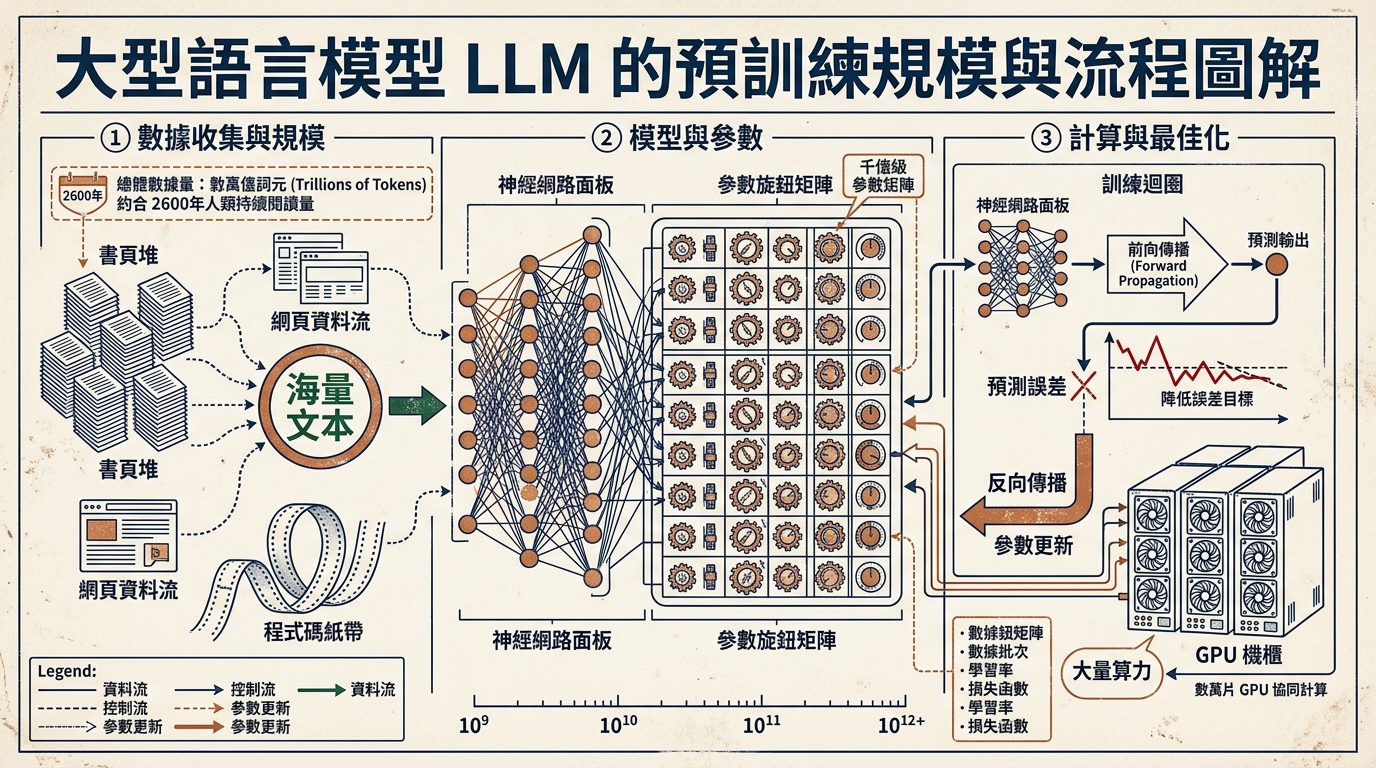
這些數字不是炫耀用的,它們提醒我們:LLM 的能力來自資料、參數、演算法與硬體共同堆出的規模。它不是單一技巧,也不是某個 prompt 魔法。當我們在產品裡使用模型時,看到的是一個已經被巨大訓練成本壓縮過的能力介面。
3. 會補字不等於會當助手|預訓練後還需要偏好對齊
影片中有一個關鍵轉折:預訓練只是故事的一部分。從網路隨機文本中學會自動補完,和成為一個好用、可靠、符合人類偏好的 AI 助手,是不同目標。
預訓練讓模型學會語言與世界的統計模式,但它不保證模型會誠實、友善、有幫助,也不保證它知道什麼時候該拒答、什麼時候該承認不知道。為了把「會補文字」推向「像助手一樣回答」,聊天模型還需要另一類訓練,其中影片提到的是 reinforcement learning with human feedback,通常縮寫為 RLHF。
RLHF 的直覺是:人類工作者標記哪些回答沒幫助、哪些回答有問題,或提供更偏好的修正,這些回饋會進一步改變模型參數,讓它更可能產生使用者偏好的回答。這也是為什麼我們今天使用的聊天機器人,不只是裸的預訓練模型。它們通常經過指令微調、偏好訓練、安全策略與產品層規則包裝。
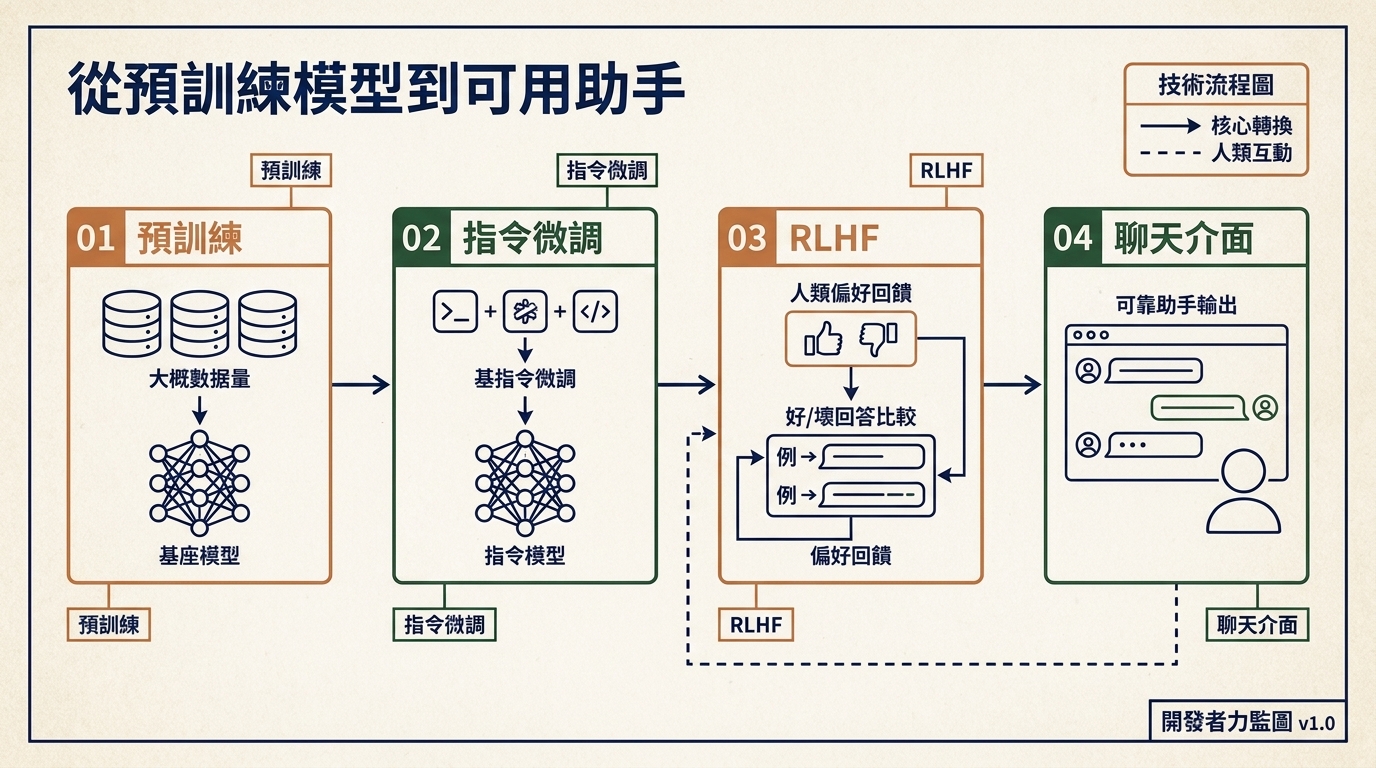
這一點對使用者很重要。當你評估一個模型時,不只是在評估「它懂多少文本」,也在評估它被如何對齊、如何取樣、如何包裝成聊天介面。兩個底層能力相近的模型,可能因為後訓練與產品設計不同,而在語氣、可靠度、拒答風格、工具使用能力上差很多。
所以「LLM 只是下一個詞預測」和「LLM 可以很好用」並不矛盾。前者描述底層訓練目標,後者描述預訓練、對齊、介面與使用情境疊加後的結果。
4. Transformer 讓上下文同時進場|Attention 的直覺是讓詞彼此改寫意義
影片最後把視角拉到 Transformer。2017 年以前,許多語言模型更像是一個詞一個詞處理文本;Transformer 的突破在於,它不是從頭到尾逐字讀,而是能把一段文本同時吸收進來,並行處理。這件事對 GPU 這類擅長平行運算的硬體非常友善,也讓大規模訓練更可行。
Transformer 的第一步,是把每個詞對應到一長串數字,也就是向量。原因很簡單:訓練流程只能處理連續數值,所以語言必須被編碼成數字。這些向量不只是代號,它們會逐漸承載詞的意義。
真正特別的是 attention。影片用很好的方式描述:attention 讓這些數字列表彼此「對話」,根據周圍上下文修正自己所代表的意義。例如 bank 這個詞,可以是銀行,也可以是河岸。它本身不夠明確,但如果周圍出現 river,attention 就能讓表示 bank 的向量受到上下文影響,偏向 riverbank 的意思。
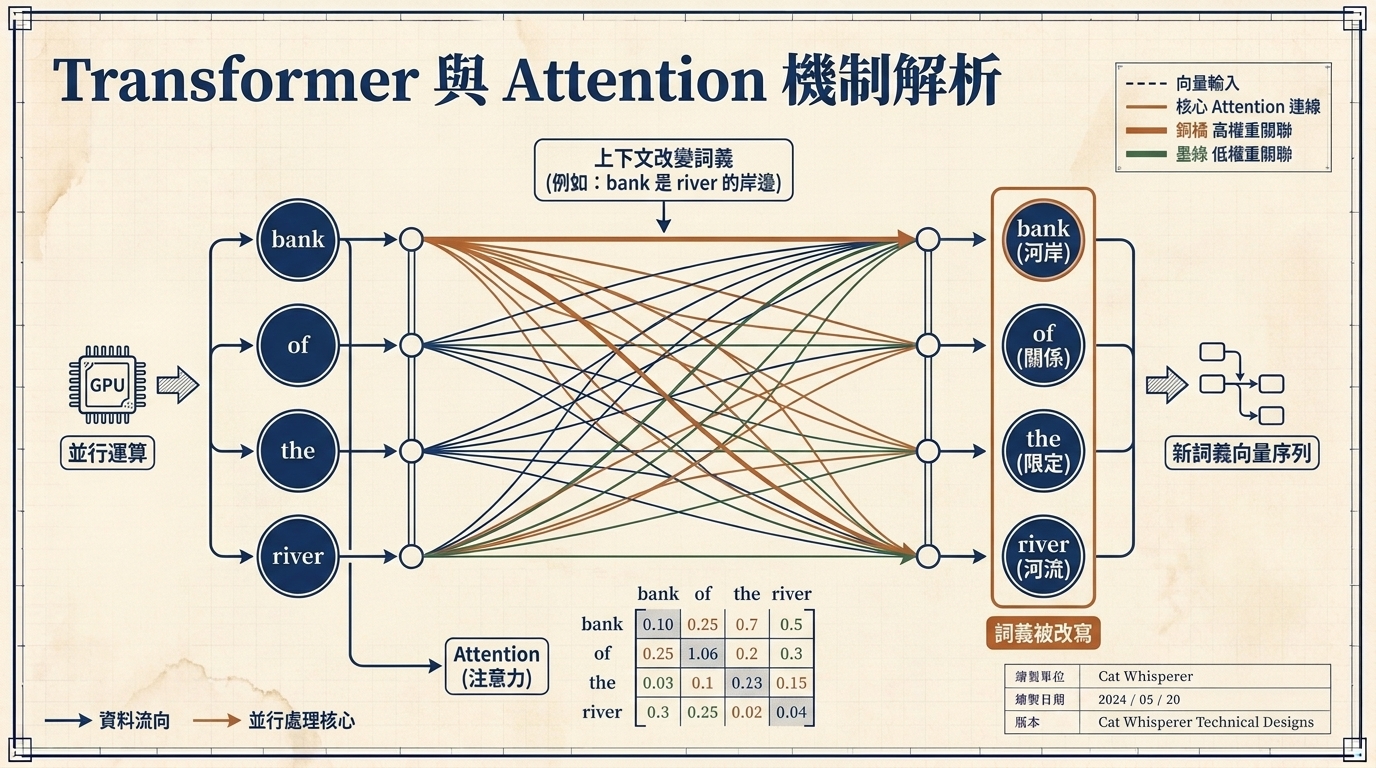
Transformer 通常還有另一個重要操作:feed-forward neural network。它提供額外容量,讓模型儲存訓練中學到的語言模式。資料會在 attention 與 feed-forward 這兩類操作中反覆流動,每一層都讓詞向量變得更富含上下文資訊。最後,模型看序列最後一個向量,結合整段輸入與訓練中學到的模式,產生下一個詞的機率分佈。
這裡要抓住的不是數學細節,而是直覺:Transformer 讓「詞的意義」不再是孤立的查表結果,而是在上下文裡被動態重寫。這也是為什麼同一個詞在不同句子裡可以導向不同預測,而模型能在很長的語境裡維持某種連貫性。
5. 該帶走的是工程直覺|流暢不代表可解釋,概率不代表沒價值
影片最後提醒一件事:研究者設計了框架,但模型的具體行為是訓練後從數千億參數裡湧現出來的。這讓我們很難精確說明模型為什麼在某個 prompt 下做出某個預測。你能觀察到的是,當你用這些機率預測去自動補完文本,生成結果會流暢、迷人,甚至非常有用。
這裡有兩個工程直覺值得帶走。
第一,LLM 的輸出要被當成機率生成的結果,而不是權威來源。它可以非常流暢,但流暢不等於正確;它可以看起來很懂,但看起來懂不等於知道自己的錯。這也是為什麼在產品裡使用 LLM 時,驗證、引用來源、工具回傳、測試與人類審稿仍然重要。
第二,下一個詞預測不代表能力很低。很多人聽到「只是預測下一個詞」會低估模型,但這個「只是」背後是極大的資料規模、參數規模、計算規模、Transformer 架構與對齊流程。比較好的說法是:LLM 的底層訓練目標很單純,但它在規模化後產生了高階能力。
對團隊來說,這支影片可以當作 AI 產品討論的共同語言。當有人說模型在「理解」時,我們可以追問:這裡指的是語義向量被上下文修正後的行為,還是人類式理解?當有人說模型「亂講」時,我們可以追問:它是缺少資料、缺少對齊、缺少工具,還是缺少驗證?當有人想把 LLM 放進工作流程時,我們可以追問:哪一段只是生成,哪一段需要 ground truth?
把神祕感拿掉後,LLM 反而更值得認真使用。它不是魔法師,也不是單純查表工具;它是一個被海量文本、參數與運算訓練出來的語言預測系統。懂這一點,才比較知道什麼該交給它,什麼必須自己設計驗證。