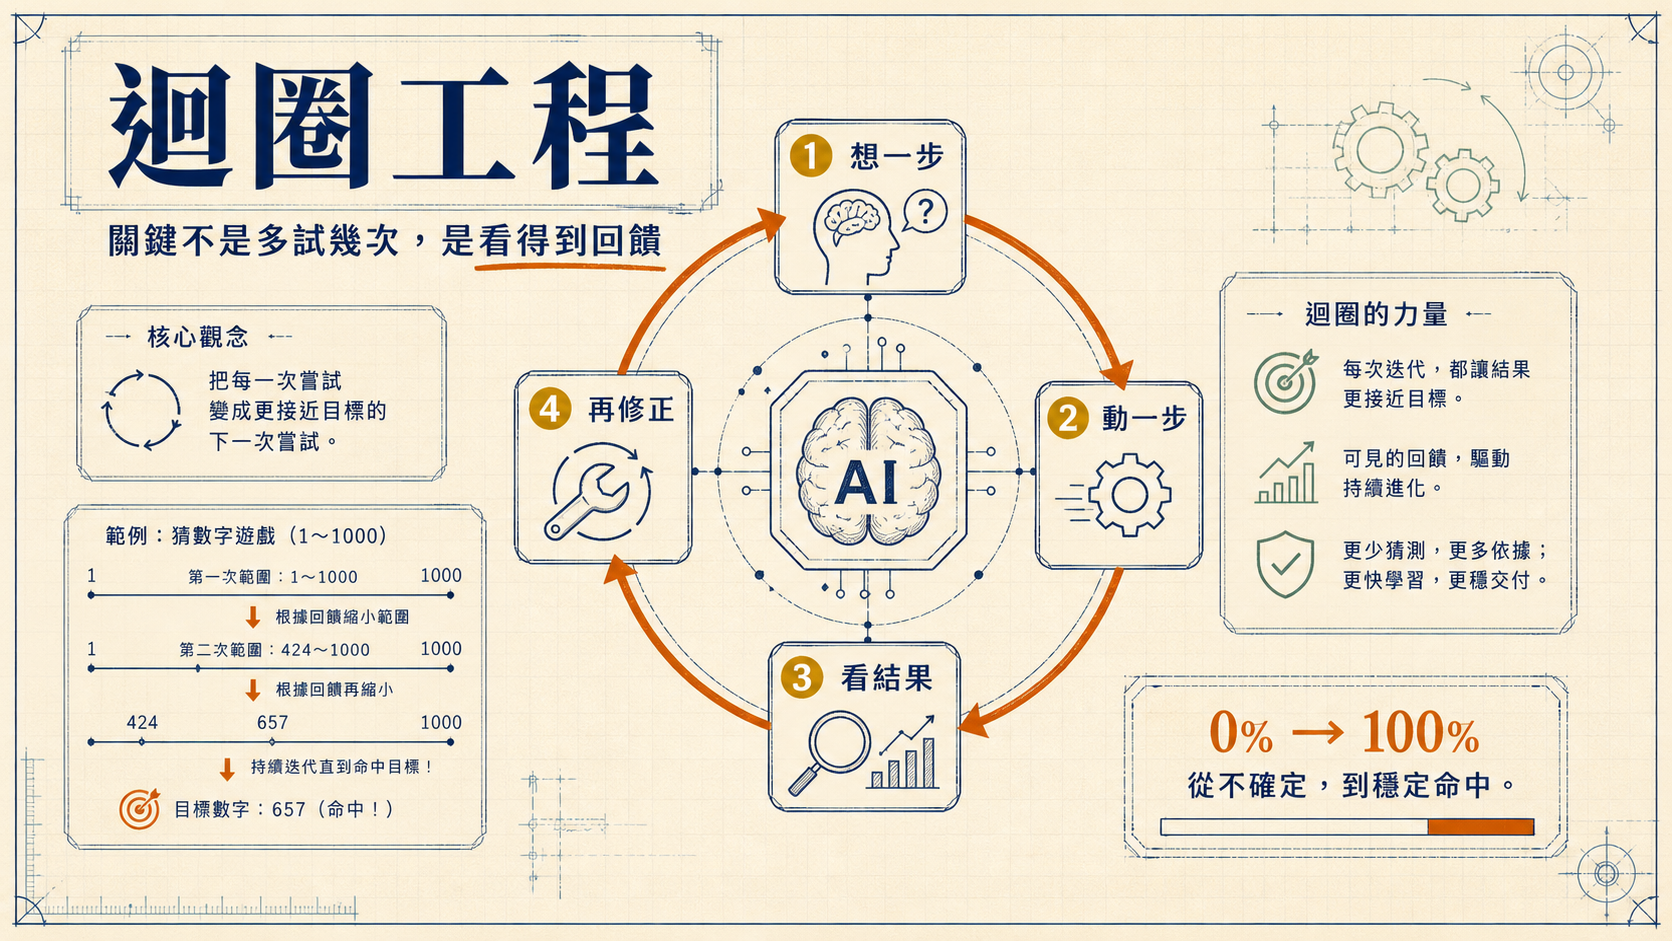
0. 不是多試,而是回饋|為什麼同樣 14 次會差這麼多
這支影片的好處,是把最近有點抽象的「迴圈工程」(loop engineering)壓成一個非常小的實驗:讓 AI 猜一個 1 到 1000 之間的數字。
原影片:同樣猜 14 次,為什麼差這麼多?|一隻 AI 親手實測「迴圈工程」loop engineering
完整程式碼:speechlab0210 的 gist
題目看起來很簡單,但設計得很乾淨。答案不在 prompt 裡,只在人的腦袋裡。AI 要猜中,唯一能取得資訊的方式,就是先猜一次,再看你回饋「高了」還是「低了」。這正好把 loop engineering 的核心拉出來:不是模型一次回答有多神,而是每一步結果能不能進到下一步決策。
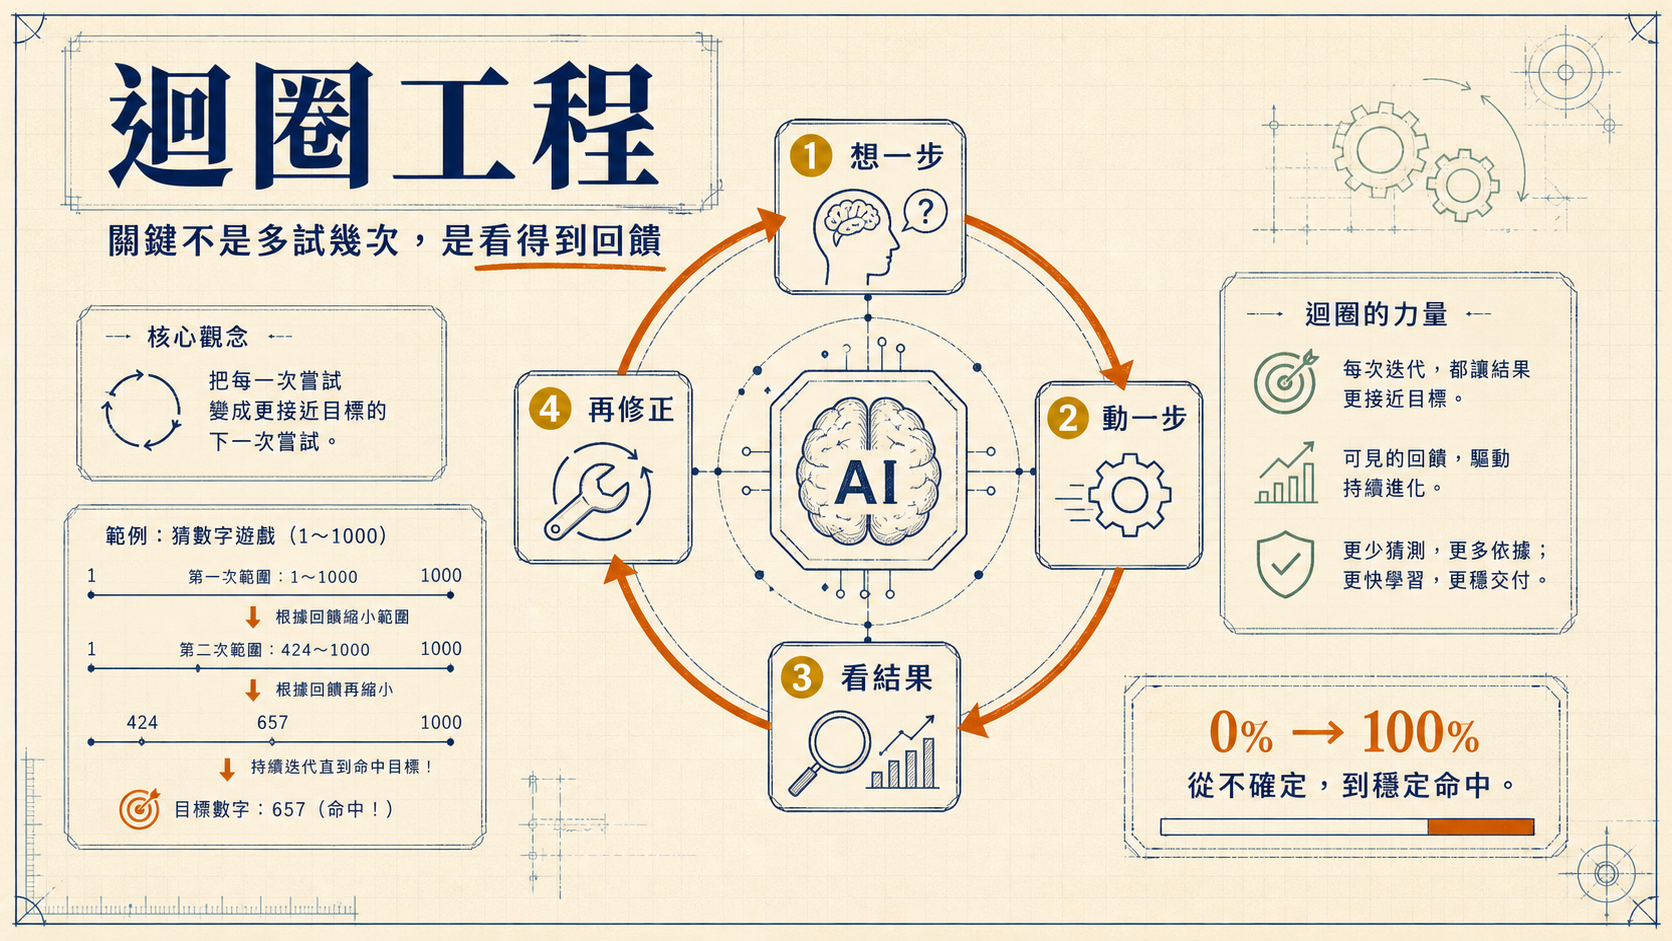
影片給出的對照很直接:同樣是 GPT-4o mini,同樣最多猜 14 次,沒有回饋時仍是 0%;看得到高了/低了之後,就能一路逼近到 100%。這不是因為「多試幾次」突然有用,而是因為每一次嘗試都產生了可用資訊。
這點值得被放大。很多人談 agent、workflow、自動化時,會把焦點放在「讓 AI 自己跑很多步」。但如果這些步驟沒有 observation、沒有驗證、沒有錯誤回饋、沒有停止條件,那它只是把一次猜測重複很多遍。迴圈不是重複,迴圈是「帶著上一輪結果進入下一輪」。
1. 模型與迴圈|模型只回答一次,系統才會行動
影片裡有一個很好的分界:模型本身只是一次回答。你問一句,它回一句,這可以看成一次 forward pass。乾淨、快速,但到這裡就結束了。
真正會做事的 AI,外面還有一圈:想一步、動一步、看結果、再修正。也就是把模型包在一個 control loop 裡。模型提供一次推理,迴圈負責把推理接到工具、環境、觀察結果與下一次決策。
這也是 ReAct 這個老點子仍然重要的原因。ReAct 的核心不是讓模型寫更長的 chain-of-thought,而是把 reasoning 和 acting 放在同一個節奏裡:想、做、觀察,再想。講者也提醒,loop engineering 這個名字最近才紅,但背後概念至少可以追到 2022 年的 ReAct。
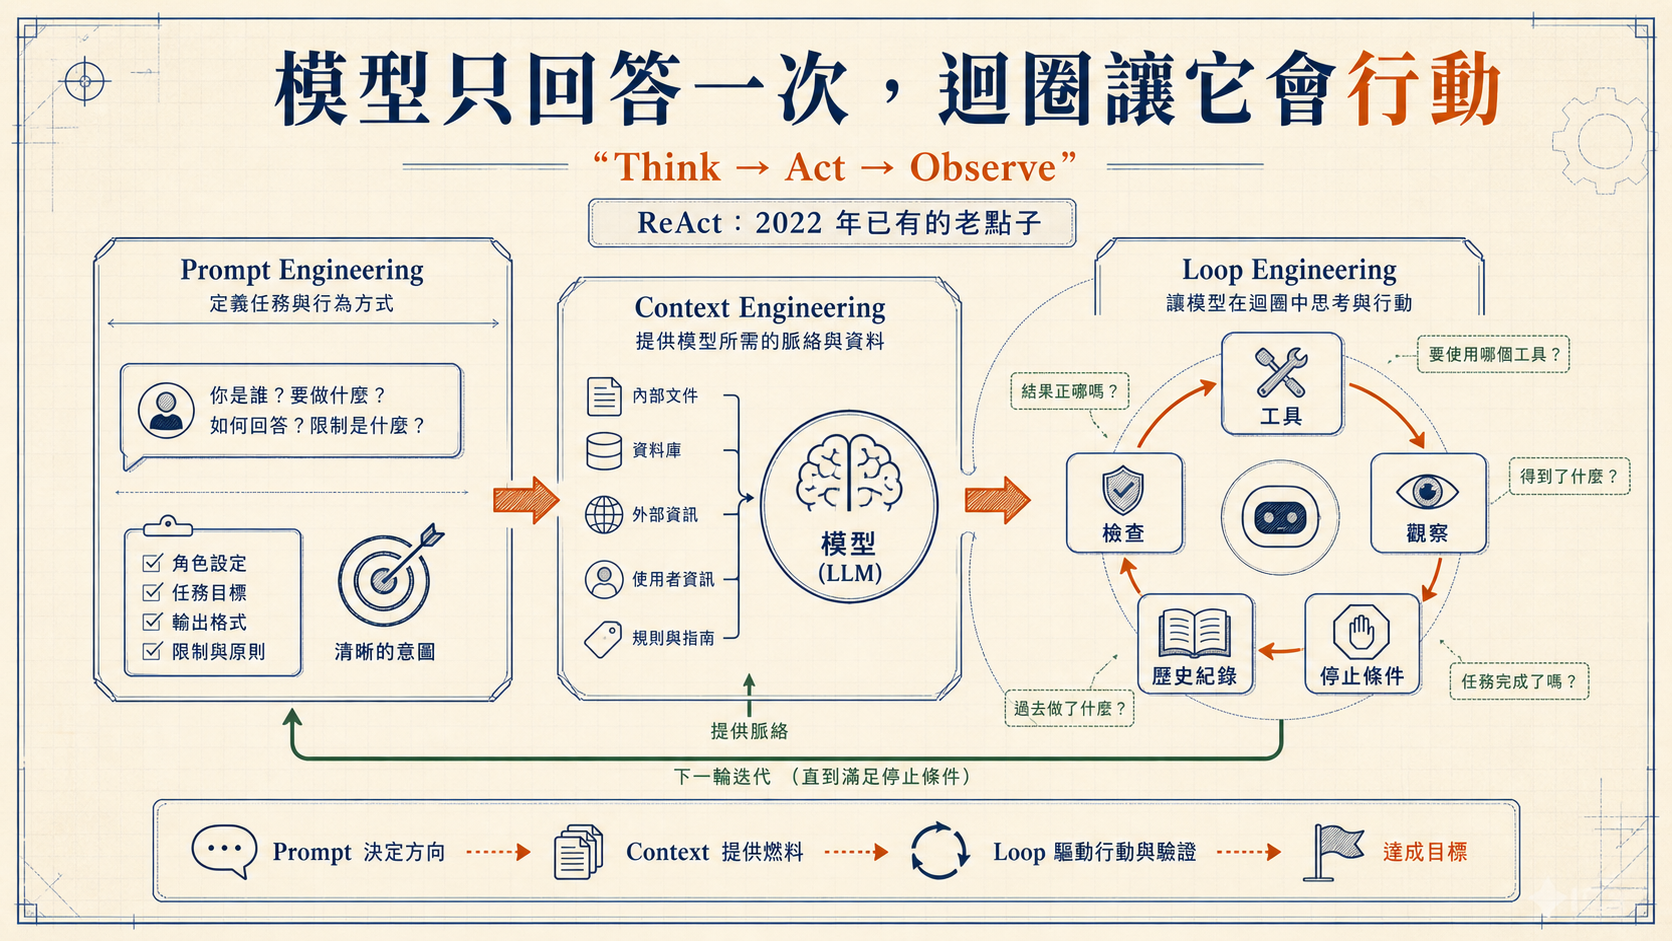
從這個角度看,prompt engineering、context engineering、loop engineering 是三個不同層次。
Prompt engineering 關心你怎麼問。
Context engineering 關心模型看到什麼資料、規則、文件和背景。
Loop engineering 關心模型怎麼一圈一圈推進:可以用哪些工具、觀察結果怎麼回來、歷史紀錄怎麼管理、錯了怎麼修、什麼時候停。
這三者不是互斥,而是疊上去的。沒有好的 prompt,模型第一步就可能偏;沒有 context,它可能不知道任務背景;沒有 loop,它即使第一步答得漂亮,也不一定能在真實世界裡完成任務。
2. 三種實驗條件|只問一次、盲猜 14 次、看結果猜 14 次
這支影片最漂亮的地方,是把變因控制得很清楚。講者用同一個 AI、同一道題,只改一件事:有沒有把結果回饋給模型。
第一種,只問一次。1 到 1000 中猜一個數字,猜中的機率很低,實驗結果是 0%。這很直覺。
第二種,讓它猜 14 次,但不告訴它任何結果。影片 description 裡寫得很清楚:它仍然是 0%,甚至連續猜了 14 次「500」。這也很合理,因為每一輪都沒有新資訊。模型不知道 500 是太高、太低、還是接近答案;下一輪其實跟上一輪一樣,只是再被叫起來猜一次。
第三種,同樣猜 14 次,但每次都告訴它高了或低了。這時 GPT-4o mini 會自然採用接近 binary search 的策略:先猜 500,太低就猜 750,太高就退回 625,再一路把範圍切半。最後衝到 100%。
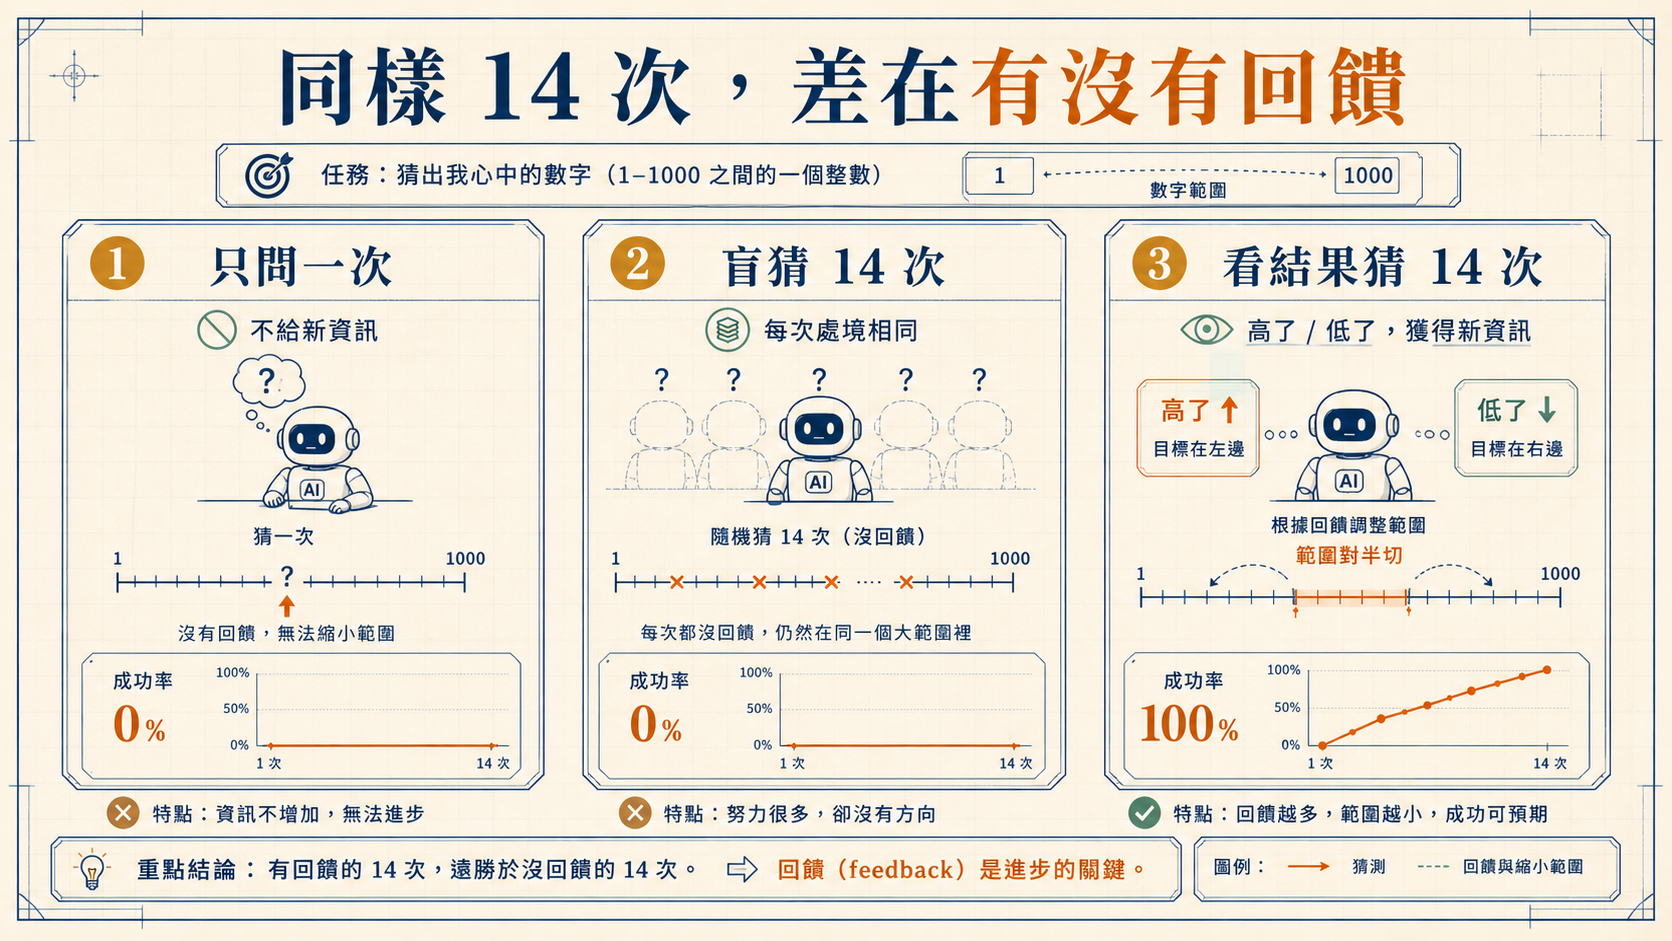
這裡有一個重要結論:第二種和第三種都猜了 14 次,因此差別不是「嘗試次數」。真正差別是回饋是否進入系統。
這也是很多 agent 設計容易犯的錯。大家會讓模型連續跑很多步,卻沒有把每一步的觀察做成有效訊號。模型可能產生長長的紀錄,看起來很努力,但它沒有從環境取得可用資訊。這種 loop 只是形式上的 loop。
有效迴圈至少需要三件事:
第一,環境要回傳可理解的訊號。高了/低了就是一個極簡訊號。
第二,模型要把訊號轉成策略更新。GPT-4o mini 把它轉成對半切範圍。
第三,系統要知道何時停止。猜中就停,或者 14 次用完就停。
這三件事缺一個,loop 就會開始失真。
3. 同樣回饋,不同能力|GPT-4o mini 與 Llama 3.3 70B 的差異
影片沒有把 loop engineering 講成魔法,這點很好。因為它接著展示了另一個模型:Llama 3.3 70B。
在同樣有回饋的條件下,Llama 3.3 70B 並沒有像 GPT-4o mini 一樣穩定對半切。影片 description 說,後段它明明知道猜高了,卻只敢一格一格往下挪,例如 799、798、797。14 次用完還沒猜中,整體只拿到 80%。
這個對照很關鍵:迴圈給模型線索,但模型仍然要會用線索。
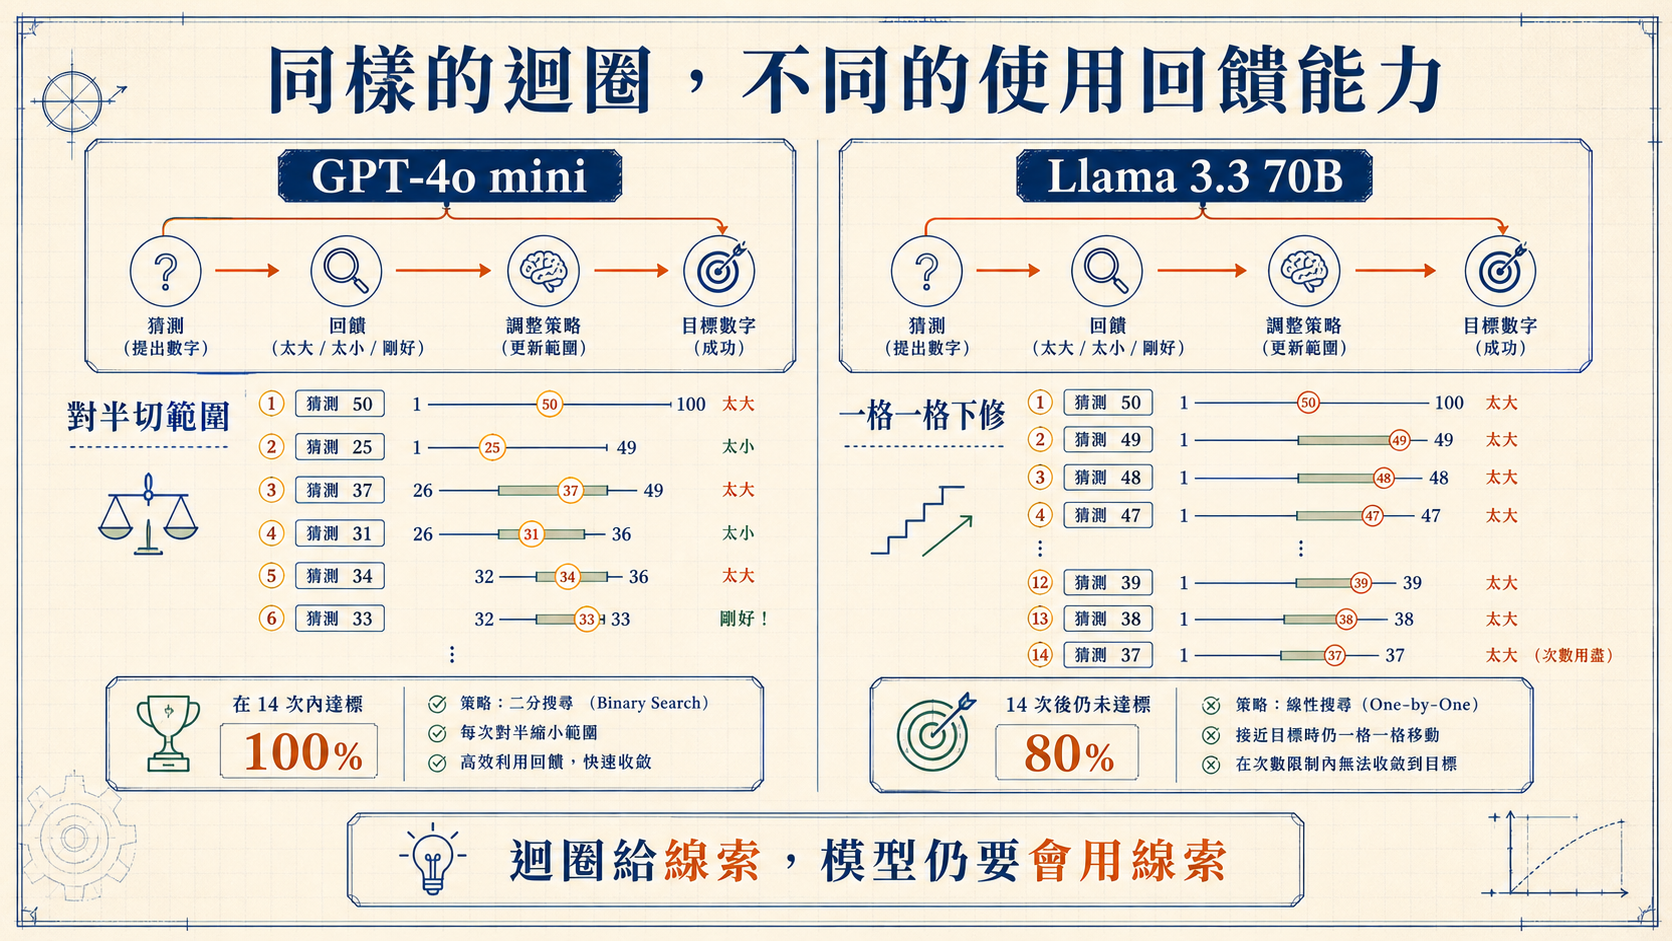
換句話說,loop engineering 不是把任何模型都變成可靠 agent。它比較像是把模型放進一個能產生回饋的工作環境裡。環境可以讓模型更容易修正,但修正策略本身仍然取決於模型能力、提示、工具格式、歷史紀錄管理與任務設計。
這也解釋了為什麼真實世界的 agent 評估不能只看單輪 benchmark。很多任務不是一次答題,而是多步互動。模型要能讀懂錯誤、更新計畫、避免重複犯錯、在時間或成本限制內收斂。這些能力,只有放進 loop 裡才看得出來。
但反過來說,loop 也會暴露模型弱點。單輪回答看起來都會講道理;一旦進入多輪行動,保守、固執、過度局部調整、不能利用回饋的問題就會出現。Llama 3.3 70B 在這個小實驗裡的表現,正好是一個簡化版提醒。
4. 工程問題|迴圈要設計工具、觀察、停止條件
影片最後把問題拉回工程:loop engineering 到底在設計什麼?
不是只設計「多跑幾輪」。真正要設計的是:給模型哪些工具?工具結果用什麼格式回來?每一步結果怎麼寫進下一步?歷史紀錄太長時怎麼整理?什麼時候應該停下來?要不要叫另一個 agent 檢查?怎麼知道自己沒有做錯?
猜數字實驗裡,工具很簡單:猜一個數字。觀察也很簡單:高了、低了、猜中了。停止條件也很清楚:猜中或 14 次用完。
真實世界就麻煩得多。寫程式時,觀察可能是測試結果、lint、typecheck、runtime error、diff、review comment。寫文章時,觀察可能是來源一致性、schema gate、圖片是否存在、語氣是否正確。做客服或銷售時,觀察可能是 CRM 狀態、客戶回信、權限限制、不可觸碰資料。
所以 loop engineering 的難點不在「讓 AI 連續跑」,而在把任務轉成能被觀察、能被修正、能被停止的流程。
這也是魚塘自己會在內容 pipeline 裡放很多 gate 的原因。影音連結不是直接丟給 AI 叫它寫完,而是先轉錄、整理摘要、生成圖片、寫文章、校對 frontmatter、跑 build。每一步都有產物,也都有驗證點。這些 gate 才是 loop 能長期可靠的原因。
本文的編輯結論是:迴圈工程真正有用的地方,不是讓模型「努力一點」,而是讓模型不必靠一次猜測決定一切。它可以猜、看、修、再猜。可是要做到這件事,你得先設計好回饋訊號。
沒有回饋的 14 次,仍然只是 14 次盲猜。
有回饋的 14 次,才可能變成收斂。