0. 瓶頸從智慧變成注意力|單一 agent 已經不是問題的全部
Luke Alvoeiro 在 AI Engineer 這場演講一開始,丟出一個很值得停下來想的判斷:今天軟體工程的瓶頸,已經不只是模型智力,而是人類注意力。
這句話聽起來有點像產品宣傳,但它其實抓到 coding agent 進入下一階段後的核心矛盾。模型已經能理解 backlog 裡大量任務,也能完成很多單點實作;可是每一個任務仍然需要人類拆解、監督、看 diff、跑驗證、判斷是否偏航。工程師可能有 50 個 feature 想推進,但一天能真正盯住的也就幾個。模型的能力上來之後,瓶頸反而變成:誰來管理這些代理?誰來決定完成的定義?誰來防止它們互相踩到?
這場演講的主角是 Factory 的 Missions。它不是把一個聊天視窗拉長,也不是單純把十個 agent 同時放出去跑。Luke 的說法是:mission 不是單一 agent session,而是一個 agent ecosystem。你描述目標、透過對話收斂 scope、批准計畫,接著系統可以執行數小時甚至數天,讓人類把注意力移去更高階的產品與架構決策。
這裡的關鍵,是「多代理」不等於「多工」。真正能出貨的 multi-agent 架構,需要角色分工、共享狀態、結構化交接、事前驗收契約,以及獨立驗證。否則多開幾個 agent,只是多幾個會互相製造衝突的自動化實習生。
這也是這支影片對魚塘最有價值的地方:它把 multi-agent 從一個容易被講成 demo 的概念,拉回到工程管理、品質保證與長任務控制的問題。
1. 五種 multi-agent 策略|先把混亂的名詞拆開
Luke 說,當你開始研究 multi-agent framework,很快會發現現場像一團霧。每個人都有自己的框架、術語和信仰。為了讓討論能落地,他先提出一個 taxonomy:前沿 multi-agent 系統大致有五種策略。
第一種是 Delegation。一個 parent agent 派出另一個 agent,請它去查資料、看資料庫 schema、分析某段 code,再把結果帶回來。這是最直覺也最常見的型態,很多 coding tool 裡的 sub-agent 都是這種模式。
第二種是 Creator-Verifier。一個 agent 負責建立,另一個 agent 負責檢查。這背後的理由很實際:寫出 code 的 agent 會有 sunk-cost bias,它會希望自己的實作是對的;換一個乾淨脈絡的 agent 來 review,更容易看到問題。這跟人類 code review 的理由其實很像。
第三種是 Direct Communication。代理之間不透過中央協調者,直接彼此溝通。這聽起來自由,但也最容易失控。狀態會碎在不同對話裡,沒有單一真相來源,長任務很容易越跑越散。
第四種是 Negotiation。代理需要協調共享資源:同一個 API、同一段 codebase、同一個架構決策。Luke 特別提醒,negotiation 不一定是對抗式的;最好的情況是 positive-sum trading,也就是代理之間交換資訊後雙方都更好。
第五種是 Broadcast。一個 agent 把新資訊、限制或狀態更新廣播給多個代理。它沒有 delegation 或 verifier 那麼亮眼,但對長時間任務很關鍵,因為系統需要共同脈絡,不然每個代理都會活在自己的局部世界。
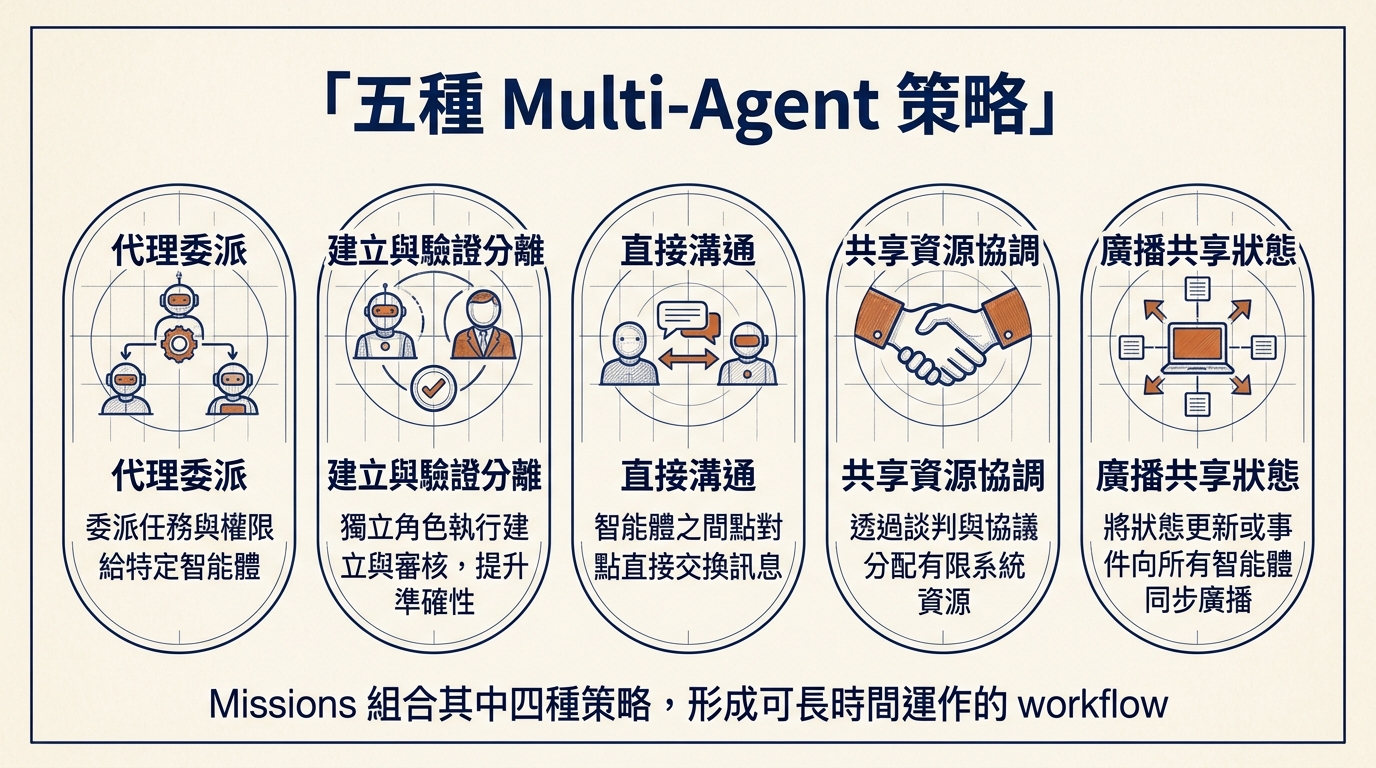
Missions 的做法,是把其中四種組合起來:delegation、creator-verifier、broadcast、negotiation。這個組合本身不神祕,重點是它被組成一個可長時間運作的 workflow,而不是散落的 agent 技巧。
2. Missions 的三角色架構|Orchestrator、Workers、Validators
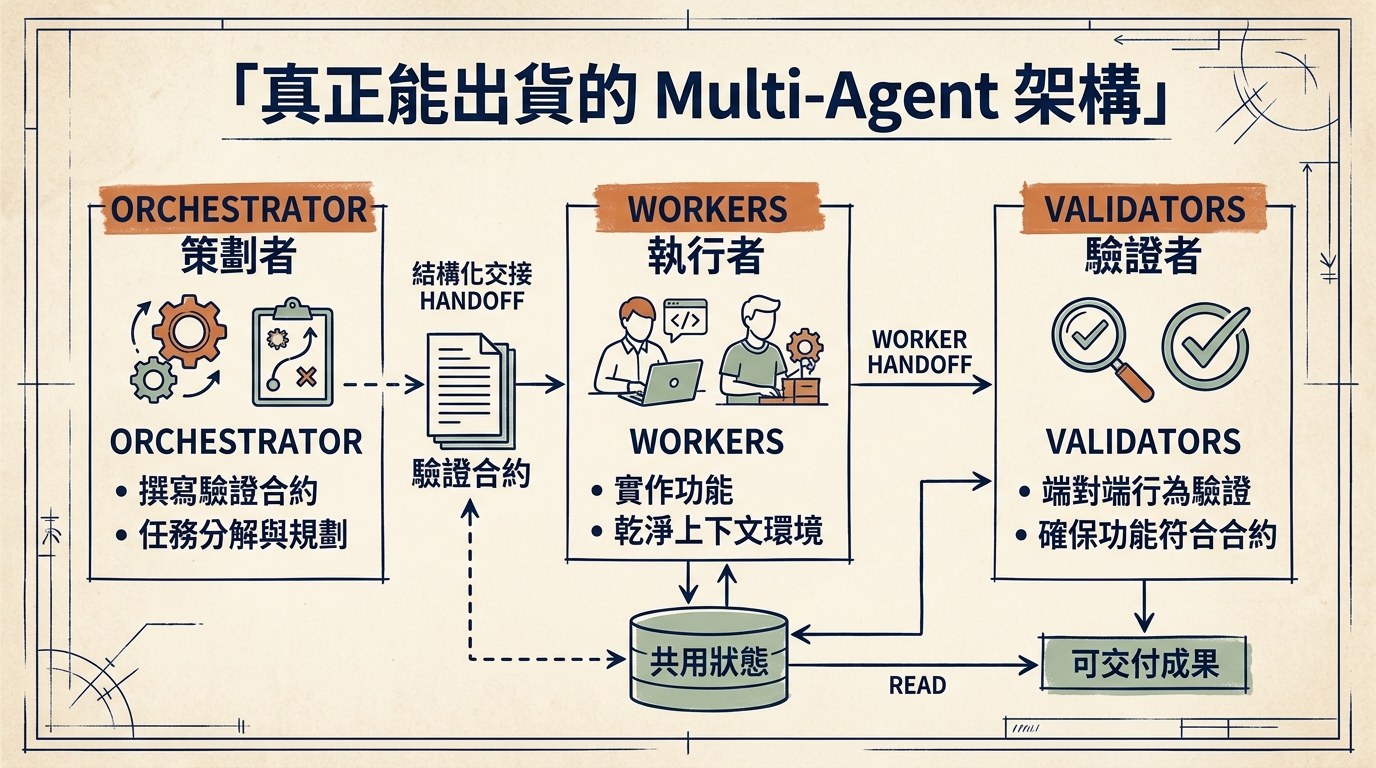
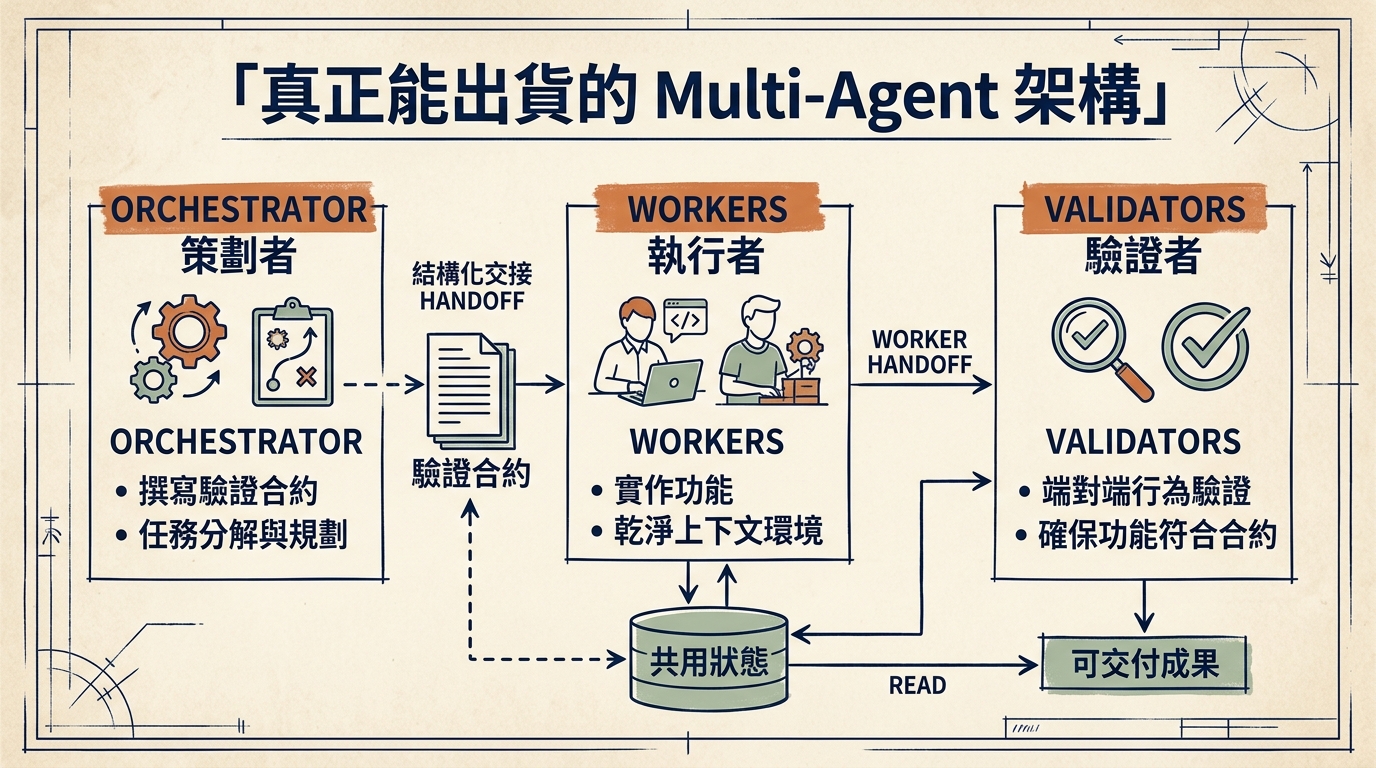
Missions 的核心,是三種角色:Orchestrator、Workers、Validators。
Orchestrator 負責規劃。當你描述想做什麼,它不是馬上開始寫 code,而是先像 sounding board 一樣追問需求,確認問題空間中哪些地方不清楚,最後產出包含 features、milestones 與 validation contract 的計畫。這裡很重要:validation contract 在任何 coding 開始前就被定義,代表「完成」不是事後由實作自己宣稱,而是事前由任務目標推導出來。
Workers 負責實作。每個 feature 被分配給 worker 時,worker 具有乾淨脈絡,沒有上一輪對話累積的雜訊,也沒有 degraded attention。它讀 spec、實作 feature、提交 git commit,讓下一個 worker 可以在乾淨且可工作的 codebase 上繼續。
Validators 負責驗證。一般系統可能跑 lint、typecheck、tests,再做 code review;Missions 也做這些,但更重視行為驗證。它不只問「code 看起來對嗎」,而是問「這個功能端到端真的能用嗎」。這是 Missions 能跑數小時或數天而不漂移的原因之一。
這個三角色架構很像把軟體團隊縮成一個 agent organization:PM/tech lead 做 scope 和驗收標準,工程師逐步實作,QA 和 reviewer 從外部脈絡檢查結果。差別是它把這些角色明確寫進系統流程,而不是期待單一 agent 自己同時扮演所有角色。
3. 驗收契約比事後測試重要|先定義 correctness,再開始寫 code
這場演講最有價值的一段,是 validation contract。
Luke 指出,大家用 coding agent 時常看到一種模式:agent 寫了一個 feature,也寫了測試,測試通過,覆蓋率看起來很好。但這些測試是實作之後才寫的,它們很容易被 code 本身塑形,而不是被原始需求塑形。換句話說,事後測試常常不是抓 bug,而是在確認 agent 已經做出的決策。
這句話很重。因為很多 agent workflow 的失敗,不是它完全不會寫 code,而是它寫出一個自洽但偏離需求的世界。測試也在那個世界裡通過,於是系統看起來很綠,實際上離使用者要的東西越來越遠。
Missions 的 validation contract 在 planning 階段寫下來,早於任何 implementation。對複雜專案來說,它可以有數百條 assertions。每個 feature 都會被分配一個或多個 assertions,而所有 features 加總起來必須覆蓋全部 assertions。
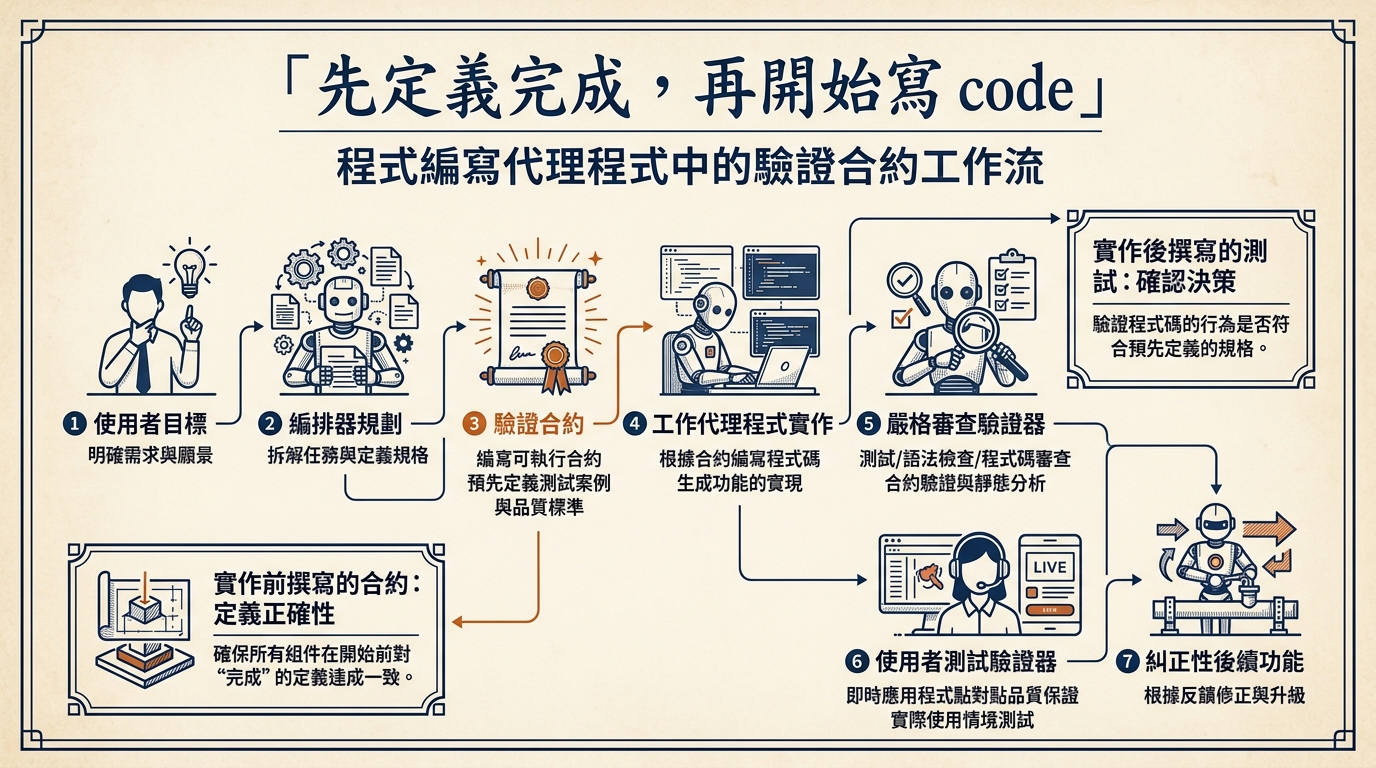
完成一個 milestone 後,Missions 會跑兩種 validator。第一種是 scrutiny validator,比較接近傳統工程檢查:跑測試、typecheck、lint,並為每個完成的 feature 生成專門的 code review agent。第二種是 user-testing validator,更像 QA 工程師:啟動應用程式,透過 computer use 或類似能力實際操作,填表、檢查頁面、點按鈕,確認功能流程整體可用。
Luke 說,user-testing validator 花的時間明顯更長,因為它在等真實世界的執行,而不是只生成 token。這也揭示了一個常被忽略的現實:當 agent 系統越接近 production,瓶頸不一定是模型輸出速度,而是外部世界、瀏覽器、測試環境、build、部署與驗證的等待時間。
4. 長任務靠交接維持記憶|不要期待 agent 自己記得
如果一個任務要跑好幾天,最大的風險之一是 context loss。單一 agent 對話拉太長會退化,多代理之間又容易漏訊息。Missions 的解法不是祈禱模型記性更好,而是強制 worker 在結束時寫結構化 handoff。
這份 handoff 不是一句「我完成了」。它要寫清楚:完成了什麼、還剩什麼、跑了哪些 commands、exit code 是什麼、發現哪些問題、有沒有遵守 orchestrator 定義的程序。錯誤會在 milestone boundary 被捕捉,接著 scope corrective work,讓 mission 把自己拉回軌道。
這點很像 AGENTS.md 或工作日誌在 agent 工程裡的意義:記憶不是感覺,是檔案與契約。 如果你希望一個系統跨多天運作,就不能把關鍵狀態留在模型的隱性脈絡裡。要把它寫成可以被下一個角色讀取、檢查、質疑的結構。
Luke 提到 Factory 最長的 mission 跑了 16 天,比一個完整 sprint 還長;他們相信可以跑到 30 天。這個數字未必代表每個團隊都該讓 agent 跑 30 天,但它說明了一個方向:multi-agent 的價值不是讓一次 prompt 變得更聰明,而是讓任務可以跨時間維持一致性。
5. 為什麼不是越平行越好|軟體工程裡 coordination overhead 會吃掉速度
直覺上,多代理最誘人的地方是平行化。如果 10 個 agent 同時跑,理論上 throughput 應該提高 10 倍。但 Luke 說,他們試過,在軟體開發領域效果不好。
原因很熟悉:agents 會互相踩 changes、重複工作、做出不一致的架構決策。協調成本最後吃掉速度收益,同時 token 還在燃燒。這也是很多人第一次把 multi-agent 用在 codebase 時會遇到的坑:你以為問題是「agent 不夠多」,實際上問題是「沒有一個可合併的工作序列」。
Missions 採用的是 serial execution with targeted internal parallelization。也就是說,同一時間通常只有一個 worker 或 validator 在跑;但在單一 feature 內,允許讀取型操作平行化,例如搜尋 codebase、研究 API。Validator 也可以平行做 read-only code review。寫入與決策保持序列,讀取與檢查才平行。
這個設計看起來慢,但 Luke 說錯誤率會大幅下降;而當任務跑很多天,correctness 會複利。這句話很關鍵:在長任務中,早期小錯會被後續工作放大。你省下的半小時平行執行,很可能換來後面好幾小時修衝突與修偏航。
對任何想在自己 workflow 裡用 subagent 的人,這段都是提醒:平行化要用在可以清楚切開、互不寫入、或有明確整合點的地方。不是所有任務都適合同時開工。
6. 每個角色要坐對模型|Droid Whispering 是新技能
Missions 的角色分工也帶出另一個問題:不同角色適合不同模型。
Luke 的分類是:planning 需要慢而仔細的 reasoning;implementation 需要快速的 code fluency 和創造力;validation 需要精準的 instruction following。沒有單一模型或單一 provider 在三件事上都永遠最好。因此他們內部把這種能力戲稱為 droid whispering:你要能在腦中建模不同 LLM 怎麼互動、各自在哪裡失敗、失敗如何在多天任務中累積,然後刻意決定哪個模型坐在哪個位置。
這也是 model-agnostic architecture 的結構性優勢。如果你鎖死在單一 provider,你就被那個模型家族最弱的能力限制住。當模型持續分化,能把正確模型放到正確座位,會變成複利優勢。
反過來說,Missions 的結構也可以補償非 frontier 模型的不足。Validation contracts 和 milestone checkpoints 讓 open-weight models 也能在這個流程中跑得不錯。也就是說,架構不是只會被模型能力淘汰;好的架構會把模型能力放大,也會把模型弱點框住。
7. Production 數據透露的現實|驗證從來不會第一次就過
演講後段,Luke 用一個 Slack clone 的 production mission 做例子。投影片資訊很多,但幾個數字值得抓出來。
第一,約 60% 的時間和 60% 的 tokens 花在 implementation。這表示系統不是只有 planning 或驗證在轉圈,它確實把主要資源投入在實作。
第二,validation 幾乎不會第一次就成功。Missions 經常需要建立 follow-up features。這剛好證明 QA loop 的價值:如果驗證永遠一次過,那不是系統完美,而可能是驗證太弱。
第三,專案最後約 50% 的 code lines 是 tests,測試覆蓋率約 90%。這不代表每個專案都應該追同樣比例,但它說明 Factory 的 approach 很重視讓 codebase 變成更適合 agent 與人類繼續工作的環境。
第四,他們大量使用 prompt caching 來抵消長任務成本。這點也很現實:multi-agent 不只是架構問題,也是成本工程問題。長任務如果沒有 caching、checkpoint、重用脈絡與清楚的失敗邊界,很容易變成看起來很聰明但帳單很難看的系統。
Luke 也提到 Missions 被用在企業場景:overnight prototype、新功能、內部工具、大型 refactor、migration、ML research,以及 codebase modernization。這些場景有共同特徵:目標可以被拆成 milestones,過程需要驗證,且成功後會讓後續工作更快。
8. 讓架構隨模型進步|Bitter Lesson 在 agent 系統裡的版本
做 multi-agent 系統的人,常有一個恐懼:下一代模型一出,今天設計的 agent architecture 會不會一夜過時?
Luke 把這連到 bitter lesson。他們在設計 Missions 時,刻意讓系統能隨模型變強而變強,而不是被模型取代。因此,大部分 orchestration logic 被定義在 prompts 和 skills 裡,而不是硬寫死在 state machine。它怎麼拆 features、怎麼處理 failure、怎麼調整 worker behavior,都盡量放在模型能理解與改寫的層次。
他提到,這些邏輯約 700 行文字,改四句話就可能大幅改變 execution strategy。Worker behavior 也由 orchestrator 依 mission 定義 skills 來驅動,因此能針對不同專案客製。真正 deterministic 的邏輯很薄,主要負責 bookkeeping:跑驗證、追蹤進度、確保 handoff issues 有被處理。
這是一個很好的產品設計方向:系統負責紀律,模型提供智慧。不要把所有智慧硬編進流程,也不要把所有紀律交給模型自由發揮。前者會被模型進步淘汰,後者會在長任務中漂移。
9. 魚塘觀點|真正的槓桿,是把代理變成可管理的組織
這支影片值得放進魚塘,不是因為它展示了某個炫技 demo,而是因為它很務實地回答了一個問題:當 agent 開始能做很多事,我們該怎麼管理它們?
答案不是「更多 agent」,而是更像工程組織的結構:有人負責定義目標,有人負責逐步交付,有人負責獨立驗證;每個階段有契約,每次交接有紀錄,每個 milestone 有修正迴路,每個角色用適合的模型。
這跟我們平常用 agent 做內容、寫 code、跑 pipeline 的經驗其實是同一件事。最容易翻車的時候,通常不是模型完全不會,而是需求沒被定義清楚、完成標準太晚才出現、平行工作沒有切乾淨、交接沒有寫下來、驗證只看表面綠燈。Missions 把這些人類團隊早就知道的紀律,重新翻譯成 agent 系統可以執行的形式。
最後 Luke 的結論是:未來真正能出貨下一代創新的,會是那些能以 agent ecosystems 思考的人,也就是能理解不同模型在壓力下如何組合、如何失敗、如何互補的人。
這句話可以更白話地說:AI 工程的下一個槓桿,不只是 prompt 寫得好,而是把代理當成一支需要架構、流程與驗收制度的團隊來設計。