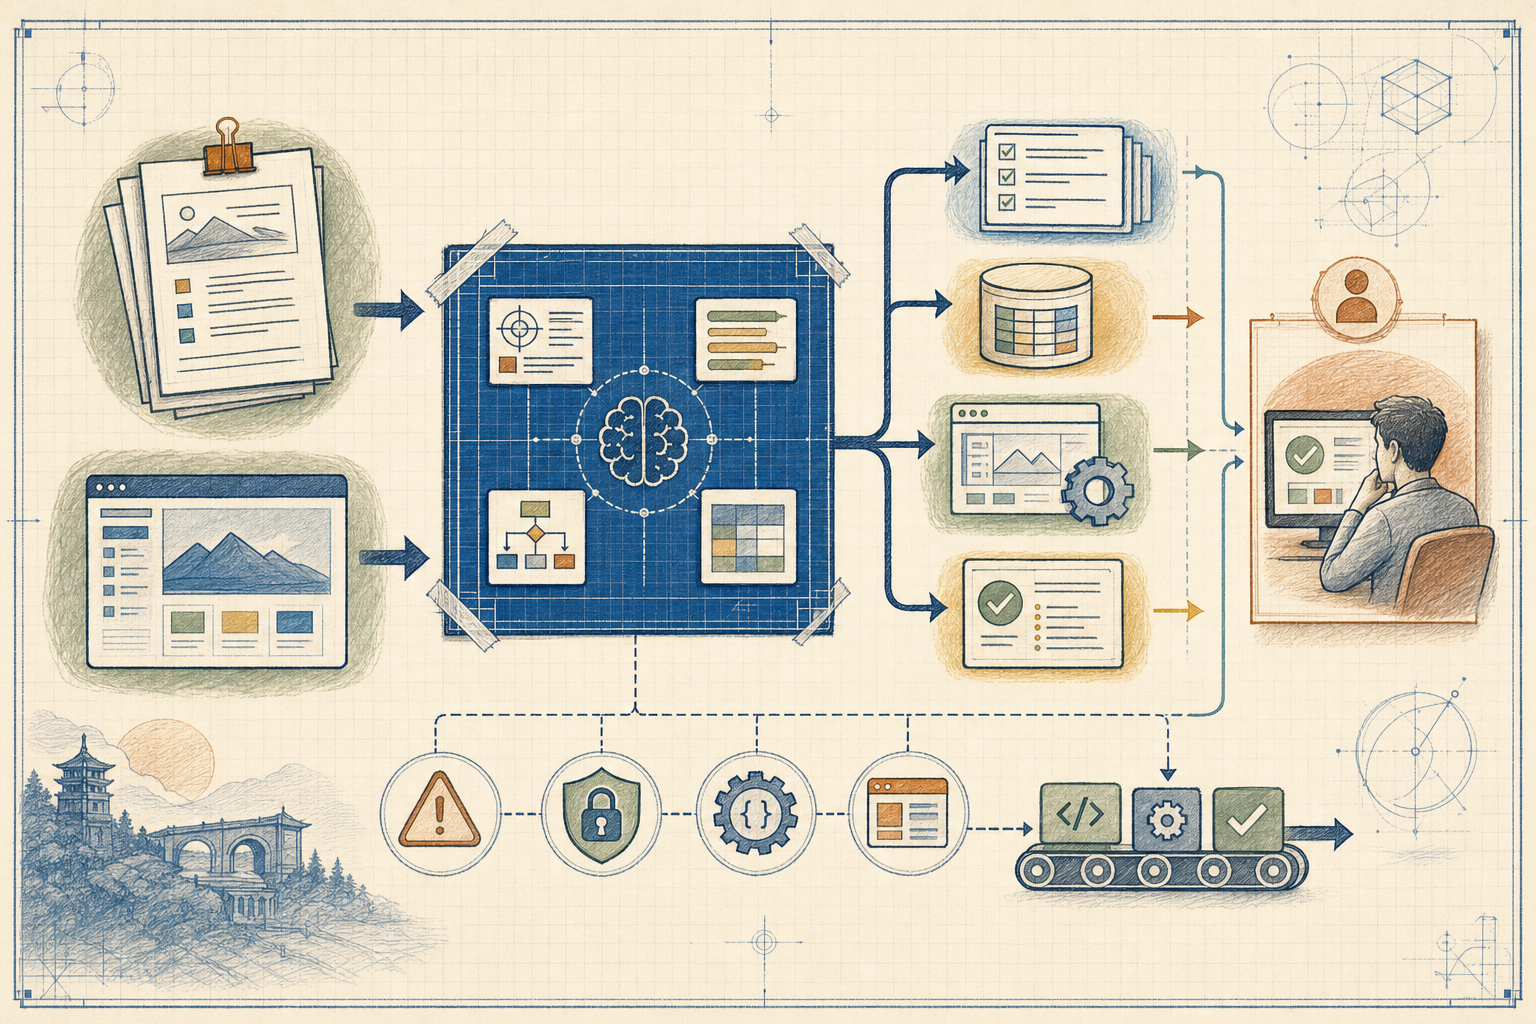
010. 問題不在 AI 會不會寫測試,而在它拿到了什麼規格
只要把「幫我寫一個登入頁測試」丟給大型語言模型,幾秒內通常就能得到一段 Playwright、Cypress 或 Selenium 程式碼。這種體驗很容易讓人以為,測試自動化最耗時的部分已經被解決了。
但真正把程式碼放進 repository 後,問題才開始出現:selector 是模型猜的、驗證條件只檢查 URL、錯誤訊息和產品不一致、測試資料彼此污染,甚至腳本雖然綠燈,卻沒有驗證最關鍵的商業規則。
TestRig Technologies 的原文提出一個很實際的觀點:Prompt engineering 在 QA 裡不是把句子寫得更華麗,而是把模糊需求轉成精確、可執行、具脈絡的測試產物。模型可以加快樣板、案例與資料的生成,但它不知道你的產品,除非你把產品規則交代清楚。
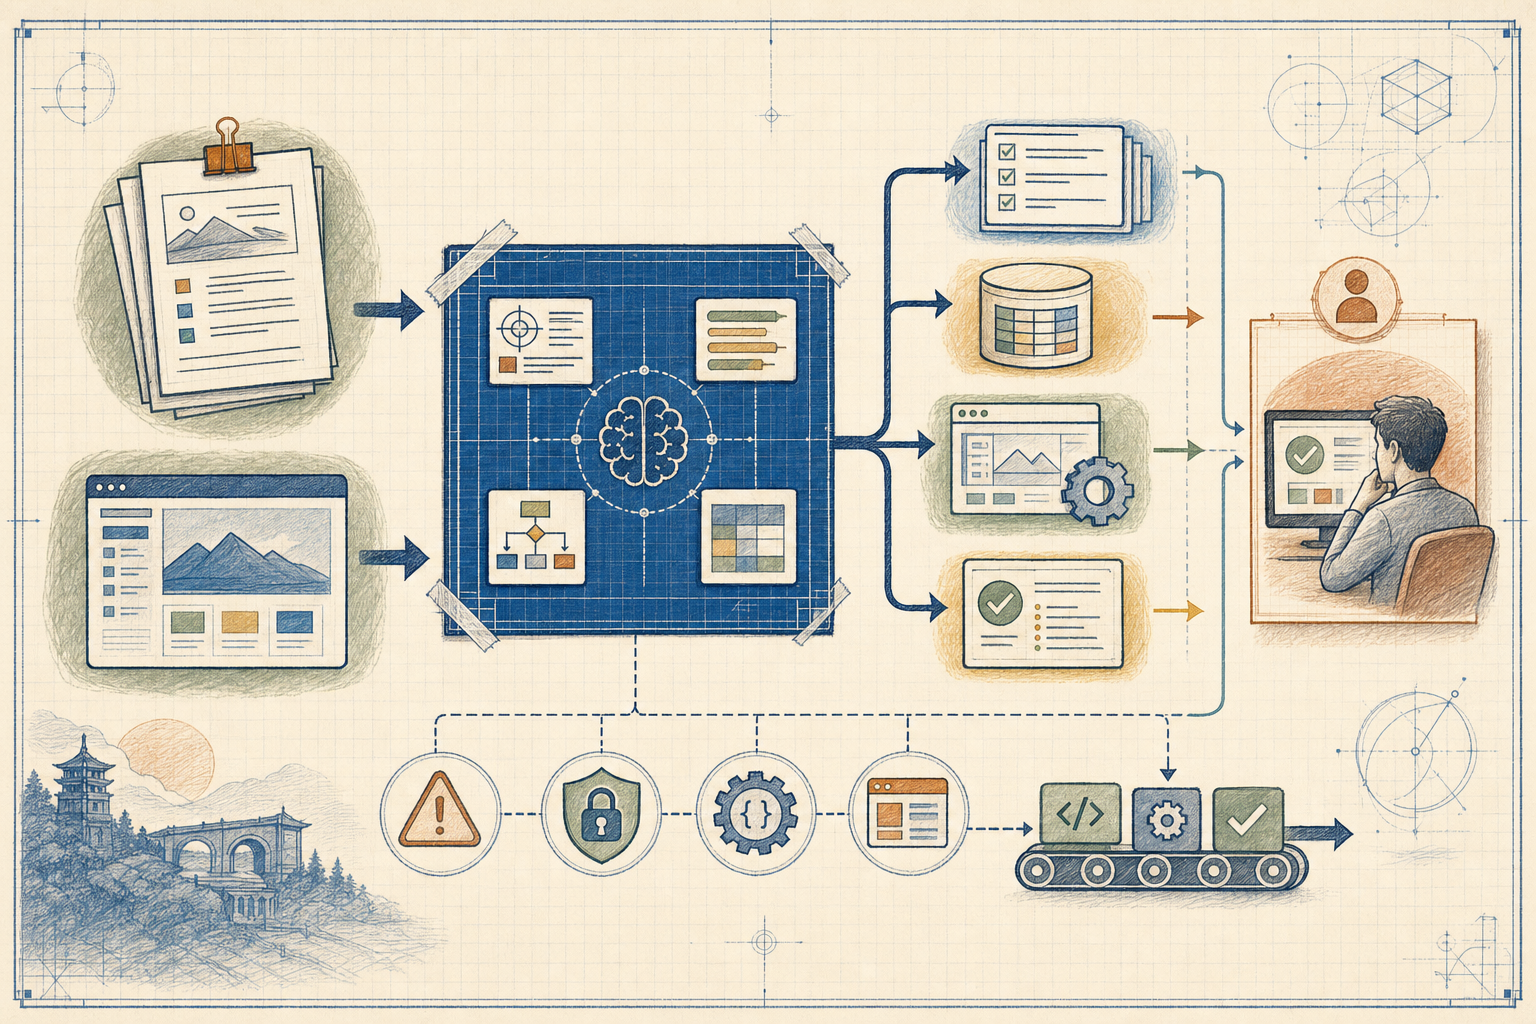
這裡必須先分清楚兩件事:
- 生成測試碼很快,代表的是產出速度。
- 測試能穩定抓到回歸,代表的是測試設計品質。
Prompt engineering 真正要縮短的,不只是打字時間,而是從需求理解、測試設計、程式實作到執行回饋的整段距離。
021. 一個可用的 QA Prompt,需要五種資訊
原文把 production-grade testing prompt 拆成五個核心元素。它們可以視為一份輕量版測試規格,也是模型產出是否可靠的最低輸入契約。
測試目標
先說清楚要測的是 component、integration、API、end-to-end、performance,還是 security。不同層級的測試有不同責任;若只寫「測試結帳功能」,模型可能一次跨過 UI、API、付款服務與資料庫,最後產生一支又慢又脆弱的巨型測試。
更好的描述會限定範圍,例如:
- 使用 Playwright 做瀏覽器端 end-to-end 測試。
- 金流服務以既有 mock route 攔截。
- 本次只驗證信用卡付款成功與拒絕兩條流程。
- 不測第三方支付頁本身。
應用程式脈絡與使用者流程
模型需要看到真實的 user story、DOM 片段、API schema、route、測試帳號策略或既有 helper。這些資訊可以降低它虛構 selector、欄位與函式的機率。
脈絡不是越多越好。把整個 repository 不加篩選地塞進 Context,可能讓模型被無關元件和舊實作干擾。比較有效的方法是提供「完成這個測試所需的最小真實上下文」,例如相關頁面、測試 fixture、API contract 與團隊慣例。
輸出結構
要明確指定語言、框架、runner、檔案位置和架構限制。例如:
- TypeScript,使用
@playwright/test。 - 沿用現有 fixtures,不新增全域 setup。
- 優先使用
getByRole、getByLabel等 user-facing locator。 - 一個 test case 只驗證一個主要行為。
- 不在第一版引入 Page Object Model。
這些限制不只是格式偏好。它們是在防止 AI 每次生成不同風格,讓 code review 和維護成本失控。
邊界與負向情境
模型很擅長補出常見 happy path,但真正有價值的測試往往藏在錯誤狀態、臨界值與行為組合裡。Prompt 應主動要求它考慮空值、格式錯誤、重複提交、網路延遲、權限不足、資料過期、極端長度與安全輸入。
不過,「請想出所有 edge cases」仍然太空泛。最好把系統的高風險區說清楚,例如庫存不能小於零、折扣不能重複套用、同一付款請求必須具備 idempotency,或登入失敗五次後帳號會暫時鎖定。
驗證規則與斷言
測試最重要的不是操作步驟,而是什麼證據足以判定通過。只要求模型「完成登入」通常會得到 click sequence;要求它驗證 URL、頁面標題、session cookie 與 API response,才會得到更接近產品行為的 assertion。
斷言也不能只追求數量。大量檢查不等於高訊號,反而可能讓測試因無關 UI 文字變動而頻繁失敗。好的 Prompt 應指出「哪個結果代表商業行為成立」,再補必要的技術證據。
032. 從一句指令,改成可審查的測試任務
原文用登入流程對比模糊 Prompt 與 context-rich Prompt。這個差異可以再往前推一步:不要只把 Prompt 當成聊天內容,而要把它寫成團隊可以 review 的任務規格。
角色
你是熟悉本 repository 測試慣例的 QA automation engineer。

目標
為登入成功流程新增 Playwright end-to-end test。

已知脈絡
- 登入頁:/login
- Dashboard:/dashboard
- Email 欄位可由 label「Email」定位
- 登入成功後會顯示 heading「Welcome Back」
- 使用既有 authenticatedUser fixture,不建立新的帳號

限制
- TypeScript + @playwright/test
- 優先使用 getByRole / getByLabel
- 不使用 waitForTimeout
- 不修改 production code

驗證
- 導航至 /dashboard
- Welcome Back heading 可見
- 登入 API 回傳 200

輸出
先列出測試設計與假設,再提供完整測試檔案 diff。
若缺少 selector、fixture 或商業規則,停止並列出問題,不要自行虛構。
最後一句很重要。可靠的 QA Agent 不應該在資訊不足時「盡力猜」,而應該把未知項目變成明確問題。這會讓 AI 從程式碼自動完成器,變成能暴露需求缺口的協作者。
團隊也可以要求模型先產生 test matrix,再決定哪些案例值得自動化。這能避免一開始就生成大量重複、低價值或過度耦合的腳本。
先產生測試設計,再產生測試碼。把「想測什麼」和「怎麼實作」拆開,通常比一次要求完整腳本更容易審查,也更容易發現需求缺口。
043. Synthetic test data 的價值,在於表達真實狀態
原文另一個重點是 synthetic test data。AI 的優勢不只是快速生成 100 筆 user JSON,而是可以依照情境組合出平常不容易手動準備的狀態。
例如,與其要求「生成 50 個使用者」,不如描述:
- 註冊後尚未驗證 email 的帳號。
- 套用折扣後放棄購物車的顧客。
- 連續付款失敗兩次,第三次成功的使用者。
- 訂閱週期中途從 premium 降級為 basic 的帳號。
- 因多次登入失敗而被鎖定的帳號。
這些資料比較接近系統真正會壞掉的地方。但生成資料仍必須服從 schema 與 business rules,否則只會得到看似多樣、實際無法進入測試環境的 JSON。
一個較完整的資料 Prompt 應包含:
- 欄位 schema 與型別。
- 唯一性、範圍、關聯與狀態轉移規則。
- 正常、邊界與無效資料的比例。
- 是否需要固定 seed,讓失敗可以重現。
- PII、production data 與敏感欄位的禁止事項。
生成後也不應直接使用。先以 Zod、JSON Schema、database constraint 或 domain validator 檢查,再把通過的資料送進測試。AI 負責提出變化,程式化驗證器負責守住確定性。
054. Prompt 要像測試程式一樣版本化
原文建議迭代 Prompt,這件事如果要在團隊規模下成立,就不能只存在某個人的聊天紀錄。Prompt 應該和測試 helper、fixture 一樣進入版本控制。
一個基本做法是替常見任務建立模板:
- 從 user story 產生 test matrix。
- 從 OpenAPI schema 產生 API negative tests。
- 從 UI 元件產生 accessibility checks。
- 分析 flaky test 的可能原因。
- 依照 code diff 建議 regression scope。
每個模板都應記錄輸入契約、輸出格式、禁止行為、範例與已知失敗模式。當模型反覆產生 raw CSS selector,就在模板裡禁止;當它常忽略資料清理,就加入 fixture teardown 規則。
更重要的是,要用真實執行結果回饋 Prompt,而不是只看生成內容是否「看起來合理」。合理的迴路是:
- Generate:依照 Prompt 產生 test design 或 code。
- Execute:在隔離環境執行 lint、typecheck 與目標測試。
- Review:檢查測試是否因正確理由通過或失敗。
- Refine:把失敗模式修回 Prompt、fixture 或產品規格。
這樣 Prompt engineering 才不只是一次性的文字技巧,而是 QA 系統的一部分。
065. 三種最常見的失敗:幻覺、假覆蓋與維護爆炸
幻覺 selector 與不存在的流程
模型會補齊它認為「應該存在」的按鈕、錯誤訊息或 API。降低這類錯誤的方法不是一直提醒它不要 hallucinate,而是提供真實 DOM、accessibility tree、route contract,並要求缺資訊就停止。
生成後必須實際執行。沒有跑過的測試碼只是候選答案,不是測試。
測試數量增加,但覆蓋沒有增加
AI 很容易產生大量參數不同、實際驗證同一件事的案例。團隊應追蹤的是需求、風險與 mutation coverage,而不是單純的 test count。
若十支測試都只確認頁面顯示成功訊息,它們可能仍然完全沒有驗證資料是否正確寫入、權限是否生效,或重複請求是否被阻擋。
生成速度超過維護能力
一天生成一千支測試不難,困難的是半年後誰能理解、除錯與刪除它們。Prompt 應限制重複邏輯、要求使用既有 fixtures,並讓每個測試保持清楚的責任。
對 flaky test,也不要讓 AI 無限制加入 retry、sleep 或更長 timeout。這些修改可能只是把 race condition 藏起來。應要求它先分析失敗證據,再區分產品 bug、測試 bug、環境不穩定或資料污染。
076. 人工審查不是過渡方案,而是品質邊界
原文明確提醒,不應把 AI 生成的測試直接推進主分支。這不只是因為模型仍會犯錯,也因為「應該測什麼」本身包含產品風險、商業優先級與組織責任。
人工 reviewer 至少要確認:
- 測試是否對應真實需求或已知風險。
- 斷言是否能證明行為成立,而非只證明畫面有變化。
- 失敗時是否能提供可診斷的訊號。
- 是否重複現有 coverage。
- 測試資料是否隔離、可重現且不含敏感資訊。
- 腳本是否遵守 repository 的 locator、fixture 與等待策略。
資料安全也不能交給 Prompt 自律。不要把 production PII、API key、客戶資料或未授權原始碼送進公開模型。真正的防線應該包含權限、資料遮罩、企業模型政策、log 稽核和可追溯的工具呼叫。
「AI 寫完,而且測試是綠的」不是完成條件。還要確認它測的是正確行為、以正確理由通過,並且在產品真的壞掉時能夠失敗。
087. 從 Prompt library 走向 Quality Agent
原文最後把方向指向 autonomous testing system:Agent 讀取 pull request,辨認功能變動,生成 regression tests、執行它們,並修復因 UI 變更而失效的 selector。
這個方向合理,但真正的 Quality Agent 不應該只是一台自動生測試碼的機器。它需要一套可治理的決策流程:
- 讀取 diff、需求與既有測試,判斷風險範圍。
- 先提出 test plan 與假設,讓人或 policy gate 審核。
- 在隔離分支產生最小變更。
- 執行測試並保留 trace、screenshot、log 與失敗證據。
- 只在證據充分時修正測試,不能為了變綠而降低 assertion。
- 將新的失敗模式回寫到 Prompt template 與團隊規範。
因此,QA 工程師的角色不會因 AI 消失,而會從重複撰寫腳本,往測試策略、風險建模、規格設計、Agent guardrail 與結果審查移動。
最實際的起點也不是立刻打造全自動 Quality Agent。可以先選一條高頻、低風險流程,例如「user story 轉 test matrix」,保存現有人工 baseline,再比較案例品質、遺漏率、執行成功率與維護時間。
Prompt engineering 在軟體測試裡最值得帶走的觀念,是把 Prompt 當成測試系統的輸入契約。當目標、脈絡、限制、邊界與斷言都能被清楚描述,AI 才能穩定放大 QA 能力;若需求本身含糊,模型只會更快地把含糊變成程式碼。
原文來源: Parimal Kumar, “How to Use Prompt Engineering for Effective Software Testing”