010. 先讀|本地模型熱,不等於所有人都該買硬體
TuTulifestyle 這支影片:Qwen3.8 27B大火!實現Token自由?Mac mini實測11個本地模型,表現如何...,表面上是在追 Qwen3.8 27B 的熱度,實際上更像是一個普通重度 AI 使用者在問:本地模型到底到了「可以拿來工作」的階段了嗎?
影片裡最值得保留的不是某一個模型分數,而是那個猶豫感。講者一方面承認,Qwen3.8 27B 讓本地模型的想像重新變大:能力更強、上下文更長、版本更齊、硬體門檻看起來也不像以前那麼遙遠。另一方面,他拿手上的 2024 款 Mac mini 實測 11 個模型後,得到的結論又很克制:能跑,不等於能進入日常;跑得動,不等於值得為它升級整套設備。
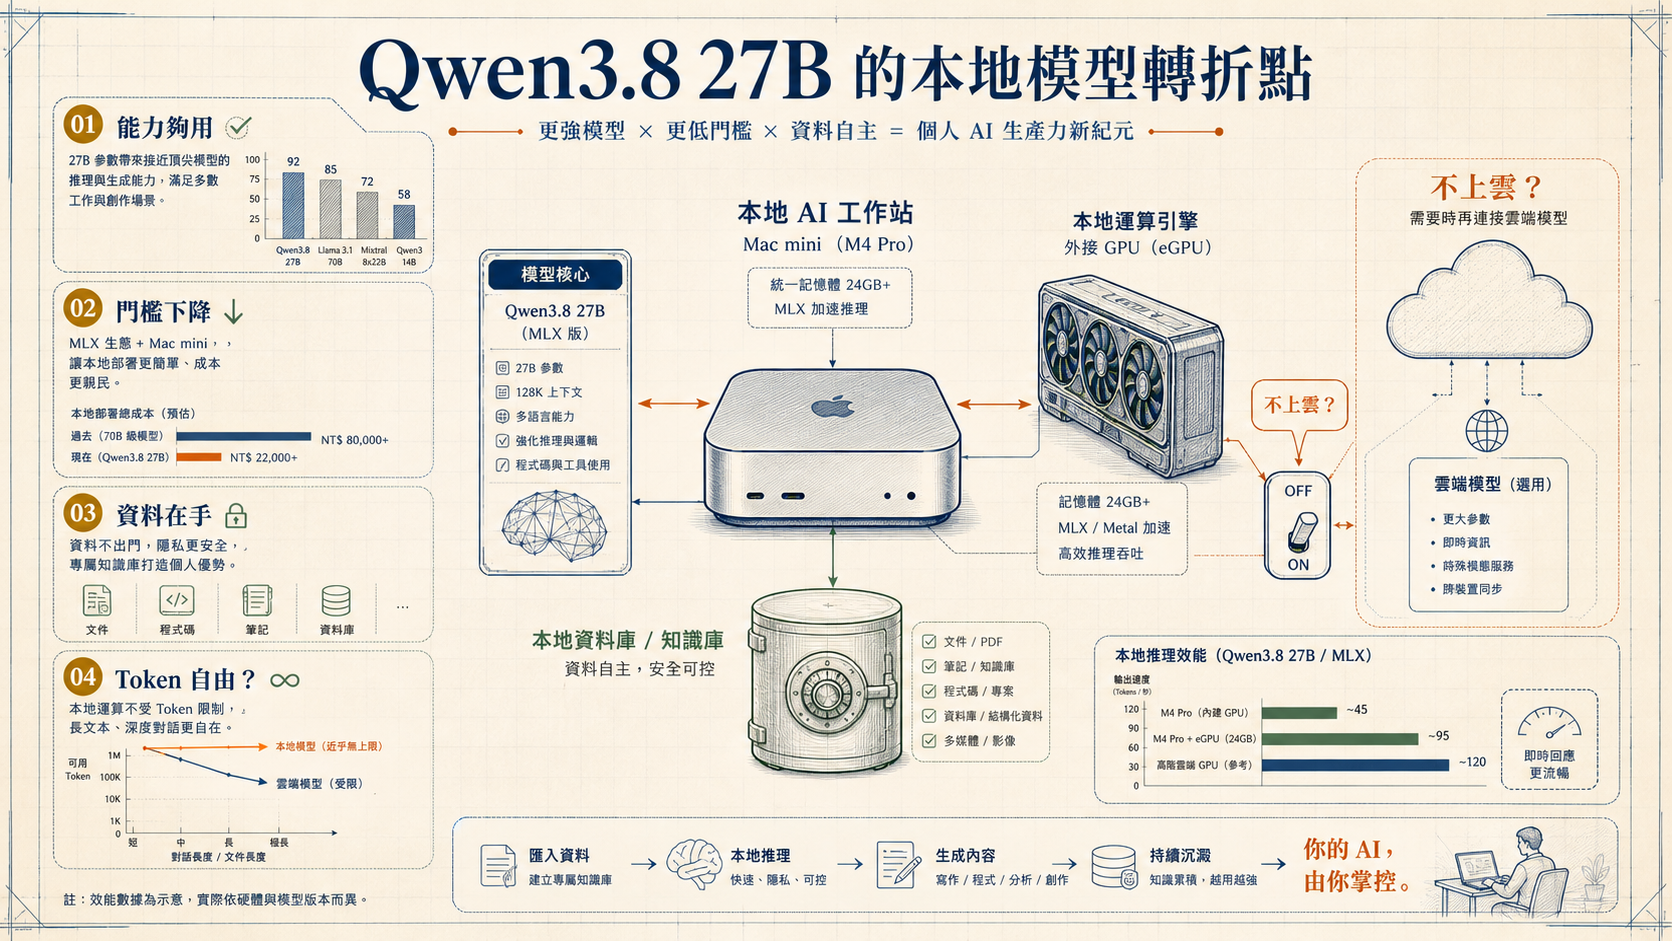
所以這篇導讀不把它整理成「本地模型推薦清單」。更準確地說,它是一篇關於本地 AI 工作流的觀察:當開源模型越來越能用,硬體越來越接近消費級,使用者真正要判斷的是哪些任務應該留在本地、哪些任務仍該交給雲端、以及「Token 自由」這個口號背後到底要付出多少隱性成本。
021. 熱度來源|Qwen3.8 27B 讓本地模型從玩具走向工具
講者開場先拆 Qwen3.8 27B 為什麼突然大火。他的歸納有三層:第一是能力夠用了,第二是家用級設備也開始能碰,第三是開源版本與生態支援來得很快。
他提到,過去很多本地模型的尷尬在於「能跑起來,但幹不了什麼活」。這次 Qwen3.8 27B 被討論,是因為它不再只是展示用的玩具。影片裡引用的說法包括 270 億參數、原生多模態、上下文擴到 100 萬,以及多項測試排名靠前。這些主張仍應視為影片與社群討論中的描述,不等於本文替任何榜單背書;但它們足以解釋為什麼技術圈會興奮:本地模型的敘事,開始從「跑得起」轉向「可能用得上」。
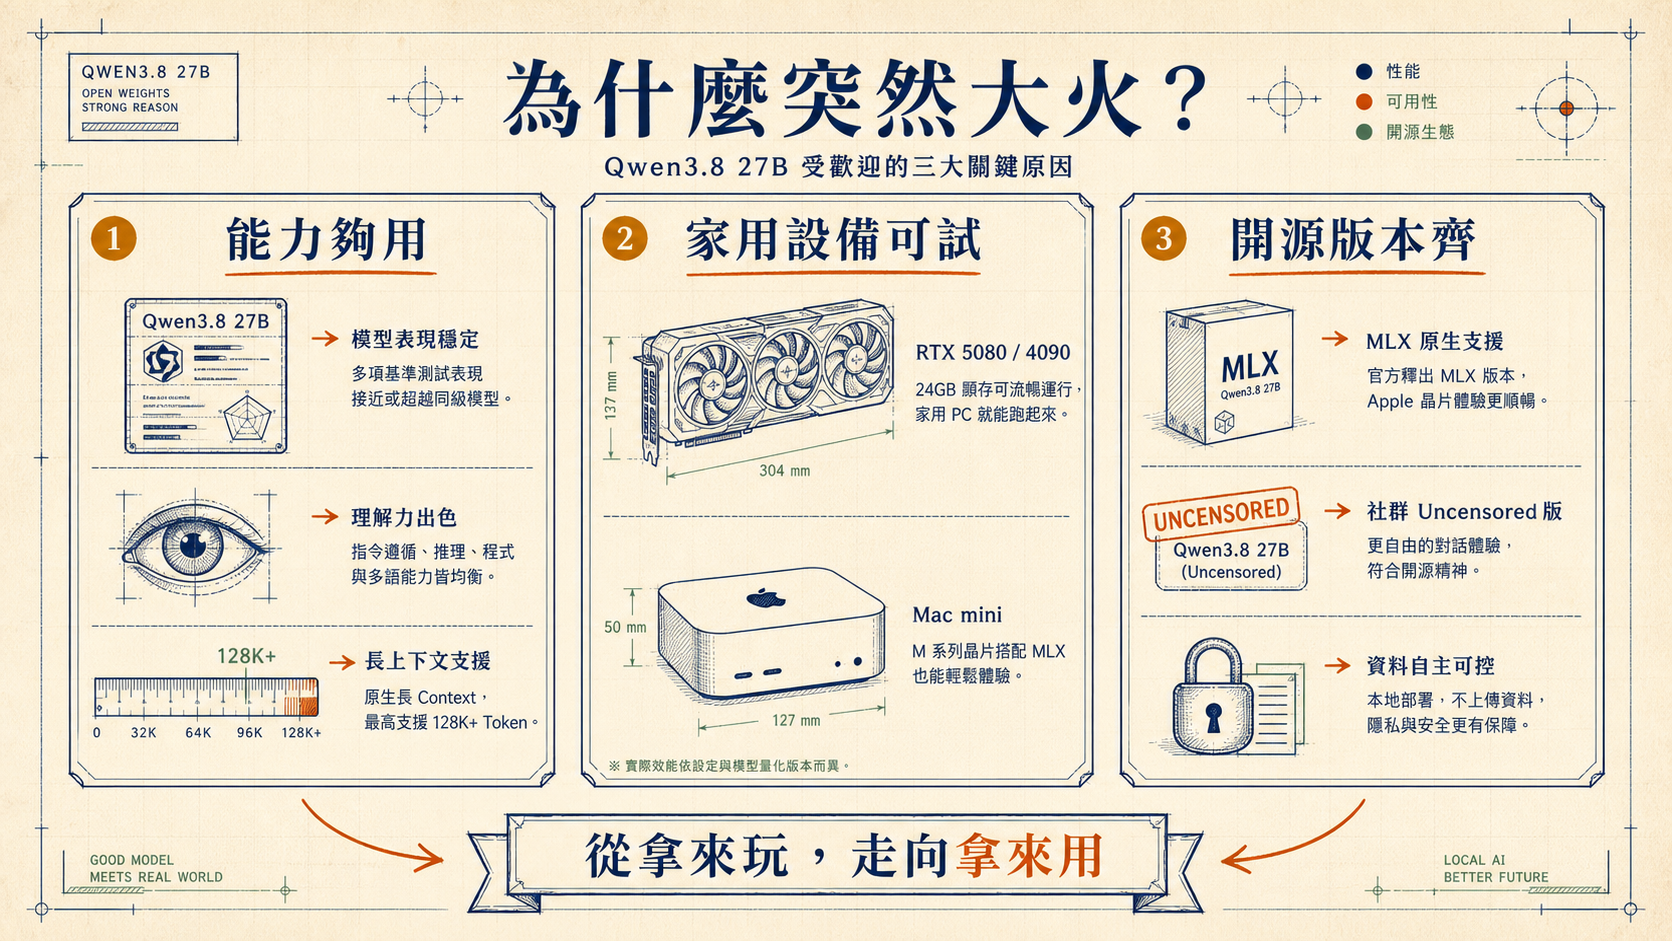
第二個因素是硬體門檻。講者指出,這類模型開始有人在 RTX 5080、4090 等高階家用顯卡上實測,甚至也有針對 Apple 生態優化的 MLX 版本。這不代表普通使用者都能無痛部署,而是門檻從「資料中心或非常昂貴的工作站」往「高階玩家設備」移動了一段。
第三個因素是開源帶來的控制感。影片裡特別提到,本地部署不只是省錢,也代表資料掌握在自己手裡,不用上雲。對很多重度 AI 使用者來說,這甚至比價格更有吸引力。因為真正敏感的,不一定是一次 API 費用,而是個人文件、證件、筆記、語音與工作資料是否要交給外部服務處理。
032. 硬體誘惑|「Token 自由」背後仍是總成本問題
影片中段談到英文技術圈對硬體的討論,尤其是 NVIDIA DGX Spark 這類機器。講者表示,他看到一種流行玩法是買兩台串起來,據說可以跑 Qwen3.8 27B,也夠得著 DeepSeek Flash,於是有人把它稱為接近「Token 自由」的方案。
這裡的數字很有畫面感:影片提到 DGX Spark 一台約 4,699 美金,兩台折合人民幣大約 6–7 萬。這個價格比傳統大型 AI 硬體便宜很多,但對個人使用者仍是一筆非常重的支出。講者開玩笑說,很多人爆買,說明人家有錢;更重要的是,這也顯示硬體與軟體的「黃金交叉點」正在出現。
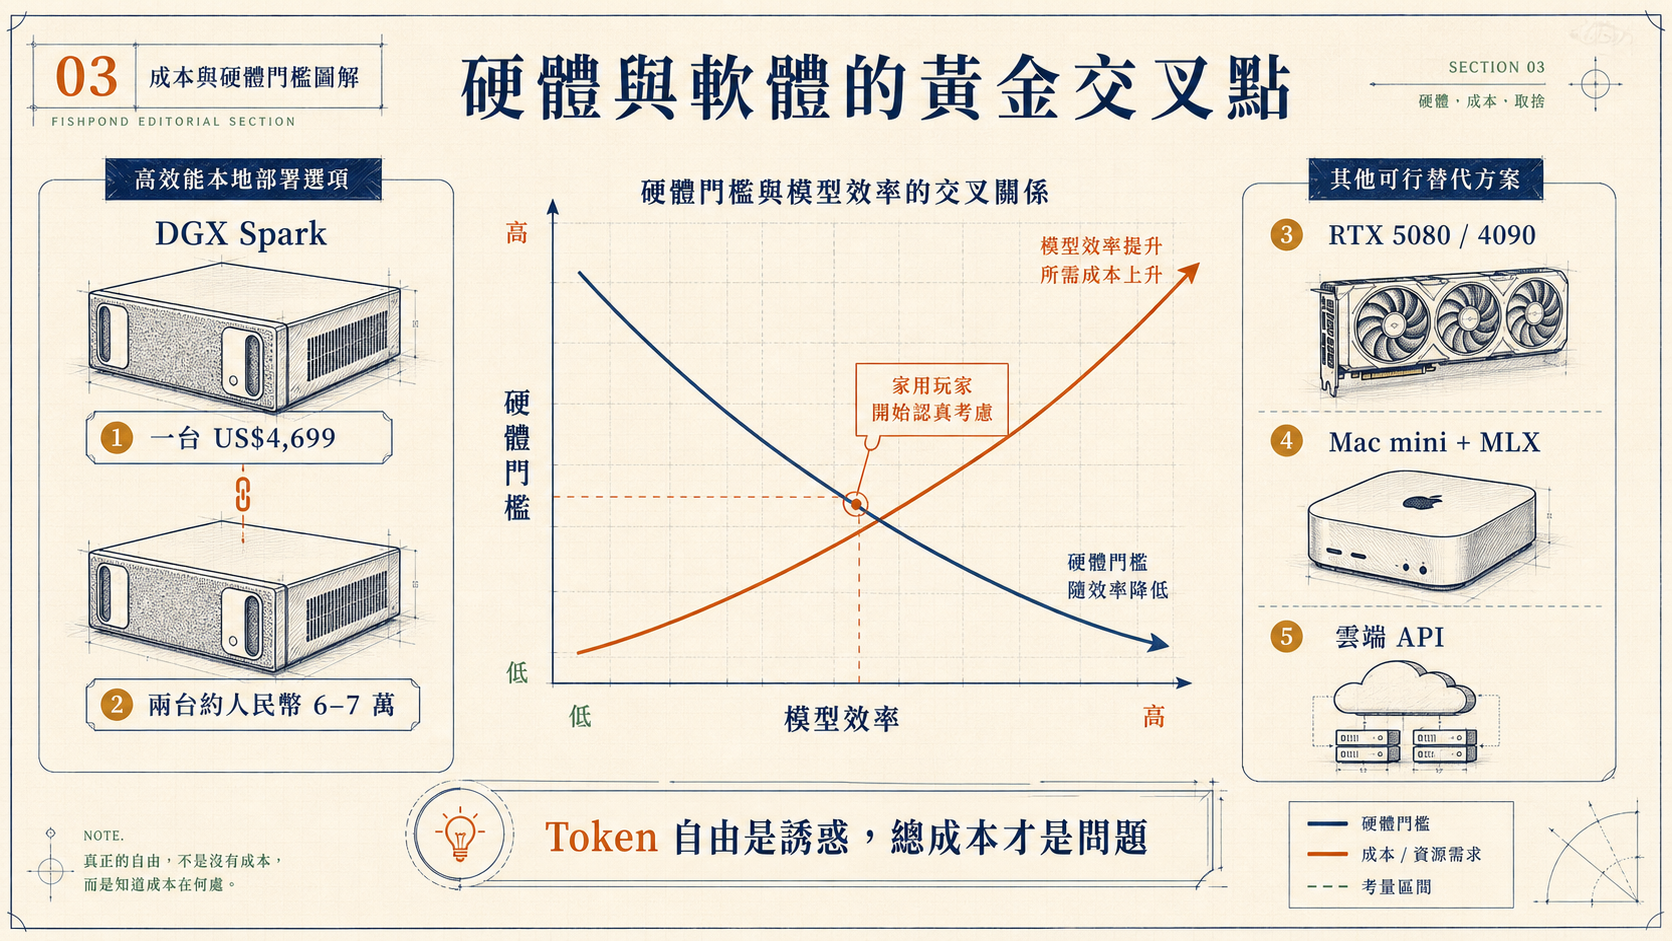
所謂黃金交叉點,是指模型效率提升與硬體可得性開始相遇。過去你可能需要很貴的設備才能跑出可接受的本地模型體驗;現在同樣的預算可以買到更接近實用的能力。這會改變一部分開發者、創作者、研究者的選擇。
但影片也沒有把這件事講成「快去買」。講者自己沒有下單,甚至後面明確說目前沒有硬體升級衝動。這個距離感很重要。因為本地模型的成本不能只看 token 單價,也要看硬體折舊、電力、維護、時間、模型更新速度,以及半年後雲端模型又可能進化到哪裡。
換句話說,Token 自由不是免費。它比較像把原本按次付費的雲端帳單,換成一次性硬體、長期維護和使用情境選擇。對每天大量處理敏感資料的人可能划算;對只是偶爾跑翻譯、摘要、字幕的人,未必是好交易。
043. Mac mini 實測|能載入,不代表能工作
講者手上最好的設備是 2024 款 Mac mini。他讓 AI 幫忙設計測試頁面,挑了自己用過或正在用的 11 個本地模型,分成大、中、小三檔,主要看速度與一些常用指標。這不是嚴格 benchmark,比較像真實使用者的體驗測試。
第一個例子是 Qwen3.6-35B-A3B。影片裡說,它總參數量 350 億,但啟用只有 3B,所以速度很快:加載約 7 秒,生成速度每秒 50 多個 token。講者表示這是他日常主力使用的本地模型之一,適合處理文件類工作。
接著是 DeepSeek 32B。這個測試幾乎直接說明「能跑」的陷阱:模型加載接近 90 秒,簡單打招呼都等了十多分鐘。原因之一是它是稠密模型,對這台 Mac mini 造成明顯記憶體壓力。這種情況下,後續能力再強也不太重要,因為互動體驗已經失去實用性。
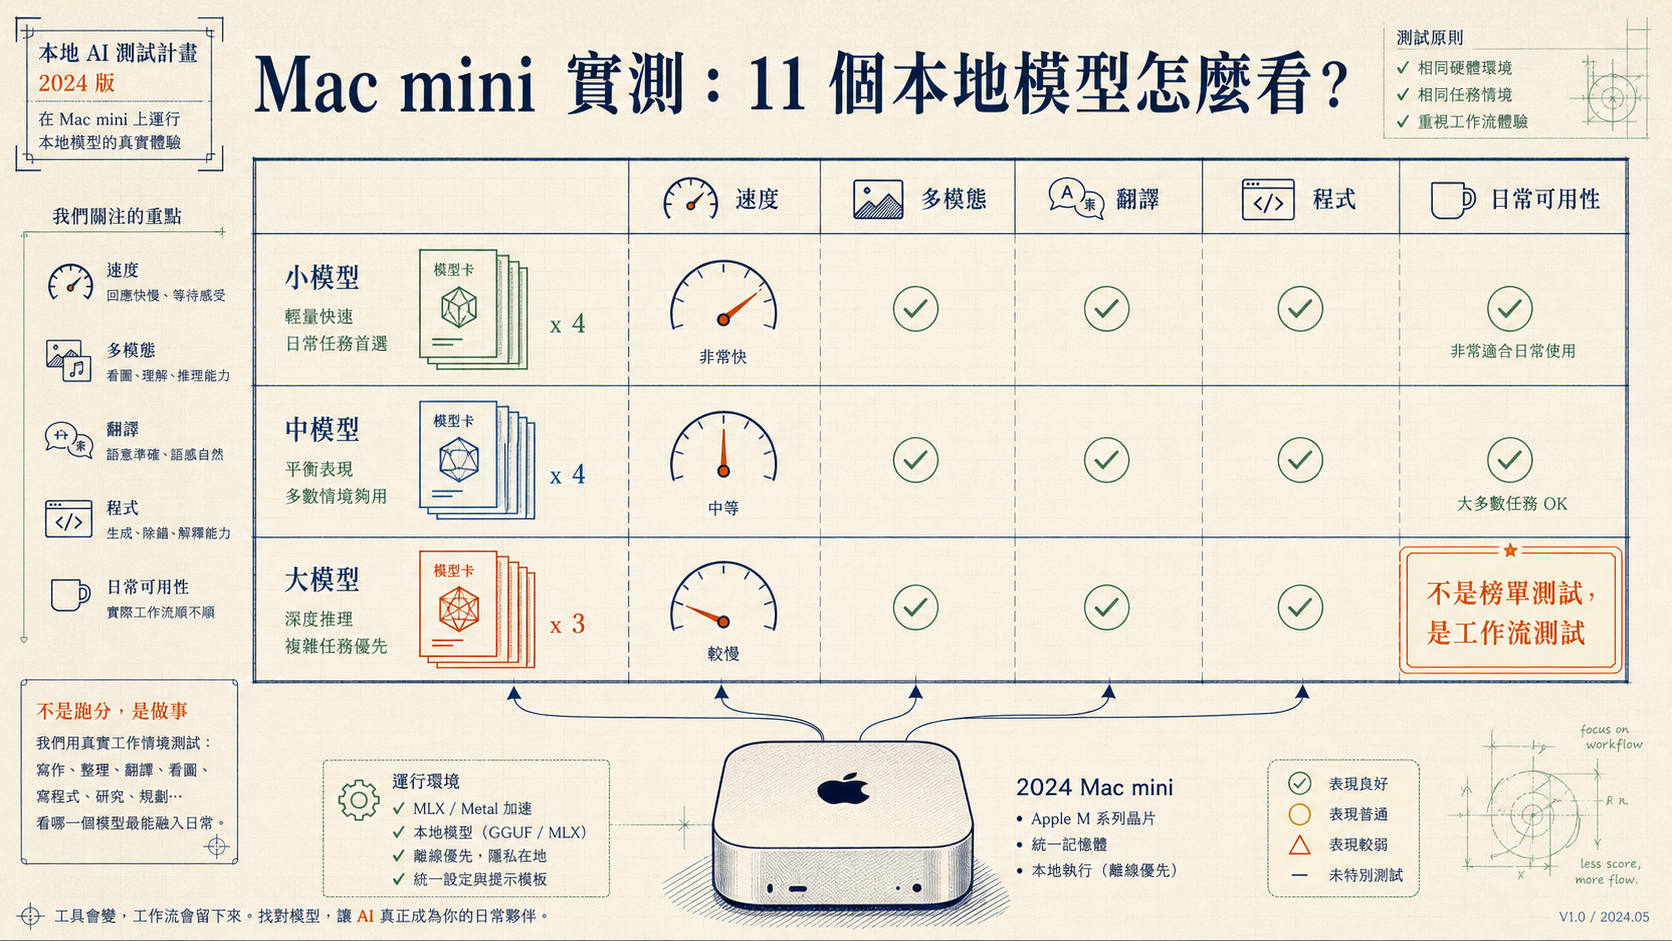
Qwen3.8 27B 則測了幾個不同版本。影片裡的觀察是,有的版本加載接近 7 秒但生成不到每秒 10 個 token;另一個版本加載約 5 秒、生成約每秒 15 個 token;還有 MLX 相關版本約每秒 6 個 token。這些速度對短句問答可以忍,但如果是大段內容生成、長文整理、程式協作,就會明顯覺得卡。
反過來,小模型與專用模型的體驗更穩。講者提到 Google 的 Gemma 類模型加載約 11 秒,但跑起來可到每秒六七十個 token;Microsoft Phi 3.8B 這類小模型約每秒 80 多個 token;混元 MT 7B 翻譯模型約每秒 40 個 token,速度與品質平衡不錯;混元 1.8B 更快,適合短句翻譯或放進 Bob 這類翻譯工具。
這段測試的真正結論不是「哪個模型贏了」,而是任務要對位。大模型承載通用推理與長內容,但硬體壓力大;小模型不適合假裝成全能助手,卻可能在翻譯、短句、固定格式處理上非常好用。本地模型的價值,不在於單一模型取代雲端,而在於把可重複、低風險、資料敏感的任務拆出來。
054. 使用情境|本地模型最適合處理邊緣但敏感的工作
影片後段的語氣變得更務實。講者說,這台設備跑有些模型還是吃力,即便是優化版本也一樣;能跑並不意味著可以投入實際使用。他用遊戲比喻:如果畫質很低、掉幀嚴重,就算遊戲打開了,也談不上體驗。
這句話很適合拿來校準本地模型熱潮。很多 demo 會展示模型成功回答了一題、成功產出了一段文字,但日常工作流需要的是穩定、夠快、可預期。當生成速度慢到使用者不想等,或模型一遇到稍複雜任務就卡住,這套本地方案就只剩心理上的自由,沒有真正提高生產力。
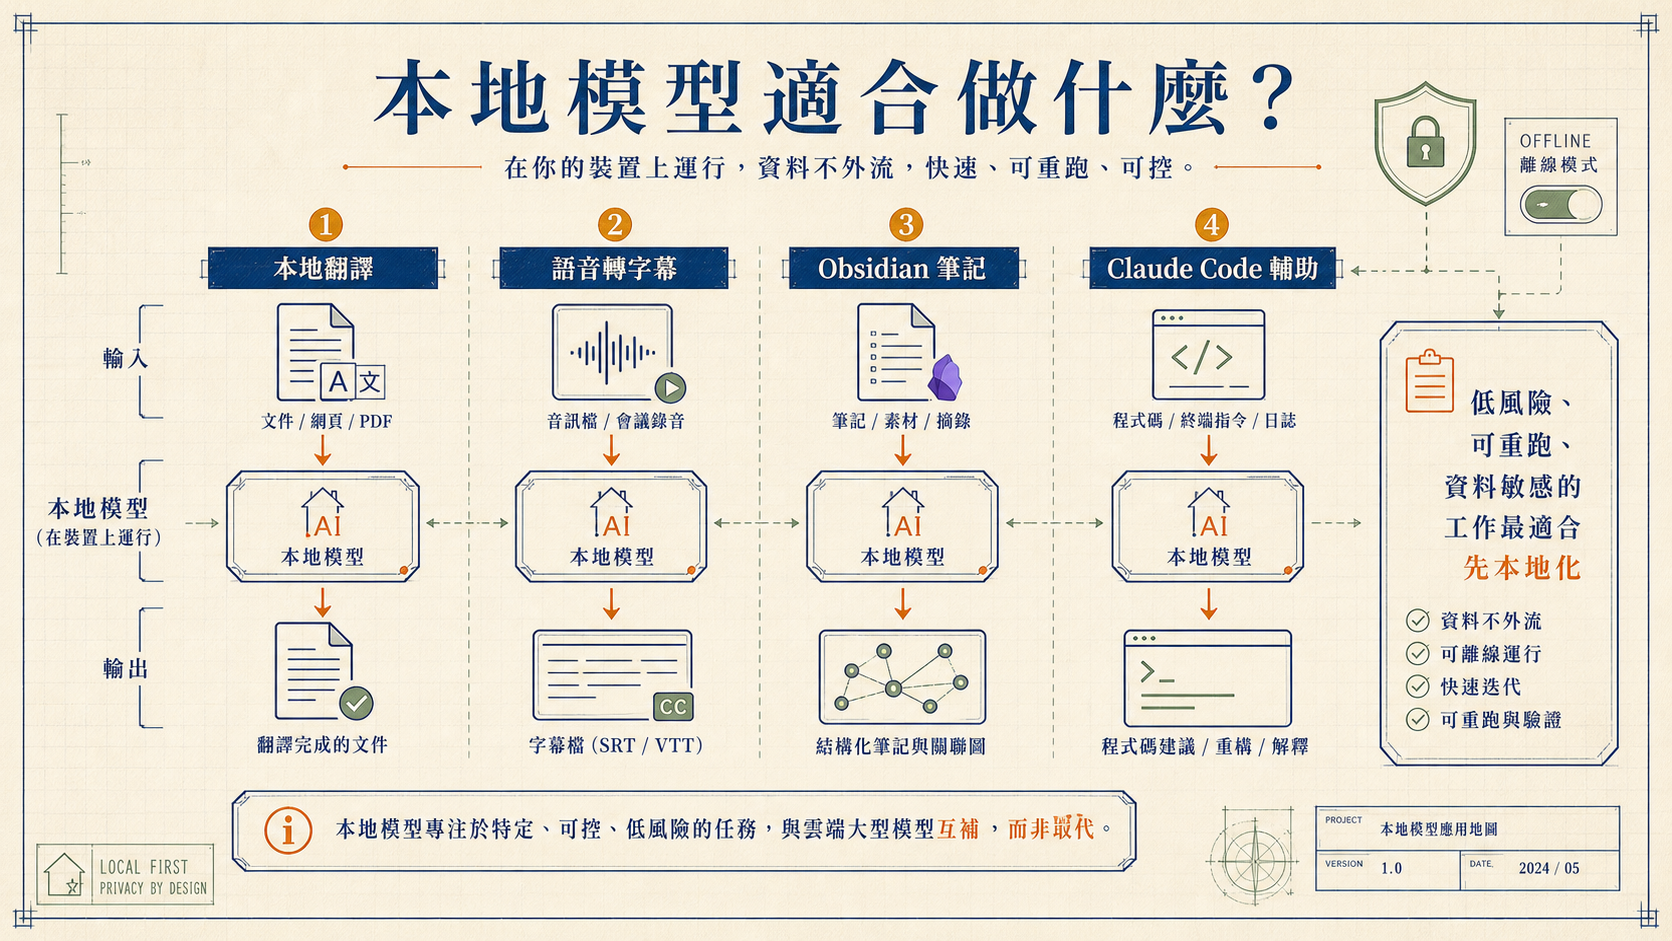
不過,講者也沒有否定本地模型。他提到自己已經用本地模型做過本地翻譯、語音轉字幕,也測了翻譯模型和語音模型。這些任務的特點是明確、可重跑、輸入輸出容易檢查,而且常常牽涉個人資料或大量零碎內容。它們不一定需要最強的雲端模型,卻很需要低成本、低摩擦、資料留在本機。
更有意思的是他的折中方案:當他用雲端 Claude 整理個人資料時,例如舊文件或證件,需要 OCR、Markdown 整理、存入 Obsidian,他會讓雲端主模型負責指揮,核心內容則交給本地模型處理與落地。這樣一來,可以兼具主模型的聰明與敏感內容不上雲。
這其實是一種很合理的 hybrid AI 架構:雲端模型負責規劃、理解意圖、拆任務;本地模型負責接觸敏感資料、做格式轉換、處理固定流程。它不是把所有東西都搬回本地,也不是把所有資料都丟上雲,而是依照任務風險與模型能力分工。
065. 編輯判斷|本地不是信仰,是工作流選項
這支影片最後的態度很清楚:真正意義上的離線模型自由,講者還想觀望。他回想兩年前有人花十多萬買一堆機器搭建離線模型環境,但現在看來那些設備可能還不如幾台 Spark。再加上雲端模型升級速度非常快,半年之後會發生什麼,很難預測。
這也是本地 AI 投資最麻煩的地方。硬體是慢資產,模型是快變量。你今天為某個 27B 模型買的設備,半年後可能因為模型壓縮、推理框架、雲端價格或新模型能力改變而重新洗牌。對個人使用者來說,衝動升級硬體的風險不小。
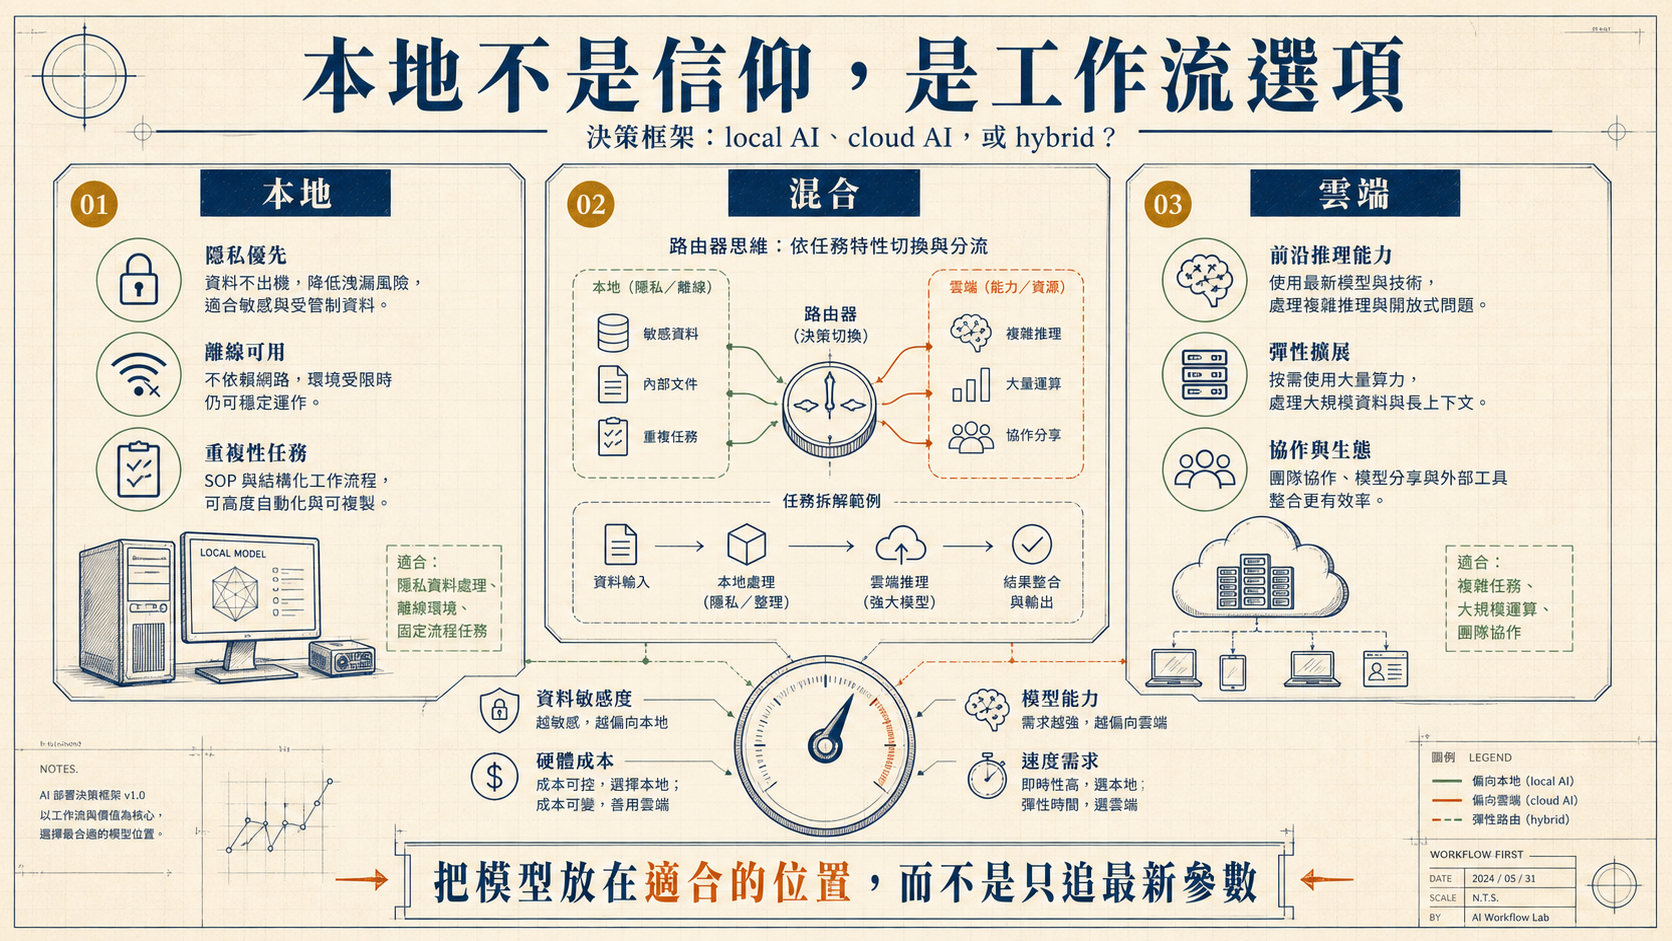
比較穩的思路,是把本地模型當成工作流選項,而不是身份認同。當資料敏感、任務固定、品質容易檢查、速度要求可控,本地模型很值得放進工具箱。當任務需要最強推理、長期維護、團隊協作、最新能力,雲端模型仍然更合理。介於兩者之間的,就是影片裡提到的折中方案:雲端負責聰明,本地負責隱私與落地。
所以,Qwen3.8 27B 的熱度真正帶來的,不只是某個模型紅了,而是讓更多人開始重新計算「本地 AI」的邊界。過去本地模型太弱,討論常常停在玩票;現在能力接近可用,問題就變成工程與產品判斷:什麼值得本地化?什麼不值得?哪個環節需要 Token 自由,哪個環節其實只需要可靠的雲端模型?
對魚塘讀者來說,這篇導讀的結論是:先別急著把「不上雲」當成終點。更值得做的是列出自己的 AI 工作流,把任務依照資料敏感度、模型能力需求、速度、成本、可驗證性拆開。當你能說清楚某個任務為什麼應該在本地跑,再去買硬體、挑模型、接 MLX 或 Ollama,才比較不會把技術熱度誤認成自己的真需求。