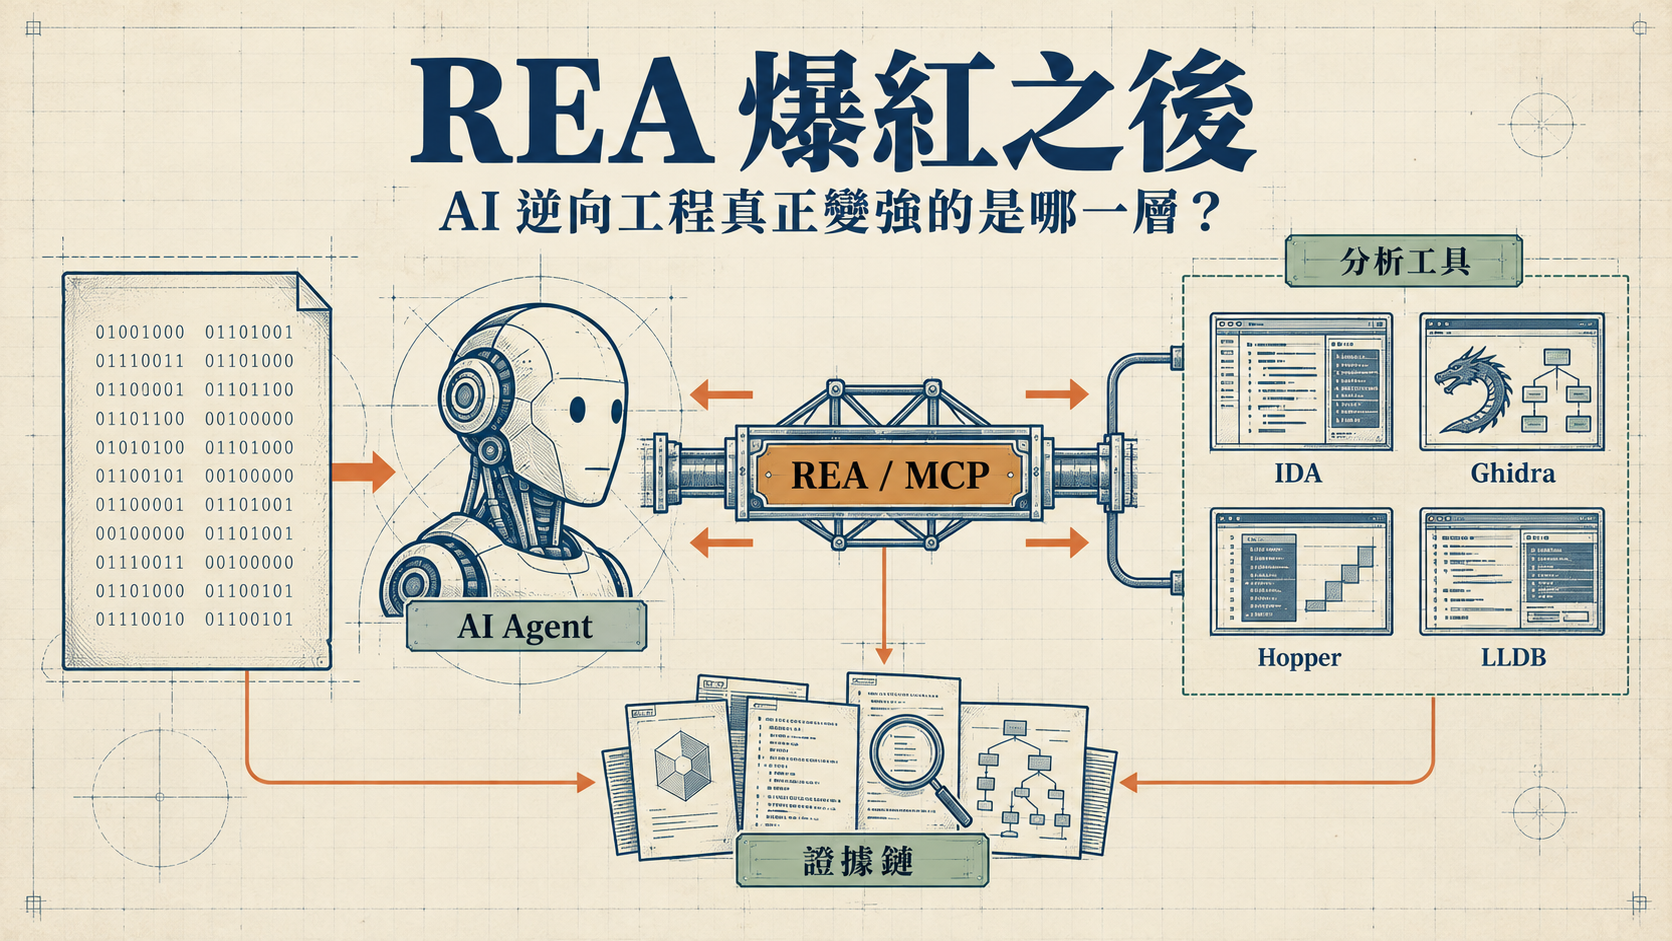
010. 導言|「逆向一切」到底逆向了什麼?
「真正變強的不是某一把新工具,而是 agent 把多把工具串成了可驗證的行動鏈。」
Reverse Engineer Anything。只看名稱,REA 幾乎像是一句對既有軟體防線的挑釁:任何二進位檔、任何封裝、任何功能,只要交給 AI,就能被一路拆解到底。當這類專案突然爆紅,最容易擴散的自然也是最戲劇化的說法——「軟體產業的天塌了」。但若要判斷一套技術究竟改變了什麼,第一步不是接受口號,而是把口號裡被摺疊的能力重新拆開。
這篇文章整理的來源,是「軒轅的編程宇宙」發布的 YouTube 影片〈逆向一切的 REA,到底是個啥?是真的厲害還是又一場流量狂歡?〉。影片以一系列自製樣本進行探索性測試,從簡單的密碼校驗、加密與執行期解密,一路加上 UPX、VMP 保護,再進一步要求 agent 重建一個帶有隱藏彩蛋的 2048 小遊戲。講者表示,這些樣本不是正式商業產品,而是由 Codex 生成後,再交給 DeepSeek Harness、REA 與 IDA 等工具組合分析。
這個選擇既是法律與平台風險的避讓,也是閱讀整支影片時不能忘記的研究邊界。影片展示的是同一位操作者、同一套主機環境與一批自製樣本上的案例,不是有控制組、可重複驗證的標準化 benchmark。輪次之間也不是完全隔離:agent 可能利用先前摸清的演算法,甚至找到留在電腦裡的舊原始碼與舊樣本。因此,文中所有時間、工具數量與成敗,都只能寫成「影片記錄」或「講者表示」;它們不能直接外推成 REA、某個模型,乃至所有 AI agent 的普遍性能。
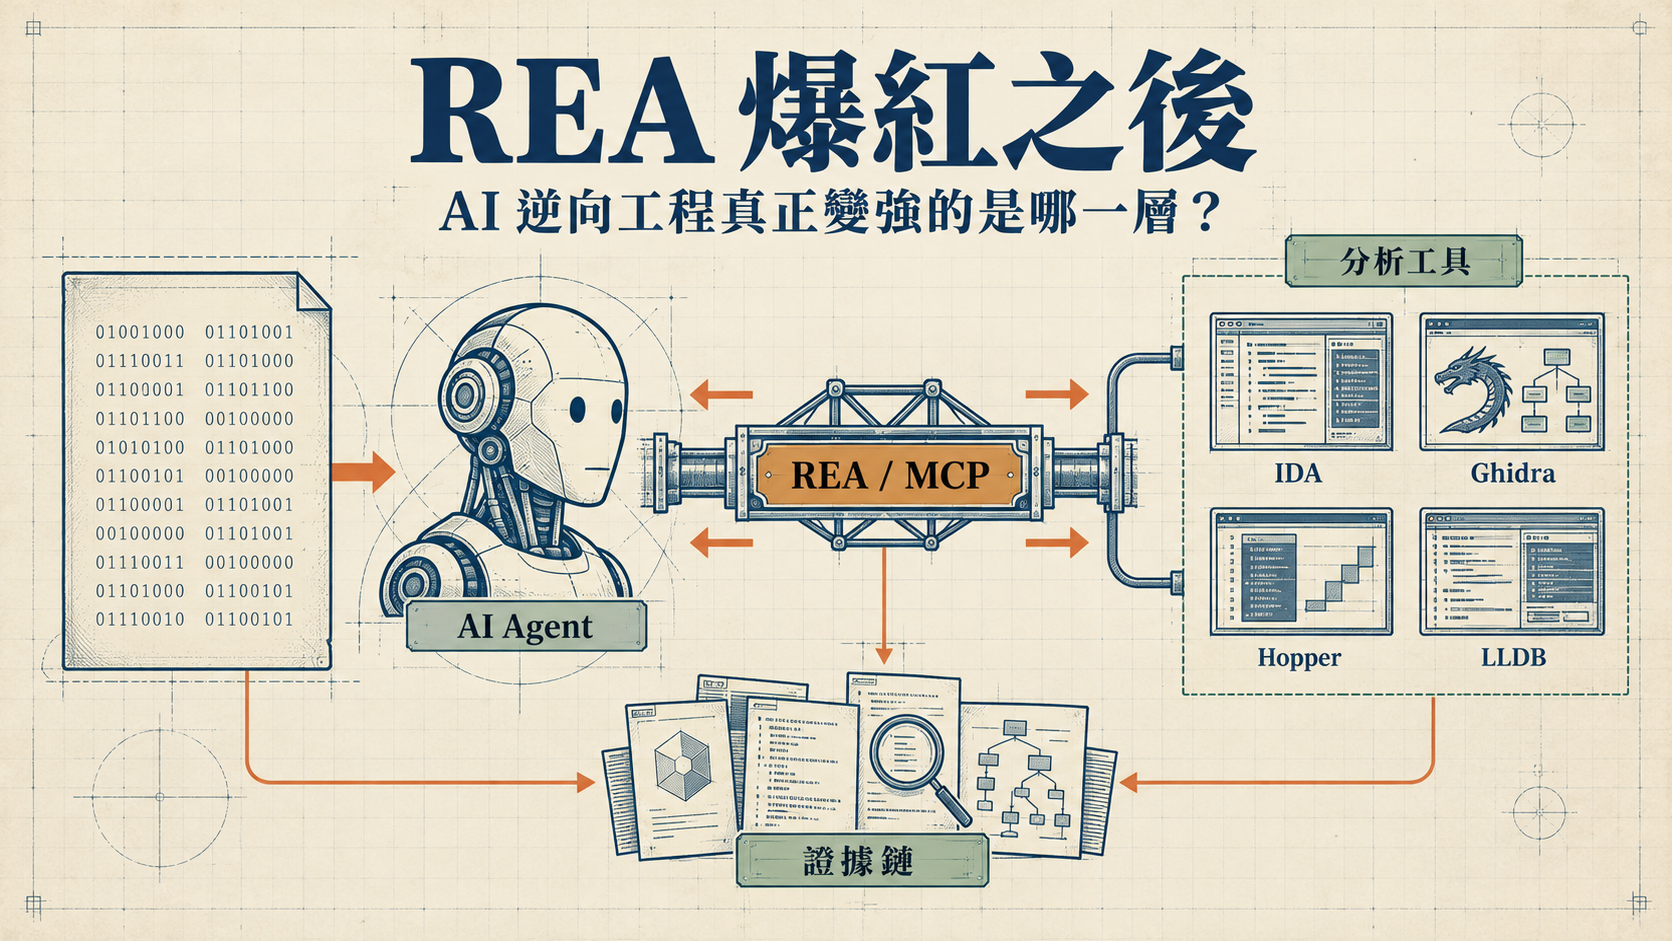
口號把四種能力壓成了一個名字
「REA 很強」這句話,至少可能同時指向四件不同的事。
第一,是模型本身的推理與規劃能力。它能否從反編譯結果裡定位輸入、校驗與資料流?能否辨認演算法、產生還原腳本,並在結果不對時修改假設?這是 agent 的認知核心。
第二,是 IDA、LLDB、Wine 等既有工具與環境所提供的可觀測性。沒有反編譯器、偵錯器、程序記憶體與可執行環境,模型再會推理,也拿不到足以推進分析的材料。影片後段最令人印象深刻的片段,恰恰不是某個模型「憑空看懂」VMP,而是它在一條路走不通後,轉向能讓樣本執行、能讀取記憶體、能再次驗證的替代路線。
第三,是 REA 所提供的統一介面、流程提示與證據整理。它把逆向分析裡常見的操作包裝成 agent 能呼叫的工具,協助模型在不同分析軟體之間工作,也把結果與來源組織成可追蹤的上下文。這不是新的反編譯演算法,卻可能降低 agent 使用既有能力的摩擦。
第四,是主機上原本就存在的資料與條件。舊程式碼、歷史樣本、編譯工具、可下載的執行環境,都可能成為任務的一部分。若 agent 的目標只是「找到密碼」,它利用這些材料或許算完成任務;但若評測題目被敘述成「正面破解 VMP」,相同結果便不能成立。任務完成與技術突破,必須分開記帳。
這四層一旦混在一起,REA 就會被描述成一個無所不能的黑盒;拆開之後,真正的新變化反而更清楚:AI 不再只回答「這段程式可能在做什麼」,而是開始有能力操作工具、收集證據、修改路徑、執行腳本,再把候選答案放回原程式驗證。逆向工程仍然依賴既有分析技術,但「誰來編排這些技術」正在改變。
八輪測試測到的,不只是破解難度
影片的敘事從快到慢:前幾輪以分鐘為單位完成,接著在 UPX 與 VMP 階段逐漸拉長,最後碰到虛擬化保護時停止。若只看結果,這像是一張單純的難度曲線;但更重要的,是每輪其實測到不同能力。
基礎混淆測的是 agent 能否讀懂反編譯結果與資料變換;加密校驗測的是它能否釐清金鑰、分塊與串接;執行期解密測的是它能否從外層邏輯重現解密流程;UPX 測的是它找工具、補環境與交叉驗證的能力;VMP 兩輪則迫使我們區分「繞路拿到答案」與「理解保護機制」;2048 的重建實驗,又把問題從取得秘密移到理解產品行為。
這也說明了為什麼本文不會把後續章節寫成破解教學。影片真正值得討論的是工作流、能力歸因、評測設計與軟體商業模式的壓力,而不是可直接挪用的繞授權步驟。逆向工程有合法且必要的用途,包括自有軟體分析、獲得授權的安全研究、互通性工程、惡意程式分析與數位鑑識;同一套能力也可能被濫用。工具越能自動完成操作,授權範圍、資料來源與研究目的就越需要在任務開始前說清楚。
因此,閱讀這支影片最有價值的方式,不是追問「AI 到底能不能逆向一切」,而是改問三個更精確的問題:哪一段能力來自模型?哪一段來自 REA 與 MCP 的編排?哪一段其實是成熟分析工具和環境早已能做到,只是現在換成 agent 來操作?接下來的章節,將先從 REA 在整套技術棧裡的位置開始。
💡 給讀者的 Takeaway
- REA 的爆紅口號不能直接當成能力結論;模型、編排層、分析工具與主機環境必須分開歸因。
- 影片是自製樣本上的探索性案例,不是有控制組的 benchmark;所有時間與成敗只能視為影片記錄。
- 「完成找出密碼的任務」與「正面破解某種保護」不是同一件事,評測敘事必須忠實描述實際路徑。
- 本文只討論合法授權研究、自有軟體與互通性情境,不提供可直接濫用的破解步驟。
021. REA 的位置|它是編排層,不是新反編譯器
「REA 的價值不在取代 IDA,而在讓 agent 知道何時該用哪個工具、如何保留證據,以及怎麼繼續往下走。」
要理解 REA,最重要的一句話其實出現在影片很前面:REA 本身不提供底層分析能力。依講者的介紹,它位於 AI agent 與 IDA、Ghidra、Hopper 等逆向分析軟體之間,透過 MCP 提供統一的工具介面,再透過 skill 指導 agent 組織分析流程、辨認不同類型的目標,並整理分析結果與證據出處。
換句話說,REA 不是一個突然發明出全新反編譯技術的引擎,而更像一個面向 agent 的編排層。過去由研究者在 IDA 裡搜尋字串、查看組合語言、反編譯函式、追蹤交叉引用,再把發現記在腦中或筆記裡;在影片展示的工作流中,這些動作被包裝成 agent 可呼叫的工具。模型接收任務後,可以要求工具回傳觀察結果,根據結果決定下一步,再把多輪輸出串成一條分析鏈。
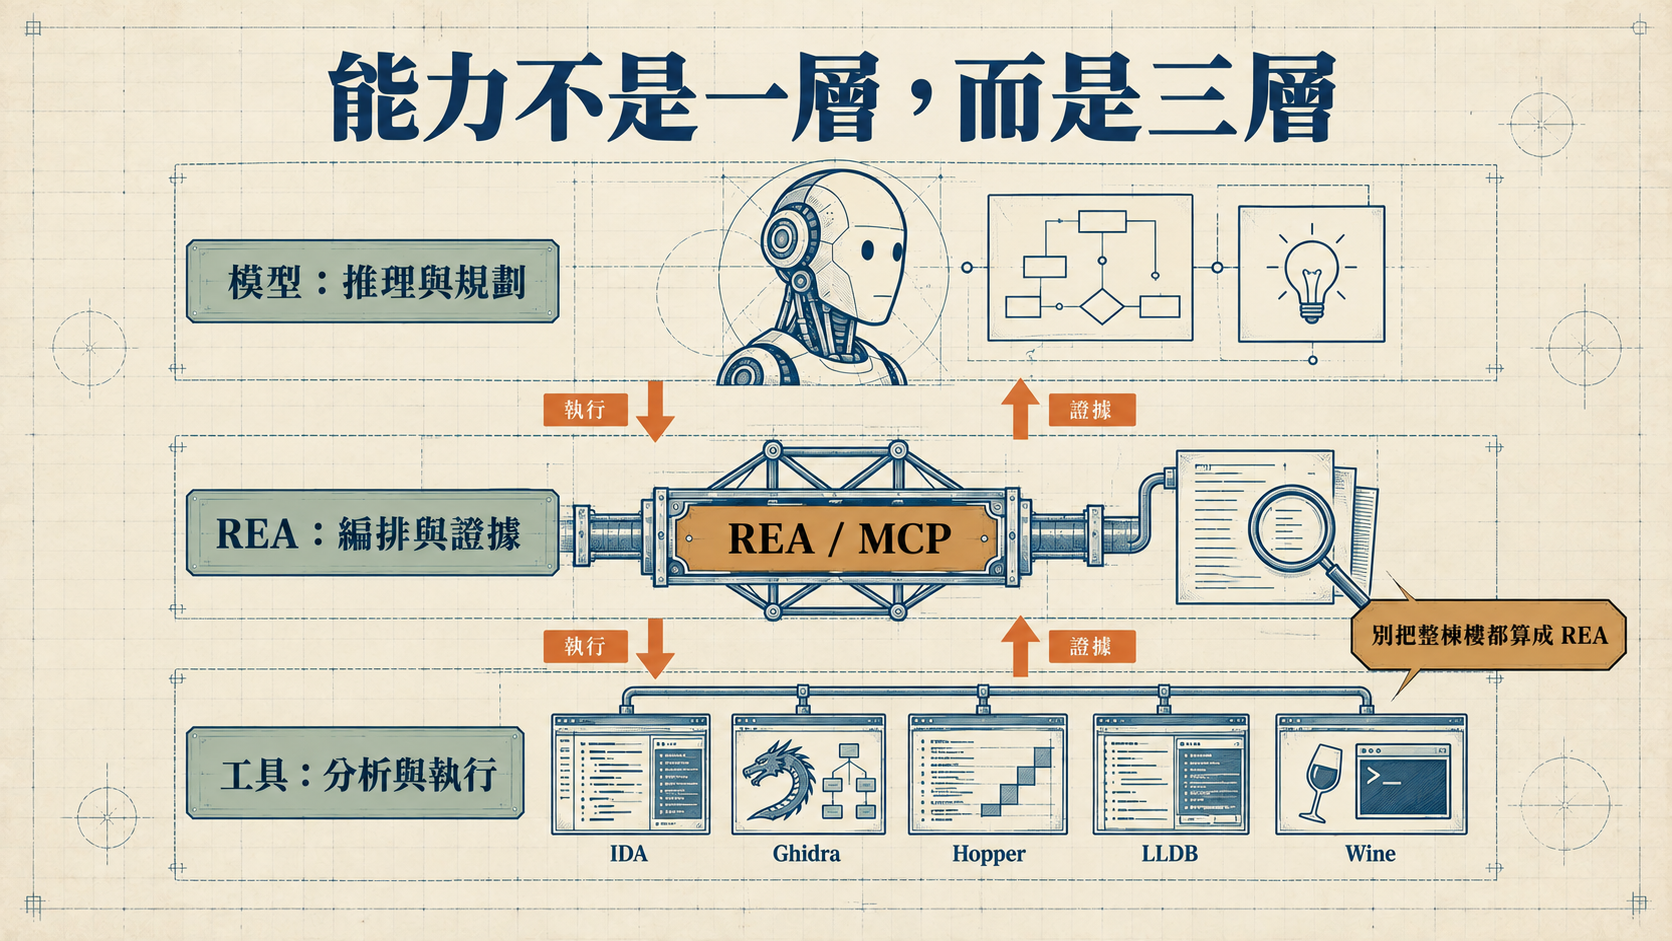
第一層:模型負責提出假設與安排下一步
最上層是 AI agent。它的責任不是直接讀取二進位檔裡的每一個位元組,而是把任務拆成可執行問題:入口在哪裡?輸入流向哪個函式?哪段資料可能是常量、密文或狀態?現有證據支持哪種演算法?候選結果要如何驗證?
影片前四輪所呈現的連續動作,包括定位函式、閱讀偽程式碼、抽取常量、撰寫腳本與回到原程式驗證,主要展現的就是這一層能力。REA 可以提供流程提示與操作入口,卻不等於它完成了推理。影片結尾,講者也明確把多數能力歸因於 AI 模型與 IDA,並表示即使移除 REA、直接用 MCP 讓 agent 對接 IDA,他認為前面多數測試仍可能完成。這是講者的判斷,影片沒有提供同模型、同樣本、同環境下「有 REA」與「無 REA」的控制組,因此兩者的實際差異仍未驗證。
這個未驗證之處很重要。若沒有控制組,我們只能確認影片展示的組合能完成哪些案例,不能量化 REA 帶來多少成功率、速度或穩定性提升。它可能節省大量提示設計與工具接線成本,也可能在某些任務上只是讓既有能力更容易被叫用;兩種可能性都合理,但不能由單一案例直接定論。
第二層:REA 與 MCP 把能力變成可調用的介面
中間層才是 REA 的主要舞台。MCP 可以把外部系統的操作能力暴露給 agent;依影片描述,REA 進一步把逆向分析的常見操作整理成統一工具,處理不同分析軟體的連線與適配,再用 skill 告訴 agent 一套較有結構的工作方式。
「統一」的價值不在於讓所有底層工具變得相同,而在於降低 agent 反覆理解各種介面與輸出格式的成本。IDA、Ghidra、Hopper 各自有不同的操作模型與能力邊界,若每次任務都從零建立連線、命名操作、解釋輸出,模型會把許多上下文消耗在工具協調上。REA 嘗試提供一層共同語彙,讓 agent 能把注意力集中在「下一個問題是什麼」。
影片記錄,安裝後 DeepSeek Harness 看見的 MCP 工具增加到 100 多個,工具描述占用 100K 以上 tokens。這組數字只能視為講者當時環境的觀察,不是 REA 在所有版本與配置下的固定規格,也未驗證其對成功率的淨影響。大量工具一方面擴大可操作範圍,另一方面也帶來工具選擇、上下文成本與誤用風險;「工具更多」不必然等於「答案更好」。真正有價值的是 agent 能否在正確時機選到足夠的工具,並把中間證據壓縮成後續可用的狀態。
第三層:IDA 與執行環境提供真正可觀察的材料
最底層是成熟的分析工具與作業環境。反編譯結果不是 REA 憑空產生,程序記憶體也不是模型自行想像。IDA、Ghidra、Hopper、LLDB,以及樣本可執行的系統環境,才提供函式、控制流、資料區段與執行期狀態等可觀察材料。
影片中的安裝過程正好顯示這項依賴。講者表示,REA 安裝時預設嘗試安裝 Hopper 的反編譯引擎,但沒有成功,最後仍使用自己熟悉的 IDA;要讓 REA 與 IDA 連線、再讓 agent 與 REA 連線,也需要額外配置。影片裡這些配置工作可以交給 agent 處理,但「agent 幫忙配好」不代表底層相依消失,只是配置勞動被自動化了。
這層依賴也解釋了後續為何環境會成為能力邊界。靜態分析看不到執行期資料時,agent 必須想辦法讓程式跑起來;分析工具超時或路徑受阻時,它需要替代工具與新的觀察面。工作流的強度,取決於模型能否規劃,也取決於它被授權使用哪些工具、主機上有哪些資料,以及環境是否允許安全執行樣本。任何實務導入都應使用隔離環境、最小權限與明確資料邊界,尤其不能把「agent 可以自行下載與執行工具」當成無條件的便利功能。
第四層:證據整理讓一次成功變成可檢查的過程
REA 在影片描述中還負責整理分析結果與證據來源,方便 agent 繼續追蹤、驗證,或依據理解重寫目標功能。這項能力看起來不像反編譯那樣醒目,卻可能是 agent 工作流能否可靠擴張的關鍵。
逆向分析不是一次問答,而是一串相互依賴的判斷。某個函式為何被認定是校驗入口?某段資料為何被當成密文?腳本還原出的候選值是否真的能觸發預期分支?若中間證據沒有被保留,模型很容易在長任務裡把推測當成事實,或在換工具之後失去前後對應。把每個結論綁回來源、讓候選答案接受正向與反向驗證,能使工作流從「看起來合理」走向「可以被檢查」。
這也讓我們看見 REA 最合理的定位:它不是能力的唯一來源,而是把模型、工具與證據串成流程的介面。若把它吹成新的萬能反編譯器,就會掩蓋 IDA 等工具的貢獻,也會錯估模型與環境的限制;若因為底層能力來自既有工具,就認為編排層毫無價值,也低估了自動化工作流在降低操作成本、保留證據與促成迭代上的意義。
真正需要驗證的,不是「REA 有沒有神奇能力」,而是它在相同模型、相同工具、相同樣本與相同權限下,能否讓任務更快、更穩、更容易稽核。影片沒有完成這組比較,因此答案仍是未驗證;但它已足以提出下一個問題:當這套三層結構進入逐輪加壓的測試時,能力曲線在哪裡開始改變?
💡 給讀者的 Takeaway
- REA 位於 agent 與 IDA、Ghidra、Hopper 等工具之間,主要作用是統一介面、流程提示與證據整理。
- 模型負責推理與規劃,分析工具提供可觀察材料;不能把整套組合的成果全部歸功於 REA。
- 影片記錄的 100 多個工具與 100K 以上 tokens屬於講者環境的觀察,不是已驗證的通用規格。
- 沒有「有 REA/無 REA」控制組,就無法量化它對速度、成功率與穩定性的實際增益。
- 實務導入必須搭配合法授權、隔離環境、最小權限與可追蹤證據,不能把自動化操作視為無條件放行。
032. 八輪壓力測試|從 71 秒到 54 分鐘的能力曲線
「同樣是完成任務,速度變慢、路徑變長與證據變弱,代表的其實是三種不同的能力邊界。」
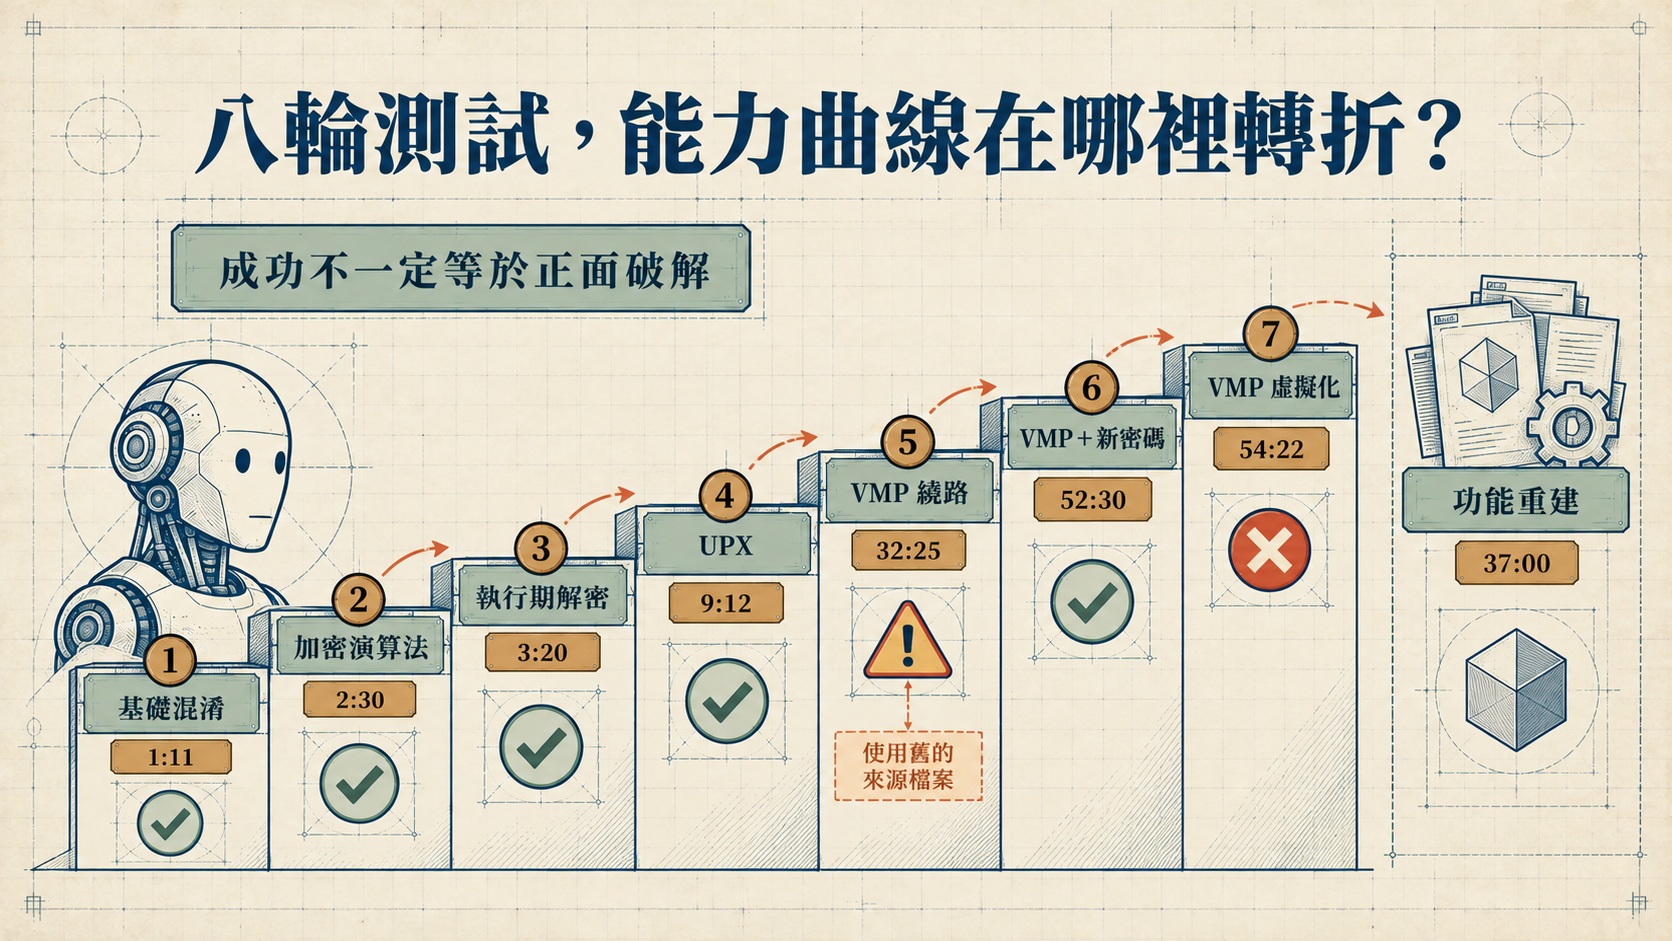
如果只看結果,影片裡的 REA 幾乎一路過關:前四輪都取得了目標結果,第五輪雖然卡在 VMP,最後仍找到可用答案;第六輪更在分析環境不相容、IDA 未能順利工作的情況下改道成功;直到第七輪開啟針對校驗邏輯的 VMP 虛擬化,agent 才在近一小時後停止。最後一輪則把問題從「找出密碼」改成「重建一個 2048 遊戲」,測試的不再只是秘密值能否被取回,而是功能與行為能否被重新實作。
但這八輪不能只用「成功/失敗」二分。它們更像是一條逐漸抬升的能力曲線:前段考驗的是讀懂既有程式結構,中段開始要求 agent 自己補工具、處理執行環境,後段才真正碰到「沒有可直接還原的原生邏輯」這道牆。若把每輪完成時間、所用路徑與證據品質放在一起看,REA 的宣傳口號就會退到背景,模型如何規劃、工具提供了什麼觀測面,以及 agent 有沒有完成驗證,才成為真正值得觀察的部分。
前四輪:成本隨保護層級平穩上升
影片記錄的第一輪用時 1 分 11 秒,agent 呼叫 12 輪工具。樣本沒有明文保存密碼,而是加入位元運算、狀態變化與資料位置打亂;agent 透過 REA 取得 IDA 的分析結果,定位輸入與校驗相關函式,理解資料變換後產生還原結果,最後再執行原程式確認成功與失敗分支。這一輪的關鍵,不是「AI 猜中了」,而是它走完了從定位、解讀到驗證的閉環。
第二輪提高了演算法複雜度,加入金鑰來源、分塊與區塊串接等要素。影片記錄用時 2 分 30 秒。難度雖然上升,任務型態仍沒有根本改變:關鍵資訊依然能從反編譯結果與程式常量中被理解,agent 只需要把更長的資料流整理清楚。因此時間增加,但工作路徑仍保持直接。
第三輪把校驗函式的機器碼加密,檔案裡只留下密文,程式執行後才在記憶體中還原。影片記錄 agent 先辨識外層解密邏輯,再於程式外重現該過程,還原 360 bytes 的機器碼,並以完整性檢查與原程式行為交叉確認;全程用時 3 分 20 秒。這個數字只代表影片中的自製樣本與當時環境,不應外推成所有執行期解密保護都能在幾分鐘內處理。真正重要的是:保護多了一層,但外層邏輯仍可讀、輸出仍可驗證,所以 agent 可以把大問題拆成連續的小問題。
第四輪加入 UPX,並因原本的 macOS ARM 樣本無法正常執行而改用 Windows 版本,分析環境則仍留在 Mac。影片記錄 agent 辨識出 UPX 後,在缺少現成工具的情況下,同時探索程式結構與可用工具,最後用官方工具的輸出與自行處理的結果互相比對,再繼續分析內層邏輯。這一輪用時 9 分 12 秒。時間第一次明顯拉長,增加的成本不只來自保護本身,也來自工具取得、環境差異與結果校驗。
第五、六輪:任務完成與技術突破開始分岔
第五輪加上 VMP 的加殼保護後,原本的分析路徑不再順暢,IDA 也出現逾時。影片記錄 agent 在 32 分 25 秒後取得密碼,但靠的是主機上殘留的第三輪原始碼與可執行檔,再利用「密碼尚未更換」這個條件完成任務。就任務定義而言,它確實找到了答案;就逆向能力而言,它並沒有正面拆開 VMP。這一輪因此非常關鍵:它提醒我們,評測不能只看最終輸出,還必須問答案從哪裡來。
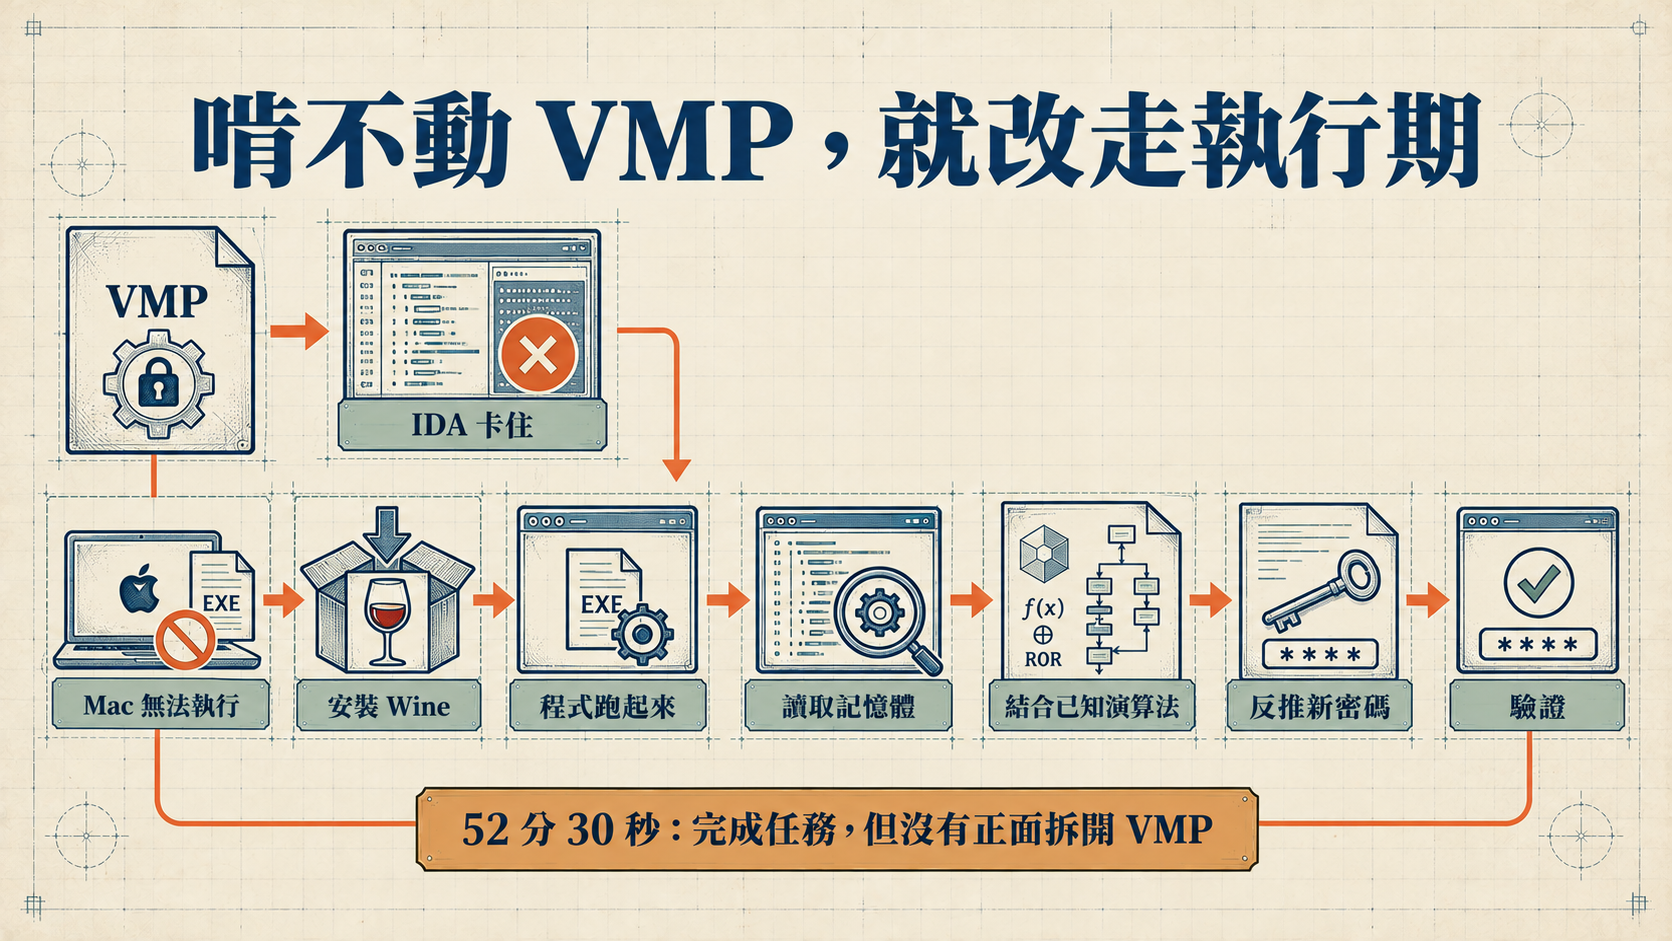
第六輪換成新的密碼,避免舊資料直接提供答案。影片記錄這次用時 52 分 30 秒。agent 在原本路徑受阻後,改為補上 Wine 執行環境、觀察程式執行時的資料,並結合前幾輪已掌握的演算法脈絡推導新結果;當 IDA 無法完成工作,又改用分析腳本與 LLDB。這裡展現的不是某個單一反編譯器突然變強,而是 agent 能在工具、作業系統與證據來源之間切換。也要注意,輪次之間存在資訊累積:它已經在前幾輪看過相近的內層邏輯,因此這不能當作「面對完全陌生 VMP 樣本」的獨立成績。
第七、八輪:一道技術牆,與另一種商業壓力
第七輪開啟 VMP 3.8.4 對校驗邏輯的虛擬化。依影片說明,即使外殼被處理、記憶體內容可取得,核心校驗仍是 VMP 自身的位元碼,而非可直接閱讀的原生 CPU 指令。影片記錄 agent 嘗試 54 分 22 秒後仍未取得密碼,並主動詢問是否繼續;它估計還需要數小時,且不保證成功。這是整段測試最有價值的失敗:agent 沒有把未完成包裝成成功,也指出了繼續投入的成本與不確定性。
第八輪則換了一條軸線。影片讓 agent 重建一個 2048 小遊戲,並在「合併到 64」時藏入平常不會立即出現的慶祝視窗。影片記錄 agent 在 37 分鐘內完成一個介面略有差異、但主要行為與隱藏彩蛋都能重現的版本。這不是原始碼逐行還原,也不是證明兩個程式完全等價;它呈現的是另一種能力:只要功能規格能從二進位與行為中被辨識,agent 可能不必取回原始實作,也能交付足以替代部分用途的新實作。
這不是 benchmark,而是一條帶有上下文的案例曲線
影片的八輪測試很有啟發性,但不是具備控制組的正式 benchmark。樣本由同一位操作者設計,保護逐輪疊加,agent 能沿用先前取得的知識;第五輪還受到主機殘留檔案影響。影片也沒有在相同模型、相同工具與相同提示下,比較「有 REA」與「沒有 REA」的差異。因此,1 分 11 秒、54 分 22 秒或 37 分鐘都應被視為影片中的案例紀錄,而不是 REA 或任何模型的普遍性能承諾。
更可靠的讀法,是觀察工作型態如何改變:前四輪主要是分析可見邏輯並建立驗證;第五輪暴露環境洩漏會扭曲評測;第六輪顯示 agent 可以主動補齊執行與除錯條件;第七輪則說明,當核心語義被虛擬化且缺乏可直接映射的原生邏輯,成本會陡升,甚至無法在合理時間內完成;第八輪則把焦點從「保住秘密」推向「功能是否容易被替代」。這條曲線,比單純宣稱「AI 已能逆向一切」更接近影片真正提供的證據。
💡 給讀者的 Takeaway
- 八輪結果要同時看耗時、路徑與證據品質,不能只看有沒有交出答案。
- 影片中的前四輪顯示,可讀、可拆分、可驗證的保護會讓 agent 快速形成閉環;這仍是單一自製樣本的案例,不是通用基準。
- 第五輪是任務成功、技術未突破;第六輪則是藉由環境與工具切換完成目標,兩者不應混為同一種「破解」。
- 第七輪的停止同樣是有效結果:它標出時間、成本與技術邊界。
- 第八輪提醒軟體團隊,風險不只在秘密值被取回,也在功能可能被重新實作;相關研究與測試都應限於自有軟體、合法授權與互通性情境。
043. 為什麼前四輪很順|靜態分析、自寫腳本與可驗證閉環
「一條路走不通就換思路,缺環境就自己搭,拿到結果再回頭驗證。」
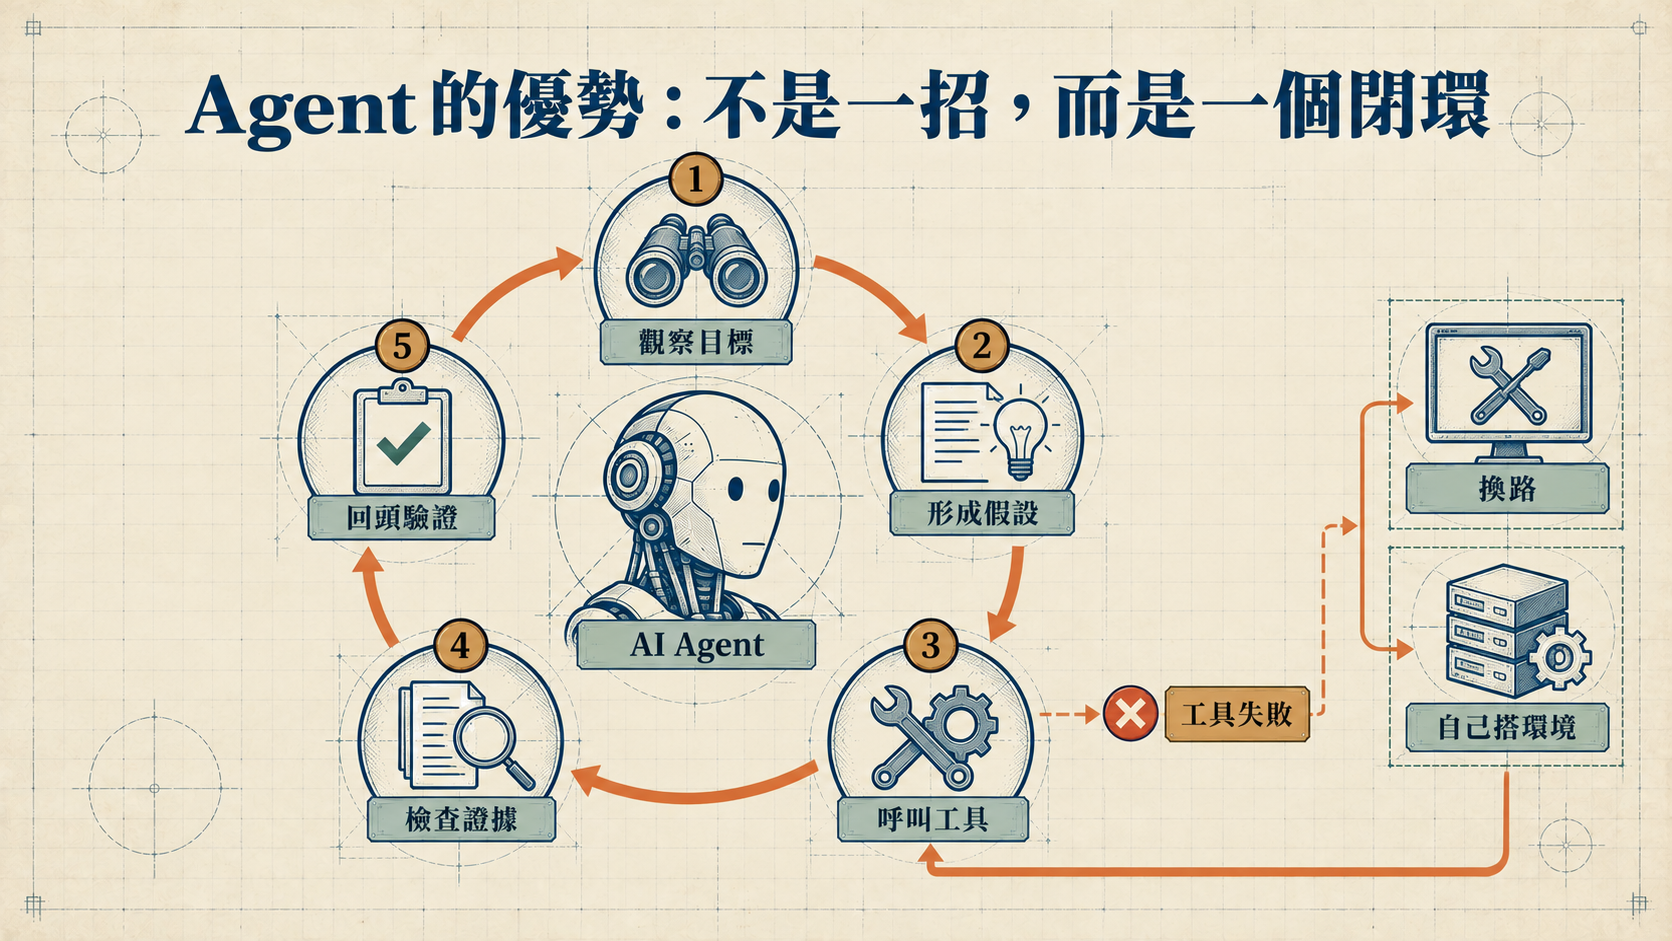
前四輪看起來像是一場保護措施逐步失效的展示,但若把「REA 很強」先放到一邊,真正反覆出現的是一套更樸素的解題結構:agent 先從分析工具取得可觀察資訊,建立對程式資料流的假設,再把假設轉成可執行的檢查,最後回到原程式或另一份輸出驗證。REA 在這裡提供介面、流程指引與證據整理;模型負責理解與規劃;IDA、編譯工具與執行環境提供實際能力。順利的是這個組合形成的閉環,而不是某個專案憑空產生了新的反編譯技術。
靜態分析先把問題變成可描述的資料流
第一、二輪的共同點,是核心校驗邏輯仍能被反編譯並追蹤。雖然第一輪沒有保存明文密碼,第二輪又加入更複雜的金鑰與分塊關係,但 agent 面對的仍是可觀察的輸入、常量、轉換與比較。對人工分析者而言,這些工作需要在多個函式、交叉引用與偽程式碼之間來回切換;對能呼叫工具的 agent 而言,優勢則在於它可以持續保存中間結論,並把下一個工具呼叫建立在上一個觀察之上。
這不代表靜態分析已經「自動解決」。反編譯輸出本身不是原始碼,變數名稱、型別與控制流程都可能不完整。agent 仍可能誤讀一段轉換,或把看似相關的常量錯認成核心資料。影片前兩輪之所以快,部分原因是樣本規模小、任務目標清楚,而且輸出有明確的成功/失敗行為可以檢驗。換成更大型、帶有更多無關路徑或外部相依的程式,整理證據的成本就未必維持同一量級。
執行期解密沒有讓證據消失,只是把它移到下一層
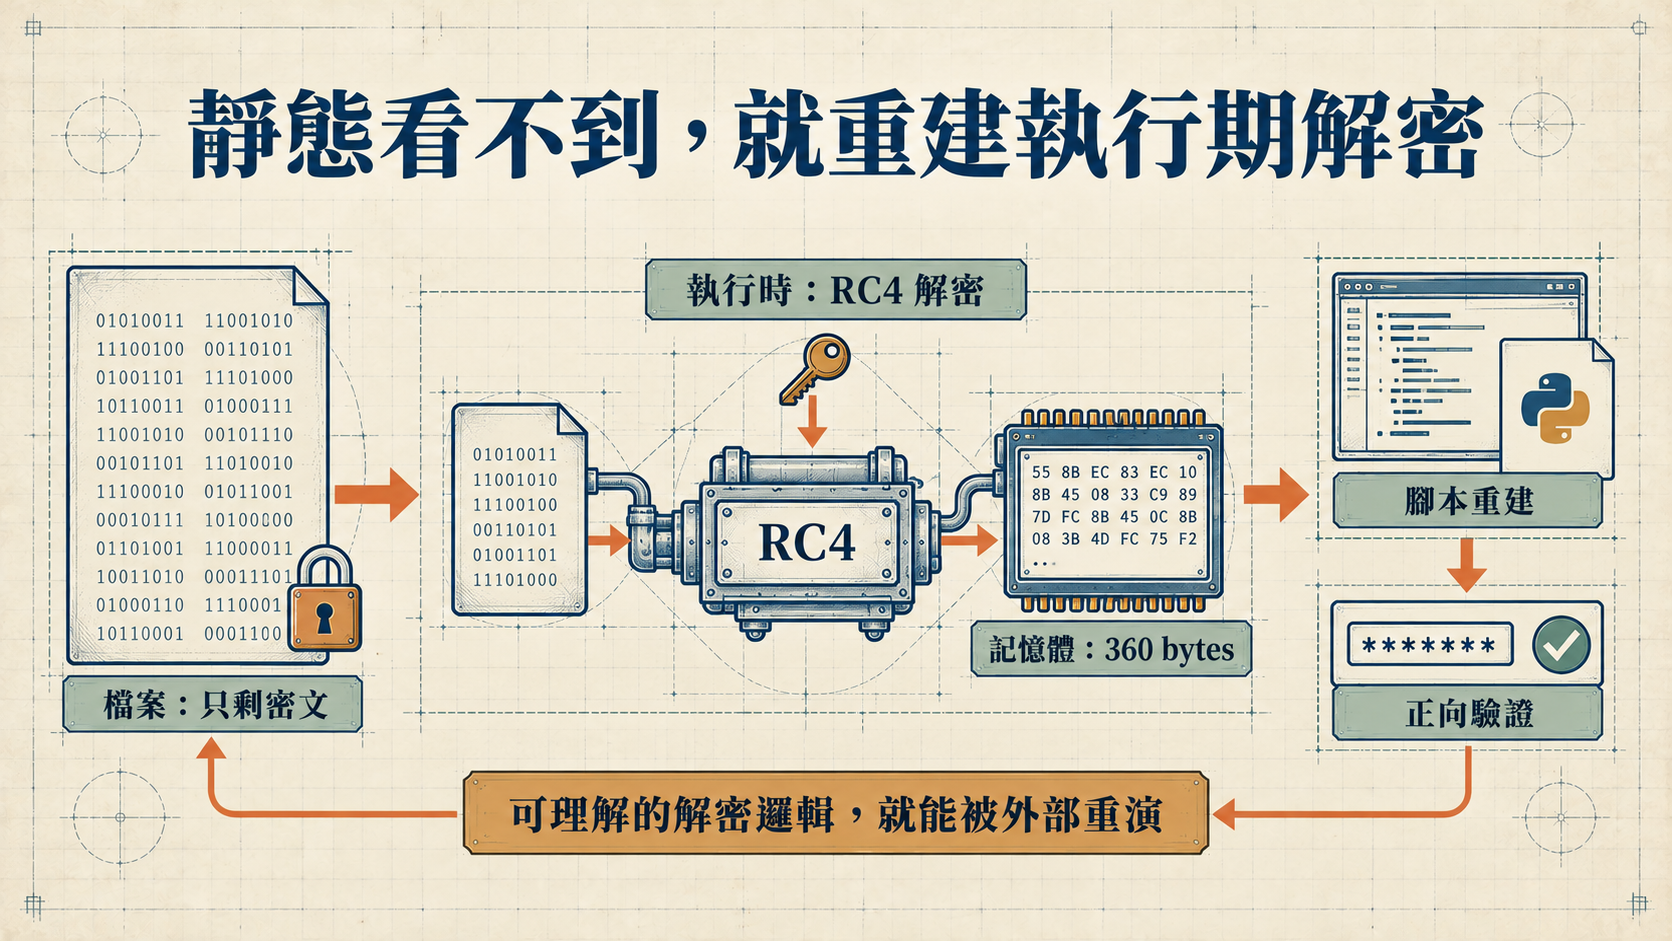
第三輪的設計刻意讓靜態檔案裡看不到校驗函式:那段機器碼先以密文形式存在,執行時才還原到記憶體。影片記錄 agent 沒有直接取得內層邏輯,而是先理解外層的解密流程,辨識出 RC4,再重現同樣的轉換,還原 360 bytes 機器碼。之後,它又以影片所述的完整性 Hash、解出內容的分析,以及原程式行為建立多重確認,總用時 3 分 20 秒。
這輪說明「靜態看不到」不等於「分析沒有起點」。如果解密例程、金鑰材料與完整性資訊仍隨程式一起交付,外層程式就可能成為通往內層邏輯的說明書。agent 擅長的不是神祕地看穿密文,而是把可見的外層行為翻譯成一個可重複檢查的模型。只要每個中間產物都有辦法驗證,錯誤就能較早被發現,不必一路累積到最後才知道推理出了問題。
同時也必須保留尺度感。影片中的 360 bytes、RC4 與自製校驗程式,只能支持「這個案例的外層邏輯足以被重現」。它不能證明所有執行期解密、所有自修改程式或所有完整性保護都同樣脆弱。更不能把一個合法自有樣本中的研究流程,轉譯成對第三方軟體繞過授權的普遍許可。
自寫工具的價值,在於縮短假設到證據的距離
前四輪另一個反覆出現的模式,是 agent 不只閱讀分析結果,也會產生小型分析程式來檢查自己的理解。第一輪用它重現資料變換,第三輪用它處理被加密的機器碼,第四輪則在缺少現成 UPX 工具時嘗試補出所需能力。這些動作的意義不在於程式碼寫得多漂亮,而在於把「我認為它是這樣運作」轉成可比較的輸出。
從工程角度看,這讓逆向分析更接近測試驅動的調查:每個假設都要留下輸入、輸出或行為證據。若結果不一致,agent 可以回頭檢查是反編譯理解錯誤、資料擷取錯誤,還是工具鏈本身造成差異。REA 所整理的分析紀錄與證據出處,在這裡有實際價值,因為它讓後續推理不必只依賴對話中的模糊記憶;但真正執行轉換、解析二進位與跑程式的,仍是外部分析工具與環境。
UPX 一輪最重要的不是「找到工具」,而是交叉驗證
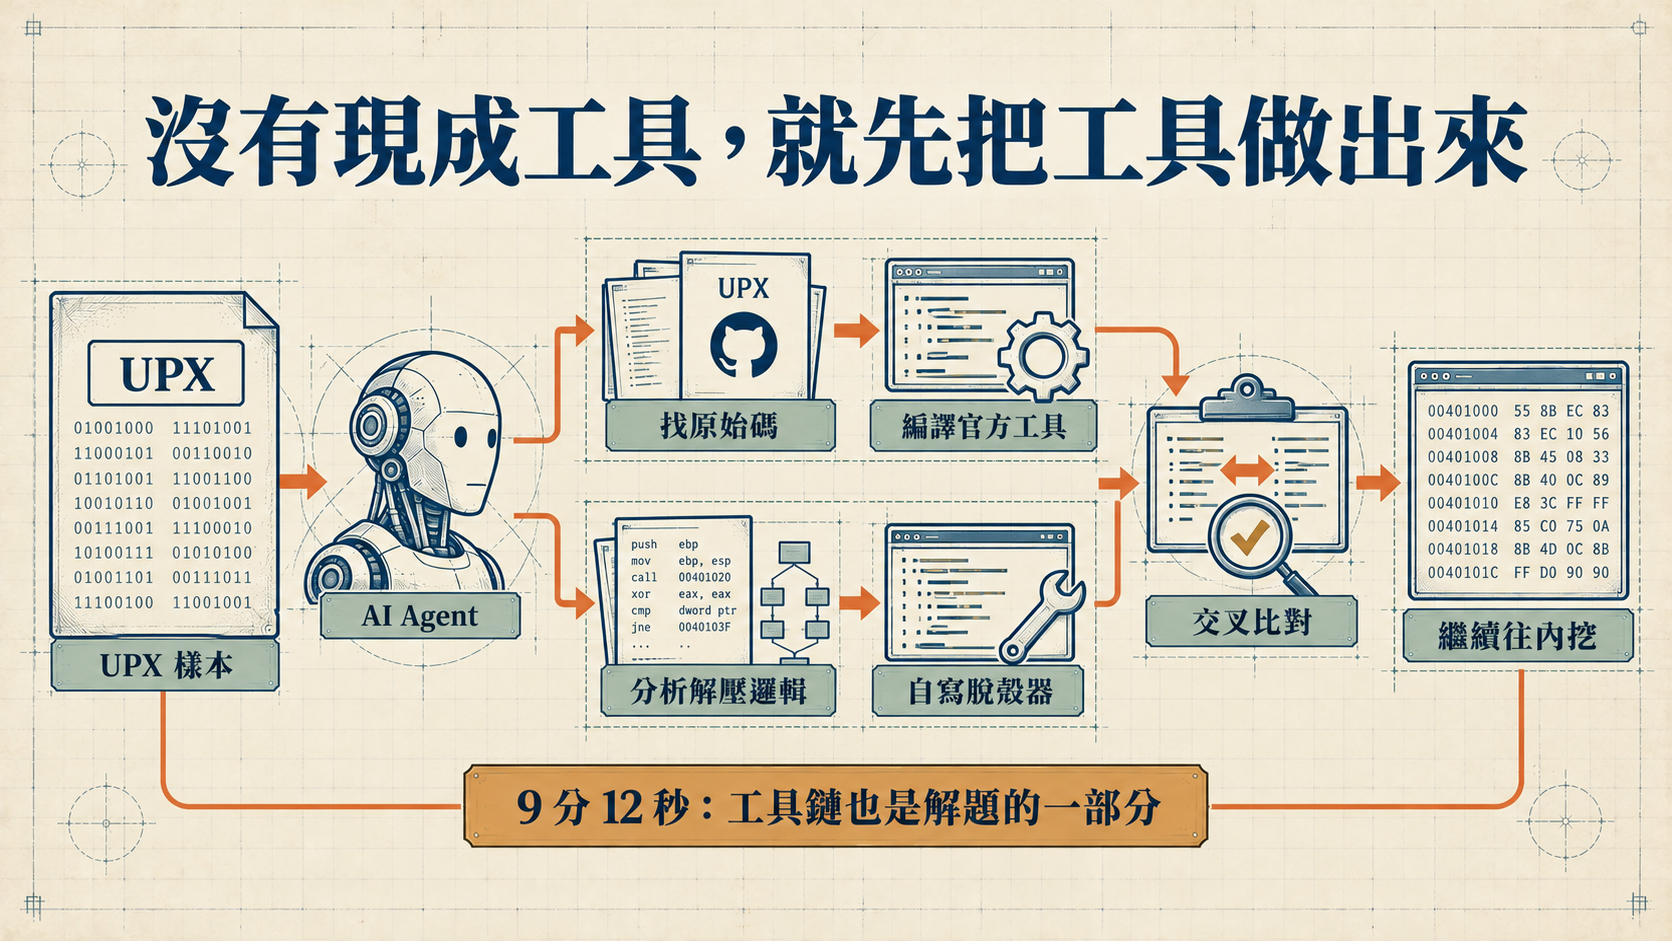
第四輪的敘事很容易被縮成「AI 自己做了脫殼器」,但影片記錄其實更值得注意的是後半段:agent 後來編譯了官方 UPX,並把官方工具的結果與自己處理的結果相互比對。換句話說,自製工具沒有被當成天然正確的答案,而是被放進一個可驗證的比較關係裡。當外層處理結果一致後,agent 才繼續面對第三輪已見過的執行期解密結構,最終完成影片中的正向驗證。
這也解釋了為什麼第四輪雖然增加了封裝層,影片記錄仍能在 9 分 12 秒內完成。UPX 是可辨識、已有成熟工具與公開實作的既有格式;內層又與上一輪高度相關。agent 的工作不是從零發明未知演算法,而是辨識類型、補齊工具、比較輸出,再沿用已建立的分析模型。把這個結果直接概括成「AI 能輕鬆處理所有加殼」會超出影片證據;更準確的說法是,成熟工具、可辨識格式與既有上下文讓這一輪形成了高效率的工具鏈。
真正的加速器,是短週期、可回溯的驗證
把前四輪放在一起,可以看到一個一致的 agent 迴圈:觀察目前可見的程式結構,提出對演算法或封裝的解釋,呼叫既有工具或產生輔助程式,然後用 Hash、工具輸出或原程式行為回頭檢查。任何一環失效,都有機會退回上一層修正,而不是依賴一次漫長且不可追蹤的推理。
這套迴圈也揭示了 REA 應該被放在哪裡評價。依影片講者的說法,即使解除安裝 REA、讓 agent 直接透過 MCP 對接 IDA,前面多數測試仍可能完成;這是講者的判斷,影片沒有提供同條件控制組加以驗證。可以較有把握地說的是,REA 把常用操作包裝成統一介面,提供 skill 形式的流程指引,並整理分析結果與證據,因而降低 agent 在不同工具間協調的摩擦。它改善的是編排品質與工作記憶,不是取代底層分析器。
因此,前四輪之所以「很順」,至少同時包含四個條件:樣本規模與目標受控、重要邏輯仍能透過某一層被觀察、已有成熟工具或可重現的轉換、結果能以明確行為驗證。少掉其中一項,能力曲線就可能像後面的 VMP 測試一樣迅速變陡。這也是團隊評估 AI 逆向工作流時更實用的問題:不是先問它能不能「逆向一切」,而是問它能看見什麼、能調用什麼、每個結論如何被證明,以及失敗時是否知道該停在哪裡。
💡 給讀者的 Takeaway
- 前四輪的共同優勢,是問題能被拆成短週期的觀察、推理、工具執行與驗證。
- 第三輪影片記錄的 360 bytes 還原成功,關鍵在外層邏輯仍可理解並能交叉檢查;不能外推成所有執行期保護都容易處理。
- 自寫腳本不是目的,而是把分析假設變成可測量輸出的手段;重要結果仍需要獨立證據確認。
- UPX 輪次依賴成熟格式、官方工具與前輪上下文,不能代表未知或高強度保護也有相同結果。
- REA 的可見貢獻是標準化介面、流程編排與證據整理;合法使用應限於自有程式、授權測試、安全研究與互通性分析。
054. VMP 教會我們的事|繞路成功不等於正面破解
「繞路完成任務,是 agent 能力;把繞路說成正面破解,則是評測敘事的錯誤。」
前四輪測試之所以帶來一種近乎勢如破竹的觀感,是因為 agent 面對的問題雖然逐步增加了混淆、加密、執行期解密與 UPX,核心分析鏈仍然可以被拆成一連串可觀察、可推理、可驗證的工作。到了 VMP,測試真正有價值的地方才開始浮現:同一個「找出密碼」的任務,究竟可以有多少種成功;而一個成功結果,又是否真的代表宣稱中的技術被突破?
影片安排的第五、六、七輪,看似都圍繞 VMP,實際上卻測到了三件不同的事。第五輪測的是 agent 會不會利用環境裡的既有線索;第六輪測的是它能否在原路受阻後重組工具與環境;第七輪才把保護推進到針對校驗邏輯的虛擬化,碰觸到正面分析 VMP 虛擬機的難題。若把三輪都壓縮成「AI 挑戰 VMP」,最重要的差異反而會被標題抹掉。
第五輪的成功,是任務成功,不是 VMP 破解
第五輪只開啟 VMP 的加殼保護。依影片展示,agent 先嘗試從樣本結構中尋找原本的程式碼與資料,但分析不順,IDA 也發生逾時,最後沒有直接從受保護樣本裡得到密碼。它隨後改變搜尋範圍,在測試電腦上找到第三輪留下的原始碼與可執行檔;因為第五輪沿用舊密碼,它便以既有答案完成驗證。影片記錄整輪用時 32 分 25 秒。
這件事有兩個同時成立、卻不能混為一談的判讀。
第一,從任務代理的角度看,它確實完成了使用者交付的目標。指令是「找出密碼」,而不是「只能以某種技術路徑拆開保護」。當同一台主機保留舊版原始碼、舊樣本與相同祕密時,先盤點可用證據,比執著在單一工具裡硬碰硬更接近一個具有行動能力的 agent。這也提醒測試設計者:環境不是中性的。殘留檔案、歷史版本、命名線索與先前輪次的上下文,都可能成為捷徑。
第二,從技術評估的角度看,這一輪沒有證明 VMP 殼被正面拆解。講者自己也明確指出,agent 是「翻到參考答案」,VMP 保護本身並未被打開。把這一輪寫成「VMP 已被 AI 破解」,等於把輸出結果誤當成技術能力,把旁路取得答案誤寫為對保護機制的突破。它證明的是環境探索與任務導向的彈性,不是 VMP 分析能力。
這種歧義並非只屬於逆向工程。任何 agent 評測只要允許自由存取檔案、網路、工具與長期上下文,都可能出現類似現象:agent 找到一條測試設計者沒有預期的短路。這有時是令人驚喜的解題能力,有時卻是資料污染或答案洩漏。要判斷是哪一種,不能只看最後是否得到正確答案,還要保存過程、標註證據來源,並說清楚成功判準。
第六輪更強的地方,不是硬啃,而是重組行動鏈
為了封住第五輪的捷徑,講者在 Windows 端重新生成程式、換上新密碼,再加上 VMP 殼。這次舊版答案不能直接沿用。影片記錄 agent 最後仍找到新密碼,總用時 52 分 30 秒;但最值得注意的不是「成功」兩字,而是它如何處理工具與環境的連續失靈。
影片中的分析環境是 macOS,目標卻是 Windows 程式。當原先的靜態分析路徑走不下去,agent 沒有持續把所有希望押在 IDA,而是改成讓目標程式先跑起來。它補上 Wine 環境,取得執行期可觀察的資料,再結合前幾輪已理解的演算法,使用自寫分析腳本與 LLDB 推進,最後回到原程式驗證結果。這條路仍不是「正面拆開 VMP 殼」;它是利用執行期資訊與已知演算法,繞過一部分靜態障礙,完成尋找密碼的任務。
因此,第六輪展現的核心能力應該被描述為工作流恢復能力。工具逾時時,它能更換工具;缺少執行環境時,它會補環境;靜態資訊不足時,它轉向執行期觀察;得到候選結果後,再回頭驗證。用影片中的話說,就是「一條路走不通就換思路,缺環境就自己搭,拿到結果再回頭驗證」。
這種能力對合法授權的安全研究、自有軟體診斷與相容性分析很有價值。資深研究者往往不是因為記得更多單一指令而有效率,而是知道什麼時候該放棄低收益路徑、如何建立下一個可驗證假設。agent 把這種策略切換做成長時間連續行動,確實可能省掉大量體力工作與環境試錯。
但仍需保留兩層編輯距離。其一,前幾輪累積的演算法資訊幫助了第六輪,這不是完全從零開始的盲測。其二,影片沒有設計「同模型、同工具、同環境,但移除 REA」的控制組,所以不能據此判定轉向能力由 REA 本身帶來。它可能來自模型的規劃能力、DeepSeek Harness 的執行介面、既有分析工具,或這些元素的組合。把整條行動鏈都記在 REA 名下,仍然是過度歸因。
第七輪終於碰到真正的虛擬化邊界
第七輪與前兩輪的差別,不只是「再加強一點」。講者開啟的是針對密碼校驗邏輯的 VMP 虛擬化,使用的版本據稱是 VMP 3.8.4。依影片說明,即使程式能執行、記憶體能被取得,受保護函式呈現的仍是 VMP 自己的位元組碼,而不是原本的 CPU 指令。分析者若要理解它,就必須面對虛擬機指令集與執行語意的還原問題。這與「找到解密資料、辨認常見加殼、沿用既有演算法」不是同一等級的工作。
影片記錄 agent 嘗試 54 分 22 秒,可以啟動程式,也取得記憶體資訊,卻沒有得到密碼。最後它主動詢問是否要繼續投入,估計仍需數小時,而且不能保證成功;講者因時間因素停止測試。這個結果不應被寫成「永遠做不到」,因為測試已中止,也沒有長時間重試或其他模型的對照。準確說法是:在影片展示的時間、模型、工具與環境條件內,這次 VMP 3.8.4 虛擬化任務未成功。 超出這個範圍的能力均屬未驗證。
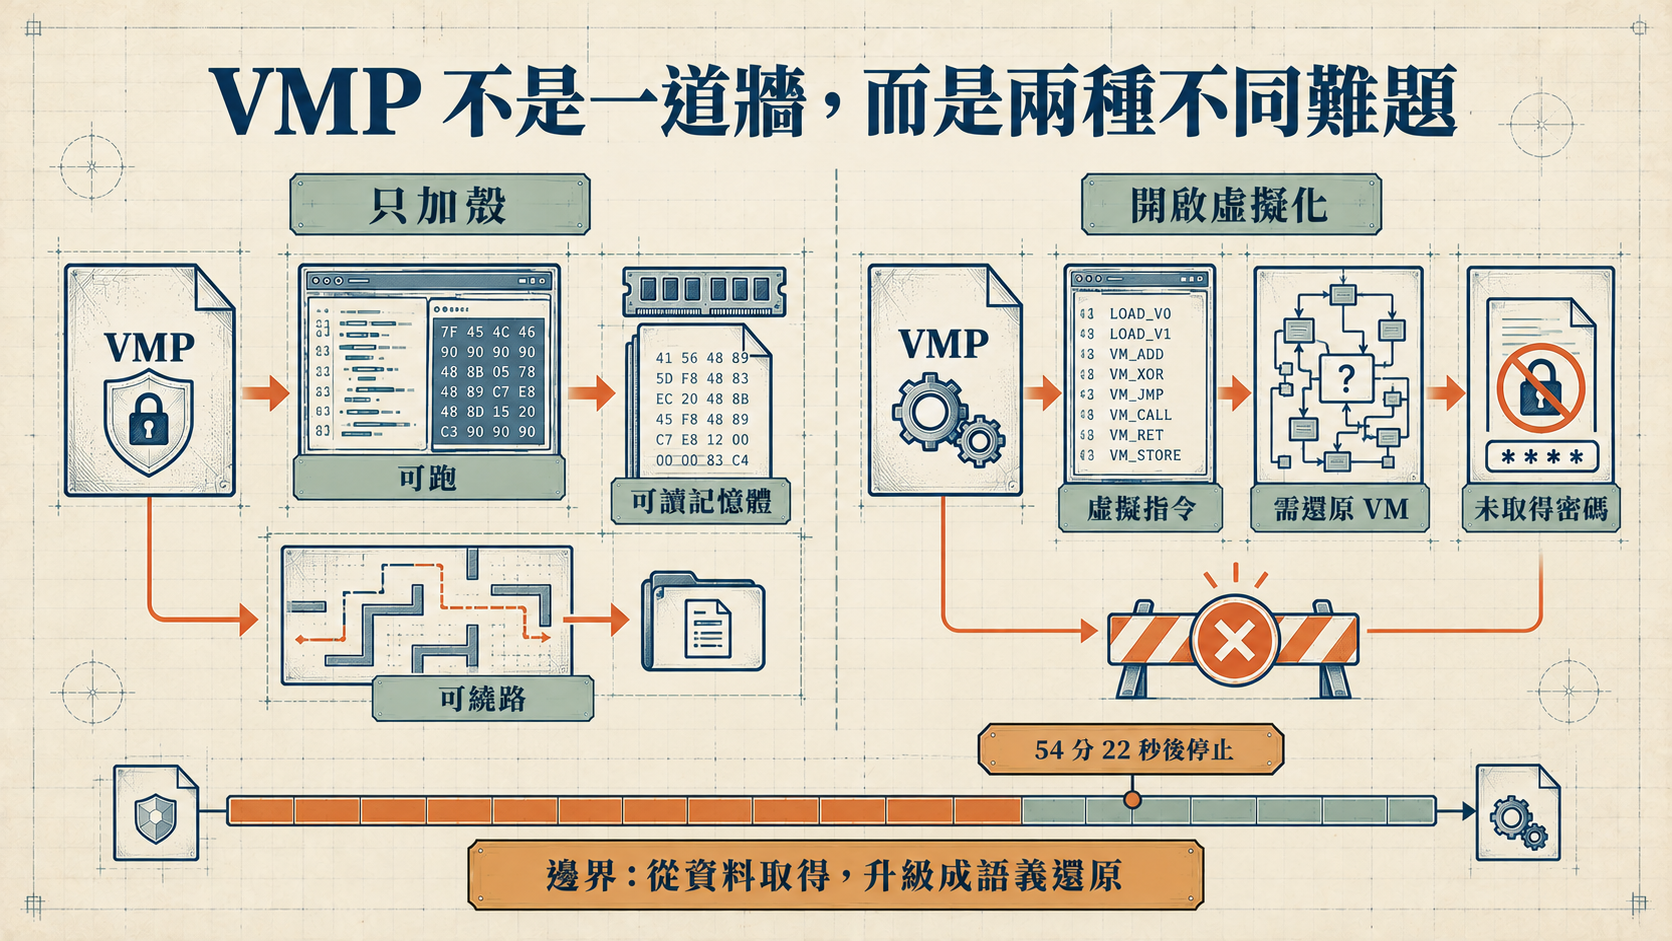
失敗在這裡不是影片的瑕疵,反而是最重要的校準點。它阻止我們把前四輪的流暢表現外推成「任何保護都只剩等待時間」。靜態混淆、執行期解密、通用壓縮殼與特定邏輯虛擬化,在分析成本上並不連續;前者已有成熟表徵與工具鏈可供 agent 操作,後者則可能迫使分析者建立更深的執行模型。agent 能夠自動走更遠,並不代表所有問題都已被壓平成同一種提示詞任務。
評測應同時回答「拿到什麼」與「怎麼拿到」
如果只用二元成敗記分,第五、六輪都是成功,第七輪是失敗。但更有解釋力的記錄至少要分成四欄:最終任務是否完成、保護機制是否被正面分析、是否利用環境旁路,以及是否經過獨立驗證。依這個框架,第五輪是「任務完成、未正面分析、使用舊檔旁路、結果經程式驗證」;第六輪是「任務完成、未正面拆殼、改走執行期資料、結果經程式驗證」;第七輪則是「任務未完成、碰到虛擬化分析邊界、在限定時間內停止」。
這樣寫並不是貶低 agent。恰恰相反,它讓真正值得肯定的能力變得清楚:agent 不只會讀反編譯結果,也會管理失敗、搜尋替代證據、搭建缺失環境與封閉驗證迴圈。只不過,這份肯定必須放在合法授權的測試範圍內,不能被延伸為繞過第三方授權或侵害軟體權利的操作背書。技術能力與使用正當性,是兩個都不能省略的維度。
💡 給讀者的 Takeaway
- 第五輪靠舊原始碼與舊樣本取得答案,證明的是環境探索,不是 VMP 被正面破解。
- 第六輪的亮點是遇到工具與環境障礙後,能改走 Wine、執行期資料、自寫腳本與 LLDB 的行動鏈;影片記錄用時 52 分 30 秒。
- 第七輪針對校驗邏輯啟用 VMP 3.8.4 虛擬化,影片記錄 54 分 22 秒內未成功;更長時間或其他配置能否成功,仍未驗證。
- 評測 agent 不能只看答案,還要區分任務成功、技術突破、環境旁路與驗證證據。
- 相關分析應限於自有程式、明確授權的研究、安全測試與互通性工作,不把能力展示變成侵權指南。
065. 從找密碼到重建功能|真正的壓力是可替代性
「知道某段程式怎麼判斷,和重新做出一個可用產品,是兩種不同的完成。」
前七輪都把終點設成一個容易判定的答案:找出密碼。第八個實驗把問題換了方向。這次不再追問某個祕密值,而是要求 agent 在沒有原始碼的情況下理解一個程式的功能,再寫出另一份能呈現相同行為的實作。對軟體產業而言,這比「密碼能不能被找出來」更接近真正的壓力來源,因為它觸及的不是單點保護,而是產品功能是否容易被替代。
但「重建功能」必須與「還原原始碼」嚴格分開。影片沒有證明 agent 把原始專案逐行恢復,也沒有證明兩份程式在架構、演算法、邊界條件與視覺細節上完全相同。它展示的是:agent 透過對執行檔的分析,理解主要玩法與一個不容易從一般操作察覺的行為,然後另寫一份能重現這些外部效果的版本。這是行為層的重建,不是原始碼層的復原。
2048 實驗如何避免只抄表面
講者先讓 Codex 寫一個 2048 小遊戲,再把可執行程式交給 DeepSeek Harness,要求它使用 REA 與 IDA 復刻。若只有常見的棋盤、方向操作與數字合併,agent 即使不分析內部邏輯,也可能憑既有知識或直接觀察介面做出相似作品。為了增加可判別性,講者在原程式中加入一個隱藏行為:當數字合併到 64 時,程式會彈出慶祝視窗。一般啟動後看不見這項行為,必須實際玩到條件成立,或從程式邏輯中辨認它。
依影片記錄,agent 花了 37 分鐘交付重建版本。講者展示的兩份程式外觀並不完全相同,重建版的遊戲格子較大;但當遊戲進展到 64 時,慶祝視窗如期出現。這個細節至少支持一個有限而重要的判斷:agent 並非只做出「看起來像 2048」的表層介面,它也辨認並重現了來源程式中特定條件觸發的行為。
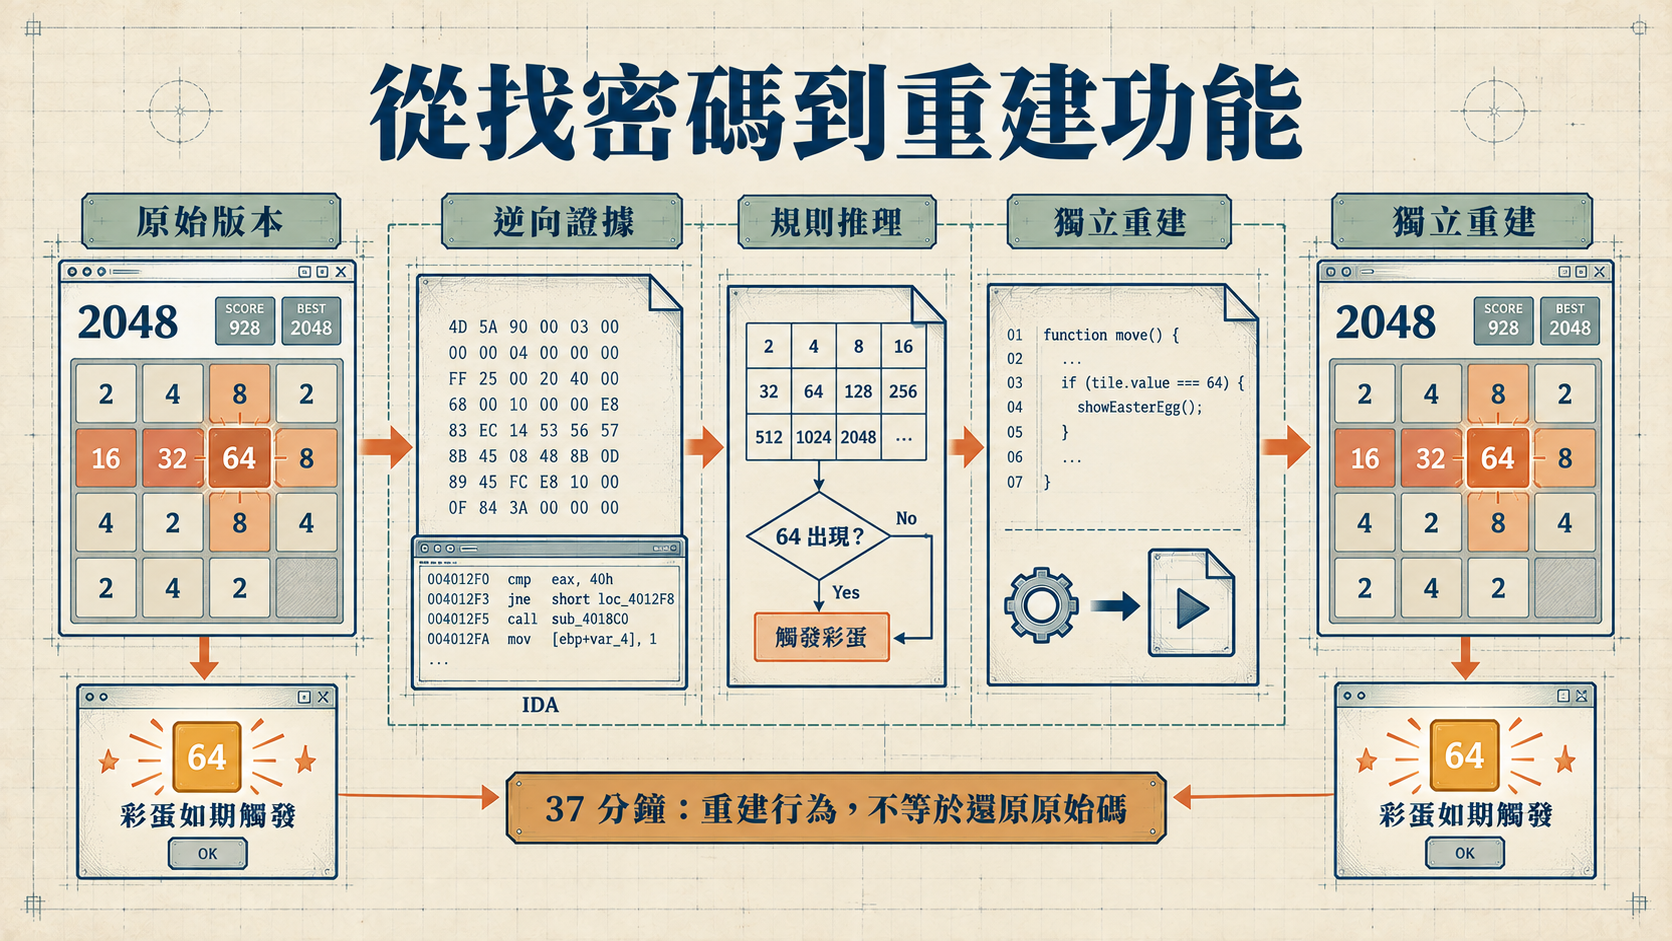
這仍不是嚴格的等價性證明。影片沒有展示完整測試套件,也沒有逐項比較所有規則、錯誤處理、效能、平台差異與極端狀態。除了格子尺寸差異之外,是否還存在其他未展示的行為差異,屬於未驗證。較穩健的描述是:重建版在影片展示的主要玩法與隱藏彩蛋上達到可觀察的一致,而非「完整還原原軟體」。
可替代性不是一個二元開關
從產品角度看,使用者購買軟體通常不是為了某段原始碼,而是為了完成工作。只要另一個工具能覆蓋足夠多的核心情境,即使內部實作不同、介面略有差異,也可能形成替代。影片後段提到,講者曾讓 AI 參照自己使用的錄影軟體另做一版;他也承認功能不完全相同,但表示基本用途已足夠。這是講者的個人經驗,並非市場調查或普遍成效數據,不能外推為所有軟體都會被快速複製。
然而,這個案例點出一個比「原始碼是否外洩」更難處理的問題:對需求簡單、流程清楚、差異主要落在功能清單的產品,替代品不必精確複製,可能只要做到「對某群使用者已經夠用」。AI 降低的若是從需求到可用原型的時間,那麼競爭壓力就會先出現在長尾使用情境與低切換成本市場,而不是等到有人逐行重建原始碼才發生。
反過來說,影片也沒有證明產品價值只剩功能。可靠性、資料安全、跨裝置同步、維運、法規遵循、客服、品牌信任、協作網路與長期相容性,均可能構成替代成本;這些面向並未在 2048 實驗中被測量。把一個小型、自製、功能邊界清楚的樣本,直接外推到大型商業系統,會忽略工程規模與服務責任的巨大差異。
因此,「可替代性上升」比「所有軟體都能被複製」更準確。AI agent 可能把功能理解、原型重建與驗證的成本往下拉,但它不自動取得產品脈絡,也不自動承擔營運品質。對產品團隊而言,真正該問的是:自己的價值有多少集中在客戶可以觀察到、容易描述、容易重新實作的端側功能?又有多少來自資料、服務、信任與持續迭代?
功勞應拆給模型、編排層、工具與環境
2048 實驗也讓「到底是誰完成工作」再次變得重要。影片裡至少有四個不同角色:模型負責讀取資訊、推理、規劃與產生程式;REA 提供逆向分析 skill、不同工具的統一封裝,以及過程與證據的整理;IDA 等工具提供實際的二進位分析能力;DeepSeek Harness 與主機環境則讓 agent 能執行工具、建立檔案並反覆驗證。
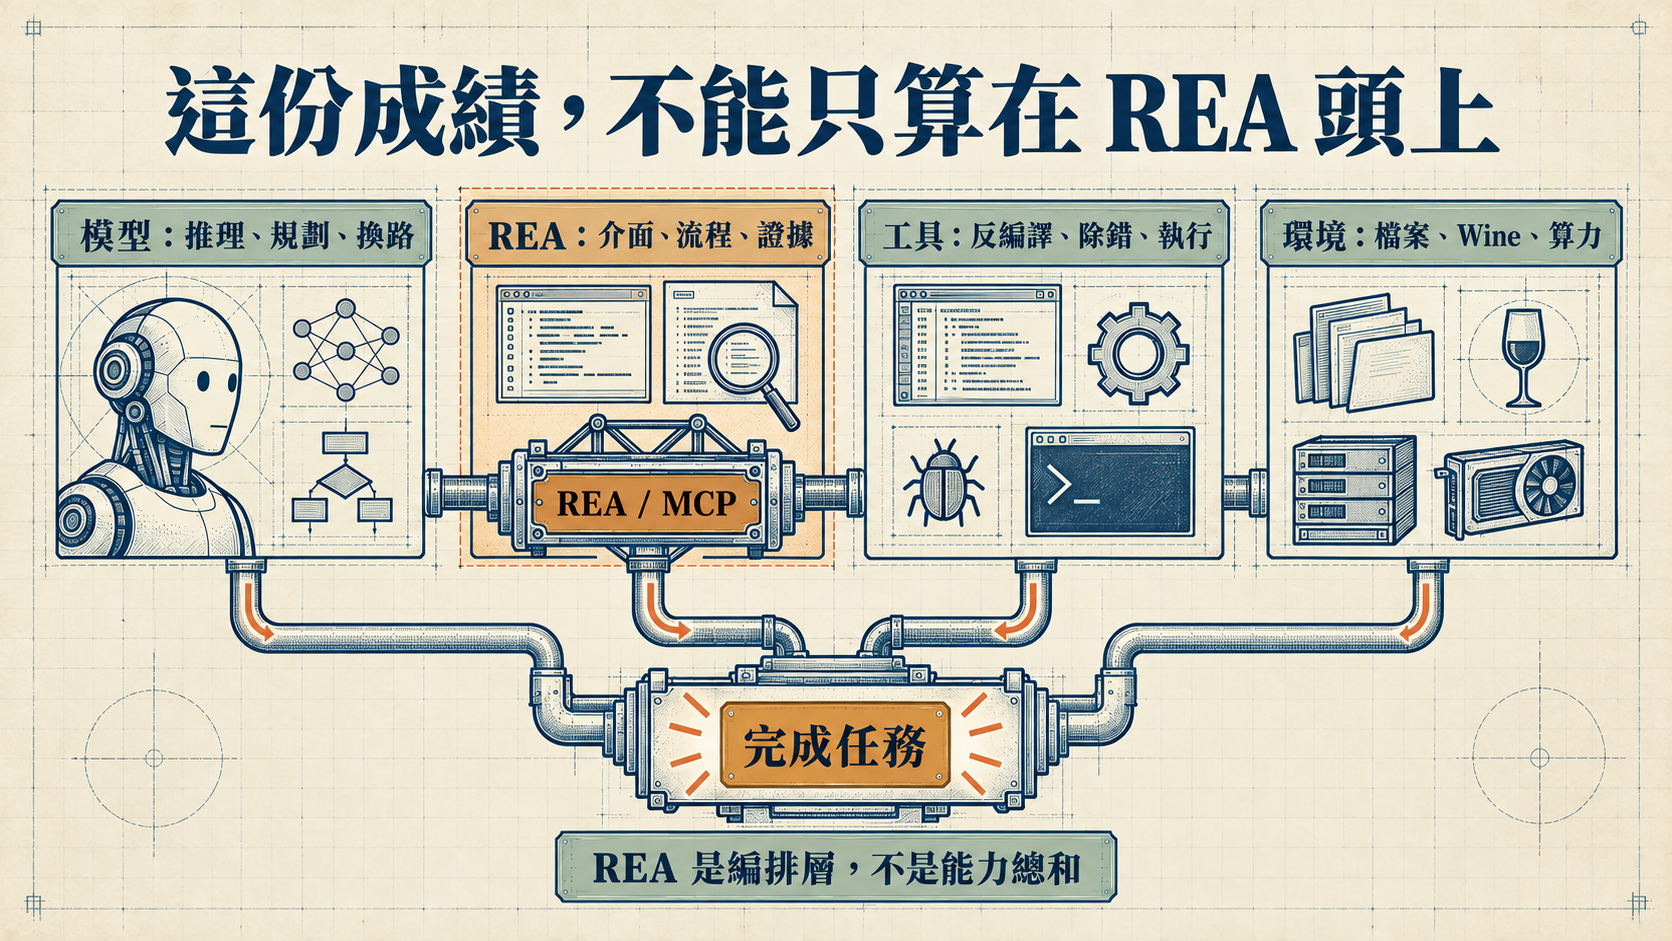
這四層並非互相排斥,缺少其中任何一層都可能改變效率。REA 的價值可以是真實的:把介面標準化、給模型較一致的工作入口、留存證據與分析軌跡,會讓複雜流程更容易組織。但講者的判斷是,主要能力仍來自 AI 大模型與 IDA;他並進一步表示,即使移除 REA、改讓 agent 透過 MCP 直接連接 IDA,前面的多數測試仍可能完成。這是講者的推測與經驗判斷,影片沒有實際展示同條件控制組,因此不能當成已驗證結論。
同樣地,也不能因為 REA 沒有自行提供反編譯引擎,就說它「沒有價值」。編排層的價值本來就不在取代底層工具,而在降低組合成本、讓能力可被模型穩定調用。問題只在於命名與傳播容易造成錯覺:當專案叫做 Reverse Engineer Anything,外部敘事可能把整個系統的成果都投射到這個中介層。準確歸因不是挑功勞,而是讓團隊知道該投資、評測與改善哪一層。
若要把影片進一步做成可比較的評測,至少需要一組「同模型、同樣本、同分析工具、同執行權限,只移除 REA」的對照;再固定上下文、清除先前輪次殘留,重複多次觀察成功率、耗時、工具呼叫量與證據品質。影片並未完成這些控制,所以文中的所有耗時都應視為這一次展示的個案紀錄,而不是 REA 或某模型的通用效能。
功能重建帶來的是產品命題,不是侵權許可
合法授權與研究倫理在這裡尤其重要。理解自有軟體、進行相容性研究、驗證安全性或重建已獲授權的內部工具,和未經許可複製第三方產品、規避授權或挪用受保護內容,不是同一件事。技術上能重建某種外部行為,不代表商標、著作權、專利、合約與資料權利自動消失;具體界線也會因司法管轄與情境不同而異,本文不做法律判定。
對開發者最實用的結論,不是學會把別人的產品「照著做」,而是重新盤點自己的護城河。如果價值只剩一組易觀察的本機功能,那麼原型化速度提升確實會讓競爭變快;若價值還包括可靠服務、獨有資料、整合生態、專業支援與可信賴的長期交付,功能重建就只是競爭的一個環節,而不是終局。
💡 給讀者的 Takeaway
- 2048 測試展示的是功能與特定行為的重建,不是逐行恢復原始碼;兩者不可混稱。
- 影片記錄 agent 用 37 分鐘做出主要玩法,並重現合併到 64 時的隱藏彩蛋,但完整行為等價性未驗證。
- AI 帶來的商業壓力,可能先表現在「做到夠用」的替代品,而不是完美複製。
- 模型、REA、IDA 等分析工具與執行環境共同構成結果;沒有控制組,就不能把功勞全算在任一層。
- 技術可行不等於法律與倫理上可為;功能分析與重建應限於自有、授權或其他合法情境。
076. 結論|天沒有全塌,但防線已經移動
「真正變強的不是某一把新工具,而是 agent 把多把工具串成了可驗證的行動鏈。」
看完整個實驗,最容易下的結論是「AI 已經會逆向」,最容易跟著傳播的結論則是「REA 逆向一切」。兩句話都抓到了一部分現象,也都省略了決定其意義的條件。影片真正呈現的是:在自製樣本、既定模型、IDA 等成熟工具、可操作的主機環境與先前輪次資訊逐步累積的前提下,agent 已能承擔不少基礎與中階分析工作,還能在路徑失效時主動換工具、補環境並驗證答案。這不是小進步,但也不是保護機制從此全部失效。
若要給這次展示一個更可靠的總結,可以分成三欄:真的強、被誇大、仍有限。這三欄不是折衷話術,而是分別對應影片裡已展示的能力、缺乏控制的歸因,以及清楚暴露的技術邊界。
真的強:agent 已能接手一段完整、可驗證的分析流程
真的強,首先強在連續性。前幾輪不是模型只回答一個二進位知識問題,而是它透過工具取得反編譯資訊、辨認資料轉換、撰寫輔助腳本、執行腳本,再把候選結果送回原程式做正向驗證。到了 UPX 與 VMP 加殼階段,它還會尋找或建立缺少的工具,在不同結果之間交叉比對。這種「觀察—推理—行動—驗證」閉環,比單次生成一段解釋更接近實際工作。
真的強,也強在失敗管理。第六輪最有說服力的不是密碼本身,而是 IDA 路徑受阻後,agent 能把問題重新表述成環境、執行與資料觀察問題,轉向 Wine、自寫腳本與 LLDB。它沒有把某個工具的失敗誤認成任務終止。對合法授權的研究團隊而言,這意味著 AI 開始有能力吸收一部分耗時、重複、需要跨工具切換的工作,讓人把注意力放在假設設計、證據品質與高風險判斷。
2048 實驗則顯示,agent 的目標可以從取得單一祕密,延伸到理解並重建外部功能。它在影片展示的範圍內抓到主要玩法,也辨認出合併到 64 才觸發的隱藏行為。即使重建版並不等同原始碼,這種從分析到重新實作的跨階段能力,仍會降低某些功能型軟體被做出替代版本的門檻。
被誇大:REA 不是憑空創造逆向能力
被誇大的第一件事,是能力歸因。REA 位於 agent 與 IDA、Ghidra、Hopper 等工具之間,依影片介紹,透過 MCP 提供統一介面,以 skill 指導分析流程,並整理結果與證據。這些都可能改善工作流,但實際反編譯、偵錯與環境執行仍由底層工具和主機完成;分析策略與程式生成則主要由模型負責。稱它為編排層,比稱它為一個全新逆向引擎更準確。
被誇大的第二件事,是把探索性展示當成 benchmark。影片中的樣本由同一位操作者設計,輪次之間存在資訊累積,第五輪還直接利用主機殘留的舊原始碼與樣本;又沒有安排同模型、無 REA 的控制組。影片提到安裝後出現 100 多個工具、工具描述占用 100K 以上 tokens,這也是講者在該環境中的觀察,不是任何安裝都必然出現的通用基準。這些數字很適合描述案例,不足以單獨建立產品效能結論。
被誇大的第三件事,是「成功」的語意。第五輪成功找到密碼,卻沒有拆開 VMP;第六輪依靠執行期資料與先前理解完成任務,也不等於正面破解保護;2048 重建能重現主要行為,仍不是原始碼還原。若傳播只保留「成功」而刪掉路徑,agent 的廣度會被誤寫成每一項底層技術都已被攻克。
仍有限:高強度虛擬化、證據品質與評測可重現性
仍有限,最直接的證據是第七輪。影片使用 VMP 3.8.4 對校驗邏輯開啟虛擬化後,agent 在 54 分 22 秒的展示時段內沒有取得密碼,並表示若繼續可能需要數小時且不保證成功。這不能證明 AI 永遠無法處理虛擬化,也不能證明所有 VMP 配置都同樣有效;它只證明在這次條件下,技術難度沒有被 agent 自動化消除。
仍有限,也表現在證據與評測。agent 可以快速產生大量中間步驟,但中間步驟不等於可靠證據。分析者仍需檢查資料來源、候選解釋、重建行為與實際程式是否一致,並防止把舊檔、測試污染或環境旁路誤認為核心機制被理解。REA 整理證據的設計方向在此有價值,但影片沒有量化其正確率、遺漏率或可重現性,因此成效仍未驗證。
最後,模型選擇也構成限制。影片使用 DeepSeek Harness,講者推測若換更強模型可能有更好表現,但沒有實際對照。不同模型、上下文長度、工具權限與停止條件可能大幅改變結果。任何「AI 已經能」或「AI 還不能」的判斷,都應附上條件與日期,而不是把單次展示寫成永久能力邊界。
防線從「藏住程式」移向「重新設計價值」
講者在影片結尾提出兩個方向:如果商業軟體依靠服務收費,可把核心能力放到雲端,避免完整邏輯直接交到端側;若核心功能必須留在端側,則考慮以 VMP 等高強度虛擬化提高分析成本。這是講者基於測試提出的建議,不是對所有產品都適用的處方。雲端化會引入成本、延遲、離線能力、隱私與合規問題;端側虛擬化則可能增加效能與維護負擔,而且影片也沒有證明任何保護能提供永久安全。
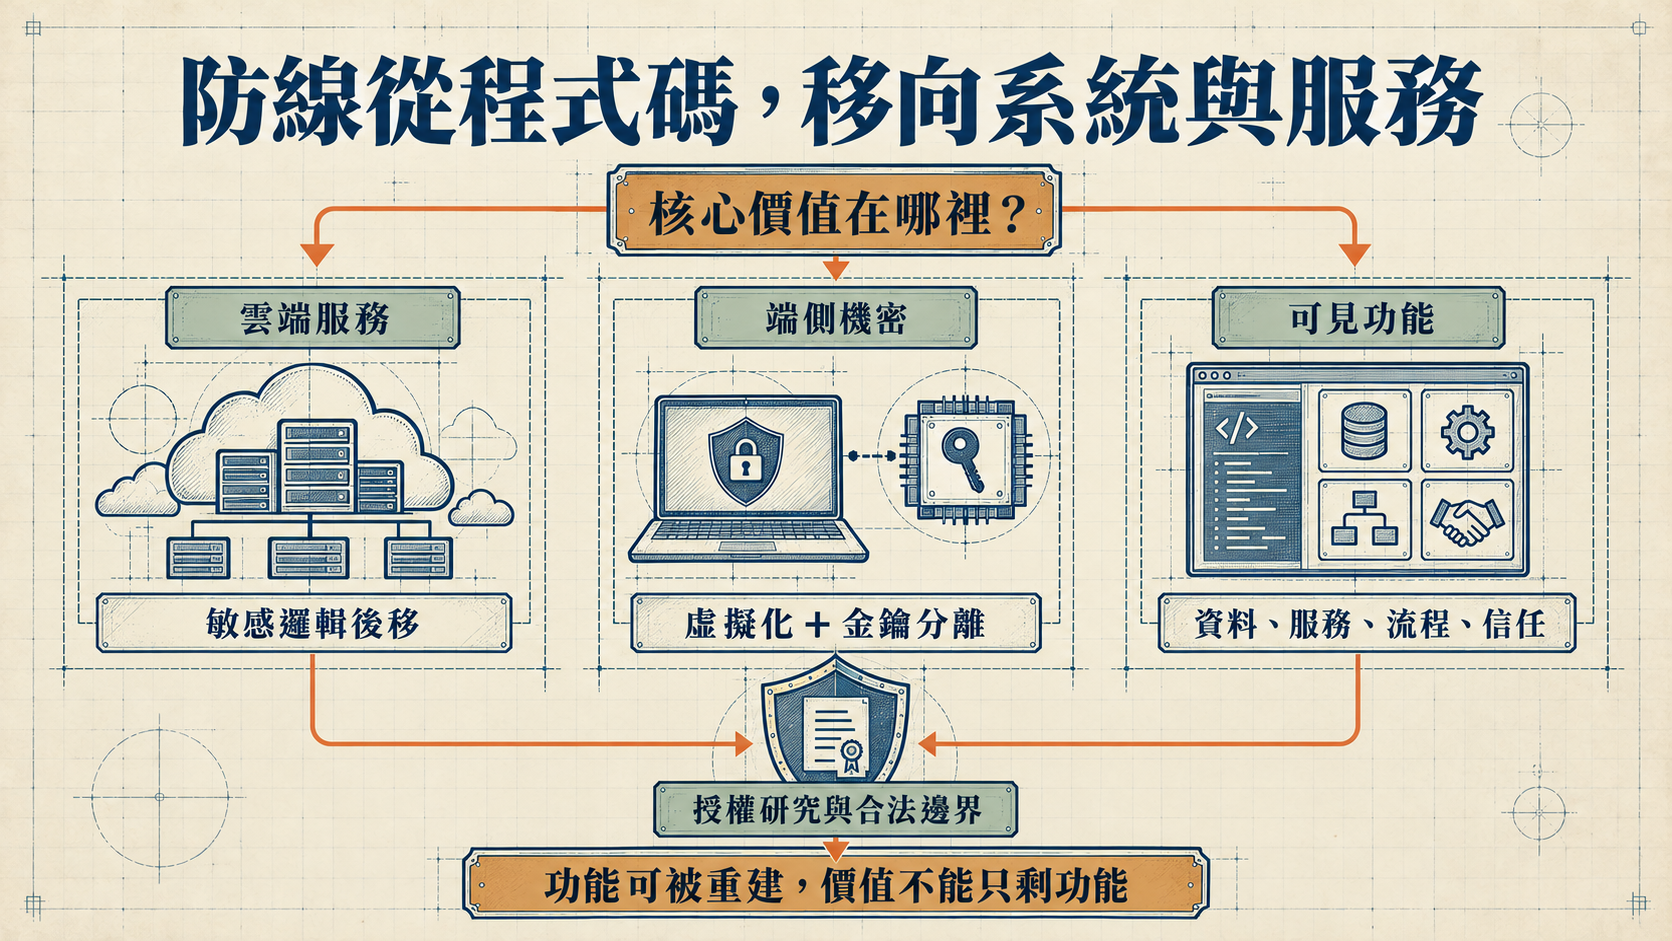
比較穩健的防禦觀,是承認端側程式一旦交付給使用者,就很難把「永遠不可觀察」當作唯一假設。保護技術仍然有價值,因為提高成本、延長分析時間與縮小可攻擊面,本來就是安全工程的重要目標;但它應與權限最小化、敏感資料治理、服務端驗證、更新機制、監測、法務與授權策略共同設計。哪些措施適合,必須依產品威脅模型、使用者權益與法規要求評估。
商業防線也不只存在於程式碼。當使用者選擇一項軟體時,他們購買的可能是可靠性、持續維護、資料可攜、協作關係、客服承諾與長期信任。這些價值不會因 agent 能重建一個小型功能就自動消失。反而是只把收費理由建立在「別人短期內寫不出這個功能」上的產品,會更直接感受到 AI 降低實作成本的壓力。
因此,影片最後那句「軟體產業的天沒有完全塌,但也塌了一半」,適合被讀成提醒,而不是判決。塌掉的那一半,是依賴資訊不對稱、重複體力與高原型成本形成的部分門檻;仍然站著的另一半,則是深度工程、可信服務、複雜營運、法規責任與持續創新的長期工作。兩者比例無法由這支影片精確量化,「一半」是講者的修辭,不是產業統計。
最後的判讀:真的強/被誇大/仍有限
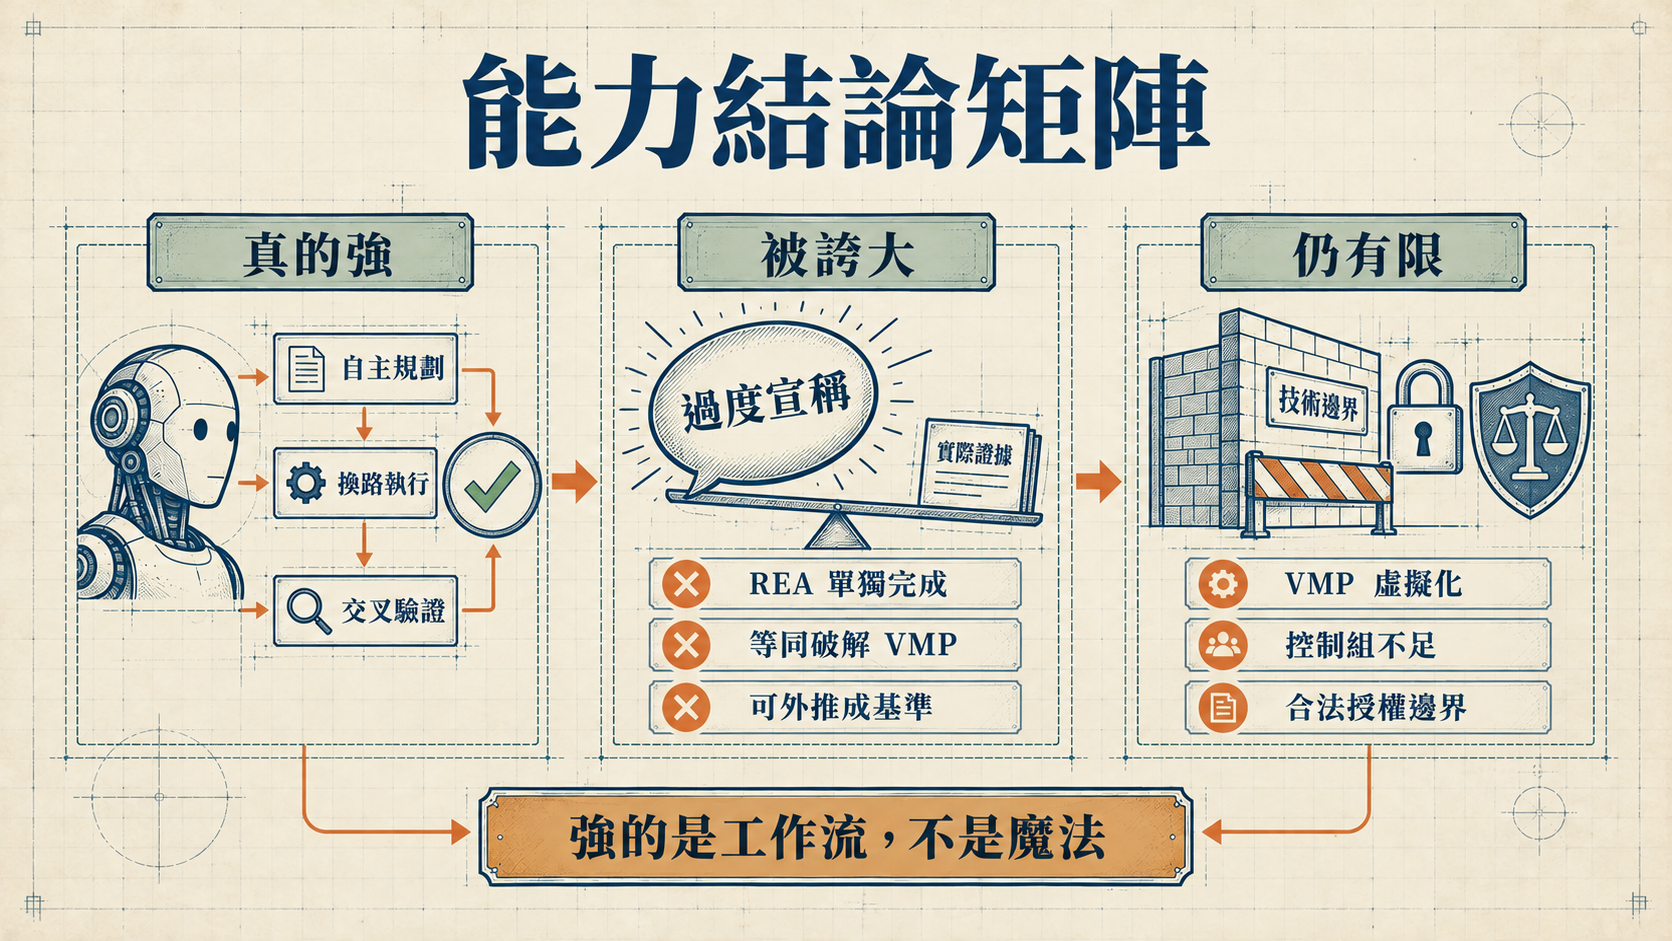
真的強:AI agent 已能在成熟分析工具之上,連續完成定位、理解、寫腳本、切換路徑與正向驗證;它也能把分析結果帶進功能重建。真正變強的是多工具被串成可驗證行動鏈後的總體能力。
被誇大:REA 是有價值的介面、skill 與證據編排層,但不是所有逆向能力的唯一來源;單次自製樣本實驗也不是通用 benchmark。沒有控制組,就不能把模型、IDA、LLDB、Wine、Harness 與主機環境的成果全算給 REA。
仍有限:VMP 3.8.4 虛擬化在影片限定時間內守住了邊界,功能重建也未等同完整原始碼或產品等價。模型會換路,但不代表每條路都能走通;它會產生結果,也不代表結果不需人類審查。
這三句放在一起,才是比「逆向一切」更接近現況的描述。對研究者而言,agent 是一個能擴大工作半徑的協作者;對產品團隊而言,它迫使防禦與商業價值往更深層移動;對所有使用者而言,能力越強,合法授權、證據可追溯與責任邊界就越不能被省略。
💡 給讀者的 Takeaway
- 真的強:多工具規劃、失敗恢復、腳本生成與正向驗證已能形成長時間自動化工作流。
- 被誇大:REA 是編排層;影片沒有無 REA 控制組,不能把所有成果都歸功於它。
- 仍有限:VMP 3.8.4 虛擬化測試在限定時間內未成功,其他模型與更長投入的結果未驗證。
- 防禦不該只押注「程式碼藏得住」,而應把保護技術、服務設計、資料治理、維運與信任一起納入。
- 所有測試時間與成敗都屬影片案例紀錄;它們能揭示能力形狀,不能直接當成產業普遍性能。