0. 不是新大模型|Fugu 的重點是把「選模型」本身訓練成模型能力
我們之前已經整理過 Nate Herk 的 Fugu Ultra 實測,那篇重點在結果面:Fugu Ultra 跟 Opus 4.8 在測試中多數平手,但更慢、更貴,所以現階段未必是每個 coding workflow 的最佳預設。
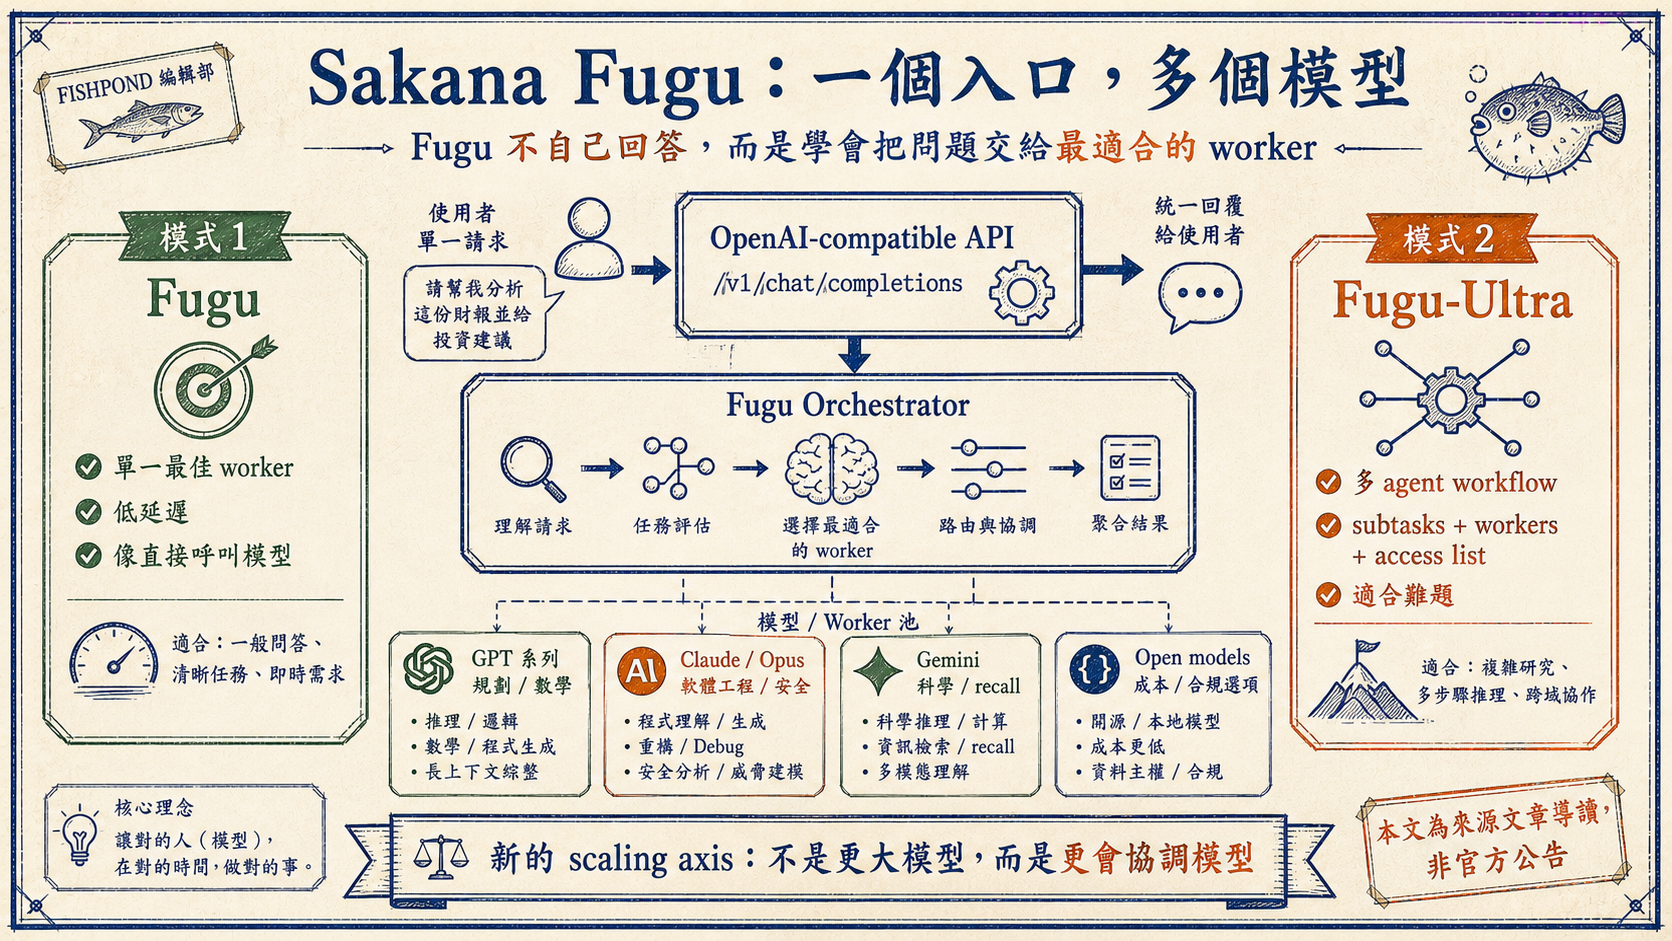
這次 Cahid Arda Öz 的文章 補上的是另一塊:Fugu 到底怎麼工作?它不是一個「比 GPT、Claude、Gemini 都更強的新 frontier model」,而是一個把多個模型包成單一 API 的 orchestration layer。使用者像呼叫單一模型一樣送 request;內部則由 Fugu 決定該交給哪個 worker,或在 Fugu-Ultra 裡組出一整個多 agent workflow。
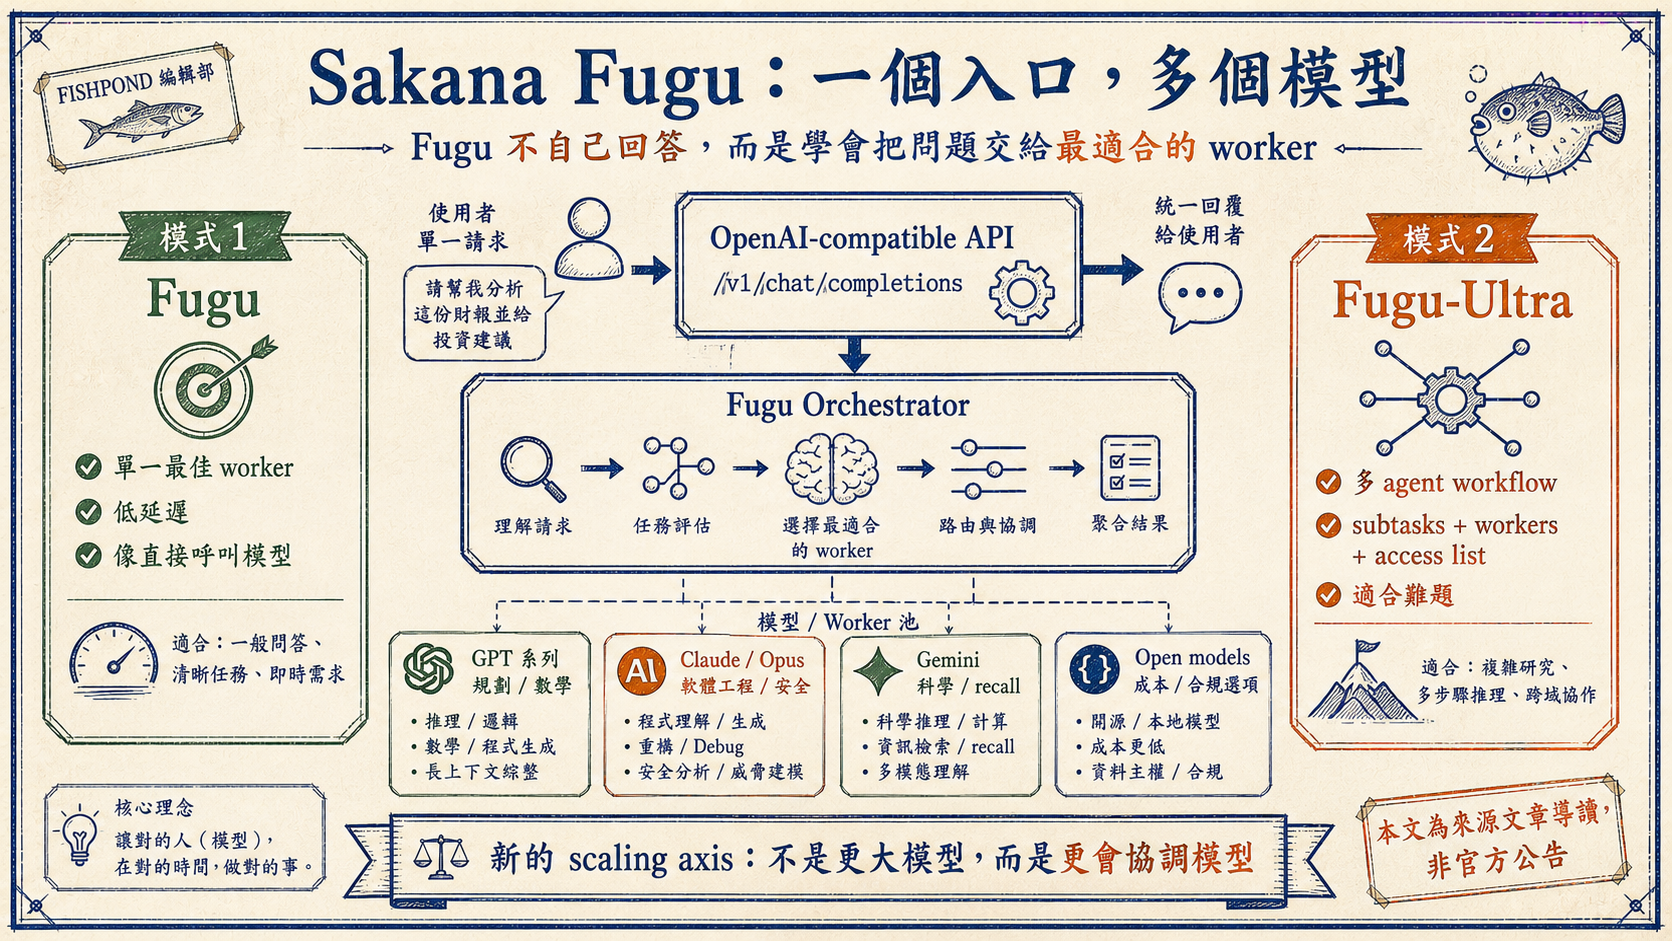
這個差異很重要。傳統 scaling 想像是:訓練更大模型、塞更多資料、跑更長 compute,讓單一模型更強。Fugu 押的是另一條 scaling axis:既然 frontier models 已經開始分工,GPT 系列可能更擅長規劃與數學,Opus 系列可能更擅長軟體工程與安全,Gemini 可能更擅長科學與 recall,那就訓練一個系統去理解「誰適合做什麼」。
文章開頭也先提醒兩件事。第一,Fugu 不是從零訓練 frontier weights,它是 orchestrator。第二,它是 hosted API,不是可以下載本地跑的模型。也就是說,Fugu 的價值和風險都在調度層:它能不能把正確任務交給正確模型?它的 routing 是否可信?使用者能不能理解它為什麼這樣調度?
1. Fugu 快版|只輸出選擇,不輸出答案
Fugu 的快速版建立在 TRINITY 這個 coordinator 思路上。它由兩個小元件構成:一個約 0.6B 的 language model backbone,以及一個約 10K parameters 的 tiny head。backbone 讀入使用者 query,形成 hidden state;head 把 hidden state 轉成每個 worker 的分數,再透過 softmax 選出要 dispatch 的 worker。
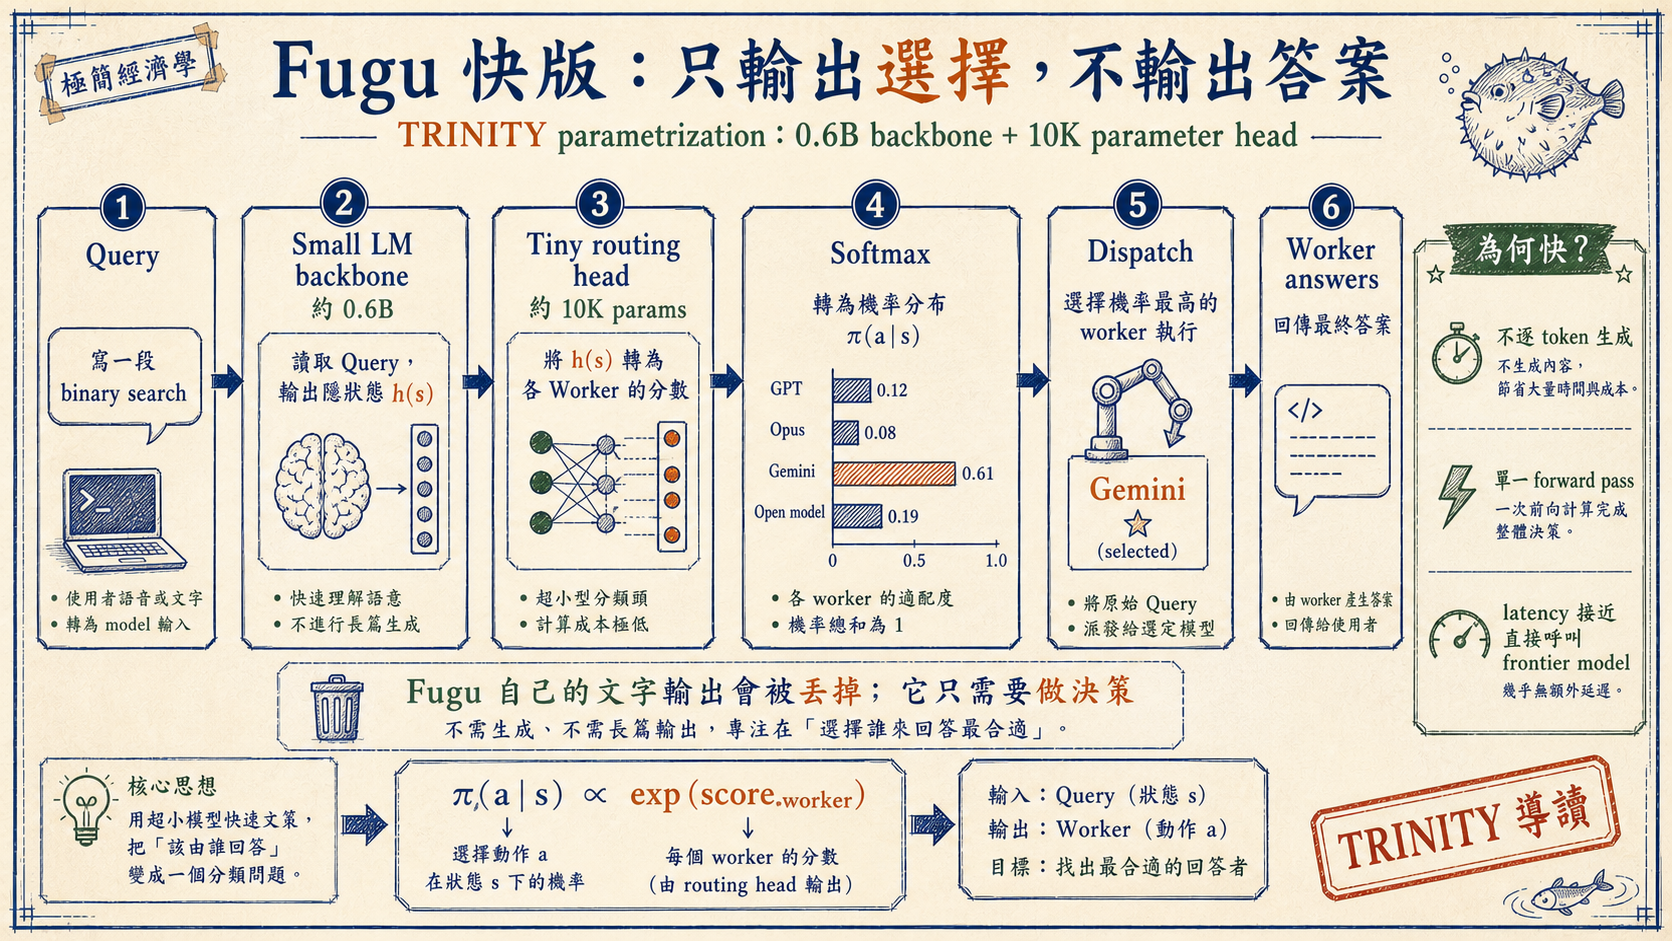
最巧妙的地方是:Fugu 自己不需要生成答案。一般 LLM 要逐 token 生成文字,這是昂貴且慢的;但 Fugu 的工作不是回答問題,而是做決策。它可以讀完 query 後直接從內部向量做 routing,自己的文字輸出甚至會被丟掉。文章引用 TRINITY 的說法:coordinator generated text is discarded,因為 prompt 的工作被委派給 worker pool。
這也是為什麼 Fugu 能主打低延遲。它不在 orchestrator 層寫一大段 plan,也不讓多個 worker 同時辯論。它只是判斷:這個 query 最適合哪個 worker?然後把請求交出去。因此它比較像「訓練出來的 router」,而不是「會回答問題的小模型」。
原始 TRINITY 架構可以更複雜,包含 Thinker、Worker、Verifier 角色,也能 loop 多輪;但 production Fugu 根據來源文章的描述,選擇了更簡化的版本:單一 worker、沒有角色、立刻 dispatch。這讓它更像現實可用的 API endpoint,而不是研究 demo 裡的完整 multi-agent system。
2. 怎麼訓練 router|先學誰會解,再用 evolution 找誰能完成
Fugu 的訓練問題很有趣:你要怎麼訓練一個 head,讓它知道哪個 worker 適合哪種問題?來源文章把流程拆成兩階段。
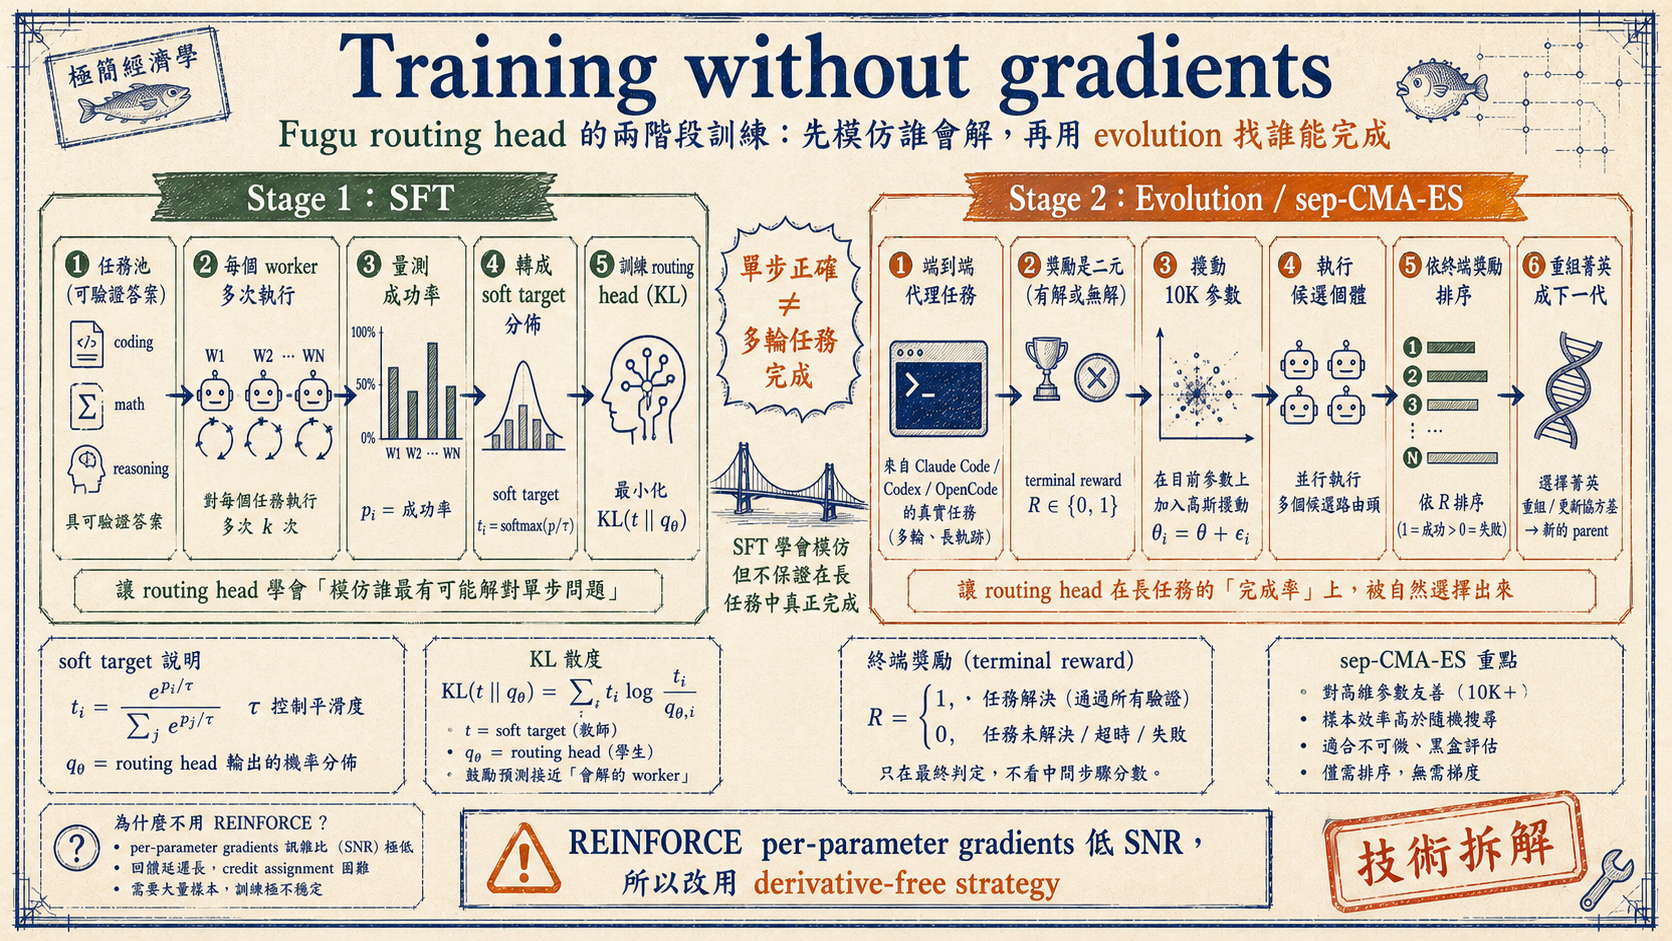
第一階段是 supervised fine-tuning。標籤不是人類手寫,而是從 verifiable tasks 來。Sakana 先準備一批 coding、math、reasoning 任務,每題有可驗證答案;接著讓每個 worker 跑多次,量測誰真的能解。這些成功率不會被壓成單一「最佳模型」標籤,而是轉成 soft target distribution。換句話說,head 學的不是「永遠選 GPT」,而是「在這類題目上,各 worker 成功機率大概如何」。
第二階段是更接近真實 agent 任務的訓練。單步題目答對不代表多輪 coding assistant 任務會完成,所以 Fugu 進一步用 Claude Code、Codex、OpenCode 這類 end-to-end tasks 來評估。reward 很粗暴:任務最後完成就是 1,沒完成就是 0。
難點在於,routing head 雖然只有約 10K parameters,但每個參數對最後 binary reward 的影響都很小,傳統 policy-gradient 方法像 REINFORCE 會遇到低 signal-to-noise ratio。來源文章說,TRINITY 因此跳過 gradients,改用 evolution strategy,也就是 sep-CMA-ES:把整個參數向量 perturb 成很多候選版本,跑真實任務,依 reward 排名,再把表現好的 candidate recombine 成下一代 parent。
這裡的直覺很像「不要問每個參數該怎麼微調,直接問哪一整組 router 行為更會完成任務」。對 orchestration 來說,這是合理的:你真正關心的是整段 workflow 最後是否成功,而不是單一步驟看起來是否漂亮。
3. Fugu-Ultra|Conductor 不是 router,而是 workflow writer
Fugu 快版只選單一 worker;Fugu-Ultra 處理的是更難的問題。來源文章說,Fugu-Ultra 背後的 Conductor 是一個完整 language model,在 paper 裡約 7B。它不是只輸出一個 worker id,而是會寫出一整個 agentic workflow。
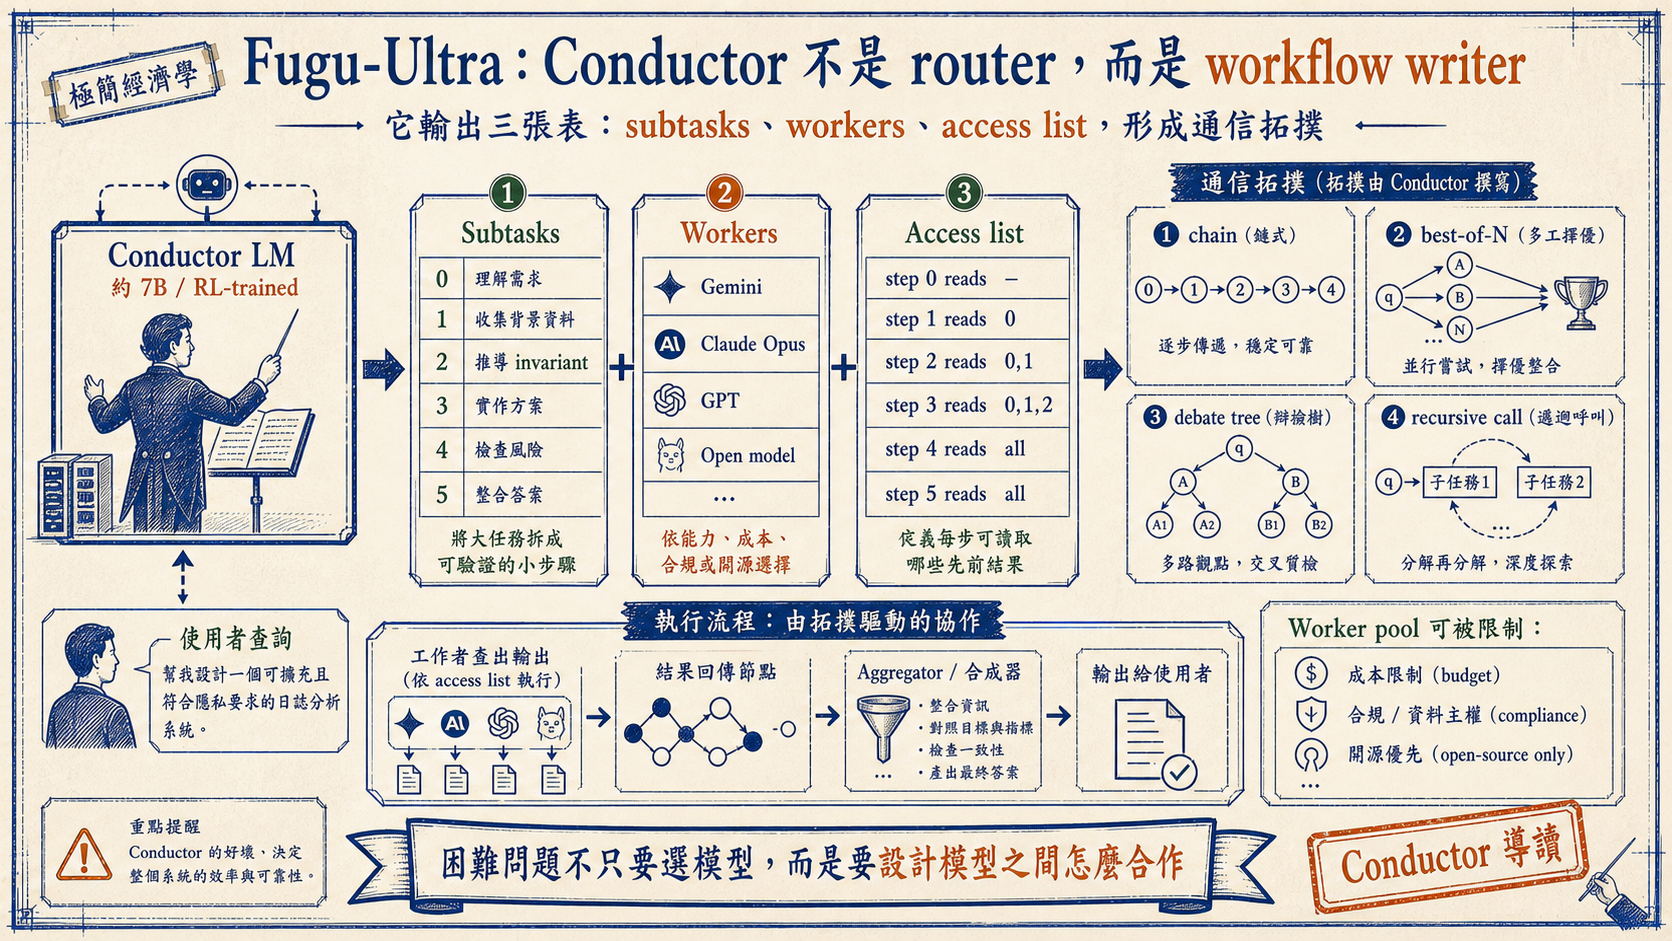
Conductor 的輸出可以理解成三張 aligned lists:subtasks、workers、access list。subtasks 描述任務怎麼拆;workers 指定每一步由哪個模型做;access list 則規定每個 worker 可以讀取哪些前面步驟的輸出。這個 access list 很關鍵,因為它定義了 communication topology。
不同 topology 會形成不同協作模式:chain 是一步接一步;best-of-N 是多個 worker 同時嘗試,再由 aggregator 整合;debate tree 讓不同答案互相交叉質詢;recursive call 則允許某些子問題再分解。這比「把同一個 prompt 丟給三個模型再合併」更細緻,因為它把模型之間的資訊流也納入設計。
Conductor 的訓練也更像 workflow-level RL。來源文章提到它用 GRPO,reward 很 blunt:列表 parse 失敗是 0,格式正確但答案錯是 0.5,正確是 1。這讓模型學到的不只是選誰,而是如何寫出能被執行、且真的能解題的 workflow。
另一個重要細節是 worker pool 可以被限制。若你因成本、合規、資料主權或供應商政策不想用某些 worker,Conductor 理論上可以在被允許的模型池裡重新組合能力。來源文章提到,即使 restricted to open-source models,fine-tuned Conductor 仍可把較弱 open models 組合出超出單一模型的效果。這個主張若成立,代表 orchestration 的價值不是單純「偷用最強模型」,而是真的能從互補性裡榨出能力。
4. 浮現的策略|好的 orchestrator 像工程 manager,不只是 switch statement
來源文章最有趣的部分,是那些不是人手 hard-code 出來的策略。Fugu-Ultra 的 qualitatively emergent patterns 看起來很像一個懂分工的 engineering manager。
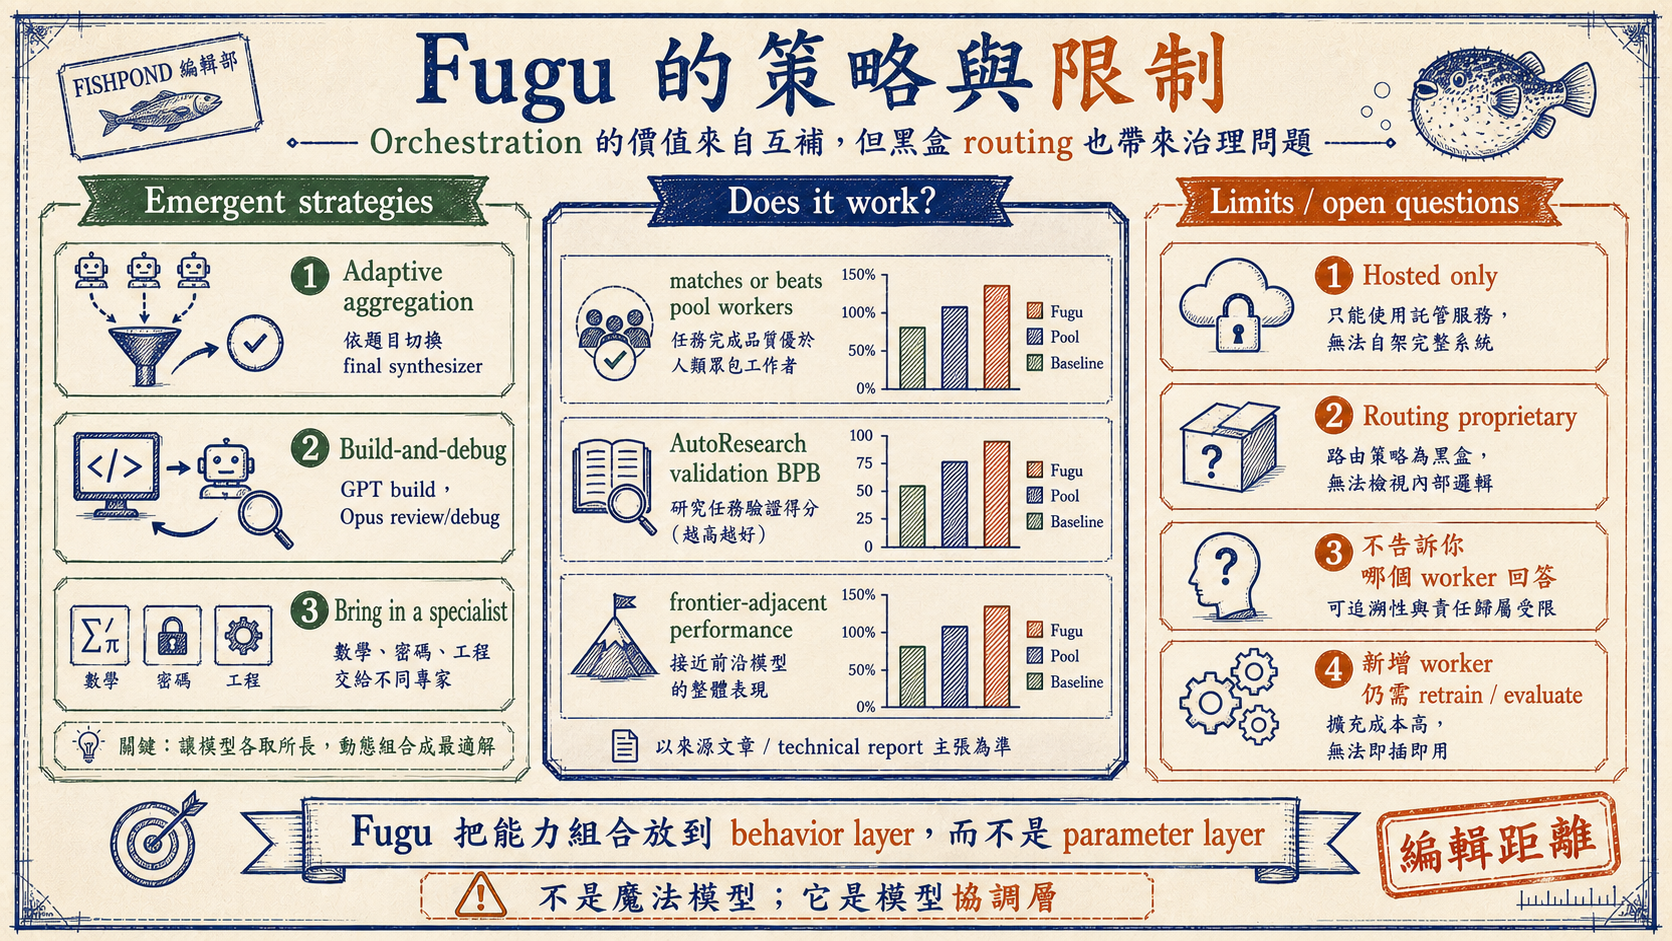
第一種是 adaptive aggregation。不是固定永遠讓某個模型當 final synthesizer,而是依題目切換 aggregator。例如某些 trivia 題可以讓 Gemini 做整合,某些 math 題則換 GPT 做 final role。這代表 system 不只知道 worker 擅長什麼,也知道什麼時候該讓誰收尾。
第二種是 build-and-debug。來源文章提到一個 Terminal Bench 任務,GPT 先 build,一個 Opus worker 再 enumerate implementation risks,找出幾個真 bug 和一個 bogus reachability check,最後把 findings 回傳給 GPT 完成 build。這種模式很像人類工程團隊:一個人實作,另一個人 review/debug,再回到原作者修正。
第三種是 bring in a specialist。對 cryptanalysis 或數學問題,Fugu-Ultra 可以讓某個模型先提出攻擊或解法,再叫另一個模型以 math specialist 角色從 first principles 重新推導。重點是,不同 worker 不是被平均使用,而是被放在不同 cognitive role 裡。
這些策略說明了為什麼 Fugu 不只是 router。如果只看 Fugu 快版,它像低延遲選模型;但 Ultra 真正押的是「workflow design as model output」。困難任務往往不只是需要最強模型,而是需要正確拆解、正確分工、正確資訊流、正確整合點。
5. 限制與治理|黑盒 routing 是產品優勢,也是使用者風險
來源文章對 Fugu 的敘述偏技術正面,但仍能看出幾個治理問題。
第一,Fugu 是 hosted,不是 download。這意味著你不能在本地跑它,也不能完全掌握 routing 行為。對企業和高敏感資料場景來說,這不是小事。
第二,routing proprietary,而且 API 不一定告訴你底層哪個 worker 回答。這讓它像單一模型一樣易用,但也犧牲可解釋性。若結果出錯、成本飆高、latency 異常,使用者很難知道問題出在哪個 worker、哪段 orchestration 或哪個 topology。
第三,新增 worker 仍然需要 retrain / evaluate。來源文章說,因為 Fugu 在 behavior layer 組合模型,不需要取得 worker weights;只要 API 可用,就能納入。但 orchestrator 仍要學 newcomer 的 strengths,routing head 也要對 worker 產生分數。因此這不是 plug-and-play 到完全零成本,而是比重新訓練 foundation model 更輕的更新流程。
第四,benchmark 需要保留距離。來源文章引用技術報告主張:Fugu models 可以 match or beat pool workers,AutoResearch 上 Fugu-Ultra 也有漂亮數字。但在實際產品選型裡,仍要回到任務類型、成本、延遲、可觀測性、合規需求。上一篇 Nate 實測正好補上這個角度:在某些 coding assessment 裡,Fugu 的品質提升不一定能抵銷慢和貴。
所以魚塘對 Fugu 的暫時結論是:它不是魔法模型,而是一個把模型協調層產品化的嘗試。它真正值得關注的,不只是這一版 API 是否划算,而是它把 AI tool stack 的下一個問題講清楚了:當模型專長開始分化,誰來做 manager?這個 manager 要如何訓練、如何驗證、如何觀測、如何治理?
如果單一 frontier model 是「更大的腦」,Fugu 代表的是「更會組織腦的系統」。下一輪 AI 工具競爭,可能不只比誰的模型最聰明,而是比誰最會把一群模型變成一個可靠、可控、可負擔的工作團隊。
本文為 Cahid Arda Öz〈Sakana Fugu: Multi-Agent Orchestration Explained in Detail〉的繁中導讀與編輯整理,不轉載原文全文。完整互動圖、公式與引用請閱讀原文:https://cahidarda.github.io/articles/sakana-fugu