010. 導言|「Fable Killer」標題底下,其實是成本問題
這支 Nate Herk 的影片標題很會下:I Battle Tested Sakana Fugu's Fable Killer。
如果只看標題,很容易期待一場新模型屠榜:Sakana AI 推出 Fugu Ultra,號稱能匹敵 Fable、Mythos,甚至在 benchmark 上超過 GPT、Opus 等 frontier model。於是問題來了:它是不是下一個大家都該立刻換上的 coding agent 模型?
Nate 的實測答案比較冷靜:不一定。
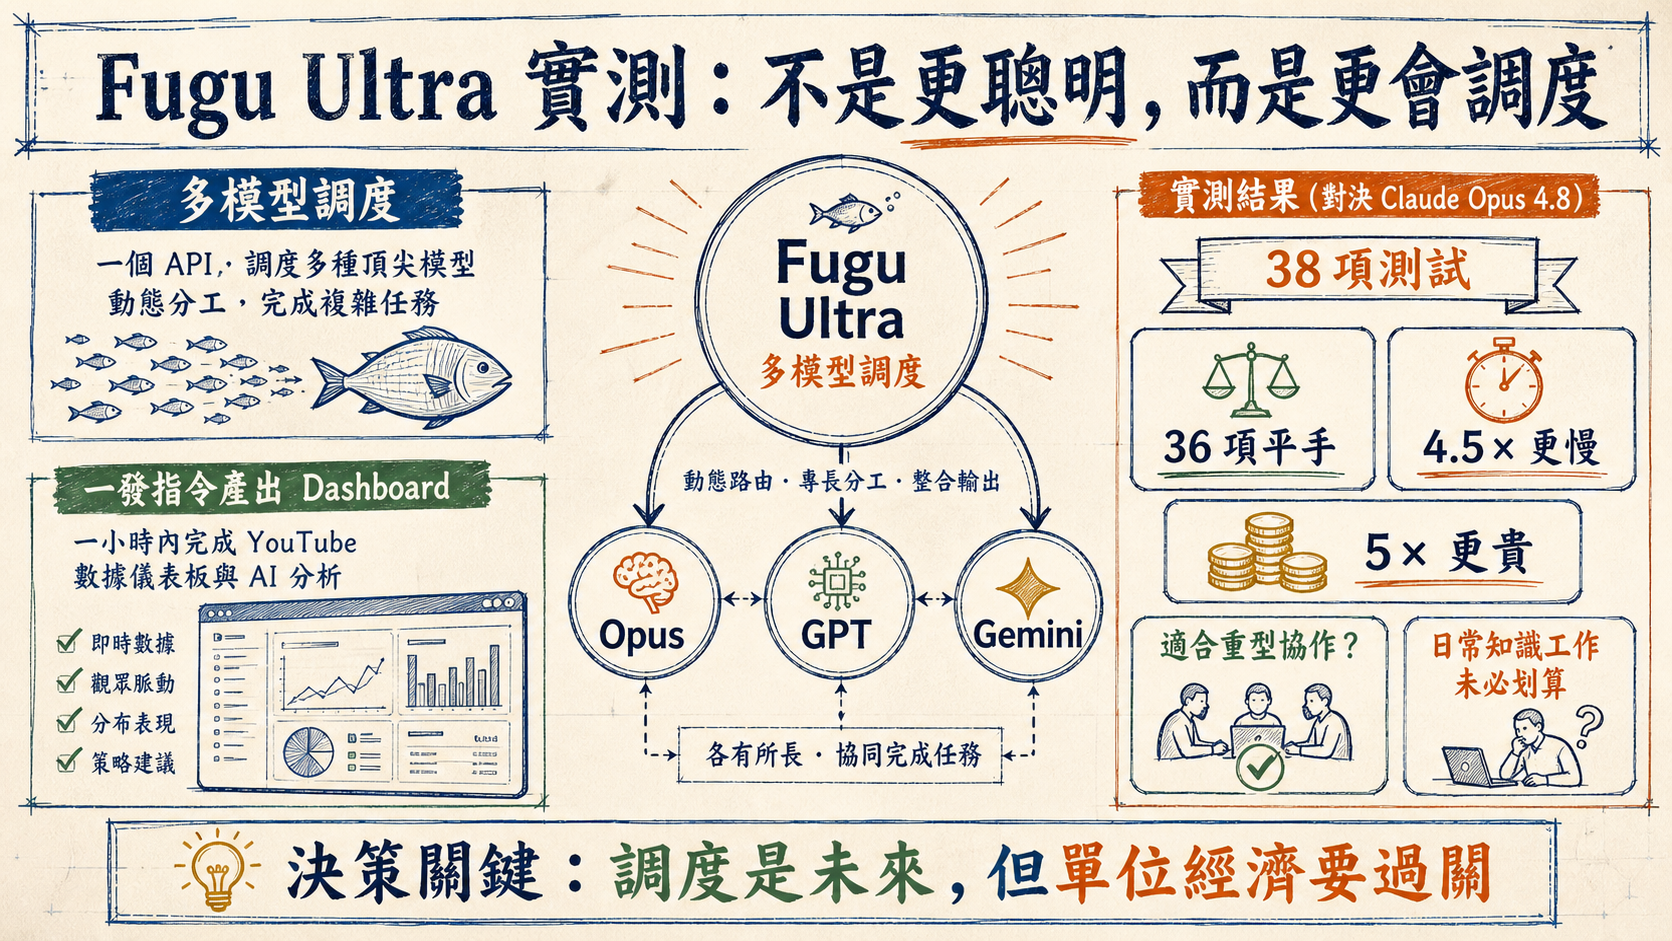
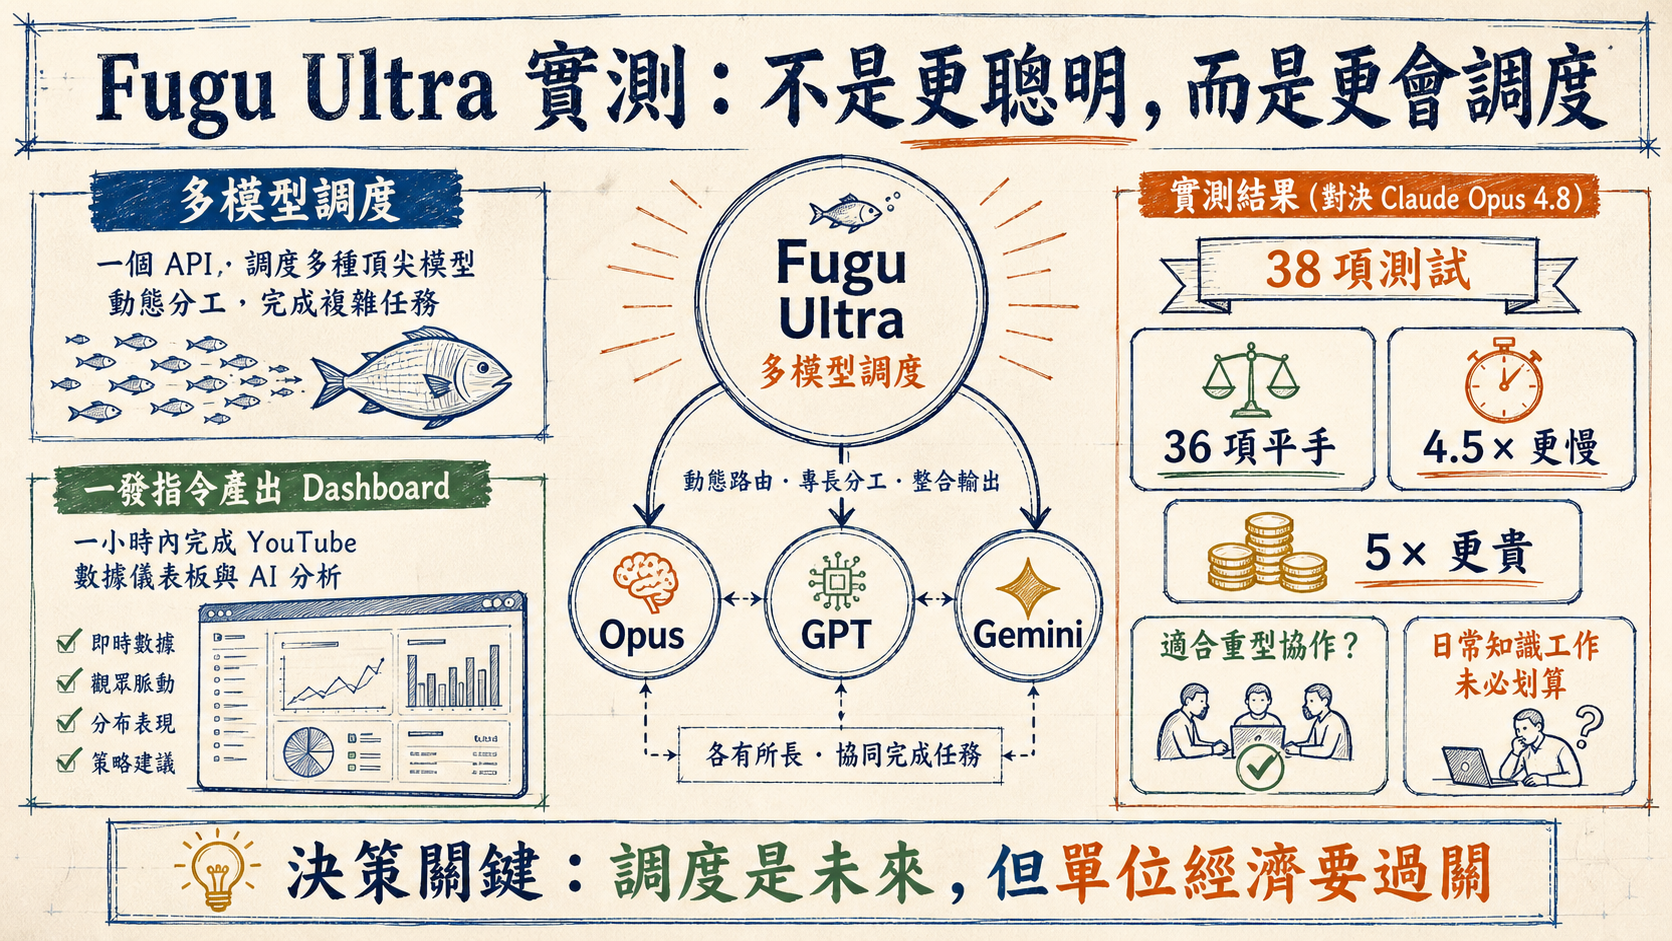
他一開始確實展示了很漂亮的成果。用 Fugu Ultra 跑一個 one-shot slash goal prompt,將近一小時後產出一個 YouTube dashboard:能刷新 live data、看 audience pulse、distribution、performance、影片 metrics、comments、strategy,還有 AI analysis 和 recommendations。對單次任務來說,這個結果很亮眼。
但影片真正重要的地方,不是那個 dashboard,而是後半段的拆解:Fugu Ultra 不是一個「比 Fable 更聰明的新大模型」。它更像一個 manager API,會把任務拆開,路由給 Opus、GPT、Gemini 等不同模型,再把結果整合回來。
也就是說,這是一個 orchestration 產品。問題不只在「結果好不好」,還要問「為了這個結果,你多等多久、多付多少」。
來源影片在這裡:Nate Herk:I Battle Tested Sakana Fugu's Fable Killer。
021. Fugu Ultra 是什麼|一個 API 包起來的多模型調度器
Nate 對 Fugu 的解釋其實很清楚:Sakana AI 是一家日本公司,Sakana 是魚;產品示意圖裡有很多小魚組成一條大魚。這個比喻很準,因為 Fugu 的核心不是單一模型,而是「多個模型協作成一個輸出」。
他說,Fugu Ultra 背後會動態協調不同 frontier models,例如 Opus、GPT、Gemini,也可能還有其他模型。使用者打的是一個 API,但裡面有一個 manager model 或 conductor,負責把任務拆成幾部分,決定哪個模型做哪一段,再把輸出合併。
這個模式其實不陌生。
如果你用過 Claude Code 的 sub-agents、dynamic workflows,或在同一個 codebase 裡手動切換 Codex、Claude、Gemini,你已經在做類似的事。差別只是:過去是你自己判斷哪個模型適合做哪件事;Fugu 想把這個判斷自動化。
Nate 用一個很好的對照說明 orchestration 的光譜。光譜左邊,是人類自己寫完整計畫、自己決定誰做什麼。光譜右邊,是模型自動拆任務、自動分派、自動整合。Fugu Ultra 站在更靠右的位置。
所以它的價值主張不是「我本身更聰明」,而是「我知道什麼時候該叫誰來做」。
032. 與 OpenRouter Fusion 的差別|投票不等於分工
Nate 也把 Fugu Ultra 和 OpenRouter Fusion API 做了區分。
Fusion 類型的做法,是把同一個 prompt 同時丟給三個模型,讓它們各自回答,再由 judge 或 merger 合成一個結果。這能帶來多視角,也常能提升輸出品質,但它不是真的任務分工。
Fugu Ultra 的概念比較接近 conductor:先理解任務,再把不同子任務交給不同模型。例如 Claude 做文字或規劃,GPT 做 coding 和 bug fixes,Gemini 做 research 或 factual work。最後再用另一個 LLM 把這些輸出整合。
差別很重要。
「同題多答」適合需要多個觀點互相校正的場景。「任務拆分」則適合複雜工作流:一部分要寫 code、一部分要查資料、一部分要做設計、一部分要審查。Fugu Ultra 押的是後者。
這也是為什麼 Nate 會說,這不是全新概念,但包得很漂亮。對已經熟悉多 agent workflow 的人來說,Fugu 像是把你本來手動做的調度包成一個 API。
043. 實測結果|38 項任務,36 項平手
影片中最硬的資訊,是 Nate 拿 Fugu Ultra 和 Claude Opus 4.8 做的對照測試。
他表示自己讓 Codex 建了一組測試,避免自己主觀挑題。測試分成四波,包含 puzzles、traps、specs、heavy algorithms,共 38 項任務。Fugu 和 Opus 4.8 都拿到相同 prompts 和 inputs,最後由 Codex grading。
結果是:36 項平手,只有 2 項 Opus 贏。
這個數字的解讀要小心。它不代表 Fugu 沒用,也不代表 Opus 在所有情境都一定更好。Nate 自己也提醒,他沒有把 Fugu 推到非常重型的 production refactor 或大型團隊協作場景;這些測試多半是 AI 生成的 assessments。
但就他的 use case 而言,結果很清楚:Fugu Ultra 沒有帶來「明顯更好」的輸出品質。
更有趣的是,Fugu Ultra 內部可能本來就會使用 Opus 4.8。Nate 也提到,他做的一些 HTML decks 和 dashboard 裡,有相當比例可能是 Opus 4.8 完成的。所以拿 Fugu 和 Opus 比,不是兩個完全隔離的模型在比;某種程度上,是「直接用 Opus」對上「讓一個 manager 決定何時用 Opus 和其他模型」。
如果 manager 沒有帶來明顯品質提升,那成本和速度就會變成決策核心。
054. 真正的敗點|4.5 倍慢、5 倍貴
Nate 最不滿意的地方不是品質,而是速度與成本。
他測得 Fugu Ultra 在整體上約 4.5 倍更慢。38 項任務中,Fugu 的總等待時間是 357 分鐘,Opus 則是 80 分鐘。他也提到,有些很簡單的任務,Opus 可能 6 秒回答,Fugu 卻花好幾分鐘。
成本也是同樣方向。Nate 表示,在這些 API calls 裡,Opus 大約花 $10,Fugu 大約花 $50,也就是約 5 倍。
這並不難理解。Fugu 會調用多個模型,還要跑更久,成本自然上升。多視角、多模型、更多中間步驟,都不是免費的。問題是:你有沒有拿到對應的品質提升?
在 Nate 的測試裡,答案偏向沒有。
他也分享了訂閱限制的感受:自己升到每月 $200 plan,填滿 5-hour window 後,週限額已經用到 34%;若在 $100 plan 下填滿三個 5-hour windows,可能就接近 weekly limit。這讓他覺得 Fugu 比 Claude Code subscription 更快吃滿額度。
這段對工具選型很實用。很多 AI 工具 demo 都會展示「能做什麼」,但真正落地時,更常決定是否採用的是「每次做要花多久、多少錢、可不可預期」。
065. 什麼情境可能適合 Fugu|重型協作,不是日常知識工作
Nate 的結論不是「Fugu 爛」。相反地,他認為 Sakana AI 做的方向很值得追。
他自己的判斷是:對日常 knowledge work,他不會用 Fugu Ultra。原因很簡單:他從 Codex subscription 和 Claude Code subscription 得到的價值更高,而且速度更舒服。Fugu 在他的日常工作裡感覺 solid,但太慢。
但他也留了一個可能的適用場景:重型軟體開發、大型團隊、同一個 codebase 上有許多角色協作時,Fugu 可能有價值。因為你可能真的需要一個 GPT reviewer、一個 Claude planner、一個 Gemini researcher,還有一個 manager 幫你把它們整合成一致結果。
換句話說,Fugu Ultra 的合理定位可能不是「每個人日常都該替換掉現有工具」,而是「當任務複雜到人工調度成本很高時,讓 orchestration layer 替你做模型分工」。
這也回到 AI 工具的一個老問題:抽象層越高,越省心,但也越貴、越慢、越難精準控制。對很多個人使用者,手動在 Codex、Claude Code、Gemini 之間切換可能已經夠好;對某些團隊,自動化調度才值得買。
076. 真正值得學的是單位經濟|未來不是單模型勝出
影片最後,Nate 的觀點其實很成熟。
他說 Fugu Ultra 對他的使用情境不是答案,但「不鎖死在單一 provider」會是未來。更重要的是,理解 unit economics:每個任務用哪個最便宜的模型,不犧牲品質,會變成非常重要的技能。
這句話比「Fugu 打敗 Fable」更值得記。
AI 工具正在從「選一個最強模型」進入「設計一套模型調度策略」。有些任務需要最強推理,有些只需要便宜快速的 reviewer;有些要長 context,有些要工具穩定;有些適合 parallel sampling,有些適合明確分工。未來強的人,不一定是只會喊最新模型名稱的人,而是能把品質、速度、成本、可靠性放在同一張表上算的人。
Fugu Ultra 這次在 Nate 的測試中不划算,但它代表的方向很重要:model routing、multi-agent orchestration、成本最佳化,會逐漸成為 AI 工程的基礎設計問題。
結論可以很簡單:
Fugu Ultra 不是「更聰明的 Fable killer」。它更像「替你自動調度多個模型的 conductor」。這個方向是未來,但至少在 Nate 這次實測裡,日常知識工作還沒必要為它付 4.5 倍時間和 5 倍成本。
給讀者的 Takeaway
- Fugu Ultra 的核心不是單一新模型,而是把 Opus、GPT、Gemini 等模型包成一個自動分工的 orchestration API。
- Nate 的 38 項測試裡,Fugu 與 Opus 4.8 有 36 項平手;品質沒有明顯拉開。
- 實測最大問題是成本和速度:Nate 測得 Fugu 約 4.5 倍慢、5 倍貴。
- Fugu 可能更適合重型協作或複雜 codebase 場景,不一定適合一般日常 knowledge work。
- 未來 AI 工具選型的關鍵,不只是追最新模型,而是懂得在品質、速度、成本之間做 unit economics。