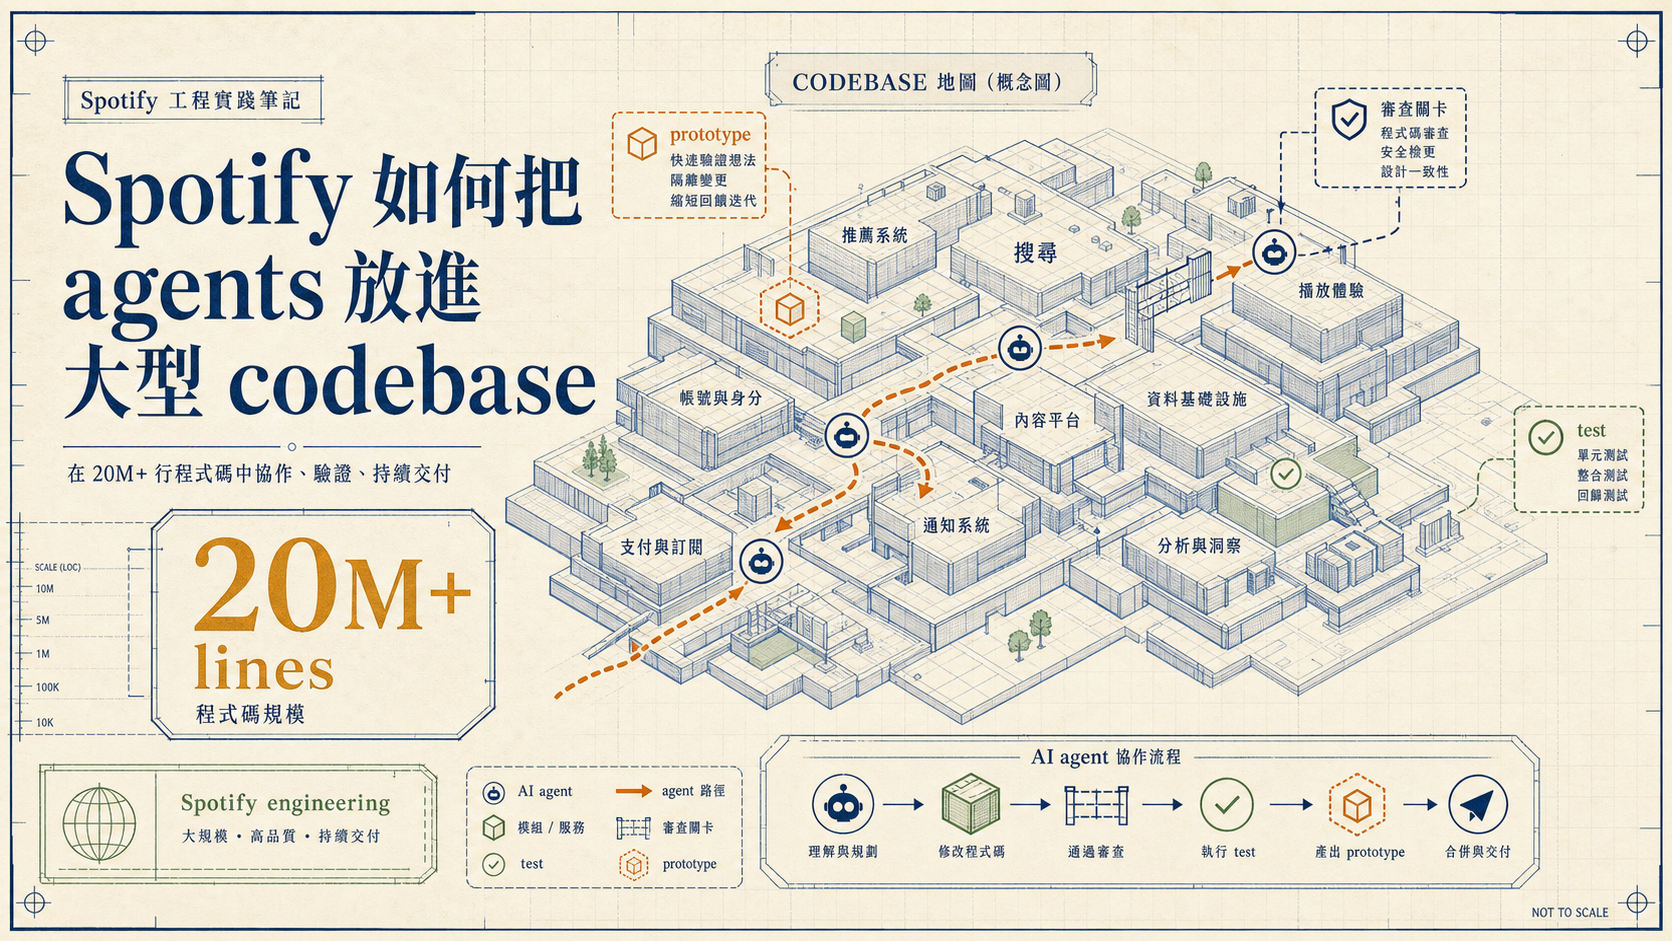
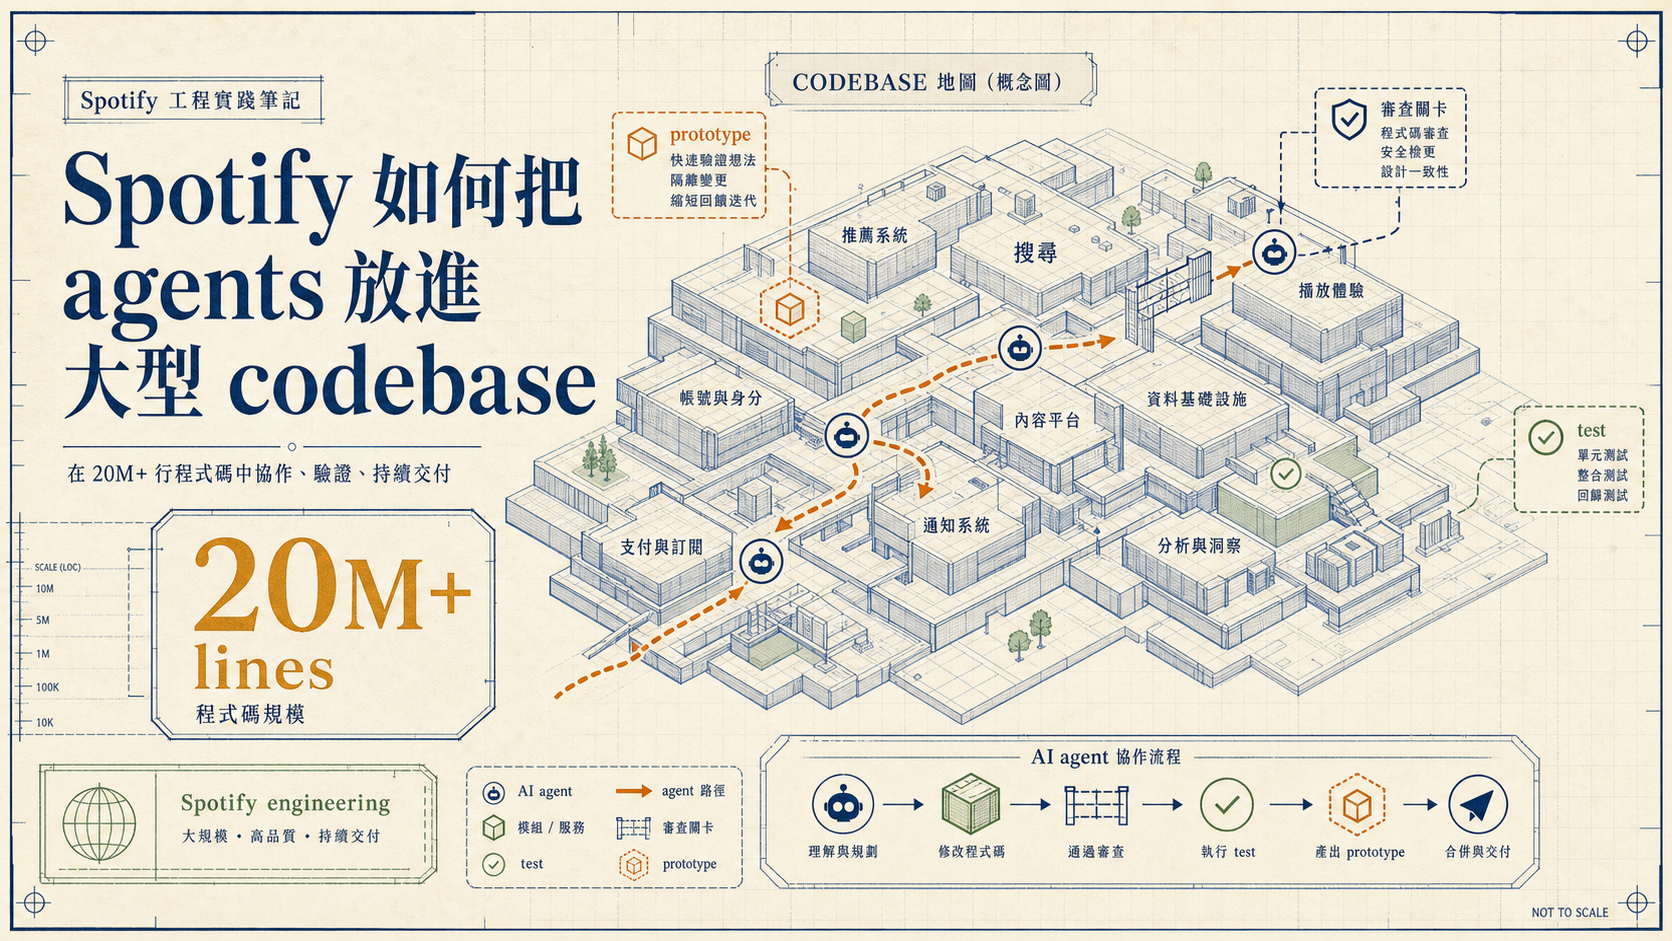
010. 先讀|Spotify 的重點不是「用了 Claude」,而是「agent 有地方可以落地」
這支訪談表面上是在聊 Spotify 怎麼用 Claude Code,實際上更值得看的,是一個大型工程組織如何把 agents 接進日常開發系統。Niklas Gustavsson 談到的不是單一 prompt 技巧,也不是某個神奇模型瞬間改變組織;他描述的是一條更工程化的路徑:先把 codebase、ownership、測試、自動化變更、prototype 分發和回饋 loop 做到足夠穩,再讓 agent 進來放大既有能力。
來源是 Claude 官方 YouTube 訪談:How Spotify runs agents across 20M+ lines of code, with Niklas Gustavsson。以下整理依據影片內容與字幕,單方數字以「Niklas 表示」歸屬,不當作外部驗證後的絕對事實。
訪談一開始有一個很好的時間感:主持人回憶去年九月 Niklas 說年底可能沒有人再用傳統 IDE,當時聽起來像兩年後才會發生的事,結果幾個月後自己的工作方式已經完全變了。Niklas 的回應也很有意思:從 Spotify 內部看,變化的感覺跟外部一樣突然,只是他們早了幾週。
這種「突然」不代表沒有前置條件。Spotify 之所以能把 agents 推進 2000 萬行以上的 backend monorepo,不是因為大型 codebase 對模型比較友善,而是因為他們過去幾年已經在處理同一個問題:codebase 長得比工程師人數快很多,手工維護會拖慢產品想法驗證。Agents 只是新角色,真正讓它能進場的,是早就存在的工程基礎設施。
021. 個人工作流|從 autocomplete 變成背景裡的 coworker
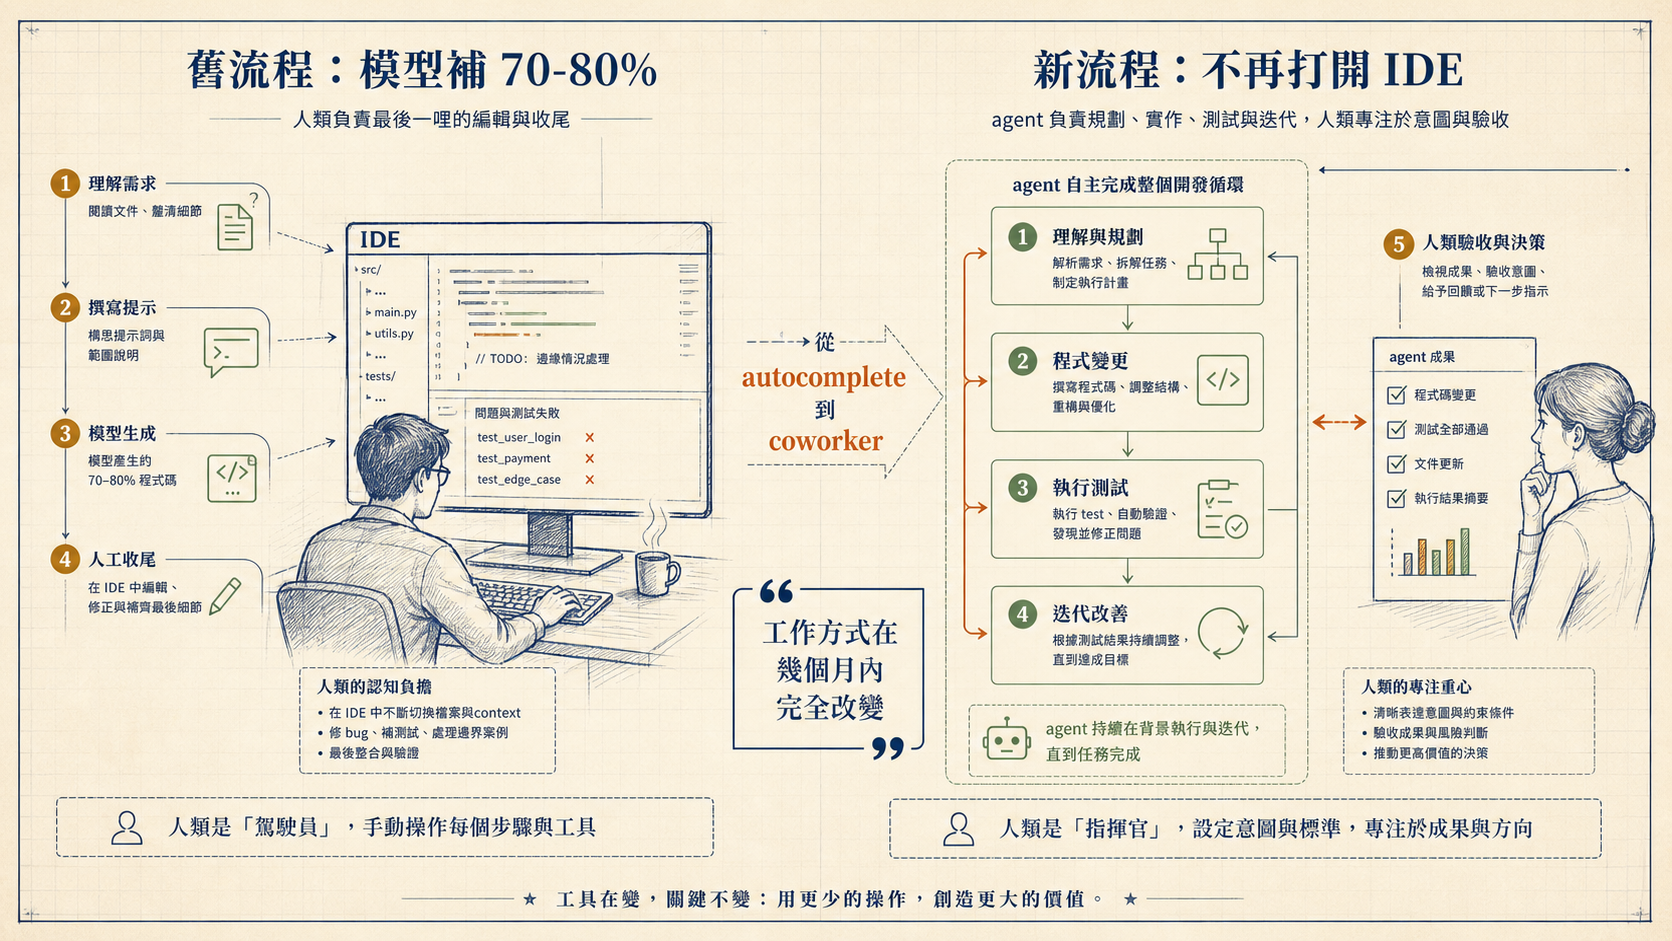
Niklas 的個人轉折點,約在 Opus 4 / 4.5 那一波。他形容過去的模型比較像 smart autocomplete:可以生出 70% 到 80% 的 code,但最後一段還是得回 IDE 手動修。真正改變的地方,是他開始不需要打開 IDE 做最後一哩編輯,而是可以把真實問題丟給 agent,讓它規劃、修改、測試,再由人類判斷方向。
這不是「工程師不用理解 code」的故事。更精準地說,是人的注意力從逐行編輯,移到問題描述、約束設定、結果審查與下一步決策。Niklas 提到自己會在 terminal / tmux 裡跑多個 session,工作時背景中可能同時有五到十個 agents 處理不同任務。這種模式下,人不是少工作,而是工作介面變了:從單線寫 code,變成多線管理嘗試、比較結果、挑選值得合併的方向。
這裡最重要的不是「開幾個 agent」本身,而是 multi-agent 工作流會暴露新的管理問題。當五個 agent 同時跑,人類最稀缺的資源變成判斷力:哪個任務應該被拆出去?哪個輸出可以相信?哪個 PR 只是看起來能跑?如果沒有測試、review、ownership 和可回滾流程,多開幾個 agent 只會把混亂放大。
所以 Spotify 的案例比較像一個提醒:agent-native workflow 的成熟度,不在於「模型能不能寫 code」,而在於組織能不能承接大量可行但未必可靠的變更。模型讓嘗試成本下降,工程系統則決定這些嘗試會變成產品速度,還是變成 review 債。
032. 大型 codebase|20M+ lines 不是障礙,前提是 context 被整理過
Niklas 在訪談中提到,他原本有點擔心 monorepo 和 agents 的搭配。過去一些工具在大型 repo 上會遇到 indexing 和 context 問題;Spotify 的 backend monorepo 按他的說法超過 2000 萬行 code。直覺上,這種規模應該讓 agent 更容易迷路。
但他的觀察相反:Claude Code 在這類 repository 裡表現很好,其中一個原因是大型 codebase 裡常常有足夠多的範例、模式和相似實作可供模型參照。換句話說,規模本身不是問題;雜亂、缺少一致性、缺少可檢索 context 才是問題。
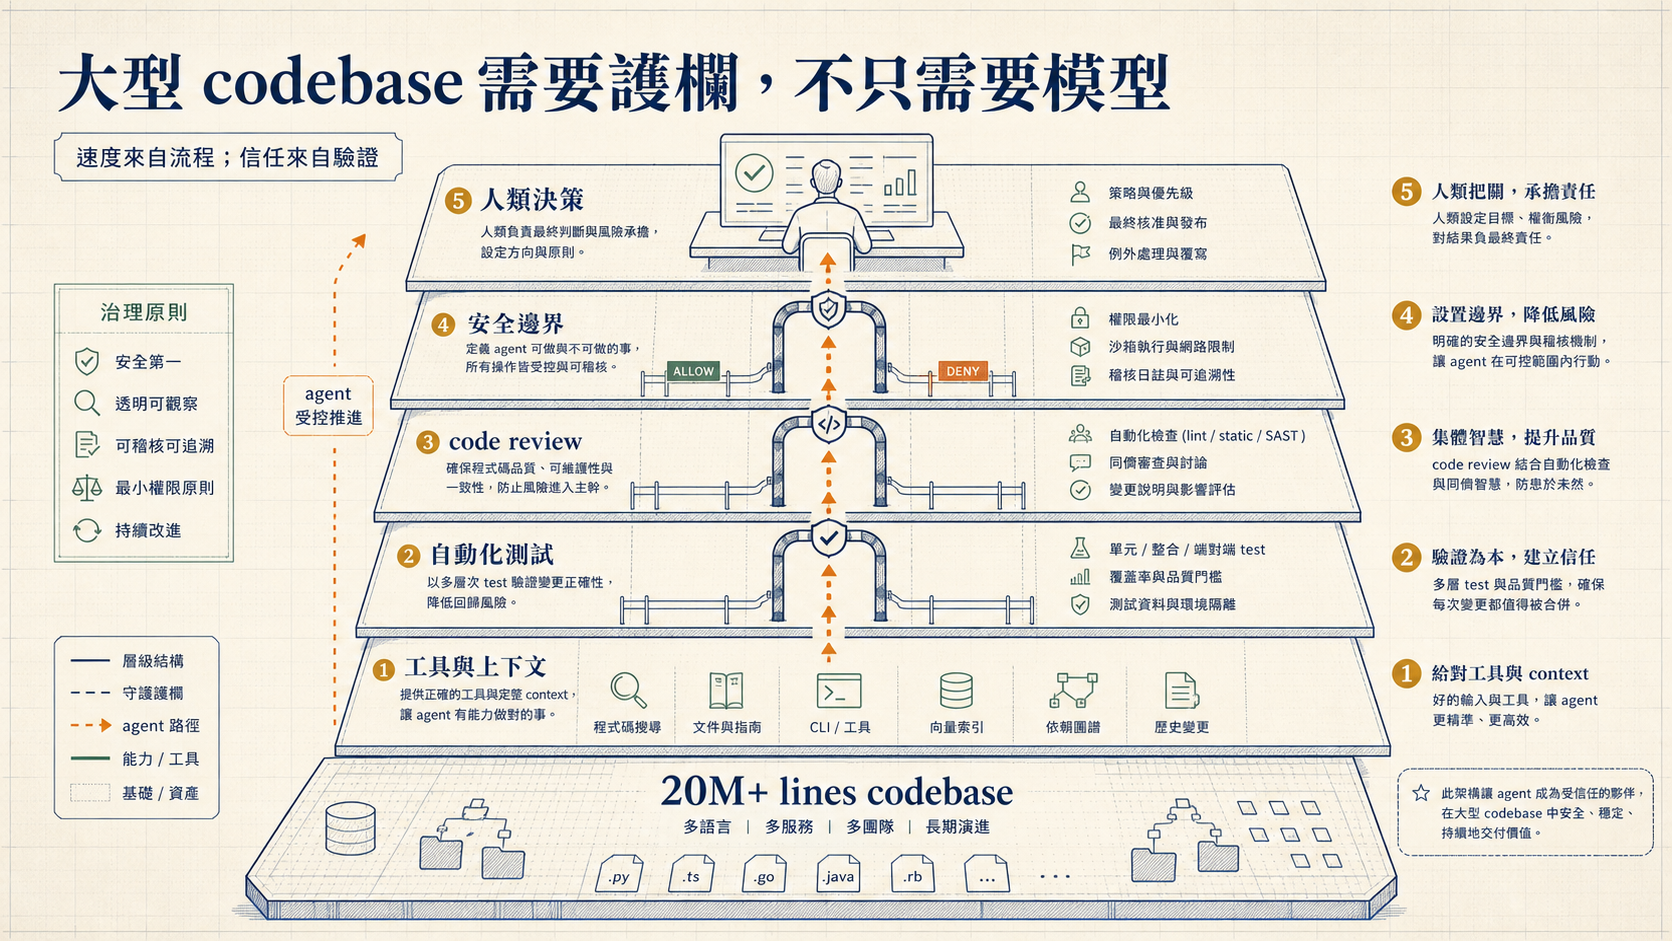
這也解釋了為什麼他後面給工程團隊的建議,不是「快去導入 agent」,而是不要忽略那些看起來不性感的工程投資:一致的架構、明確 ownership、測試自動化、可重複的流程、能讓人和 agent 找到範例的 code organization。這些東西以前讓人類更有效率,現在同樣讓 agents 更有效率。
這點很值得拆開看。很多團隊在導入 AI coding tool 時,第一反應是補 prompt template、補使用規範、補採購流程;但真正會影響產出的,可能是更底層的 codebase hygiene。當 repo 裡的慣例清楚,agent 可以從相似模組學習;當測試能快速告訴你錯在哪,agent 可以自己迭代;當 ownership 清楚,人類 review 不會變成沒人負責的排隊系統。
這也是大型公司和小團隊的共同點。小團隊沒有 2000 萬行 code,但常常也沒有穩定 context。Agent 在小 repo 裡照樣可能亂改,因為缺少測試、缺少命名慣例、缺少設計文件、缺少「正確做法」的可見範例。規模不同,問題相同:agent 需要可學習、可驗證、可回饋的環境。
043. 從自動化 PR 到 agents|Spotify 早就在練「大規模變更」這塊肌肉
訪談裡另一個關鍵背景,是 Spotify 幾年前就開始處理 codebase 成長問題。Niklas 說,他們觀察到 codebase 成長速度大約比支援它的工程師人數快七倍,於是開始想辦法對整個 codebase 做 mutation,而不是讓每個團隊在各自 repo 裡重複解同一類維護問題。
當時的解法不是 LLM,而是 deterministic scripts:寫明確規則,自動套用到大量 component,產生 PR,透過既有測試與 review 流程合併。Niklas 表示他們已經合併過數以百萬計這類 PR。這段歷史很重要,因為它讓 Spotify 在 agent 時代之前,就已經建立了「大量小變更如何安全進入系統」的肌肉。
Agents 接手的不是空白場地,而是既有流水線。當 deterministic script 處理不了更開放、更模糊的變更時,LLM agent 可以提供新的能力;但驗證、ownership、component boundary、CI、review 的邏輯仍然延續。這就是為什麼他會說,過去投資 test automation、把 codebase 分成很多 components、定義 ownership,到今天變得很有幫助:同一套 verification 可以拿來約束 agents。
這裡的編輯觀點是:企業導入 AI agents,最容易犯的錯是把它想成「新增一個超強工程師」。更實際的比喻是「新增一個高吞吐、低耐心、需要明確環境的變更產生器」。它可以快速提出 patch,但你仍然需要系統回答三個問題:這個 patch 對不對?誰負責審?出事怎麼退?
054. Prototype loop|一到兩小時做出可分享版本,才是真正改變組織速度的地方
Spotify 的另一條線,是 prototype。Niklas 提到,現在內部有很簡單的方式,可以在 mobile app 和 backend 做 end-to-end prototype,並透過內部 app store 分享給其他人試用。他說,有些以前需要動員工程團隊才看得到的想法,現在可以用自然語言描述,在一到兩小時內做出 working prototype,讓大家用真實資料和真實使用情境感受它。
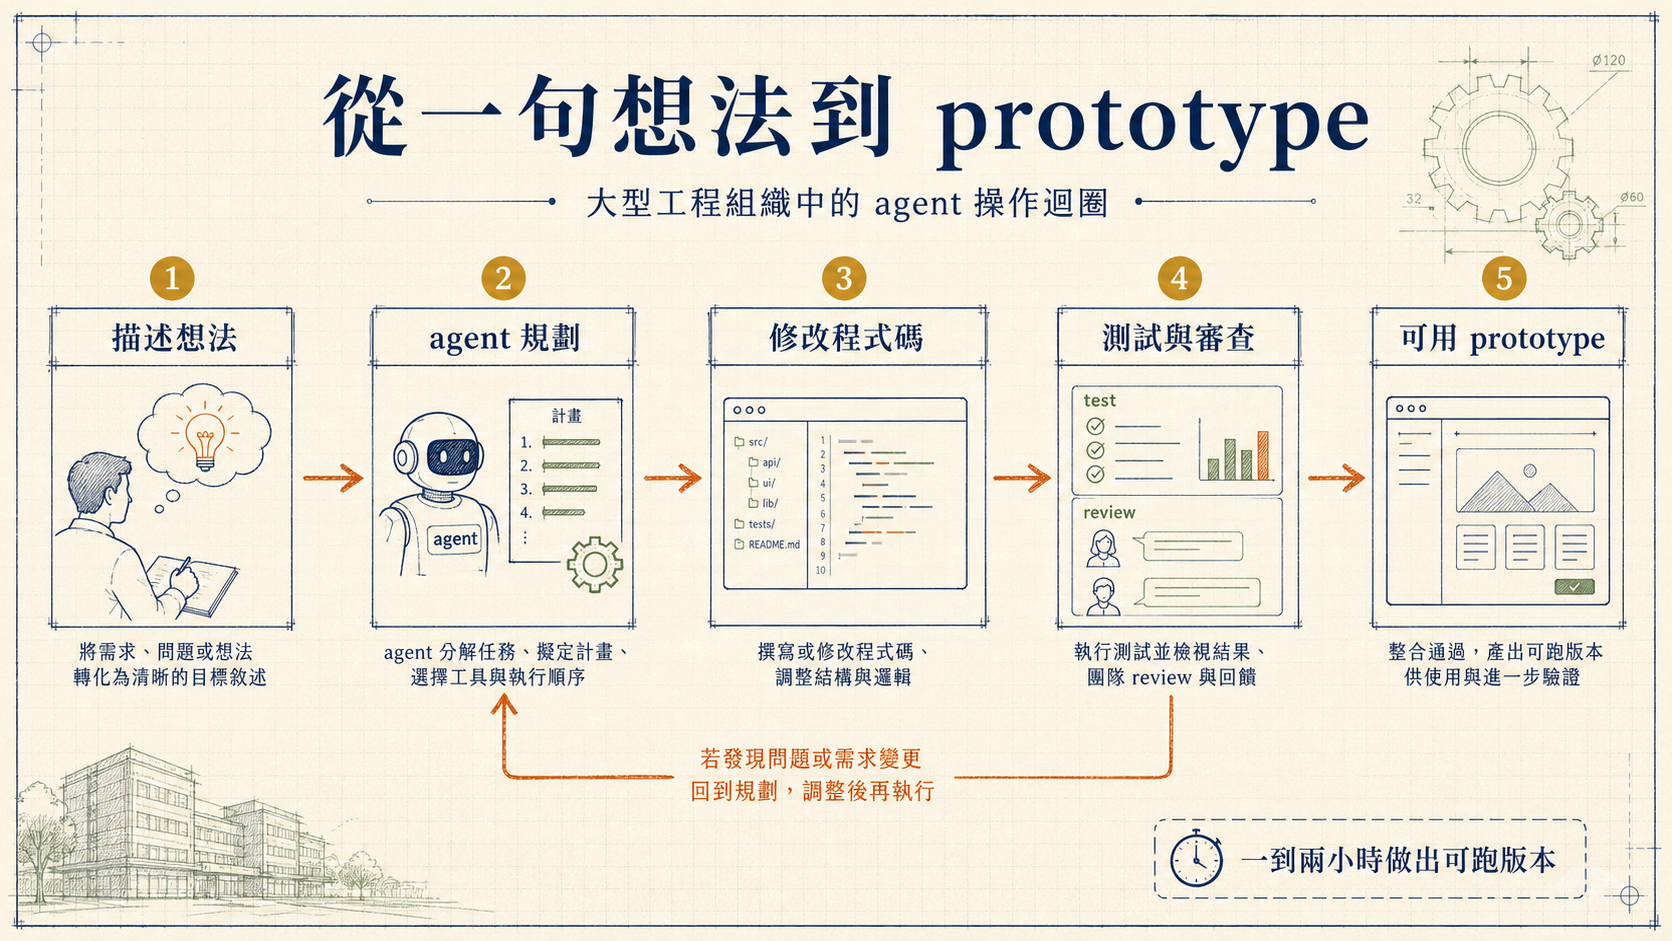
這裡的產品意義比 coding efficiency 更大。工程組織的瓶頸常常不是「能不能寫出正式版本」,而是「能不能用足夠低的成本看見一個想法到底長什麼樣」。如果每個想法都要排進 roadmap、找 mobile、backend、design、PM 協作,很多想法在被驗證前就死在協調成本裡。
Agent prototype loop 改變的是想法的流動性。Niklas 提到,從工程師到高階主管,都有人把自己的想法做成 prototype 放到內部 app store。這不代表每個 prototype 都會上線,也不代表正式產品流程消失;它代表「看見」一個想法的成本下降了。當想法能被更早、更多人、用更接近真實產品的方式試用,組織就能用比較便宜的方式淘汰錯誤方向,也能更快聚焦值得投入的方向。
這也是 AI 對產品組織最實際的影響之一。很多 AI 討論停在「工程師效率提升幾倍」,但 prototype loop 影響的是決策品質。當想法從簡報變成可點、可試、可比較的版本,討論會少一點抽象,多一點具體。真正的速度不是每個 idea 都一小時上 production,而是錯的 idea 更快被看見、好的 idea 更早獲得支持。
065. 工程品質|速度與可靠性不是二選一,前提是把驗證做進 loop
主持人在訪談中提到工程常見的 trade-off:速度和品質似乎站在兩邊。Niklas 的回答比較接近「這是假的二分法」。如果要更快地把想法推到使用者面前,就更需要 infrastructure;不是靠大家工作更久,而是讓系統越來越能支援快速、安全、可驗證的變更。
這句話可以視為整場訪談的中心。AI agent 的速度很迷人,但沒有驗證,速度只是風險加速器。Spotify 的路線看起來不是把人類 review 拿掉,而是讓 agent 參與已經存在的 loop:提出變更、跑測試、遵守 ownership、經過 review、部署到可以觀測與回滾的系統。當這些環節存在,agent 的輸出才有機會變成可靠速度。
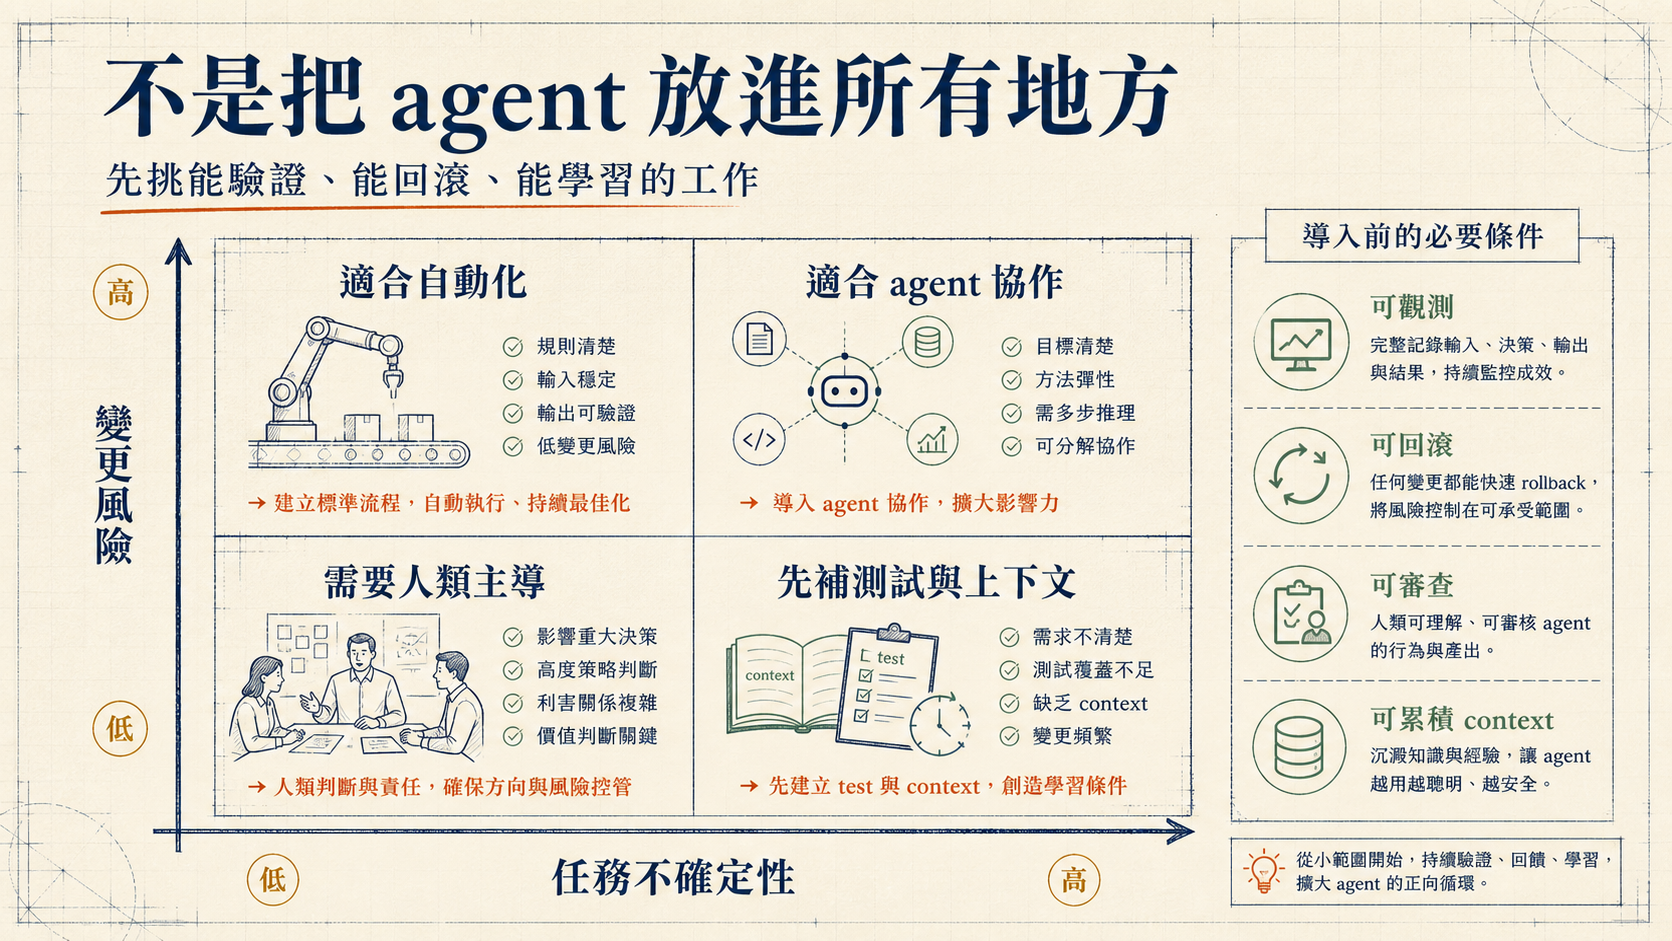
對其他團隊來說,最可複製的不是 Spotify 的規模,而是任務選擇方式。不要一開始就把 agent 放進所有地方。比較好的切入點,是那些可以清楚描述、可以自動驗證、可以小步合併、可以回滾、而且 repo 裡有足夠相似範例的工作。例如例行 migration、測試補強、內部工具 prototype、低風險 refactor、文件與程式碼同步。相反地,高風險、低測試覆蓋、牽涉產品判斷或安全邊界的任務,應該先補護欄,再談 agent 自動化。
這也是「AI-first engineering」和「AI chaos engineering」的分界。前者會把 agent 當成工作系統的一部分,設計可觀測、可審查、可回滾的流程;後者只是把改 code 的權限交給模型,然後期待 review 人力接住所有不確定性。
076. 給 Builder 的讀法|先整理工作的形狀,再追求模型的速度
如果把這支訪談讀成「Spotify 很會用 Claude Code」,會漏掉最有價值的部分。更好的讀法是:Spotify 多年前就在面對「codebase 成長快過人力」的結構性問題,於是投資了大規模變更、自動化測試、component ownership、prototype 分發等基礎設施。當 agents 變強,這些投資突然變成加速器。
對正在新創或產品團隊裡當 Builder 的人,這裡有三個實用提醒。
第一,別只問「要用哪個 agent 工具」。先問你的工作能不能被 agent 接住:任務有沒有明確定義?結果能不能自動驗證?失敗能不能回滾?有沒有足夠 context 讓 agent 知道在這個 codebase 裡什麼是正確風格?
第二,別把 prototype 當玩具。能在一到兩小時內做出可用 prototype,最大的價值不是省幾天 coding,而是讓團隊更早看見想法。這對 early-stage team 特別重要,因為你真正缺的常常不是工程手速,而是高品質的問題探索速度。
第三,別忽略 boring infrastructure。命名一致、測試穩定、component 邊界清楚、文件不過期、範例可搜尋,這些在 AI 前看起來只是工程紀律;在 AI 後,它們會變成 agents 的訓練地圖。你整理給人看的東西,也是在整理給 agent 用的 context。
Spotify 的案例不是說每家公司都要立刻複製大型平台工程。它真正提示的是:agent adoption 的天花板,常常不是模型,而是組織把想法變成安全變更的能力。模型負責產生更多可能性;工程系統負責讓可能性被驗證、被選擇、被可靠地送到使用者手上。