0. Loop 來了|Armin 不是在問「要不要用 agent」,而是在問「誰控制 agent 之外的循環」
Armin Ronacher 在 The Coming Loop 裡寫的不是一篇單純反 AI coding 的文章。更精準地說,他承認 loop 已經開始變成工程現實,也承認它在某些場景很有效;但他真正不安的是:當任務不再由模型自己說「完成」,而是由外層 harness 持續判斷、續跑、重開 session、派給其他機器時,工程師的 judgment 會被放到哪裡?
文章開頭引用 Boris Cherny 的說法:他不再 prompt Claude,而是讓 loops 去 prompt Claude,自己的工作變成寫 loops。這句話抓住了現在 coding agent 工具正在移動的方向。早期我們把注意力放在模型本身:它會不會寫 code?會不會叫工具?會不會跑測試?但越來越多實驗的真正重點,是模型外面的那層系統:queue、orchestrator、judge、session manager、subagent、durable task runner。
Armin 對這件事的姿態很有意思。他不是說 loop 沒用,而是說自己對「不用看、讓機器一直跑」這件事還不舒服,尤其當產物是他真的在意、需要長期維護、需要能向別人解釋的程式碼。這種不舒服不是保守,而是工程判斷:如果你不能理解你 ship 的東西,當系統在壓力下出事時,你要怎麼負責?
這篇導讀會把原文拆成幾個核心問題:agent loop 和 harness loop 有什麼不同?哪些場景 loop 已經很好用?為什麼長期核心程式碼會被 loop 放大壞味道?什麼叫 software as organism?為什麼即使你不喜歡,也可能不能 opt out?最後,若 loop 無可避免,harness 要怎麼設計才不會讓人類只剩 messenger?
1. 兩層 loop|模型內部會迭代,但外層 harness 會決定任務能活多久
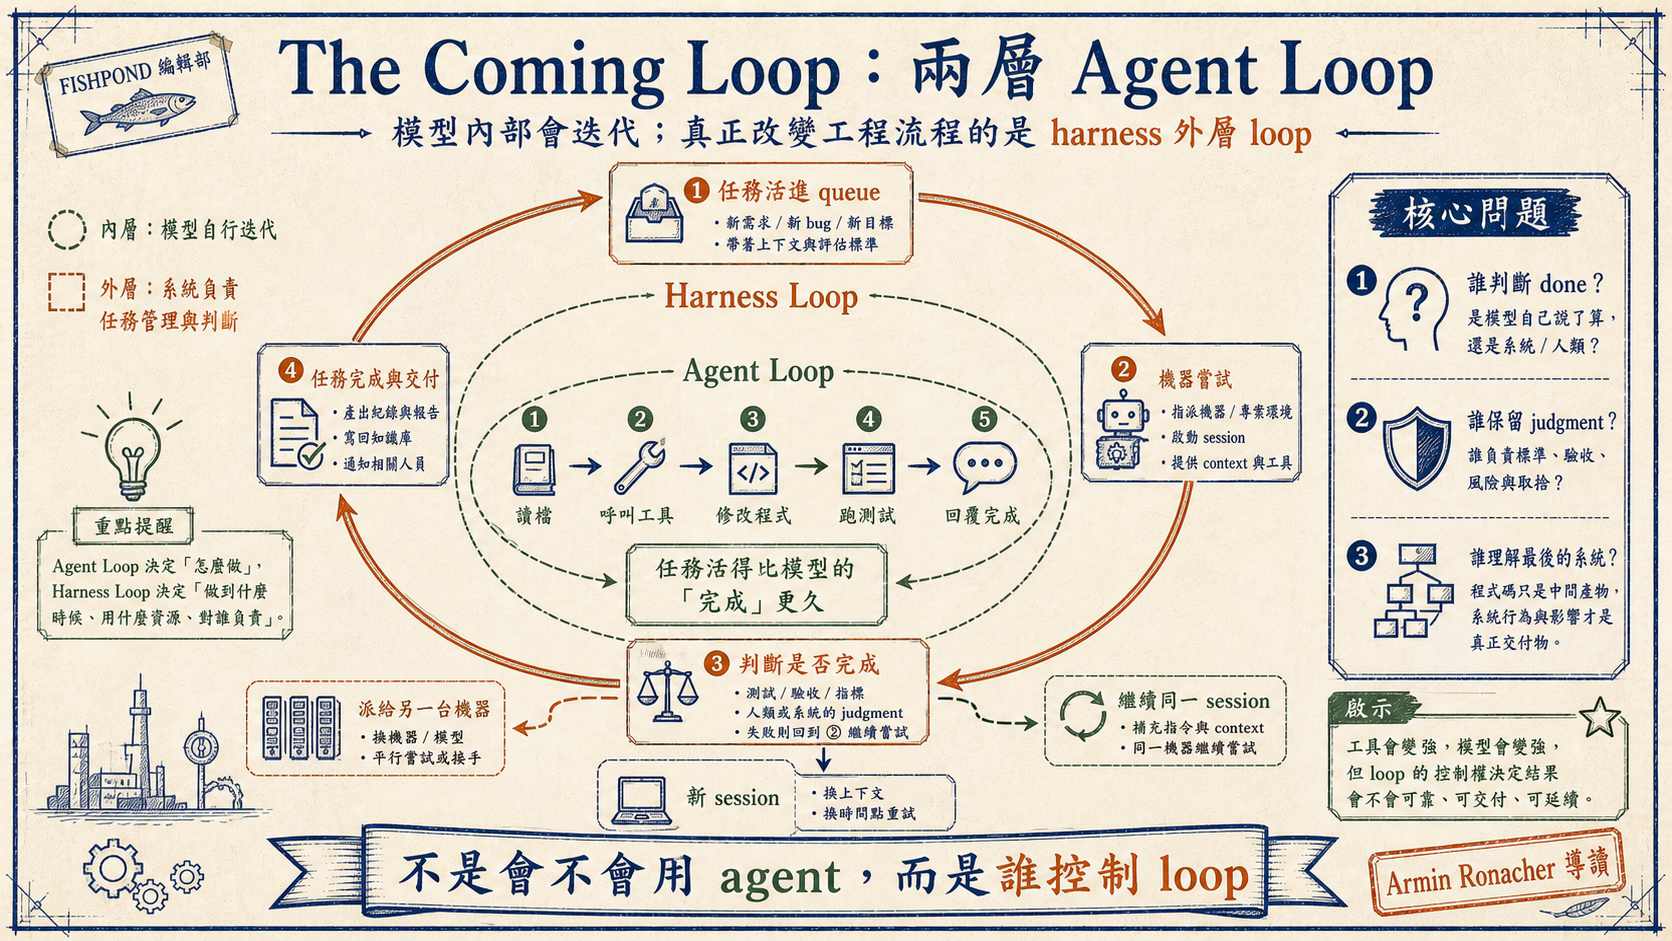
Coding agent 本來就有 loop。模型讀檔、呼叫工具、修改檔案、跑測試、讀錯誤、再修改,最後回覆「完成」。這是我們熟悉的 agent loop,也是 Claude Code、Codex、Cursor 類工具每天都在做的事。
Armin 文章真正指出的是另一層 loop:harness-level loop。這層 loop 不在模型內部,而在模型外部。它把工作放進 queue,讓一台機器拿起來嘗試,然後由 harness 判斷是否真的完成。若沒完成,它可以繼續同一個 session、注入新訊息、開新 session 換一段 context,甚至把任務交給另一台機器。
這個差異很大。agent loop 裡,模型最後說「我完成了」,人類通常接手 review。harness loop 裡,「完成」不再是模型和人之間的交接點,而是另一個系統判斷的輸入。done signal 變成可被消費、可被質疑、可被再啟動的事件。
這會讓任務「活得比模型的完成更久」。對很多工作來說,這是好事:模型卡住時 harness 可以重試;測試失敗時可以續跑;子任務可以被拆給不同 agent;長任務不用靠單一上下文撐到底。但它也改變了責任結構:如果一個 loop 跑了十輪,最後產出一個可用但混亂的 patch,是誰真正做了工程判斷?
這就是原文最尖銳的地方。工具越強,loop 越容易變成「繼續讓機器試」。但工程不只是試到過測試。工程還包括保留 invariants、理解 load-bearing parts、知道什麼不該被 fallback 掩蓋、知道哪些複雜度不值得引入。這些東西如果沒有被 harness 明確納入,loop 會很勤勞,但未必會變好。
2. 哪裡有效|短壽命、可驗證、機械轉換,是 loop 最自然的棲地
Armin 並沒有否認 loop 的價值。相反,他列出幾個 loop 已經非常好用的場景:porting、performance exploration、security scanning、research。這些場景共同點是:結果比較容易驗證,或產物不一定需要長期維護。
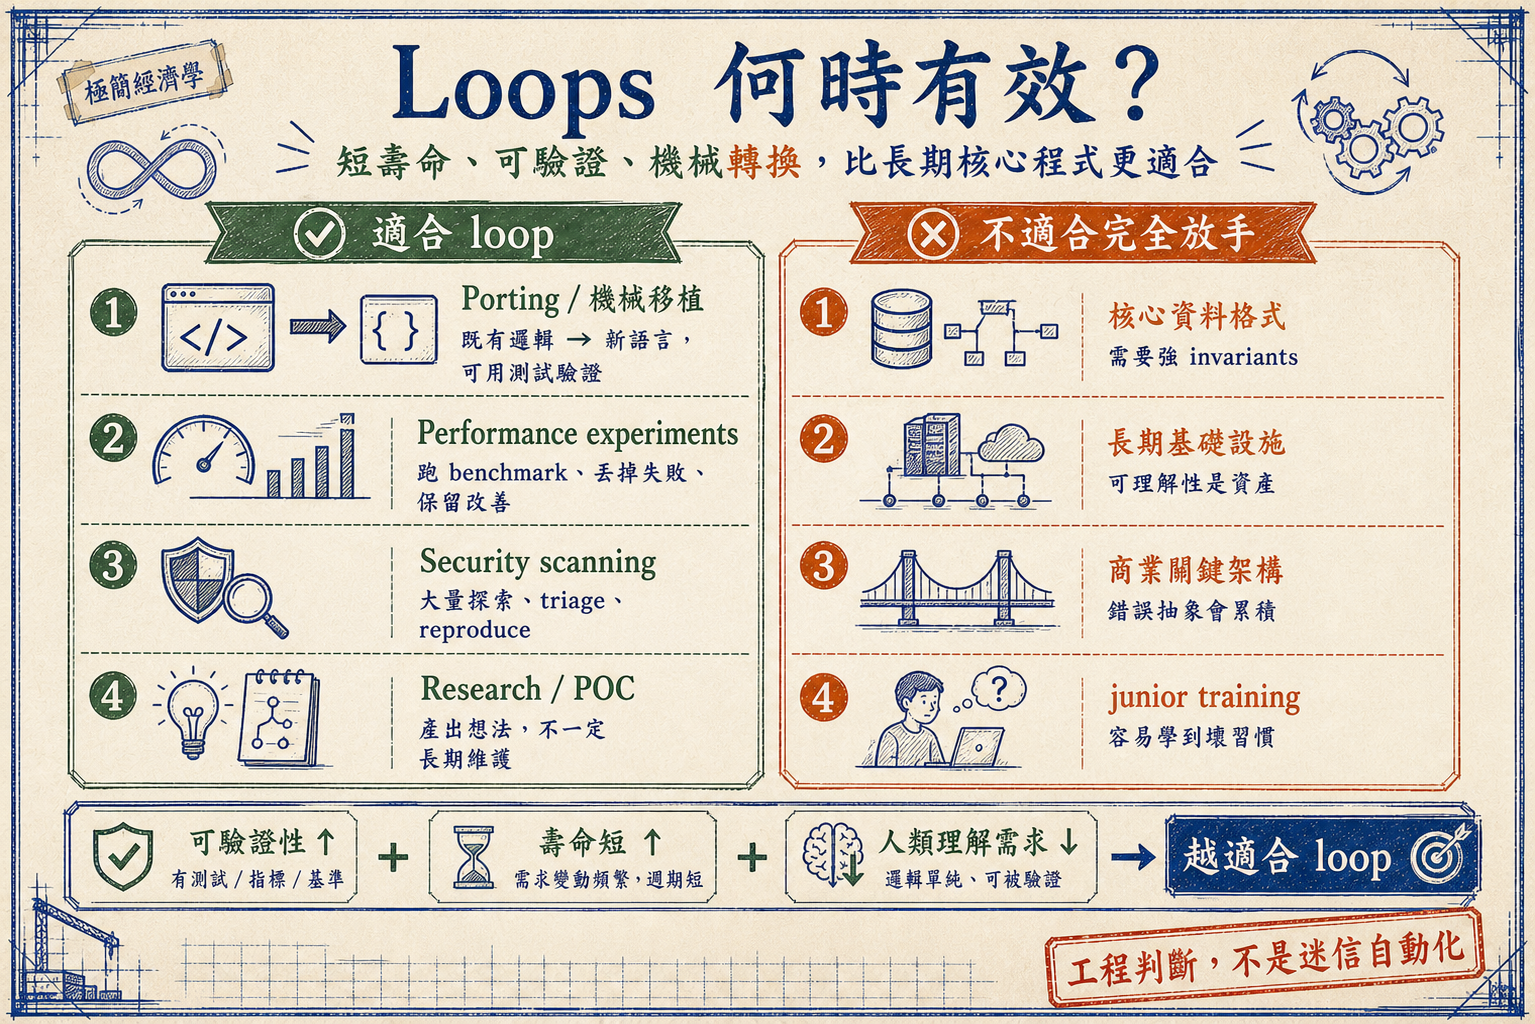
Porting 是典型例子。把既有邏輯從一種語言移到另一種語言,雖然細節很多,但目標相對清楚:行為要一致,測試要過,效能不能太差。Armin 自己也提到曾成功用這種方式把 MiniJinja port 到 Go。這類工作有既有參考物,也有測試可驗證,loop 的探索成本就很划算。
Performance exploration 也適合 loop。機器可以提出實驗、跑 benchmark、丟掉失敗結果、保留改善方向。這種 code 不一定要成為長期架構,它可以是探索用腳手架。只要 benchmark signal 足夠,harness 就有理由繼續。
Security scanning 更自然。安全研究本來就像在巨大空間裡找可能性:產生 hypothesis、嘗試 exploit、reproduce、triage。即使很多結果是 noise,只要能找出真問題,就有價值。這也是為什麼 defenders 最終也會被迫用 loop 回應 loop。
Research 和 proof of concept 也類似。你可以讓機器探索問題空間、整理 findings、提出可行方向,這些產物不一定直接進 production。它們的價值是擴大搜索,而不是寫出可維護核心系統。
原文對 loop 的接受度,大致可以整理成一條軸線:越短壽命、越可驗證、越像機械轉換、越不要求人類長期理解,越適合 loop;越長壽命、越核心、越依賴強 invariants、越需要人類能解釋,越不適合完全放手。
3. 長期程式的風險|loop 會放大模型的局部修補傾向
Armin 對長期程式碼最不放心的地方,是 present-day models 寫出的 code 常常太 defensive、太複雜、太 local in reasoning。它們看到局部 failure,就加一層局部防禦;遇到不清楚的狀態,就多補 fallback;碰到設計不明確,就用更多 machinery 蓋過去。
這和好工程常常是相反方向。對重要資料格式、核心基礎設施、長期可維護系統來說,正確修法往往不是「每個 malformed case 都處理」,而是讓 malformed case 不可能被寫出來。也就是把 invariants 放在系統設計裡,而不是讓每個角落都長出錯誤處理。
loop 會放大這個問題。單次 agent run 可能加一個防禦,下一輪看到另一個測試失敗又加一個 fallback,再下一輪為了繞過 edge case 又加一個小抽象。每一步看起來都在讓系統更 robust,但整體可能變得更不可理解。表面上 bug 變少,實際上系統的語意邊界變模糊。
這對 junior training 也危險。若年輕工程師只看到 AI 產生一堆「看似合理」的防禦式 code,又能把理由講得頭頭是道,他們可能會學到錯誤的工程直覺:把壞狀態到處 handle,而不是從設計上消滅壞狀態;把複雜度藏起來,而不是讓 invariant 清楚可見。
所以原文不是在反對自動化,而是在提醒:loop 若沒有工程價值觀作為約束,會把模型目前的壞習慣連續放大。harness 需要的不只是「能不能繼續」,還要有「什麼樣的 code 不應該被接受」。
4. 軟體變成有機體|從理解機器,到診斷、監控、治療一個自己也不完全理解的系統
原文裡最有力的隱喻,是 software as organism。過去的工程理想,是把軟體當成 deterministic machine:有架構、有 invariants、有 load-bearing parts、有文件、有工程師知道哪些地方能動、哪些地方不能動。即使大型系統早就不可能完全裝進一個人的腦袋,理解仍然是目標。
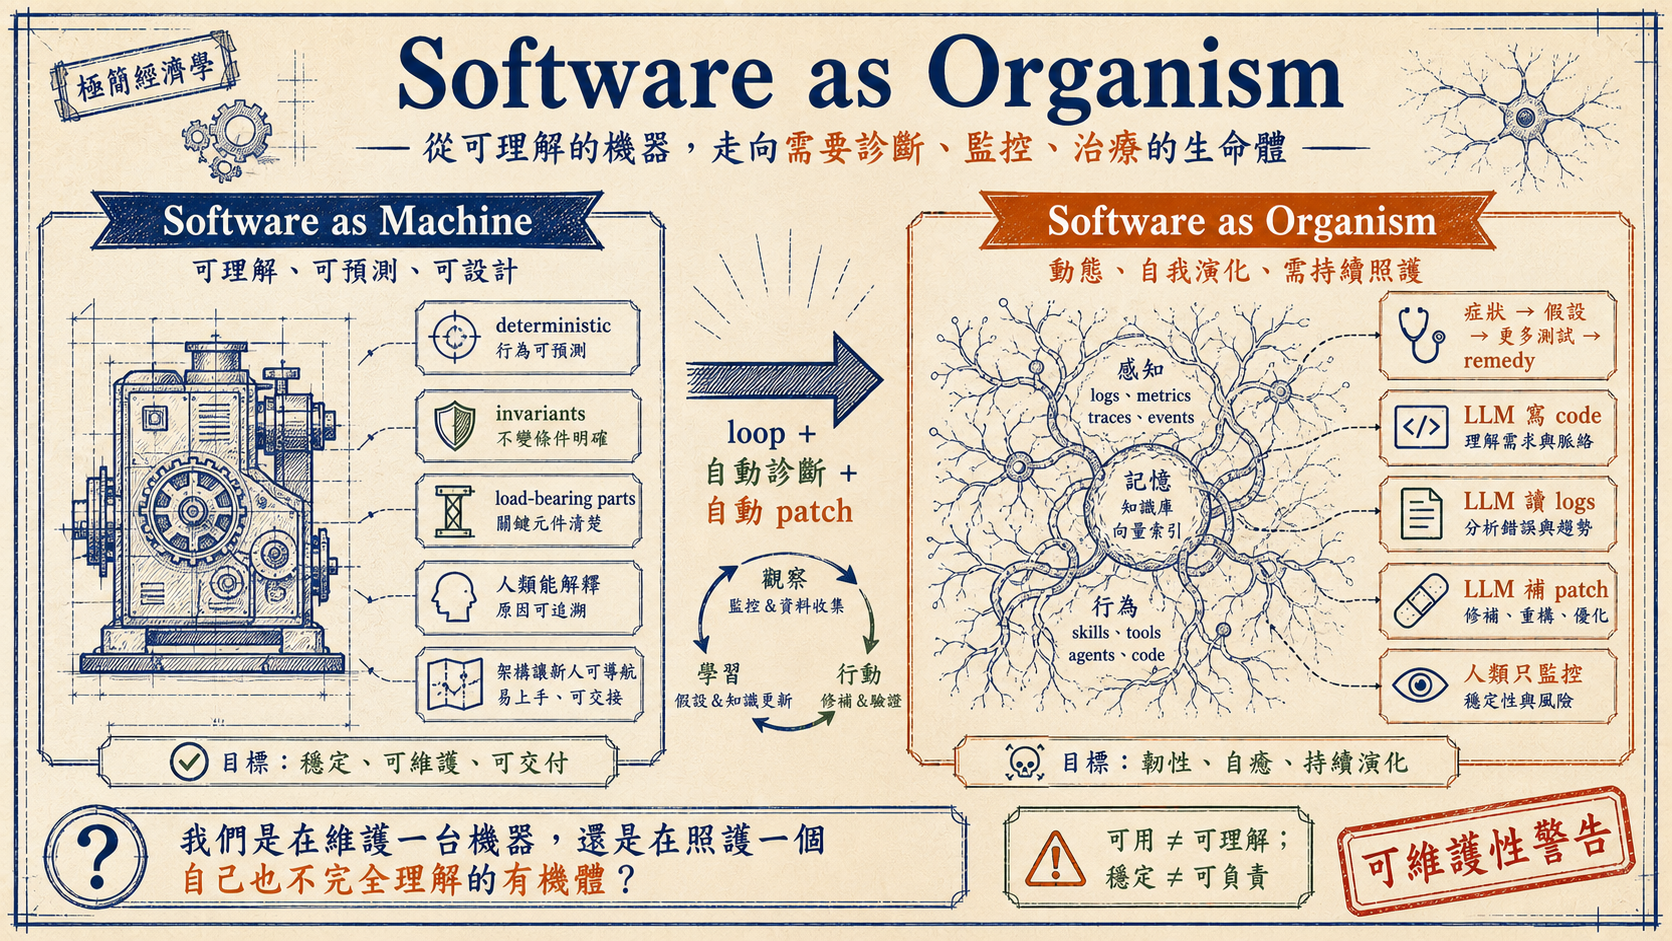
但 LLM 和 loop 把我們推向另一種狀態。系統出 production issue 時,第一反應可能是讓機器讀 logs、提出 root cause、開 patch;patch 又被另一台機器 review,甚至自動 merge。人類不一定理解整個系統,而是像醫師一樣看症狀、下診斷、開 remedy、觀察是否穩定。
這不是全然壞事。很多現代分散式系統早就已經需要這種診斷方式。問題是,當 code 本身也越來越多由 loop 生成、review、patch,系統就不只是難理解,而是可能從設計上假設「你會用另一台機器來理解我」。
這會改變可維護性的定義。過去我們問:新人能不能讀懂這段 code?未來可能變成:agent 能不能診斷它?monitoring 能不能抓到症狀?另一個 loop 能不能提出 patch?如果這些變成默認維護模型,人類 comprehension 的位置就會後退。
Armin 沒有說所有軟體都不能這樣。不是每一行 code 都值得人類親手寫,也不是每個系統都需要同等程度的理解。但問題是:我們是否願意讓所有軟體都走向這種 authored-by-loop、diagnosed-by-loop、patched-by-loop 的狀態?
5. 不能完全退出|如果攻擊者、回報者、競爭者都 loop,你也會被迫 loop
原文最不舒服的一段,是 opt out 可能不可行。即使你的團隊不用 loop 寫 code,其他人也會用 loop 對著你的系統運作。
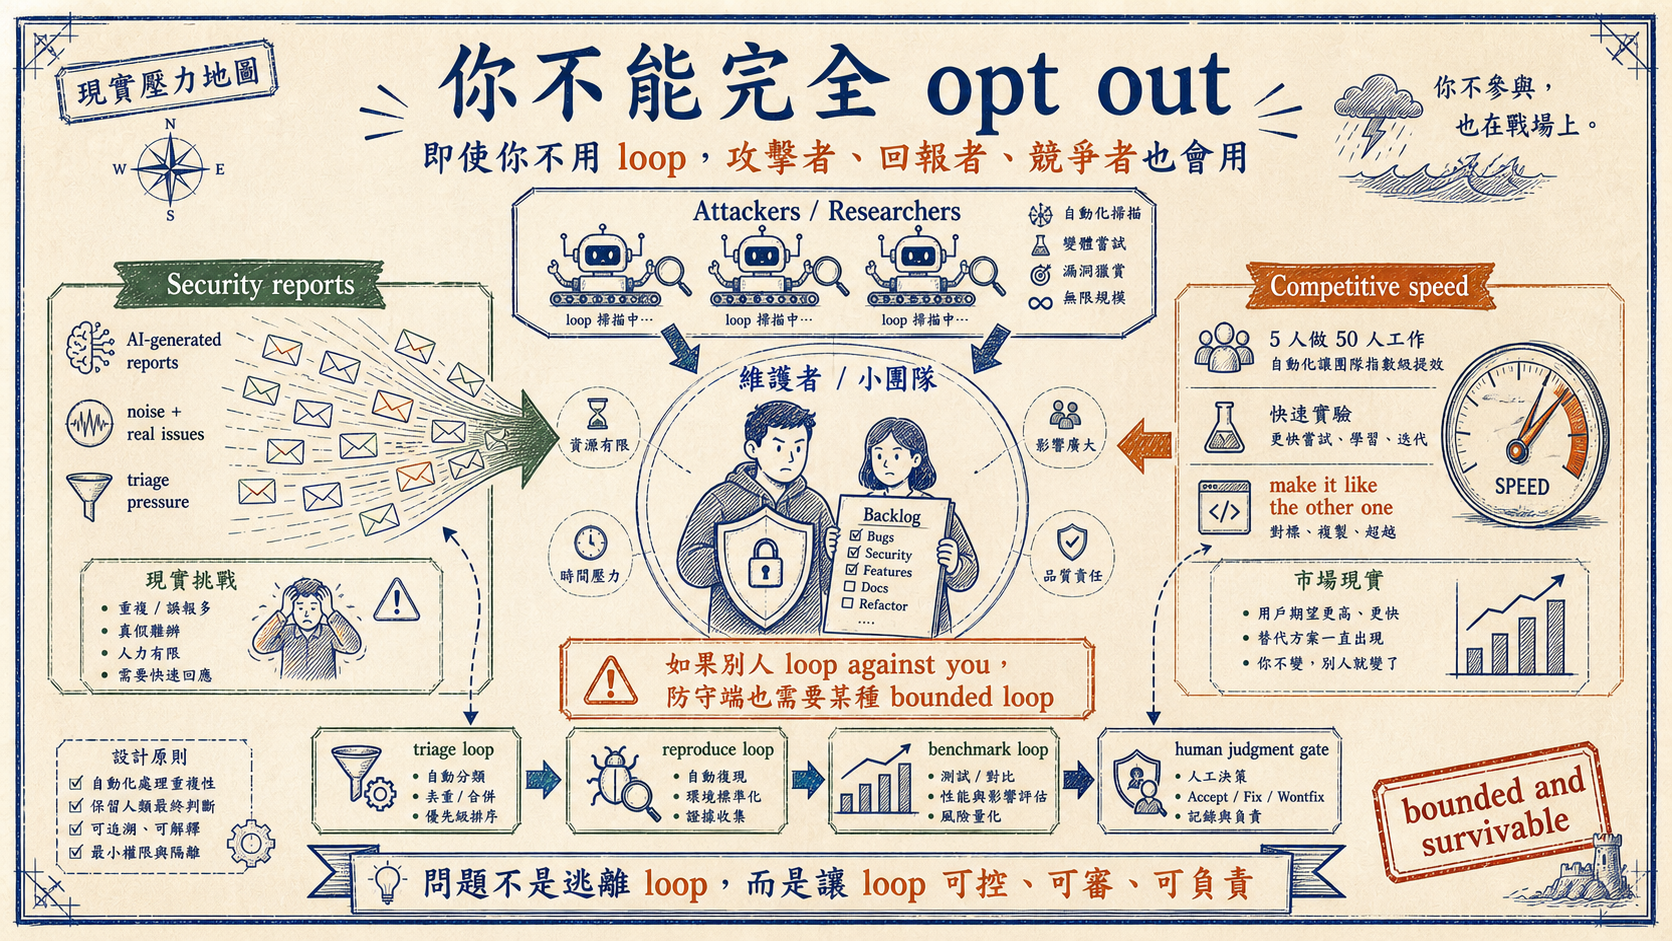
Security 是最清楚的例子。攻擊者可以連續跑機器找漏洞,security researchers 也可以大量產生報告。這些報告裡會有 noise,也會有真問題。對 maintainer 來說,壓力不是「AI 報告準不準」而已,而是量大到你不丟機器回去 triage、reproduce、分類,就處理不了。
Armin 提到 curl maintainers 被 AI-generated reports 壓垮的例子。這代表即使 core development 本身沒有大量用 AI,周圍的維護環境也會被 AI loop 改變。當別人用 loop against you,你可能也需要某種 defensive loop。
競爭壓力也是同一回事。有些小團隊會因為懂得 orchestration 而做出以前需要大團隊才能完成的速度。有些產品會被機器持續對照競品、快速補功能、快速實驗。對某些市場來說,使用者不在乎 code 是否優雅,只在乎產品是否快、功能是否到位、價格是否合理。
這不是說所有領域都會被速度吞掉。高信任、高責任、高安全要求的領域仍會懲罰 sloppy systems。但大量軟體其實活在「快速實驗、覆蓋率、反應速度」比長期架構純度更重要的環境裡。這會逼所有人重新估計 loop 的成本與必要性。
6. 新的依賴|當 codebase 假設機器參與維護,人類能力會不會退化?
Armin 對未來最害怕的,不只是成本依賴,而是 cognitive dependency。過去開發工具也要錢,編譯器、IDE、雲服務都要錢;但 coding loops 帶來的新依賴不只是錢,而是理解能力。
如果一個 codebase 由 loops 生成、由 loops review、由 loops patch、由 loops 維持生命,那當你失去同等級模型時會怎樣?如果成本突然不可負擔?如果法規、貿易限制或平台政策讓你不能使用某類模型?如果團隊已經失去不用機器理解系統的能力?
這些問題不是科幻。很多人已經開始 merge 自己不能完整解釋的 code;issue report、chat discussion、review comment 也越來越常透過 LLM 重新包裝。人與人之間的工程溝通,正在被機器介面化。
這未必一定錯。也許未來的軟體本來就需要機器共同維護,就像現代系統早就需要 compiler、CI、observability、cloud provider。但如果我們走向那裡,就不能假裝這只是「多一個工具」。它會改變工程師如何理解系統、如何訓練新人、如何承擔責任。
真正的風險不是「AI 寫了爛 code」這麼簡單,而是「我們接受了一種只有 AI 才能持續維護的 codebase」,然後又沒有設計好在 AI 不可靠、不可用或不可負擔時的退路。
7. 控制 loop|未來問題不是要不要 loop,而是怎樣不放棄 judgment
Armin 的結論很清楚:looping future 很可能會來,即使他現在仍然抗拒。問題不是我們會不會 loop,而是在 loop 的未來裡,如何不 abdicate judgment,如何保留 good engineering 的規則,如何讓 responsible human 仍然能 supervise。
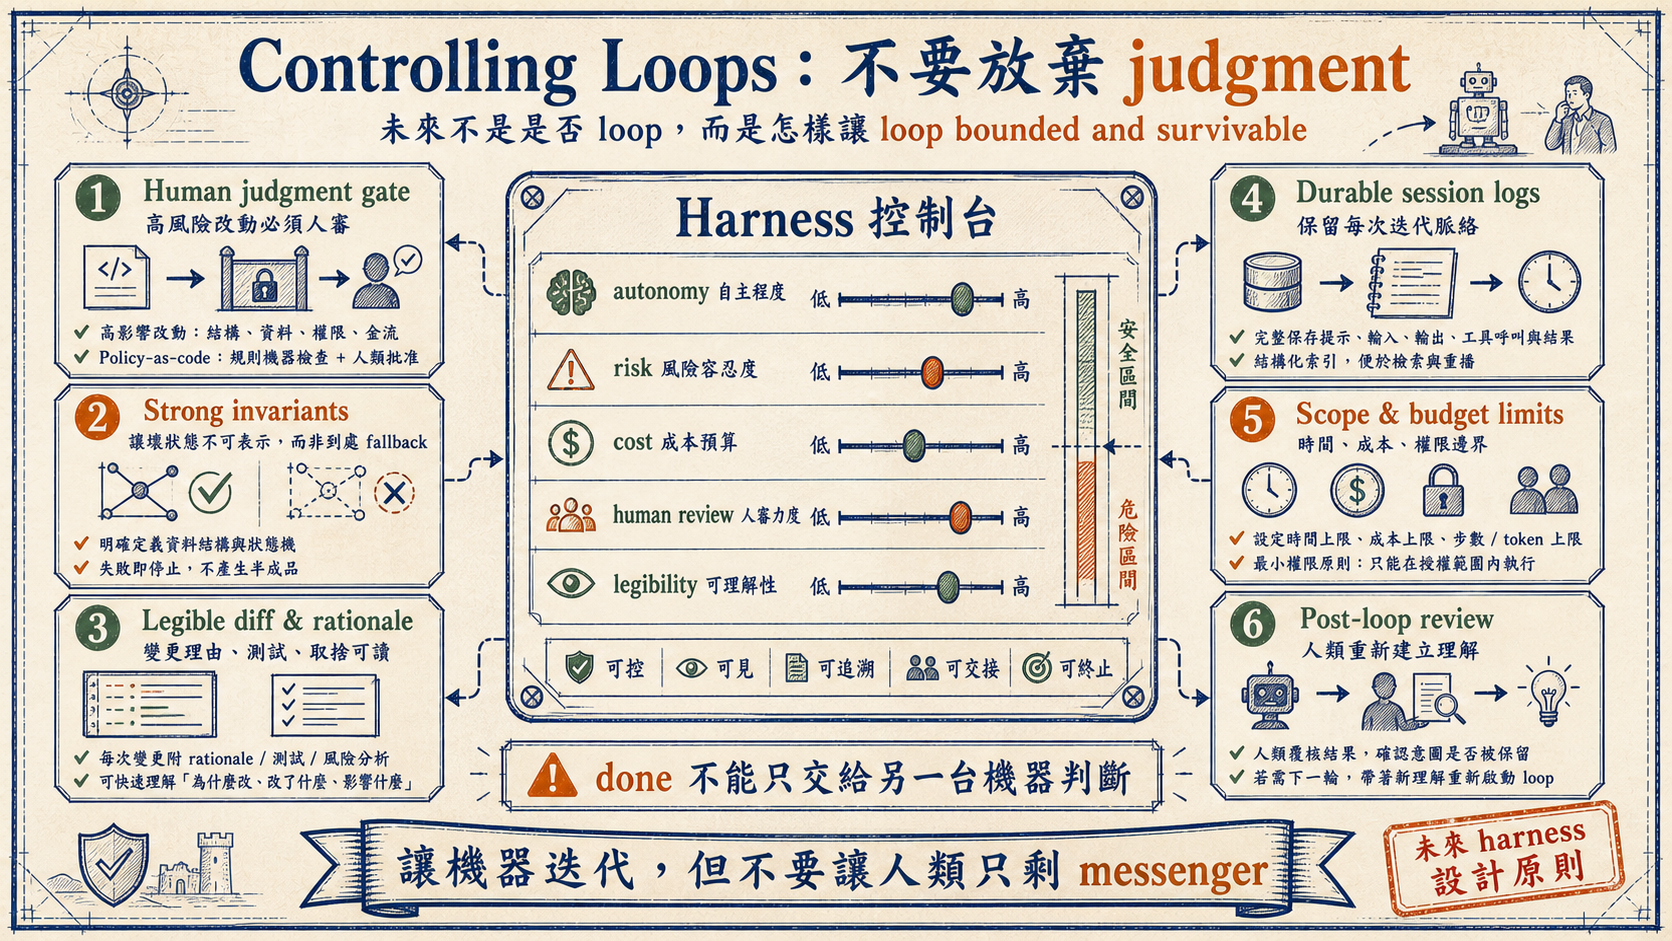
這裡可以把原文延伸成一套 harness 設計原則。
第一,高風險改動要有人類 judgment gate。不是每個 typo、benchmark experiment、research note 都需要人工審核,但資料格式、權限、金流、migration、核心架構一定需要。
第二,harness 不只要跑測試,還要尊重 invariants。測試通過不代表設計正確。好的 harness 應該鼓勵「讓壞狀態不可表示」,而不是用 fallback 把壞狀態藏起來。
第三,diff 和 rationale 要 legible。loop 產生的變更不該只是一包 patch;它應該留下為什麼改、改了什麼、測了什麼、放棄了哪些方案、風險在哪裡。否則人類 review 只會變成 rubber stamp。
第四,session logs 要 durable。外層 loop 跑了幾輪、注入了什麼 context、哪一步失敗、哪一步改變方向,都應該可回放。沒有歷史,post-loop review 就無從做起。
第五,要有 scope、budget、permission limits。loop 不該無限續跑,也不該無限擴權。時間、成本、檔案範圍、外部操作、部署權限,都應該有清楚邊界。
第六,loop 完成後,人類要重新建立理解。這可能是 review checklist、architecture note、postmortem、ADR,或簡短的「這次 loop 產生了什麼設計變化」。重點是不要讓人類只剩傳話者。
The Coming Loop 最值得留下的,不是對 AI coding 的恐懼,而是對 harness engineering 的提醒。工具會變強,loop 會變多,速度會變快。但工程的核心仍然是 judgment:知道什麼值得自動化、什麼必須理解、什麼可以交給機器探索、什麼必須由人類負責。
本文為 Armin Ronacher〈The Coming Loop〉的繁中導讀與編輯整理,不轉載原文全文。完整論述請閱讀原文:https://lucumr.pocoo.org/2026/6/23/the-coming-loop/