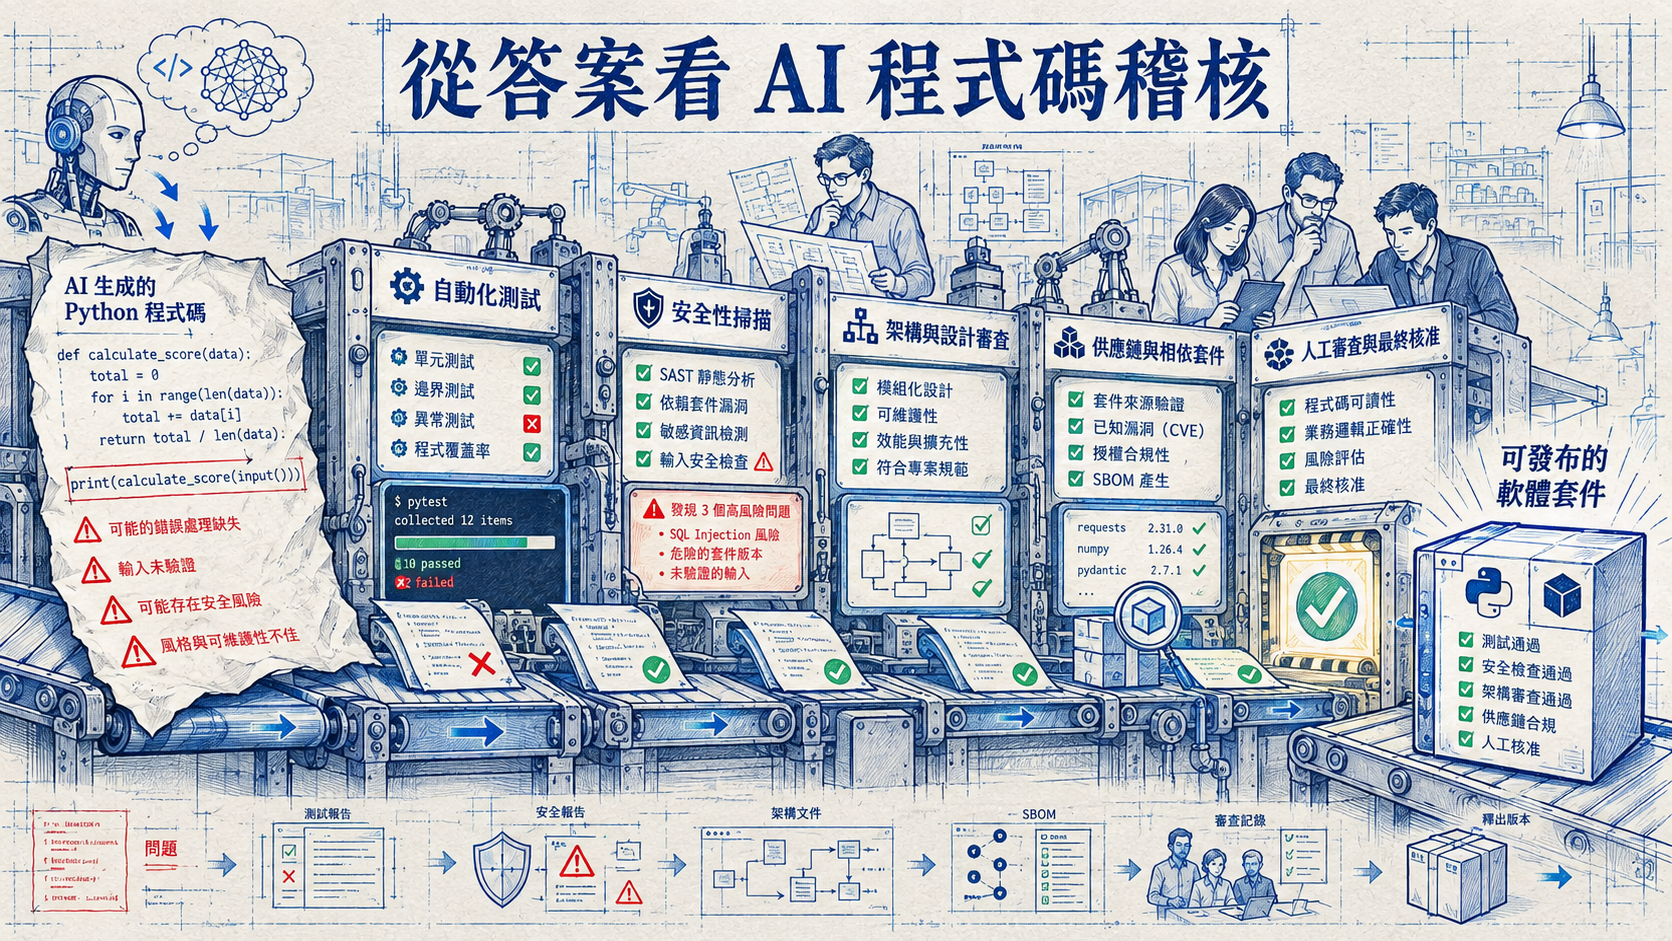
0. 答案的真正形狀|它不是把 TODO 填完,而是把審查制度寫進 repo
前一篇〈AI 生成程式碼怎麼驗〉拆的是題目:一個看起來成熟、測試覆蓋率接近 100%、CI 也會跑的 Python 專案,如何同時藏著 retry 吞錯、最後一次多 sleep、TLS 訊號消失、設定淺拷貝、時區偏移與分頁終止假設。
這一篇要看的是 Cheuk Ting Ho 提供的 audit-ready-python-template。我們用 Repomix 1.18.1 整理其 40 個檔案、約 23.5k tokens,再和原始 audit-ai-workshop 及 66 頁完整投影片 逐項對照。
先釐清一件很重要的事:這不是原 repo 的逐行答案 branch。 練習專案叫 accountsync,答案 template 改成通用的 mypackage;資料模型也從 user sync 改成 paginated items client。它保留的是同一組問題的工程解法,再把解法擴成新專案可以直接沿用的 guardrails。
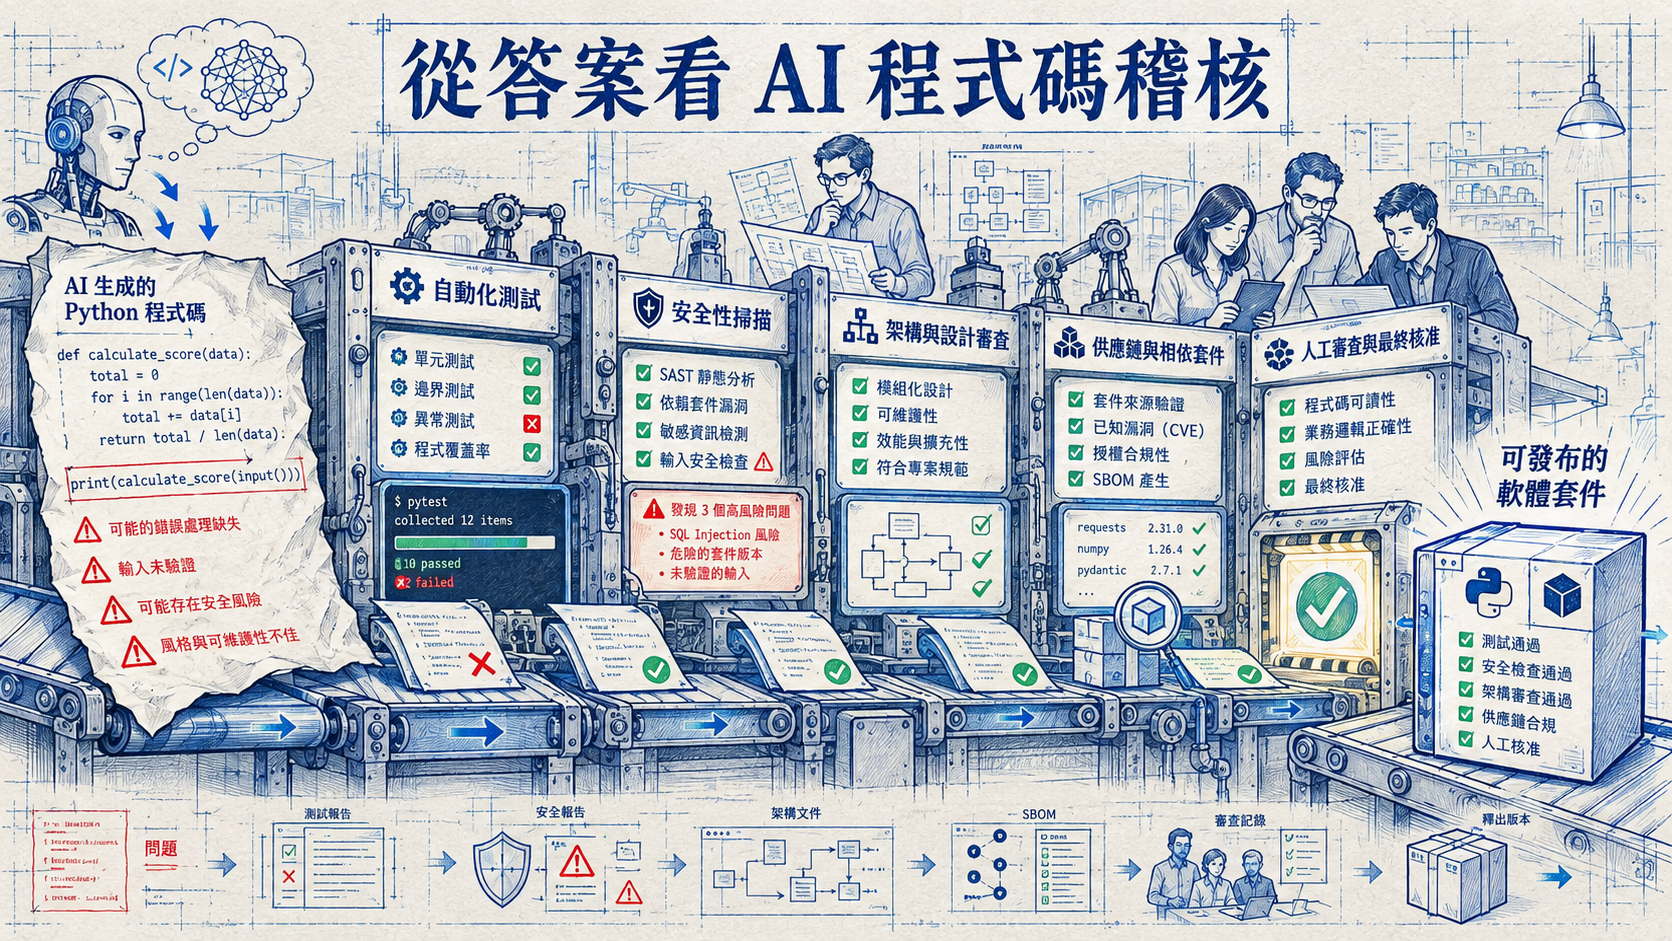
所以它真正回答的不是「TODO 要填哪一行」,而是三個更深的問題:
- 如何讓錯誤不再被隱式成功掩蓋?
- 如何把一次性的 reviewer 經驗,變成每次 commit 都會執行的規則?
- 如何防止下一個人或 AI assistant 把安全決策「順手簡化」掉?
答案散落在程式碼、測試、CI、Semgrep、import-linter、threat model、ADR、CODEOWNERS 與 PR template 裡。也就是說,答案不是一段 code,而是一個制度。
1. 失敗語義|修 retry 的關鍵不是重試成功,而是最後失敗時仍然誠實
原始練習的 fetch_with_retry 和 fetch_user 有一個共同缺陷:迴圈內成功會 return,失敗會 catch 與 sleep,但 retries 耗盡後沒有 raise。Python 因此隱式回傳 None。
答案版把 retry 收斂成一個泛型 helper。它接受一個 Fetch[T] Protocol,成功時保證回傳 T;若每次 transient attempt 都失敗,就 raise RetryExhaustedError,並把最後一個底層錯誤接到 __cause__。這個簽名與控制流一起消除了「失敗卻回傳 None」的灰區。
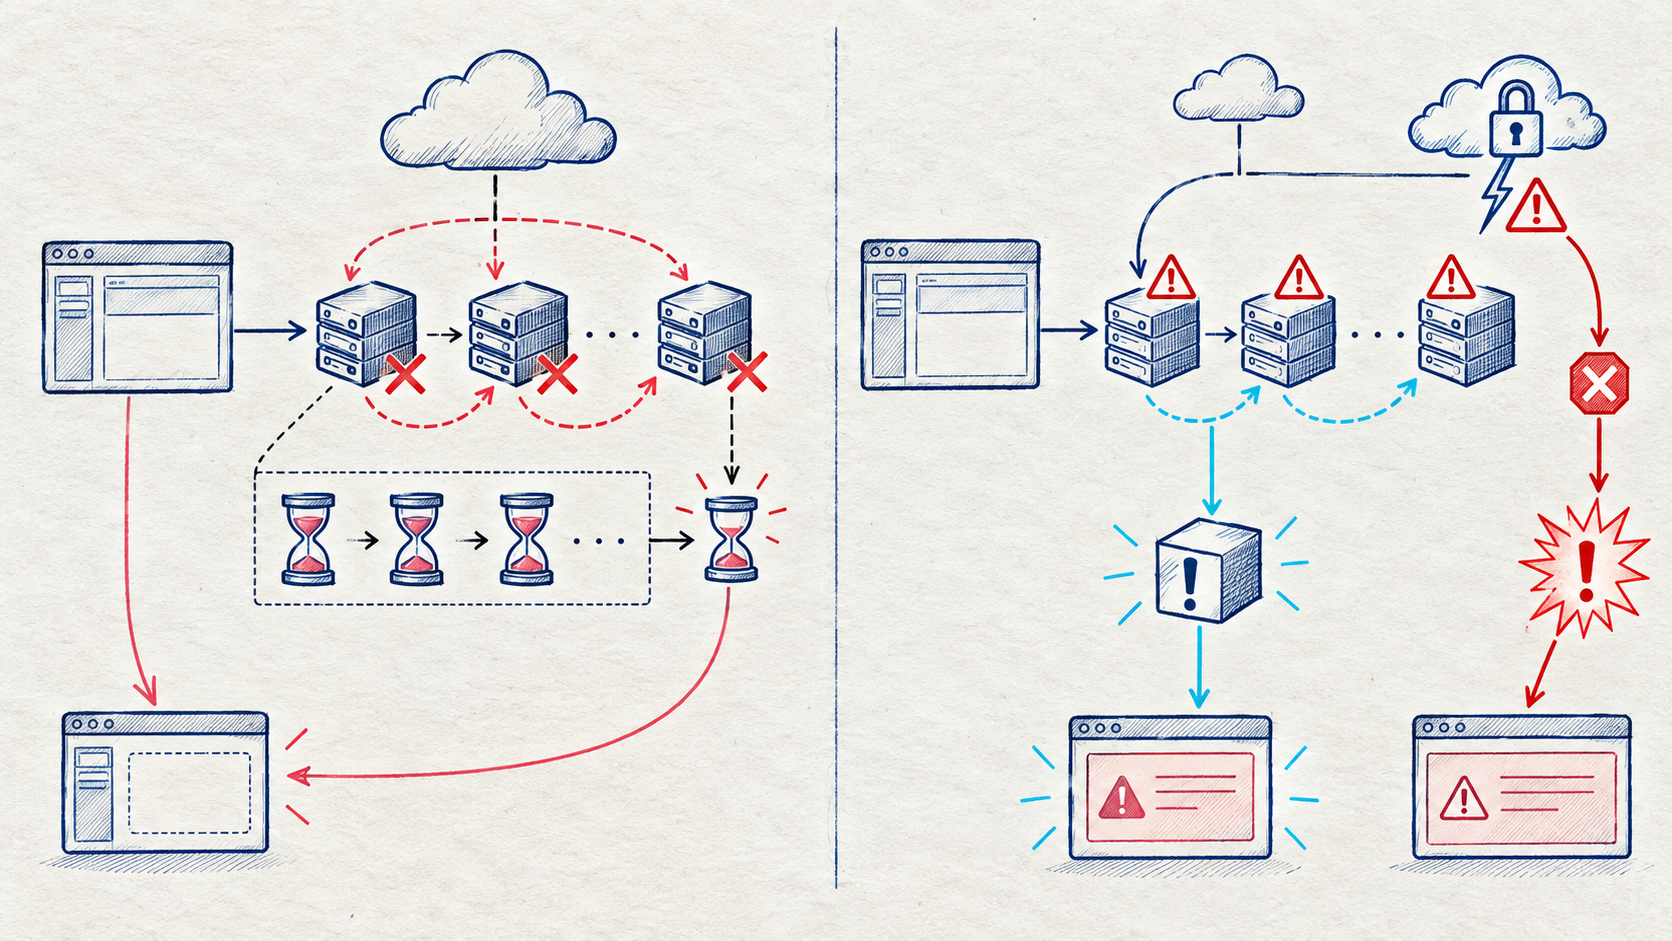
另一個細節是 sleep 的位置。答案版在第 2 次 attempt 之前才 sleep,所以 N 次 attempts 只會有 N−1 次等待。預設三次、0.5 秒 backoff 的實際序列是第一次立刻嘗試,失敗後等 0.5 秒;第二次失敗後等 1 秒;第三次失敗後直接 raise,不再多等 2 秒。
這比原始程式少的不只是延遲,而是語義混亂。Backoff 的目的在「分隔兩次嘗試」,沒有下一次嘗試就沒有等待理由。
答案版還在入口檢查 retries >= 1 與 backoff >= 0。原始練習允許 --retries 0 或負數,迴圈零次執行後同樣會悄悄回傳 None;答案版把這些值判定為呼叫端錯誤,在最靠近邊界的位置拒絕。
2. 錯誤分類|ConnectionError、TLS failure、HTTP 503 與程式 bug 不能共用一條路
原始練習用 except requests.RequestException 一把抓。問題是 SSLError 繼承自 ConnectionError,後者又屬於 RequestException。如果不先分類,憑證錯誤、MITM 訊號或 TLS handshake 失敗會被當成普通斷線重試,最後還可能變成 None。
答案版的 retry.py 先捕捉 SSLError,立刻轉成 TransportSecurityError,不 retry、不 sleep。只有 ConnectionError 與 Timeout 進入 RETRYABLE。其他未預期例外,例如 KeyError,原樣向上傳遞,不用 retry 掩蓋 programmer bug。
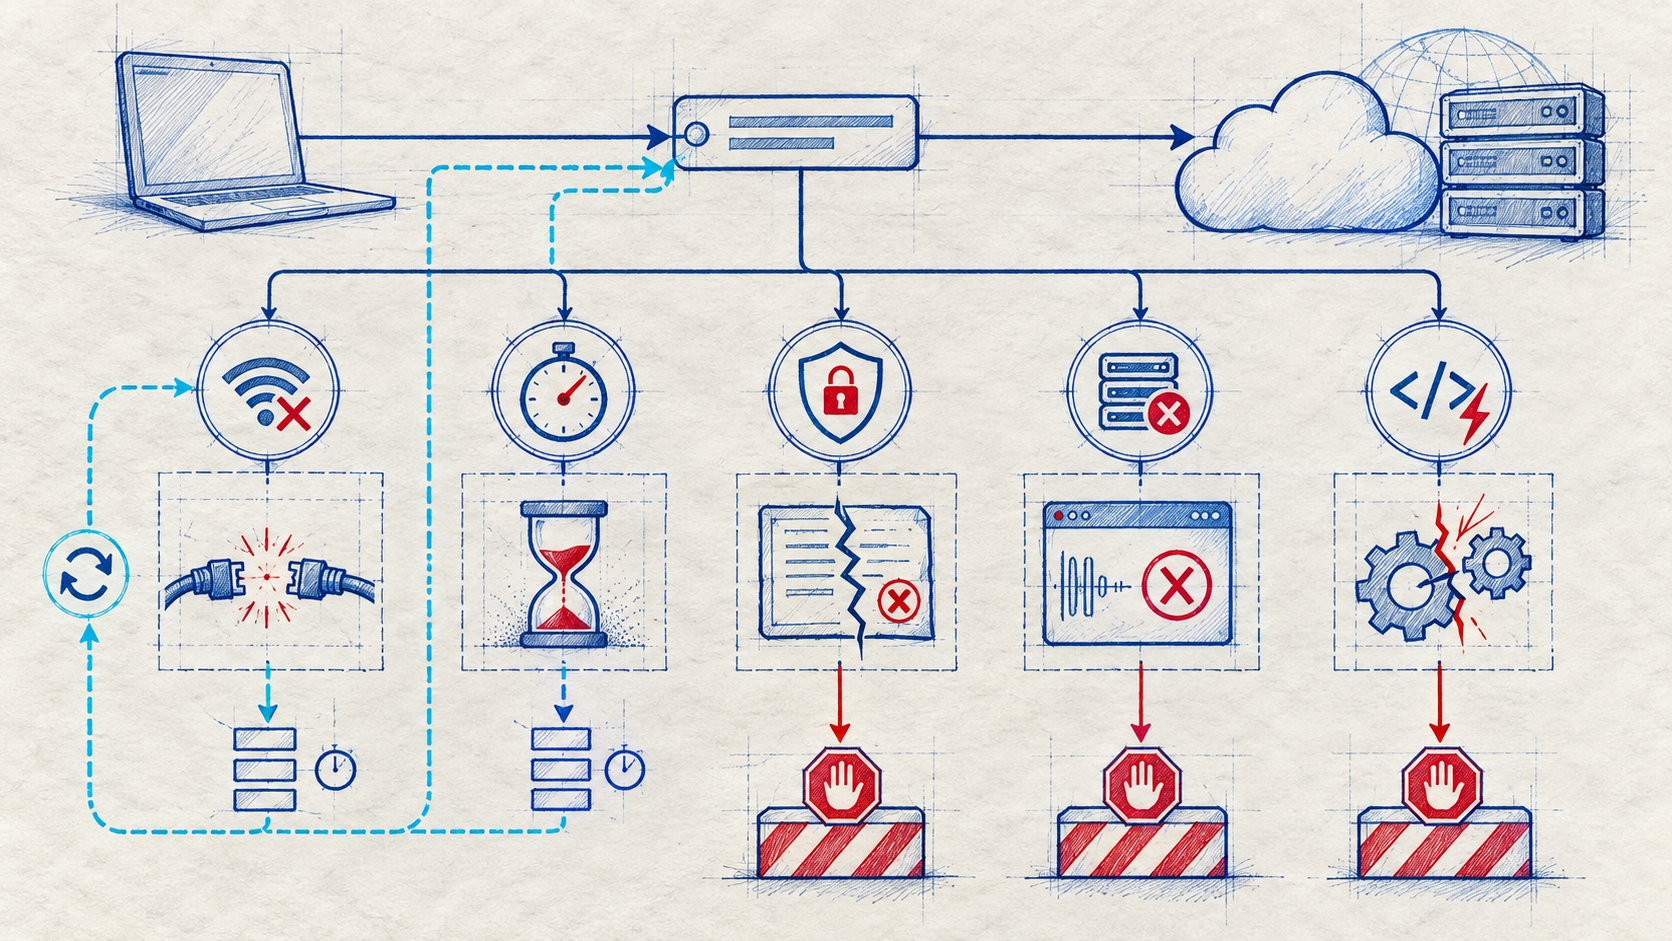
HTTP 非 200 則由 client 在拿到 response 後轉成 UpstreamError;非 JSON body、錯誤 JSON shape、錯誤 timestamp 也屬於「上游有回答,但我們拒絕信任」。於是錯誤階層形成清楚邊界:
ConfigError:自己的設定不合法。TransportSecurityError:傳輸安全失敗,不能當 transient。RetryExhaustedError:可重試錯誤已達上限。UpstreamError:上游回應存在,但內容或狀態不可接受。- 其他 exception:程式本身的 bug,原樣爆出。
這種 taxonomy 的價值在呼叫端。上層不必從 None 猜發生什麼,可以對安全事件告警、對 transient exhaustion 回 503、對 config error 阻止啟動,並讓真正的 coding bug 進 error tracker。
3. 性質測試|從「這個例子會過」升級到「任何反例都不該存在」
投影片 Exercise 1 的重點是:原始 suite 已經有很高的 line 與 branch coverage,再加幾個 hand-written examples 不會自動找到新的 bug。答案版因此把 Hypothesis 變成正式依賴,並把性質測試從 .txt TODO 變成可執行的 tests/test_properties.py。
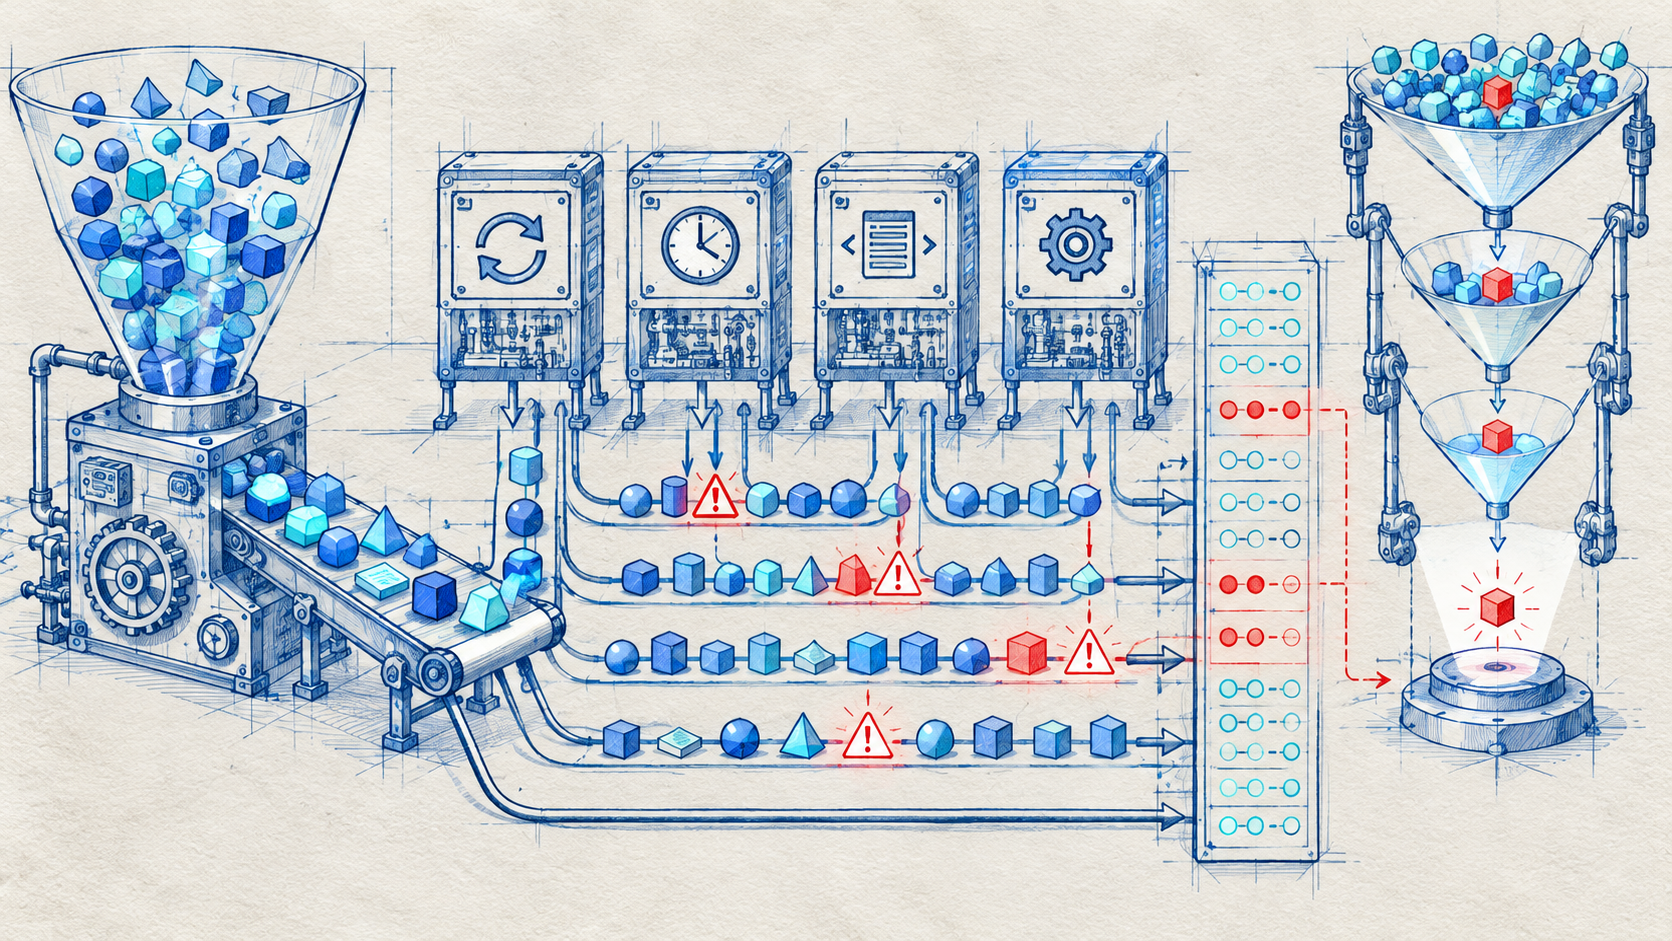
幾個 property 很能代表方法轉變:
- 任意帶時區 datetime,序列化再 parse 後必須代表同一 instant,且統一成 UTC。
- 對任意 aware datetime,
ensure_aware必須 idempotent。 - 廣泛範圍內的 epoch seconds 必須 round-trip。
- 任意合法 retries 與 backoff,calls 必須等於 retries、sleeps 必須等於 retries−1,序列符合指數退避。
- 任意 total 與 page size,cursor pagination 必須 exactly once 產出所有 ids。
- 任意合法 config override,修改結果都不能污染 DEFAULTS。
答案版也設定 Hypothesis profiles:本機 dev 跑較少 examples,CI profile 每個 property 跑到 1000 examples。這不是為了追求大數字,而是把「偶爾在開發者電腦撞到反例」提升成「每次合併都固定投入搜尋預算」。
同時,coverage gate 被明確設成 100%。這裡 100% 不再是假裝足夠,而是底線:example tests 負責每條路徑都有走到,property tests 負責廣泛輸入下的 invariant,adversarial tests 負責惡意或病態環境。三者疊加才有意義。
4. 時間邊界|不要在每個模組各自理解 UTC
原始 auth.py 用 datetime.strptime(...Z) 得到 naive datetime,再和 datetime.now() 比較。因為兩者都 naive,在 UTC runner 上看似合理;換到東京、洛杉磯或 Kathmandu,字面上的同一時間會被當成本地時間,產生偏移。
答案版不是只把一行改成 datetime.now(UTC)。它建立 clock.py 作為唯一讀 wall clock 的模組,定義 AwareDatetime = NewType(...),並讓 ensure_aware 明確拒絕沒有 offset 的 datetime。所有跨邊界 timestamp 都經 parse_timestamp 轉成 aware UTC。
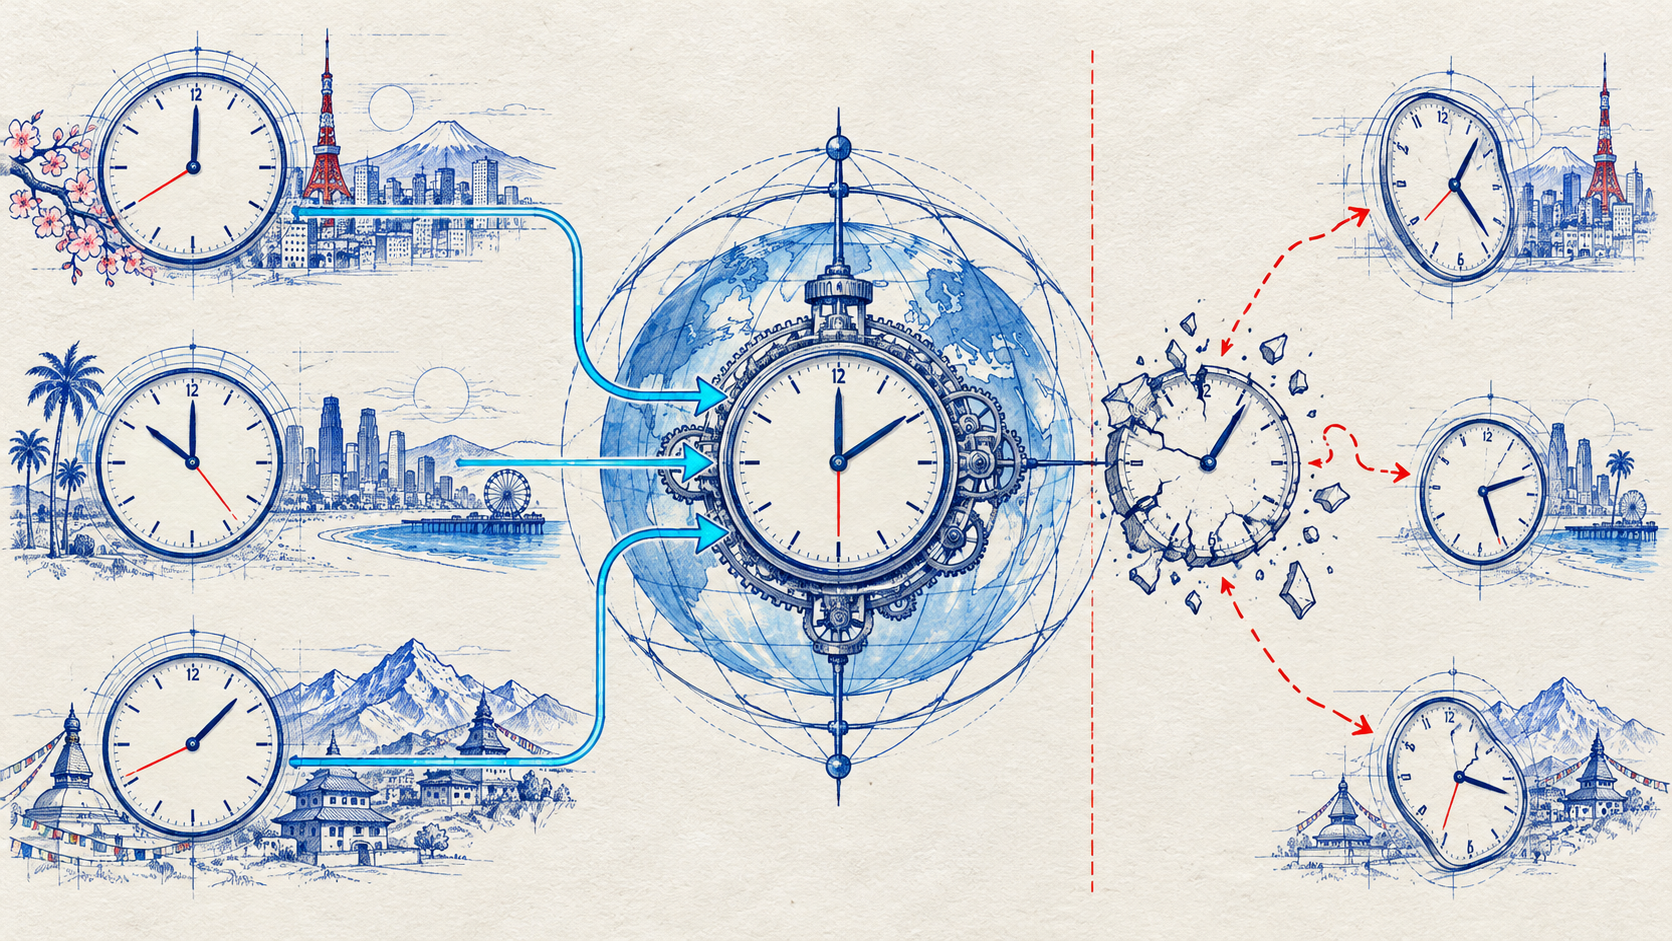
from_epoch 也沒有直接依賴 OS 的 datetime.fromtimestamp,而是從 aware UTC epoch 加上 timedelta。Repo 的註解指出這避免了 Windows 對 1970 年以前 timestamp 的平台差異;測試也包含 -86400 與 NaN、infinity、超大值、bool 等反例。
這項決策同時被四層機制保存:
clock.py的 API;- Ruff 的 DTZ 與 banned API;
- Semgrep 的
no-naive-utc-clock; - ADR-0001 與 CI timezone matrix。
CI 除 UTC 外,加入 Asia/Tokyo、America/Los_Angeles、Asia/Kathmandu。選 Kathmandu 特別有意義,因為 +05:45 能抓出只拿整數小時測試時看不到的假設。
5. 設定邊界|TypedDict 不會替你驗證 runtime input
原始 merge_config 用 dict(defaults) 做 shallow copy,再用 update 覆蓋。結果有兩個:覆蓋 database.host 可能整段吃掉 port 與 pool_size;沒有被覆蓋的巢狀 dict 又可能繼續和 DEFAULTS 共用物件。
答案版把 config 做成 TypedDict,DEFAULTS 標成 Final,load_config 從 copy.deepcopy 開始,再用 recursive merge 合併,並拒絕任何 unknown key。這解決 shape 與 aliasing,但作者沒有把 TypedDict 當 runtime validation。
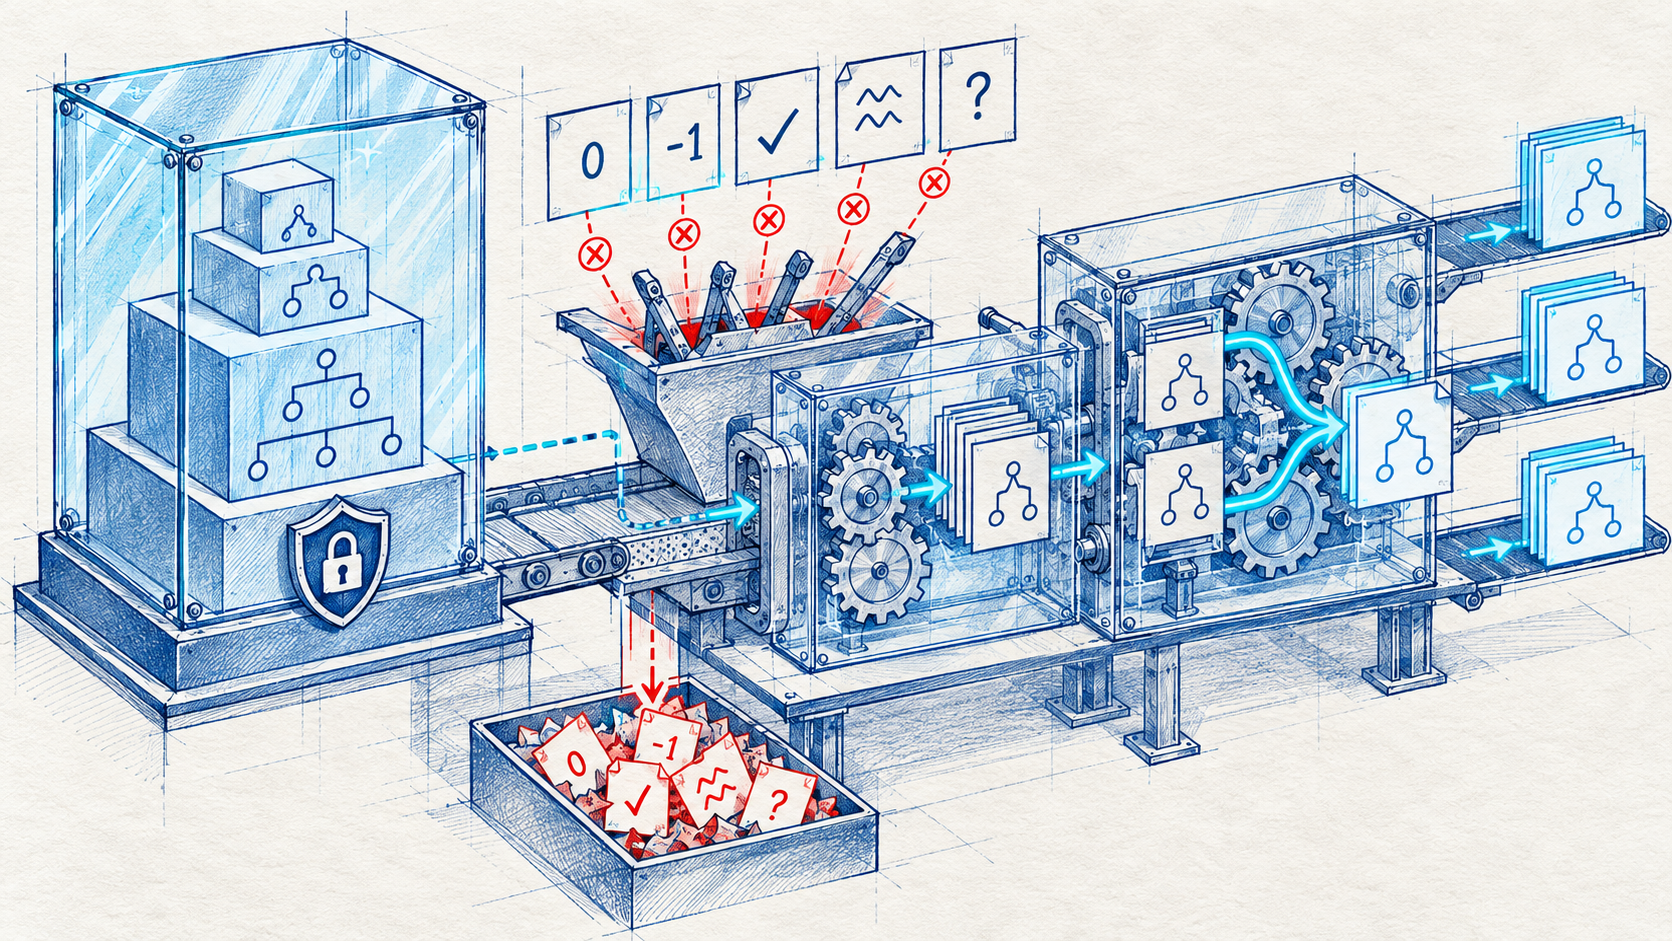
validate 仍逐項檢查:
- retries 1–10;
- page_size 1–1000;
- max_pages 1–100000;
- backoff 0–60;
- timeout 0.1–300;
- verify_tls 必須真的是 bool;
- base_url 必須是 https;
- bool 雖是 int 子類,仍被明確拒絕;
- NaN 利用「否定範圍比較」被擋下。
環境變數也不容錯吞掉。像 MYPACKAGE_RETRIES=lots 會回 ConfigError,而不是忽略後偷偷用 default。這反映一個 audit-ready 原則:邊界上的壞資料要明確失敗,不能靠 fallback 把問題藏起來。
6. 敵意上游|資料不是 JSON 就可信,cursor 也不是天然保證
答案 template 把 upstream 明確視為 hostile。Client 不直接把 response.json() 的結果交給業務層,而是經 parse_page、parse_item、parse_timestamp 逐層驗證。
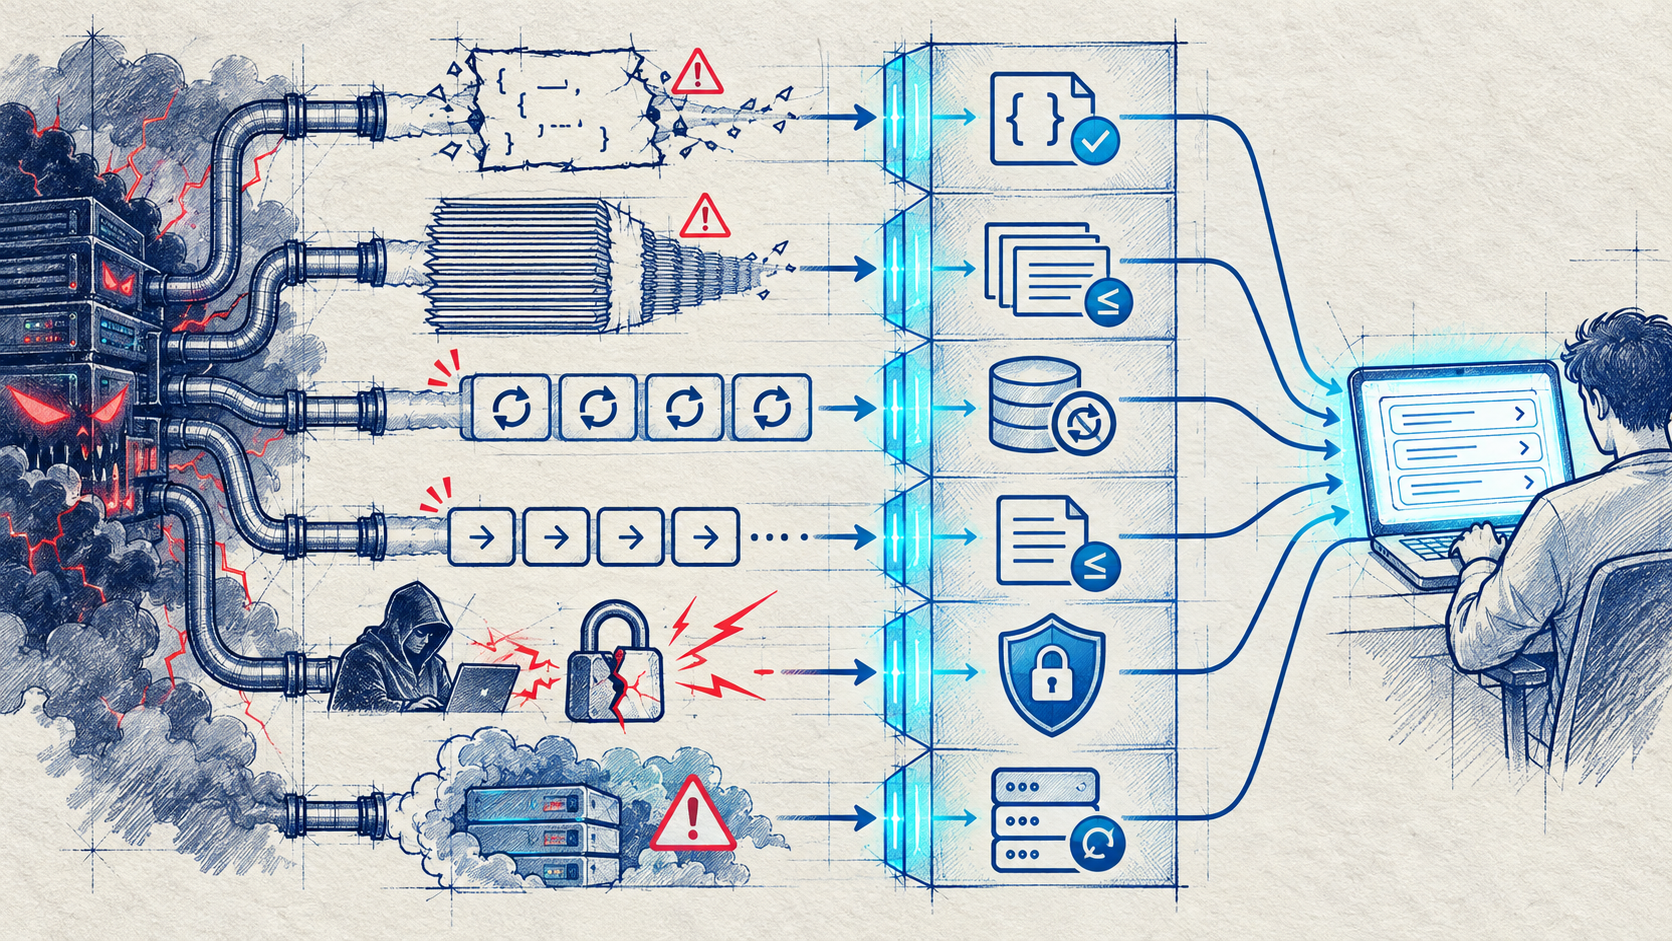
Item id 必須是非空字串且不超過 256 字;updated_at 必須有 timezone。Page 必須是 object、items 必須是 list、next 必須是非空字串或 null。Request 固定走 Session、有 timeout、TLS verification;_url 還拒絕 //evil.example.com 或完整外部 URL,避免 caller 用 path 把 request 導到不同 origin。
分頁不再以「短頁」猜終點,而是使用 explicit next cursor。同時維護 seen set 抓 cursor loop,以 max_pages 處理每頁都給全新 cursor 的無限串流,再檢查 upstream 不能回超過 page_size 的 items。
這裡也保留誠實的限制。THREAT_MODEL 明寫:cursor pagination 不是 consistent snapshot;若翻頁期間資料新增或刪除,可能跳過或重複,這被列為 accepted risk,要求 consumers idempotent。好的答案不是宣稱風險歸零,而是說清楚哪個風險由誰承擔。
7. 靜態防線|把 reviewer 看過的坑編成機器規則
Ruff 在答案版不是只跑 E、F、I。規則擴到 DTZ、RET、S、TRY、ASYNC、LOG、PERF、C90、TID、PL、D 等,並把 datetime.utcnow、requests.get/post/request、pickle、yaml.load 放進 banned APIs。
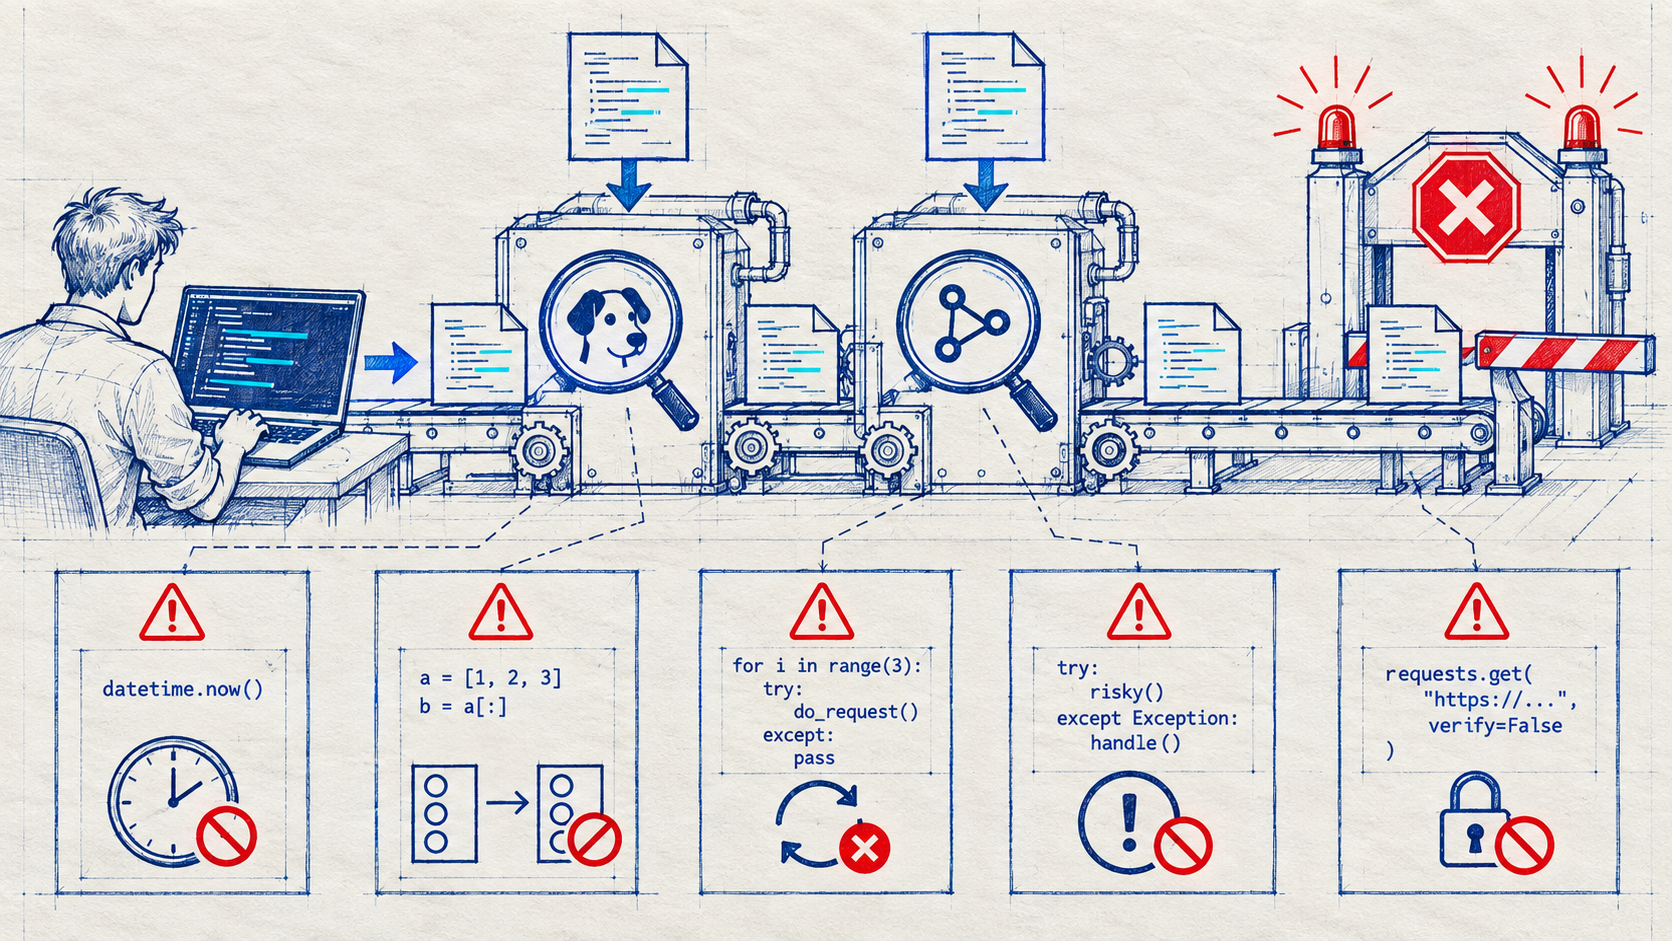
但通用 linter 表達不了所有 project invariant,所以 repo 另有 .semgrep.yml:
- 禁止 naive UTC clock;
- 禁止對 module-level defaults 做 shallow copy;
- 偵測 retry loop 吞錯卻可能沒有最終 raise;
- 若捕捉 RequestException,必須先處理 SSLError;
- 禁止
verify=False。
更細的地方是 .semgrepignore。投影片提醒 Semgrep 可能預設忽略 tests;答案版用自訂 ignore 清單把 tests 納入,因為測試也可能是 AI 生成,而這些規則保護的不只是 production security,也保護「測試是否在驗錯誤行為」。
工具也不透過 uvx 每次抓最新版,而是放進 dependency groups 與 uv.lock。Pre-commit 和 CI 都跑 lockfile 裡同一版本,避免本機 pass、CI fail,或昨天 pass、今天工具更新後突然變結果。
8. 供應鏈|鎖版本只是開始,還要驗 lock、查漏洞、列成分、檢查 workflow
答案版的 audit job 先執行 uv lock --check,確認 pyproject 與 lockfile 同步。接著有兩次 pip-audit:runtime dependencies 對 PyPI vulnerability data;所有 dependency groups,包括 dev 與 CI tools,對 OSV。
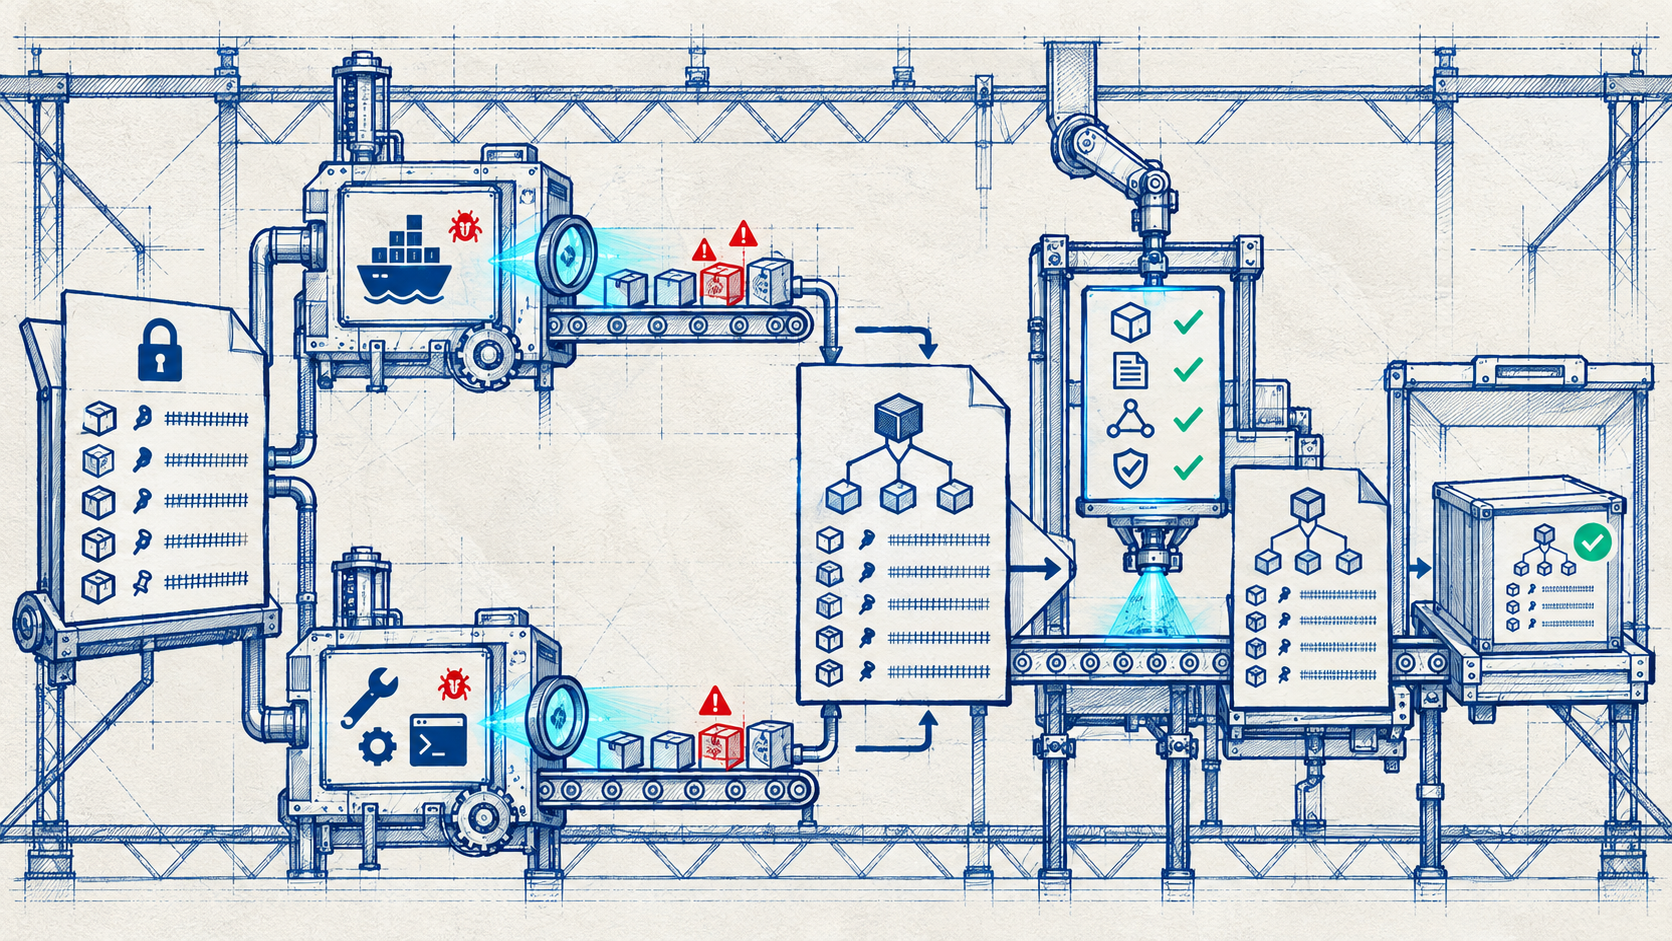
這個差異很重要。很多 repo 只 audit runtime,卻忽略 semgrep、twine、build tools 本身也會在 CI 執行程式碼。答案版把 pip-audit、zizmor、cyclonedx-bom、twine 鎖在 tools group,連這些稽核工具自己的依賴也進 OSV audit。
SBOM 部分更值得抄。CI 建立一個 runtime-only environment,再用 cyclonedx-py 產生 JSON;SOURCE_DATE_EPOCH 使用 commit time,搭配 reproducible output,避免每次產物因隨機 serial 改變。
但「格式是合法 CycloneDX」不等於「內容正確」。所以下一步用 Python 檢查:
- metadata subject 必須是 mypackage;
- runtime dependency requests 必須存在;
- pytest、pip-audit、cyclonedx-bom 等 dev/tool packages 不得混進去。
GitHub Actions 本身也進供應鏈模型:第三方 actions pin 到 commit SHA,checkout 不保留 credentials,workflow 預設 contents: read,再用 zizmor 掃 workflow。這讓「審查程式碼」延伸到「審查負責審查與發版的機器」。
9. 架構契約|型別不是註解覆蓋率,重點是限制不該出現的依賴
投影片有一個尖銳示範:專案幾乎沒有型別註解,ty check 仍可能顯示 all checks passed。沒有資訊時的綠燈,並不代表安全。
答案版全面補型別,且同時跑 ty 與 mypy --strict。由於 ty 還是 pre-1.0,mypy 作為交叉檢查。Protocols 用於 Fetch、Clock、HttpSession 與 Response,讓測試 fake 不必繼承 concrete class,又能讓 type checker 驗證 call sites。py.typed 會進 wheel,CI 還用 unzip 確認真的被打包。
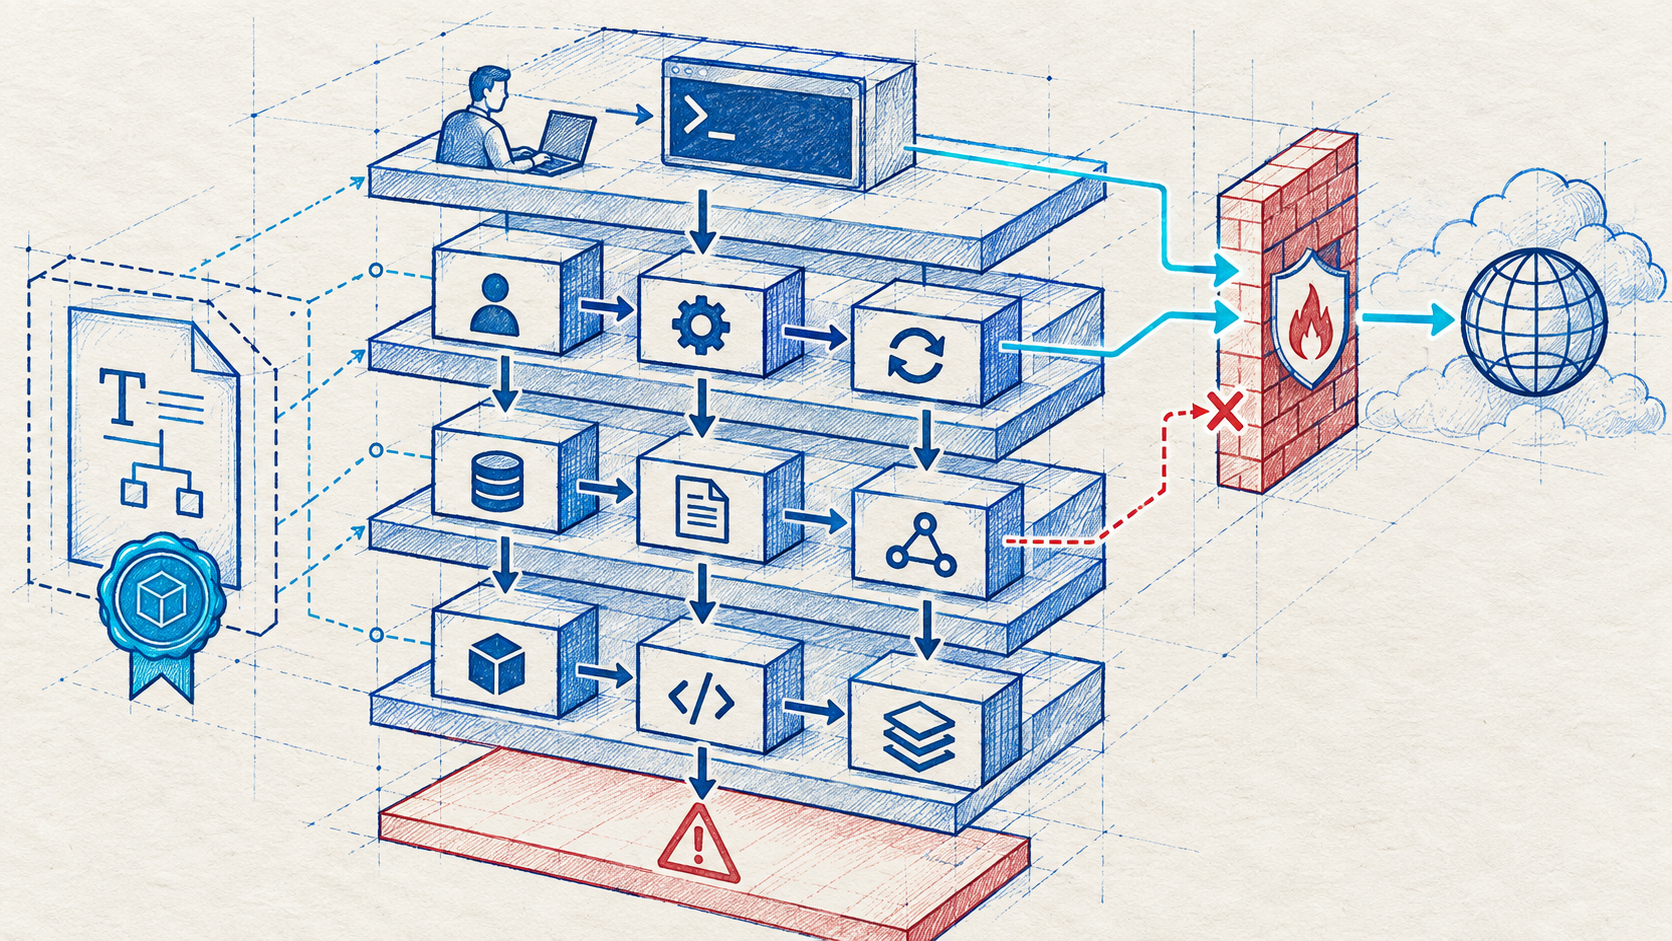
.importlinter 把 package 定義成 exhaustive layers:__main__ → cli → client → retry|clock → config → errors。新增模組若沒有被放進 layer,CI 會 fail,逼人類明確決定它的位置。
另兩個 contract 是:
- errors 是 leaf,不能反向依賴 package 其他模組;
- package 內原則上禁止 requests,只有 client 與 retry 被 allowlist。
這比「保持乾淨架構」具體得多。AI assistant 很擅長為了完成當下任務直接跨層 import;import-linter 讓這種捷徑在 commit 時變成可觀察失敗。
10. 對抗式審查|Pathological fake 比完美 mock 更接近真實世界
原始測試大量使用永遠回 200 的 mock,很容易讓「每次失敗後都回 None」也被視為安全。答案版保留 WellBehavedUpstream,同時新增 scriptable 的 PathologicalUpstream:每次 call 可以回 page、FakeResponse 或直接 raise exception,最後一步還能持續重複。
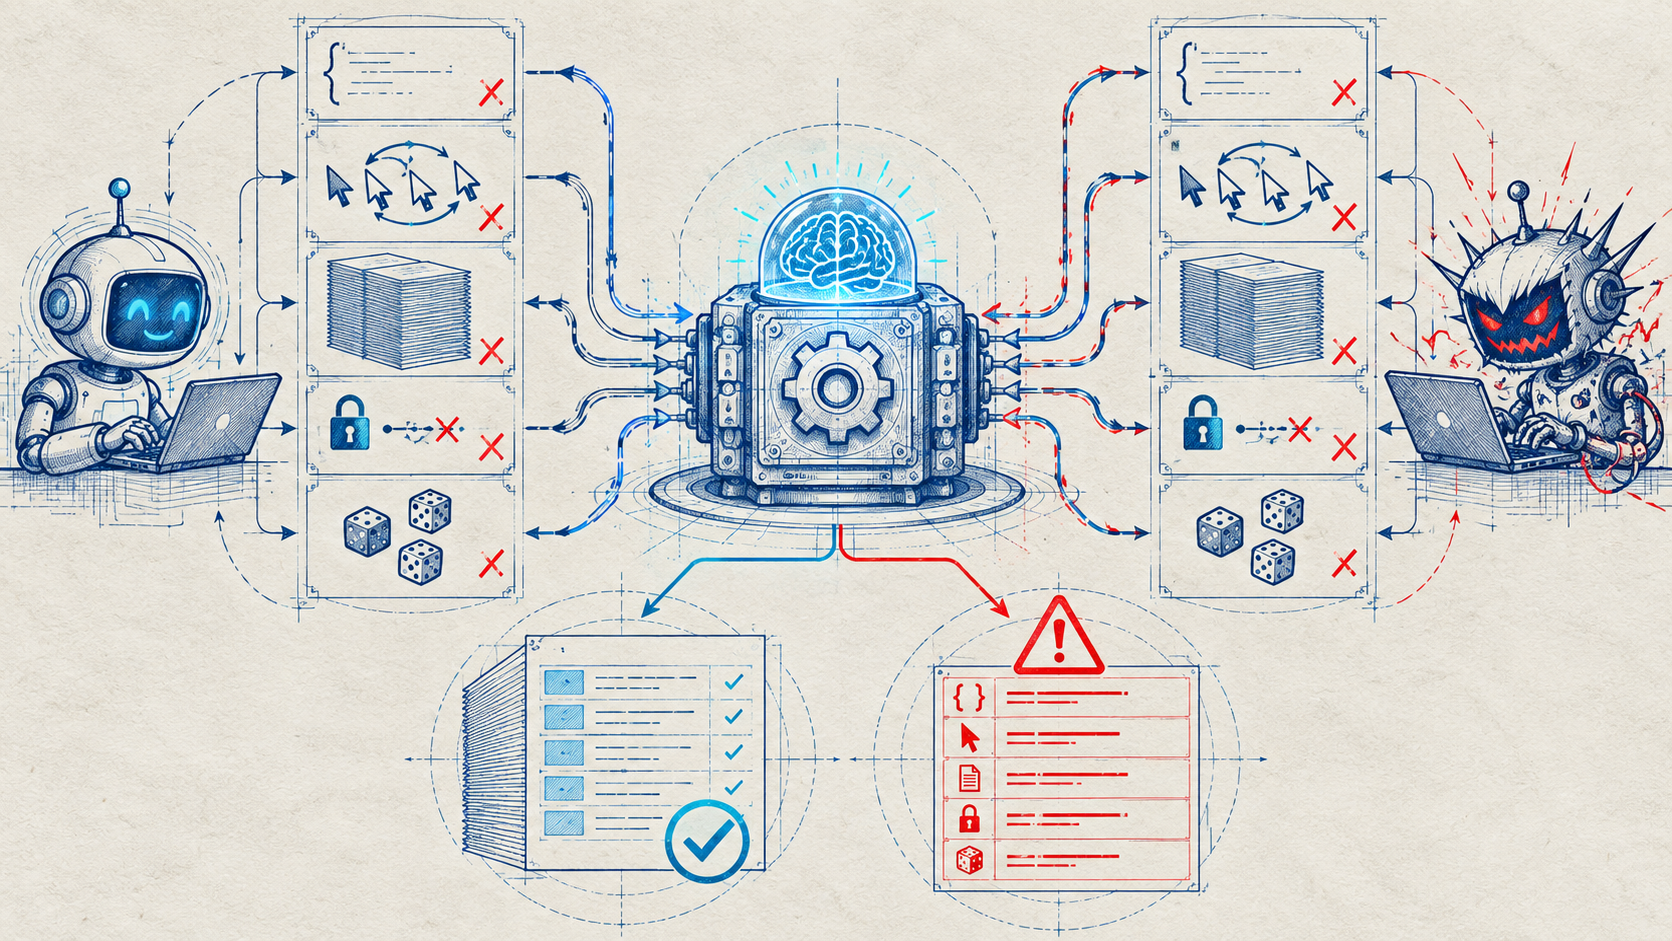
Adversarial suite 包含:
- fuzz page、item、timestamp parser;
- 重複 cursor;
- 永遠產生新 cursor;
- oversized page;
- naive timestamp;
- null、list、string、缺欄位等 malformed bodies;
- connection reset、timeout、TLS、500、429、非 JSON 的 fault injection。
最關鍵的 assertion 是:若 fault injection 最後成功,就必須得到完整 2+2+1 共 5 items;否則只能以 UpstreamError、RetryExhaustedError 或 TransportSecurityError 明確失敗。不能成功一半、不能無聲截短、不能回錯資料。
這些測試獨立成 adversarial CI job,並在高 effort Hypothesis profile 下執行。Repo 還有 docs/adversarial-review.md,要求團隊按 hostile upstream、clock、retry amplification、pagination concurrent writes、filesystem/process、config surface 逐類攻擊。
11. 人類治理|Human in the loop 需要檔案、owner 與可追溯決策
投影片說人類監督不可少,但答案 template 把這句話進一步具體化。CODEOWNERS 對 security surface 設額外 owner;PR template 追問 AI provenance、failure path、security signal、time 與 input;AGENTS.md 為 AI coding assistants 設規則;CLAUDE.md 指向同一份指引。
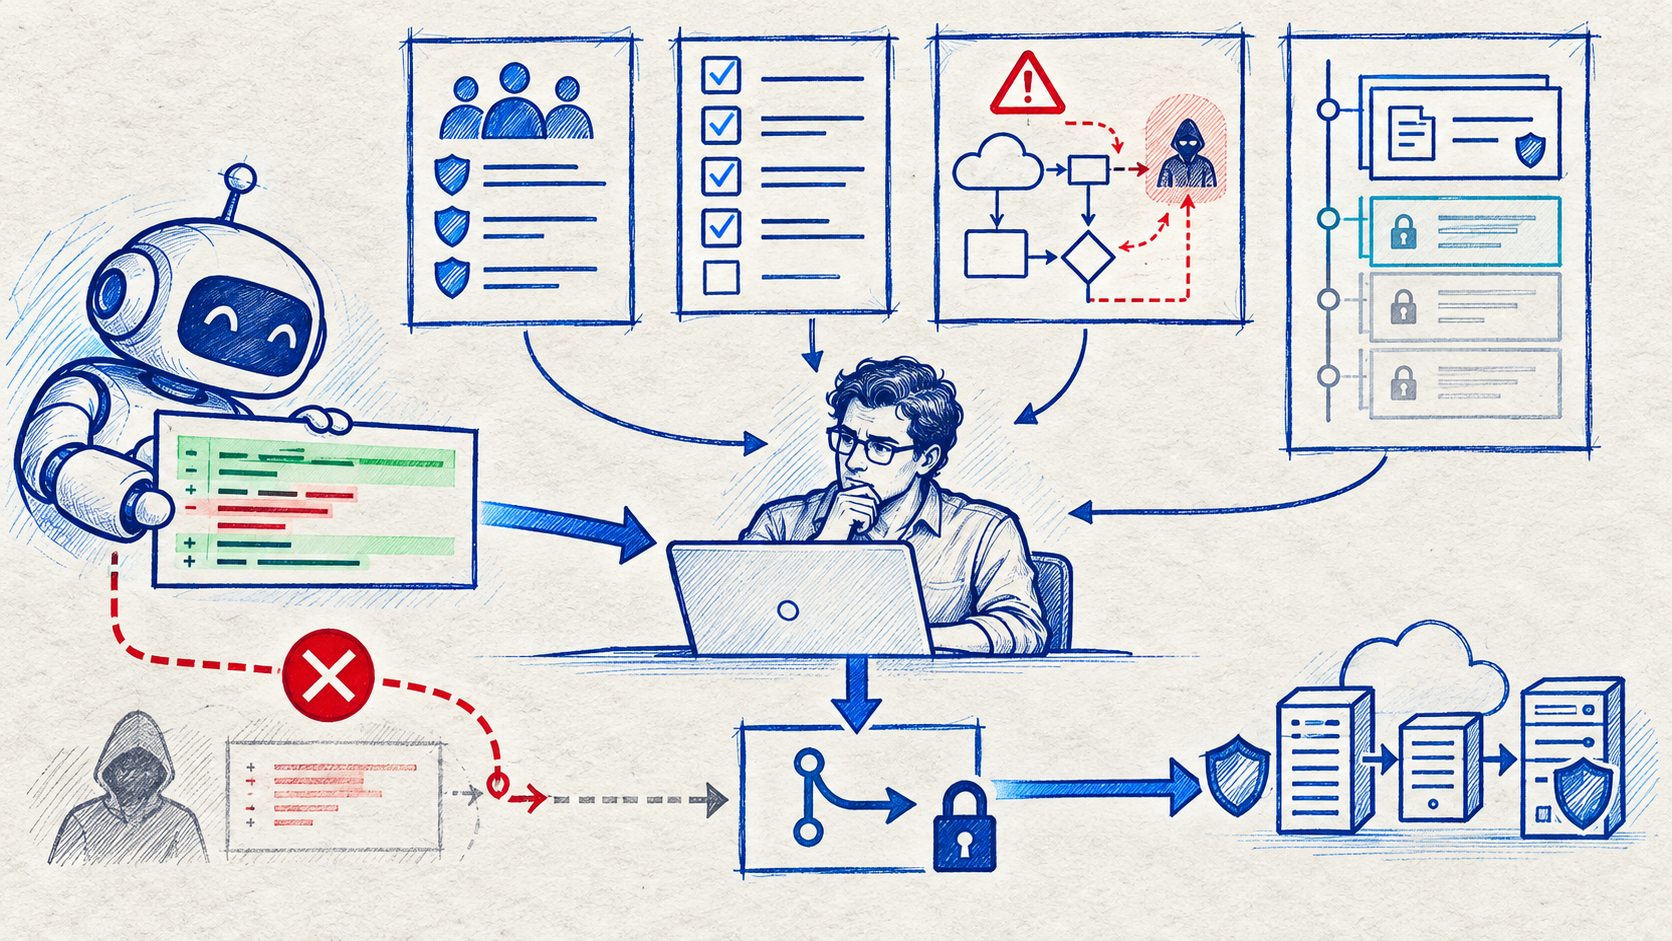
ADR 的角色尤其重要。ADR-0001 不只寫「使用 aware UTC」,還記錄背景、決策、後果,以及哪些機器規則負責 enforce。README 甚至明說:把 reviewer 或 AI assistant 可能「helpfully undo」的決策寫進 ADR。
THREAT_MODEL 則列出 assets、trust boundaries、entry points、mitigations、tests 與 accepted risks。它讓安全模型不只活在某個資深工程師腦中,也讓 AI 在改碼前有可讀的約束。
這就是 human in the loop 比「每個 PR 都有人按 approve」更完整的版本:
- 人定義什麼不能失去;
- 檔案保存為什麼;
- 工具自動攔住常見倒退;
- 人把注意力放在新風險與 trade-off;
- 接受的風險也留下責任邊界。
12. 怎麼使用這份答案|不要整包抄,應該抄它把知識變成 constraint 的方法
這個 template 很完整,但不代表任何 Python repo 都該原封不動複製。它有 100% coverage、雙 type checker、Semgrep、Ruff 大 rule set、import-linter、雙 vulnerability data source、SBOM、zizmor、六個 CI jobs。對小型 script 可能過重,對處理權限、金流、身份或關鍵資料的服務則很合理。
比較好的導入順序是:
第一層:先修失敗語義
列出每個 I/O 邊界的成功與失敗型別;禁止隱式 None;TLS 與 auth/security signals 不得混進 transient retry;最後一次 attempt 後不再 sleep;所有 retry 都有上限。
第二層:把已知事故寫成 properties
從「某個案例壞掉」抽成 invariant,例如完整或明確失敗、設定不共享可變狀態、timestamp 跨時區不變、pagination exactly once 或至少有明確 accepted risk。
第三層:把 reviewer 經驗做成 rules
通用問題放 Ruff,project-specific pattern 放 Semgrep,依賴方向放 import-linter,設計決策放 ADR,輸入與信任邊界放 threat model。
第四層:把工具本身納入供應鏈
固定版本、檢查 lockfile、audit runtime 與 tools、產生並檢查 SBOM、pin CI actions、掃 workflow。不要讓安全工具成為未管理的遠端程式碼入口。
第五層:最後才談 AI workflow eval
DeepEval、Ragas、Phoenix 可以衡量產生程式碼的 workflow,但它們不能替代 code-level tests、threat modeling 與人工設計判斷。先確保產物有可執行 guardrails,再評估 agent 多次 run 的穩定性、failure patterns 與 regression。
答案版最深的洞見,不是「多裝幾個工具」。它示範了如何把一次審查中學到的事,逐步轉成型別、測試、規則、CI、文件與 owner。這樣下一次 AI 生成相似程式碼時,團隊不必重新靠直覺發現同一個坑。
真正 audit-ready 的 repo,不是永遠不會出錯;而是它能讓錯誤更早、更大聲、更可分類地出現,並留下足夠證據讓人知道:這次綠燈到底證明了什麼,又沒有證明什麼。